
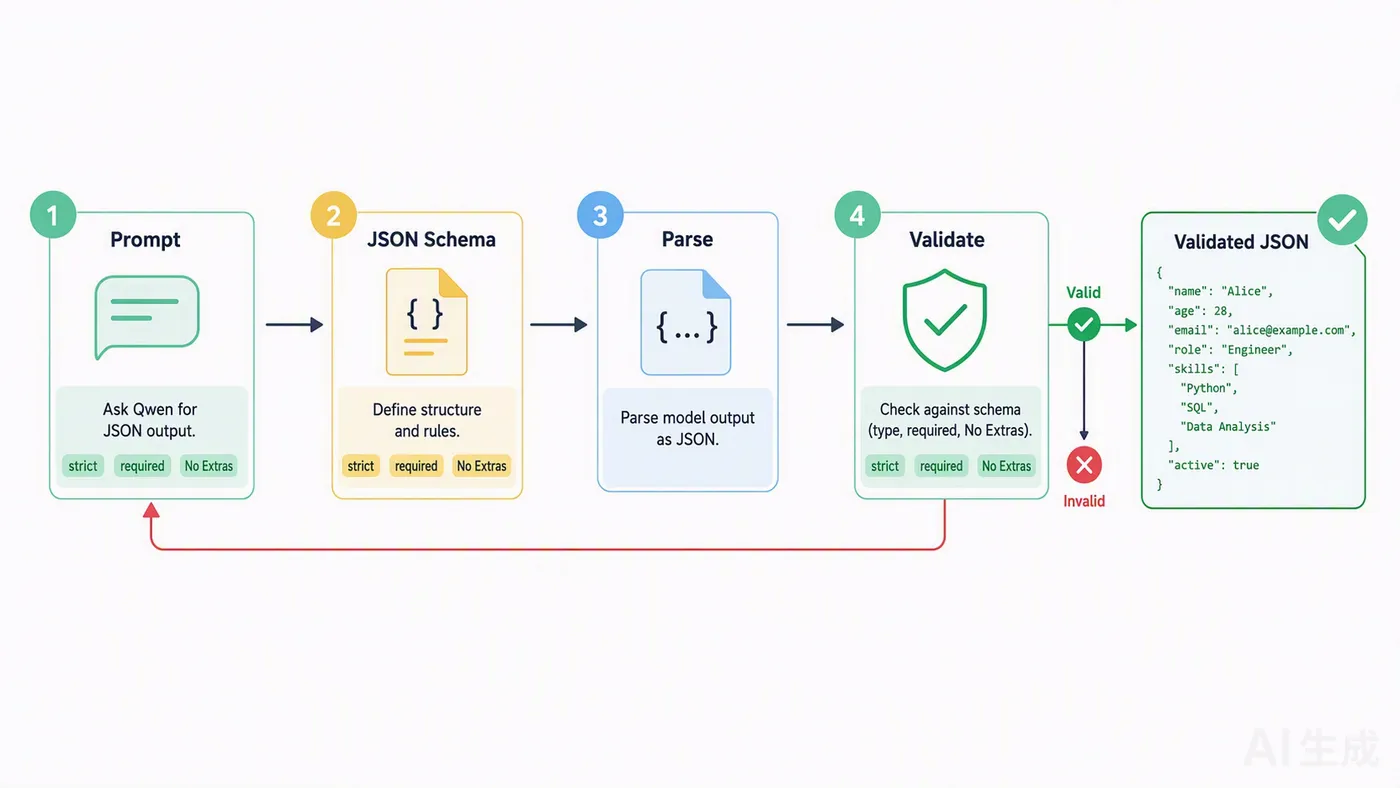
结论先行:稳定 JSON 不是提示词问题,而是接口契约问题。
“请只返回 JSON”只能表达意愿,不能建立约束。真正可上线的方案,要同时处理输出模式、Schema、字段必填、额外字段、业务规则和异常分支。少一层,解析错误就可能从模型端一路传到数据库。
能解析,不等于能使用
开发中常见三类失败。
第一类是格式失败,例如混入解释文字、Markdown 代码围栏或不完整括号。第二类是结构失败,例如字段缺失、类型不符、枚举越界。第三类更隐蔽:JSON 格式和结构都正确,但业务含义错误,例如结束时间早于开始时间、金额为负数、订单状态与操作不匹配。
json_object 和 json_schema 解决的问题不同。
json_object 主要约束输出成为 JSON 对象。它适合字段较少、结构允许变化,或者业务侧本来就有强校验器的场景。但它通常不负责保证某个字段必然出现,也不代表字段类型、枚举和嵌套层级一定符合预期。
json_schema 更像一份机器可读合同。你可以定义对象属性、数据类型、枚举、数组元素和嵌套结构。对接工作流、数据库写入和工具调用时,它通常更可控。
Schema 里的几个配置尤其关键:
- strict:要求模型按给定结构生成,但不应把它理解为业务正确性的担保;
- required:明确下游不可缺少的字段,避免“模型觉得没必要就省略”;
- additionalProperties: false:阻止随意增加字段,降低接口漂移风险;
- enum 等约束:可用于收窄合法值;其他 JSON Schema 关键字的支持范围应以当前模型文档为准,跨字段规则仍由业务代码校验。
反常识点在这里:Schema 越长不一定越稳。把大量业务说明塞进字段描述,会增加理解负担。结构约束交给 Schema,判断依据放进提示词,跨字段逻辑留给业务代码,职责应当分开。
把生成链路变成校验流水线
第一步:先定义消费方合同
不要从提示词开始。先问下游需要什么:哪些字段必须存在,哪些允许为空,失败时是否可重试,旧版本消费者能否接受新字段。只有消费方合同明确,Schema 才不是装饰品。
第二步:按风险选择模式
内容摘要、临时标签等低风险任务,可以从 json_object 开始。会触发写库、审批、计费或工具调用的输出,优先考虑 json_schema,并限制额外字段。
第三步:编写紧凑 Schema
下面是一个接口示意。API Key 只从环境变量读取;Base URL 需要按地域和业务空间替换,并以控制台与官方文档为准。
import json
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url=os.environ["DASHSCOPE_BASE_URL"],
)
response = client.chat.completions.create(
    model="请替换为控制台中可用的模型ID",
    messages=[{
        "role": "user",
        "content": "从文本中提取工单编号、优先级和问题摘要。"
    }],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "ticket_result",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "ticket_id": {"type": "string"},
                    "priority": {
                        "type": "string",
                        "enum": ["low", "medium", "high"]
                    },
                    "summary": {"type": "string"}
                },
                "required": ["ticket_id", "priority", "summary"],
                "additionalProperties": False
            }
        }
    }
)
data = json.loads(response.choices[0].message.content)
第四步:实施二次校验
至少设置三道检查:JSON 解析、Schema 验证、业务规则验证。业务规则包括跨字段关系、权限范围、资源是否存在、数据是否过期。验证失败时记录错误类型,不要只记录“模型失败”。
第五步:设计可观测的失败处理
区分可重试与不可重试错误。偶发格式问题可以有限重试;Schema 本身与任务冲突,应先修合同。将原始响应、校验错误、提示词版本和 Schema 版本关联起来,但日志中要脱敏。
早期调试可在千问大模型平台https://platform.qianwenai.com/try-ai观察不同约束下的输出;进入 API 接入、应用编排和运行治理阶段,再通过
阿里云百炼平台https://bailian.console.aliyun.com/落地。具体模型支持范围、额度和上下文长度,以控制台与官方文档为准。
结构稳定之后,还要防业务错误
多模态输入并不意味着所有结构化输出模式都适用于每种模型、图片格式和调用方式。图片数量、文件大小、输入方式及结构化能力限制,以官方文档为准。涉及图片时,还要处理资源可访问性、超时和内容安全。
开启 strict 后,还需要业务校验吗?
需要。strict 约束的是结构,不负责判断订单是否存在、用户是否有权限,也无法替代金额、时间和状态机校验。
所有任务都应该使用 json_schema 吗?
不必。结构经常变化、字段由用户动态定义的任务,强 Schema 可能增加维护成本。先判断下游是否依赖固定字段,再选择模式。
校验失败时,是否把错误原样交给模型重试?
可以提供精简后的错误信息,但要限制重试次数,并避免把敏感数据、内部堆栈或完整数据库结构放回提示词。持续失败通常说明合同或输入需要调整。
参考资料
千问结构化输出官方文档https://help.aliyun.com/zh/model-studio/qwen-structured-output
Qwen Code 结构化输出文档https://qwenlm.github.io/qwen-code-docs/zh/users/features/structured-output/
JSON 稳定性的终点不是“解析成功”,而是“错误被拦在写库之前”。
