
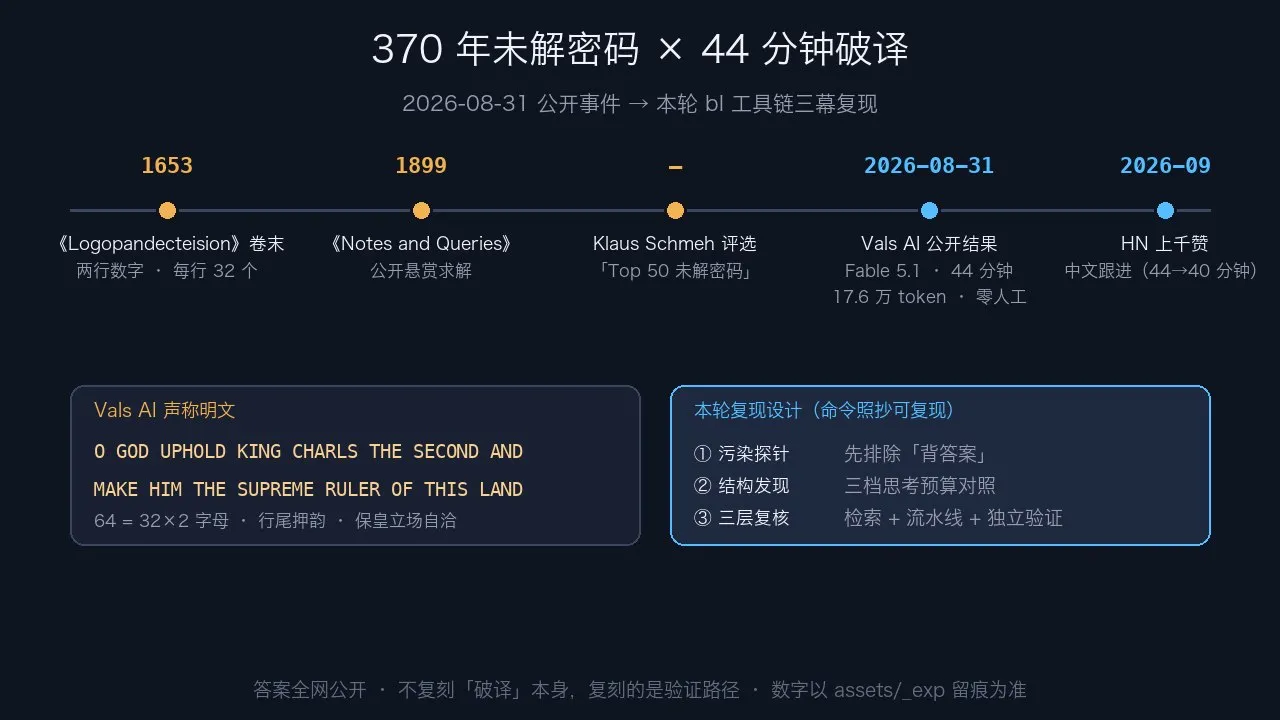
九月中旬,一条「AI 破译 370 年密码」的新闻在技术社区传开:Vals AI 研究员用 Claude 的 Fable 5.1 在 44 分钟内破译了 1653 年的 Cyphral Distich,消耗 17.6 万 token。评测圈的讨论集中在模型能力上,但工程视角的问题更实际:这类多步核验任务,放在百炼的命令行工具链里,能不能走通?
我完整走了一遍。任务链三层:先排除「背答案」的可能(污染检查),再做一次结构发现实验,最后把逐位复核交给编排流水线并用自建密码做全链验证。全程只用了三类能力:bl text chat(qwen3.8-max 推理)、bl knowledge(检索)、bl pipeline(编排)。以下是实测记录。
场景:一条需要「检索 + 机械核对 + 边界判断」的任务链
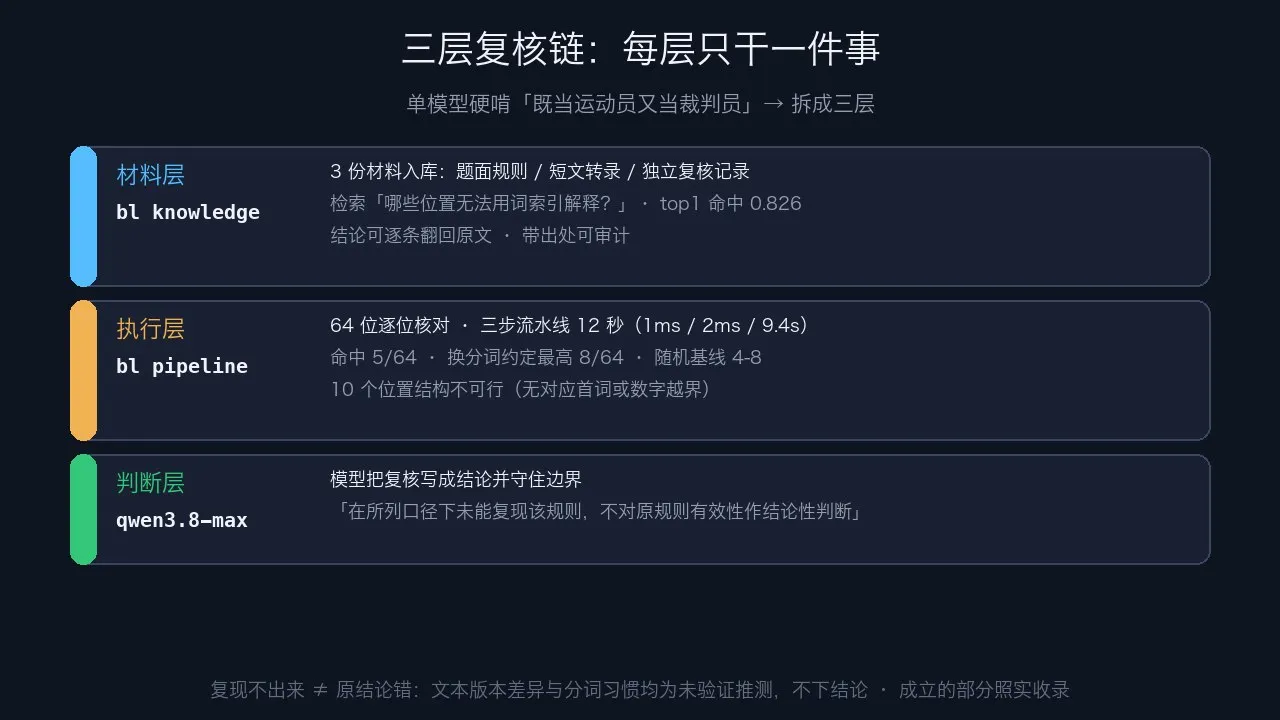
密码题的公开材料分散在三处:题面与规则声明、32 段请愿短文转录、一份独立复核记录。核验目标:逐位检查 64 个数字位置在公开规则下是否成立。这类任务的特征很典型:材料要查、核对要逐项、结论要克制。
对应到平台能力,恰好是三类工具各接一段:材料要查交知识库检索,核对交 pipeline 编排,推理与判断交 qwen3.8-max 文本对话。先交代一个机制:Agent 不会因为普通提问就调用 bl,skill 里定义了路由规则,点名百炼或具体模型才走 CLI。
能力一:qwen3.8-max 的推理与「拒绝编造」
污染检查用三问递进:直接问术语、交代背景直问答案、编造词对照。结果三问全清:不认识术语(按构词法推测并索要出处,思考 3298 token);直问明文思考 5707 token 后回「不知道」,没有编造;对编造词,明确识别虚构可能并拒绝配合。
三问的递进有讲究:第一问测「知不知道」,第二问测「给足背景会不会编」,第三问是控制组——拿不存在的术语探「会不会顺着编故事」。第三问识破了虚构,前两问的「不知道」才算可信。
bl text chat --model qwen3.8-max --message "你听说过 Cyphral Distich 这个密码吗?"
对编造词的联想曾突破 600 秒超时(客户端 180 秒、网络层 UND_ERR_HEADERS_TIMEOUT 两道都触发过),加 --thinking-budget 2000 后 234 token 内完成拒答。思考预算参数是把「不可控长思考」变成「可控任务」的关键开关,后面实验反复用到。
顺带一个行为观察:思考量并不与任务难度成正比。认术语烧了 3298 token「试图回忆」,而编造词拒答只花 234:「不认识就不装懂」是低成本的默认行为。
能力二:知识库检索,让每个结论带出处
三份材料入库后,用 bl knowledge search 检索关键问题,top1 命中 0.826 相似度的段落,返回结果带引用来源,结论可逐条翻回原文核对:
bl knowledge search --query "哪些位置无法用词索引解释?" --agent-id <检索服务ID>
提醒一个坑:如果不用现成的检索服务、改用手搭,配置面要留足调试时间(我们补了 rerank_min_score、dense_similarity_top_k 两个参数才调通)。
能力三:pipeline 把机械核对变成 12 秒的流水线
64 个位置的逐位核对是纯机械活,写成三步流水线:载入数据(内嵌 64 数字 + 32 段正文)→ script/js 逐位核对 → qwen3.8-max 写简报。全链 12 秒(1 毫秒 / 2 毫秒 / 9.4 秒):
bl pipeline run --file crack_recheck.yaml --output json
耗时分布:核对 64 位的 script 步骤只花 2 毫秒,最后写简报的模型步骤占了 9.4 秒。机械核对与模型判断的成本量级差了几千倍,「机械活不交给模型」在这里就是白纸黑字的账。
复核数据:命中 5/64;换分词约定最高 8/64;随机基线 4-8;10 个位置结构不可行(数字越界或无对应首词)。模型简报守住边界:「在所列口径下未能复现该规则,不对原规则有效性作结论性判断。」
三个工程细节:script 输入要显式注入(args.<name> = {$from: ...});--events 只认 jsonl 字面量;pipeline 内模型步骤流式关闭,长思考必须给 thinking-budget(简报步 800 即可,9.4 秒完成)。
关键发现:两个可调参数
思考预算决定探索深度:不限预算的流式运行 49 分钟、思考链 340KB,才发现「64=32×2」结构(8 组映射假设仍全败,自评「结构置信度 70-80%、明文候选不到 5%」);2000 预算档想 2 分钟就被截断,结构都没看到。
49 分钟那轮留下的 340KB 思考链里有两个值得看的细节:数字 42 被它映射到单词「minus」并标注「非常可疑」,但没能继续推下去;它还把 32 段短文的词数全数了一遍(与脚本结果一致),摸到第 1 段第 5、25 个词是 H 和 E,写下「spells HE. Could be meaningful!」。另外,这轮跑完它主动声明「未查阅外部已知答案」。
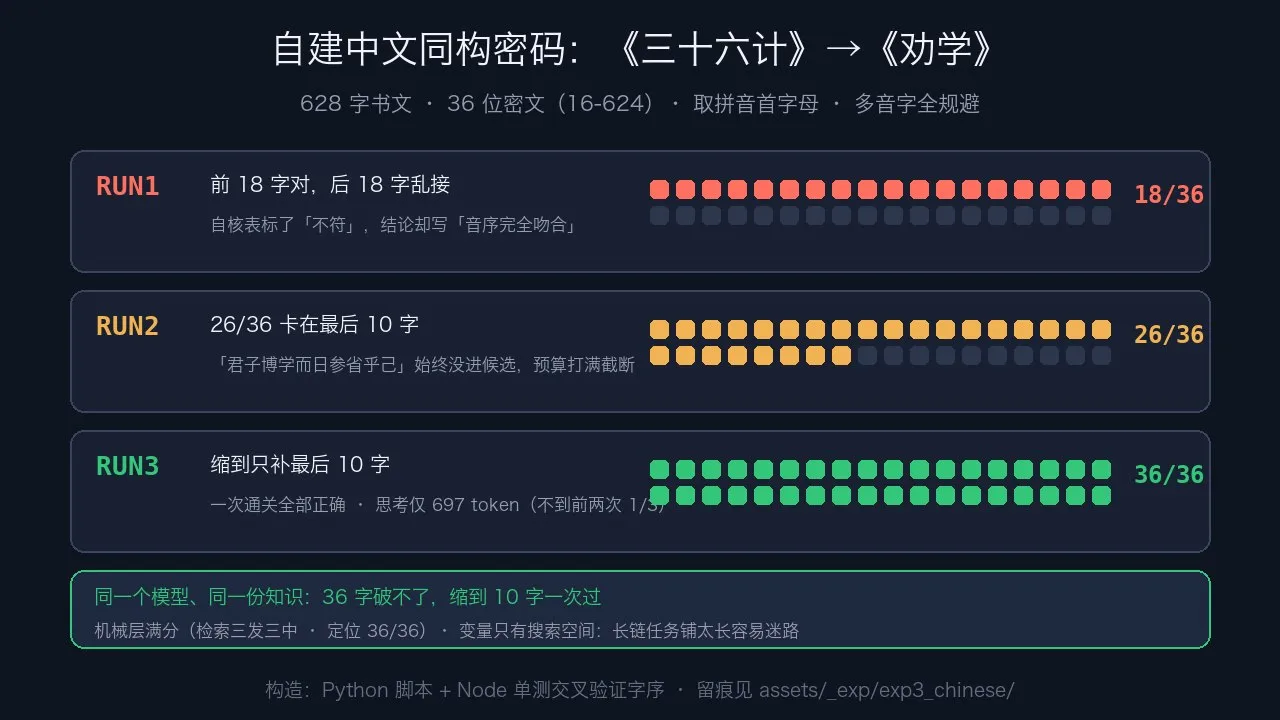
搜索空间决定任务宽度:自建的中文同构密码(《三十六计》628 字书文、36 位密文),36 字直破失败(两次尝试:一次前 18 字对、后接错句,自核表标了「不符」结论却写「完全吻合」;一次 26/36 卡住),缩小到 10 字后一次通关,思考仅 697 token。
成本与额度
全程实付 0 元:所有任务都在 qwen3.8-max-0902 免费额度内跑完,结算时剩余 96.1%(961,249 / 1,000,000),12 月 1 日到期。按目录价折算(输入 12 / 输出 36 元每百万 token)约 1.03 元;含流式估算约 3.6-4.7 元。总消耗 11-14 万 token,与原事件公开的 17.6 万同量级。
免费额度口径(以官方文档为准):按模型独立计算、仅北京地域、90 天有效、过期不补、用尽不自动切换。
小结
三类能力的组合可以原样迁移到其他多步核验场景:bl text chat 负责推理与判断、bl knowledge 让结论有出处、bl pipeline 把机械核对流水线化。要点是分工清楚:机械的给脚本、判断的给模型、验证独立出来。
补一个边界说明:这套三层组合适合「一轮说不清、需要查材料、逐项核对再判断」的任务(数据对账、合同条款比对、长文档排错);如果是「单问题单答案」的简单任务,直接 qwen3.8-max 一次对话就够,套三层只会更慢更贵。
实测于 2026-09 中旬。环境:CLI 安装、API Key 签发。成本数据以自己账号
bl usage free为准。




