
答题 / 考试类小程序的工程复杂度,不在"显示题目、提交答案"这两个表单上,而在题库侧:富文本题怎么存、规则组卷怎么抽、正式考试的脉冲并发怎么扛。这三块决定了系统能不能支撑考证刷题、大型统考和付费题库这类真实业务。本文拆解这三个模块的实现要点。
一、题库侧数据模型:主表、选项表与快照三层
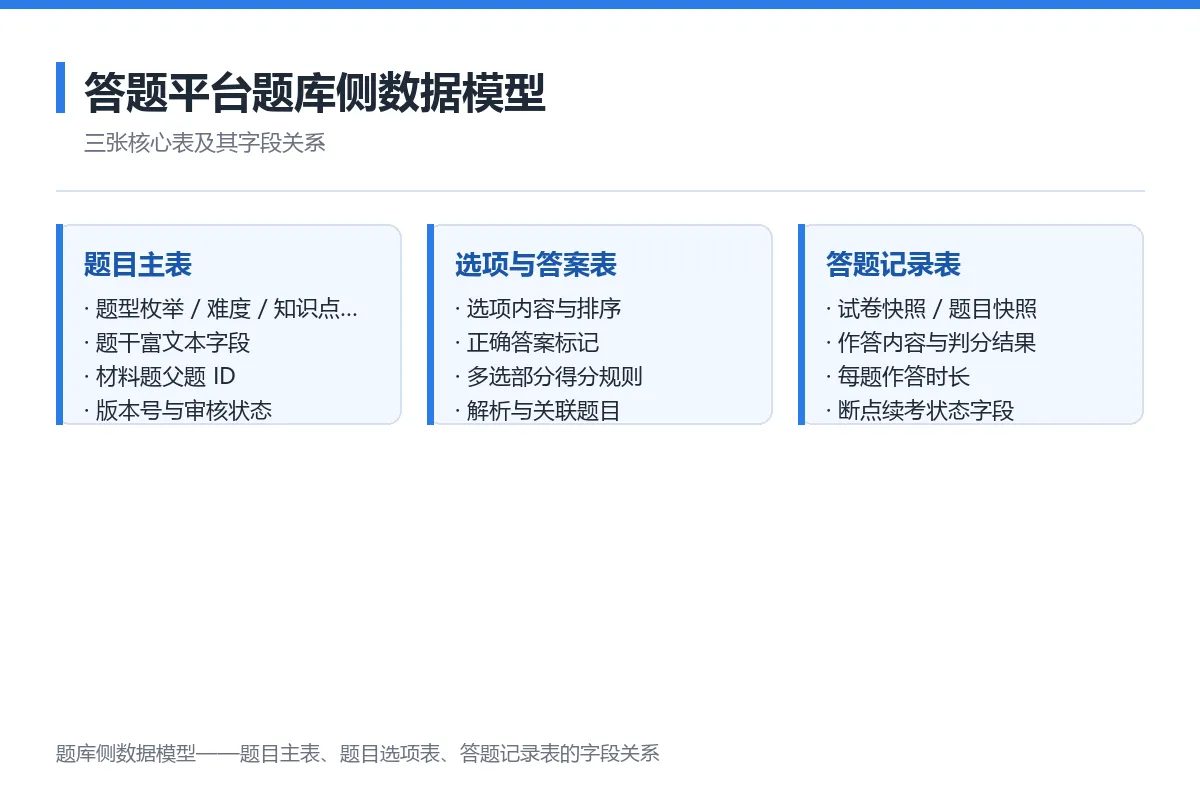
题库侧数据模型——题目主表、选项与答案表、答题记录表的字段关系
1. 题型收敛为枚举,材料题用父子结构
题目主表的题型字段收敛为少数枚举值(单选、多选、判断、填空、材料)。材料题不单独造存储,而是用父子结构:材料本体是一条父记录,子题通过父题 ID 关联,判分时子题独立计分。把材料塞进每道子题冗余存储的做法,改一处材料要同步 N 条记录,是题库系统的经典事故源。
2. 富文本与上下标单独评估
理工、医学类题库绕不开图片、公式与上下标。题干与解析字段要用富文本存储并在渲染端统一处理上下标,不能假定纯文本;录题端的批量导入模板要覆盖图片引用,否则后期录题人力翻倍。
3. 答题记录必须存双快照
答题记录表要同时落试卷快照和题目快照:试卷会改版、题目会被编辑,没有快照,三个月后回看"这次考试到底答了什么"就对不上号。每题作答时长、断点续考状态也落在这张表,是学习分析和异常追溯的数据地基。
二、组卷判分流水线:规则抽题与逐项判分
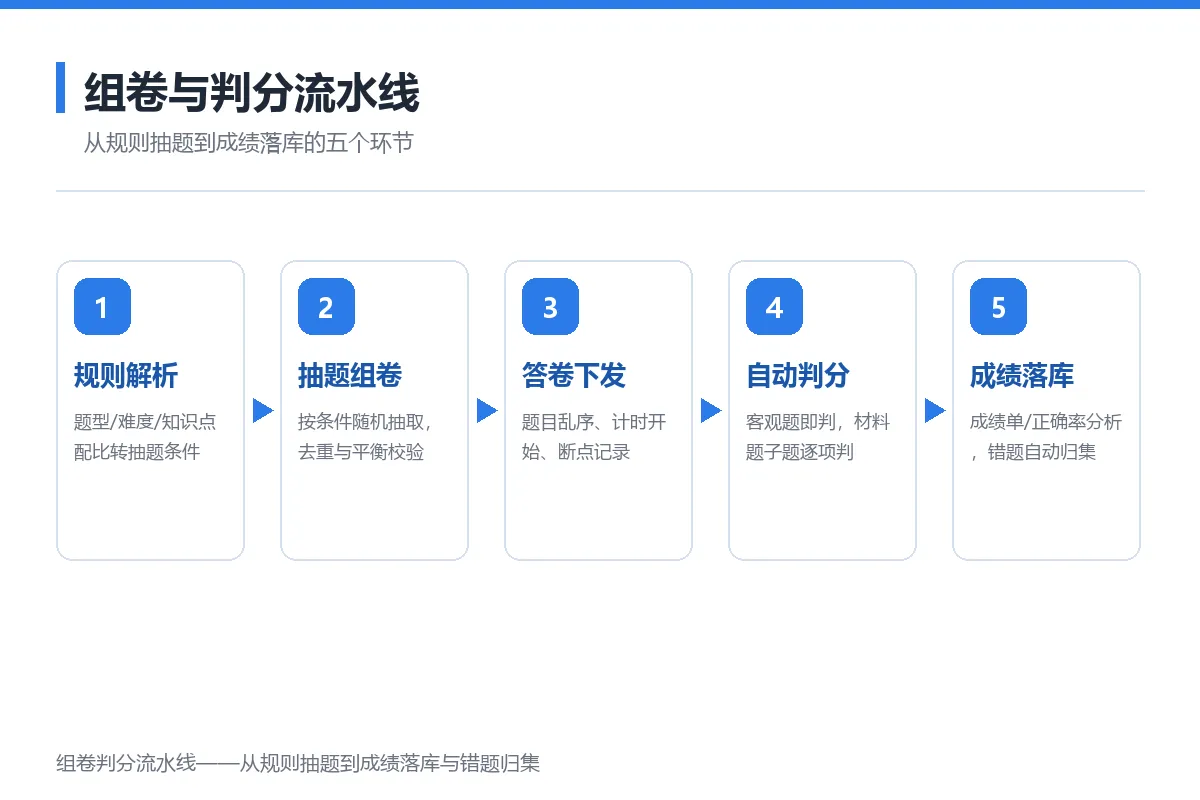
组卷判分流水线——从规则抽题到成绩落库与错题归集
1. 组卷规则转抽题条件
规则组卷的本质是把"题型 / 难度 / 知识点配比"翻译成数据库查询条件,再叠加去重与平衡校验:同一套卷内知识点不重复、总分配平。抽题过程要可重放(记录随机种子或抽题日志),否则考后申诉无法复核"为什么抽到这道题"。
2. 判分规则与题型一一对齐
客观题即交即判;多选的漏选得分、错选不得分要在判分器里配置化,不写死代码;材料题子题逐项判分后汇总到父题。判分器输出要带规则版本号——判分规则后续调整时,历史成绩不能被追溯改写。
3. 成绩落库与错题归集异步化
判分完成后成绩单、每题正确率分析、错题归集进异步任务队列。同步做全量统计是大型考试交卷时段最典型的超时来源;错题归集带幂等键,避免重练列表里同一道错题出现两遍。
三、考试并发:脉冲流量与断网兜底
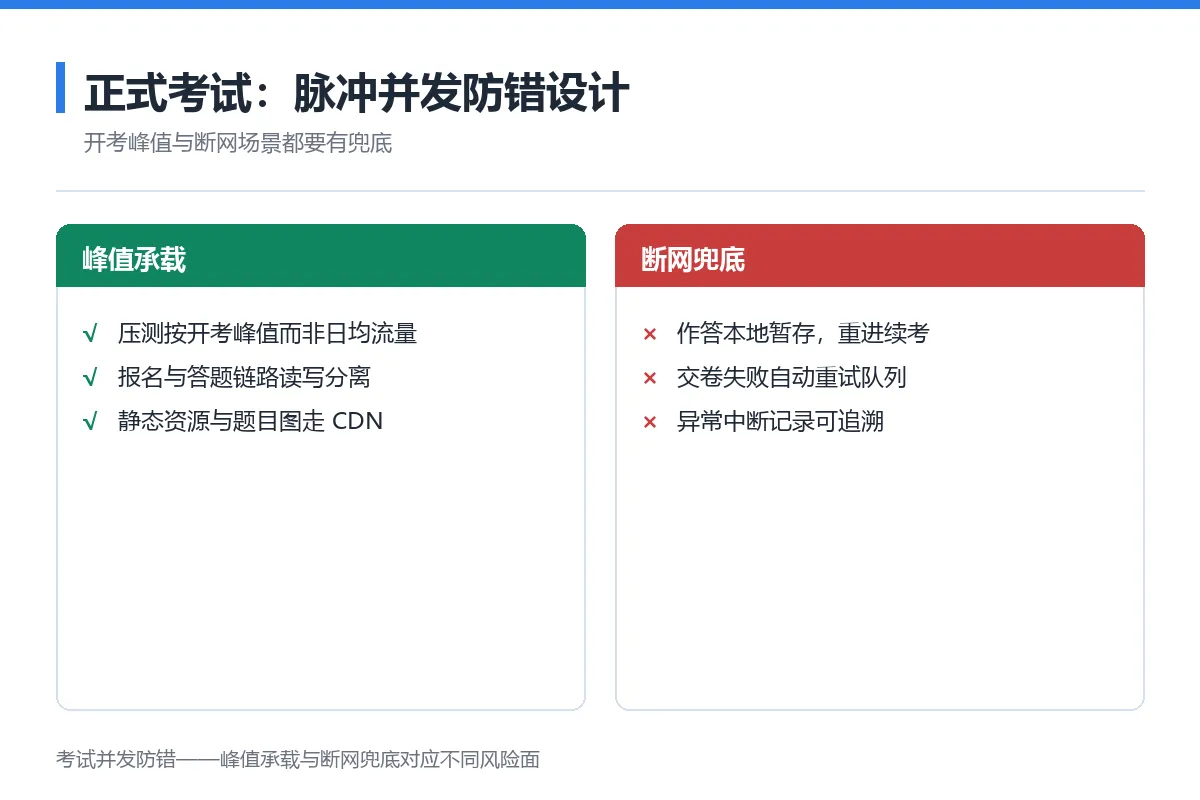
考试并发防错——峰值承载与断网兜底对应不同风险面
1. 容量按开考峰值规划
考试流量是脉冲式的:开考铃响,数千人同一分钟涌进来。报名信息下发、题目下发、答卷提交三条链路要分离,读多写少的题目与图片走 CDN,答卷提交走队列削峰。压测场景必须模拟"开考一分钟内全员进入",而不是日均流量。
2. 断点续考靠本地暂存加状态机
作答内容先落本地暂存(客户端缓存 + 定时同步服务端),断网重进后按续考状态恢复答卷与倒计时;倒计时以服务端为准,客户端时钟不可信。交卷失败进自动重试队列,重试期间答卷锁定防重复提交。
3. 异常全程留痕
切屏、断线、重复登录这类异常事件落事件表,与答题记录关联。大型统考的公平性争议最终都靠留痕说话,事后补记是补不出来的。
结尾:四个高频踩坑
- 题目编辑后答题记录不同步快照,历史考卷失真
- 判分规则写死在代码里,规则一调整历史成绩全错
- 统计同步计算,交卷高峰判分接口批量超时
- 倒计时信任客户端时钟,刷新页面时间重置
题库侧做扎实,刷题留存、付费题库和统考业务才有地基;这三块做浅了,前端再精致也只是个出题表单。




