一、前言
现在大模型已经不再是单纯的Demo演示、学术实验,而是真正落地到智能客服、内容生成、代码辅助、数据分析、AI推理服务等核心业务场景。但很多团队在落地过程中,都会遇到一个共性难题:大模型上线后黑盒化严重,不知道模型效果是否达标、推理链路是否异常、资源成本是否浪费,更无法精准应对数据泄露、服务雪崩、迭代翻车等问题。
传统的软件生产保障体系,聚焦的是代码逻辑、接口稳定性、服务器性能等常规维度,完全适配不了大模型的特殊性。大模型具备概率性输出、上下文依赖、算力高消耗、数据高敏感、迭代高频次的特点,普通的运维监控、测试评测手段,根本无法覆盖模型离线训练、线上推理的全流程风险。
比如很多团队会出现这些痛点:离线训练看不出模型隐性缺陷,上线后出现输出幻觉、逻辑错误;模型推理链路冗长,出问题后无法定位是输入数据、模型权重、推理引擎还是网络调度问题;敏感业务数据在推理、微调过程中存在泄露风险;模型迭代灰度无标准,新版本效果变差无法及时发现;流量峰值来袭时不会降级兜底,故障后回滚无完整方案,同时算力成本居高不下无法优化。今天我们结合实际应用的痛点,深入拆解大模型专属的全链路生产保障体系。
二、体系整体架构
1. 核心架构定位
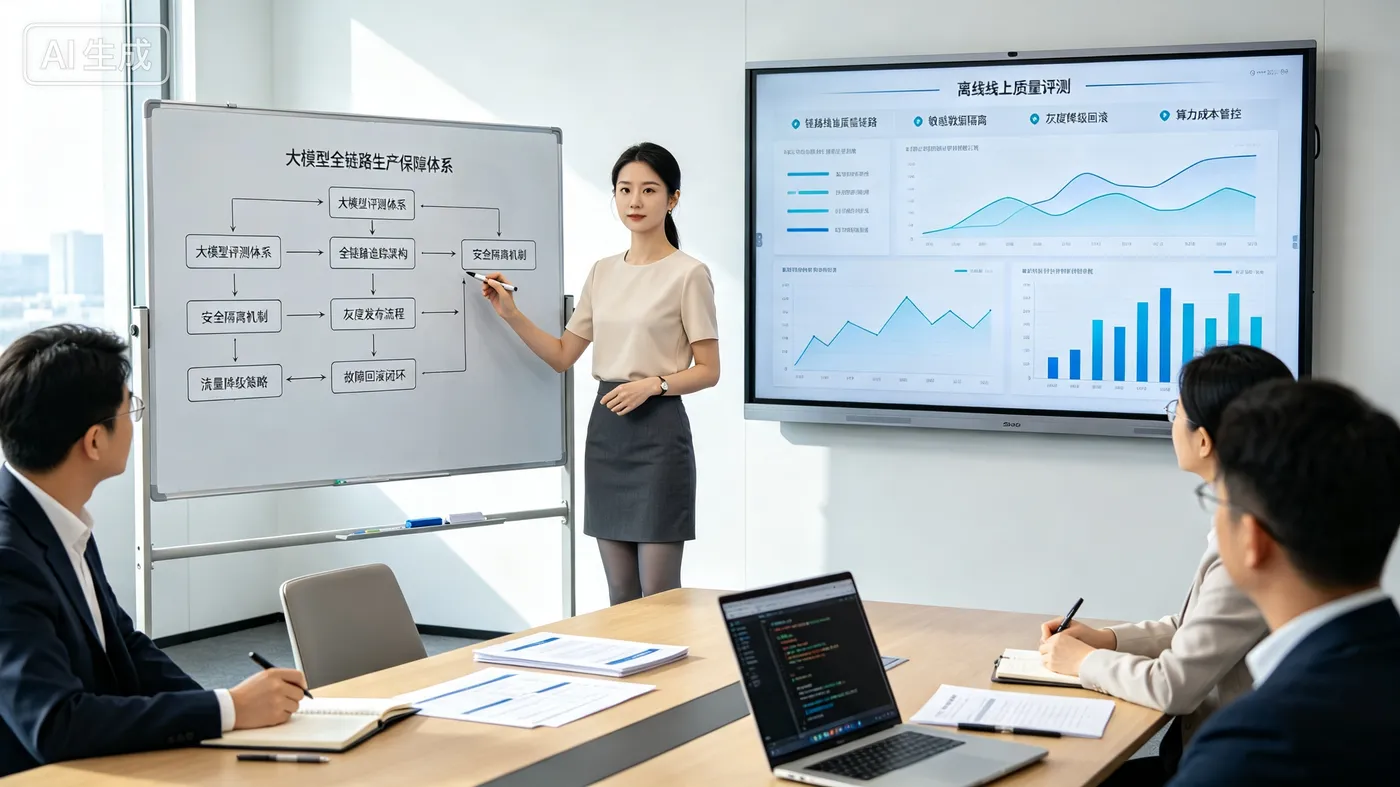
大模型全链路生产保障体系,核心目标是消除AI生产黑盒、全流程可控可管、全风险提前规避、全场景稳定兜底。区别于传统软件运维体系,该体系完全适配大模型训练、微调、推理、迭代的完整生命周期,打通离线研发、线上生产两大场景,实现质量、成本、安全、稳定性四位一体的全域管控。
整套体系分为三大核心层级,层层递进、相互联动,无管控盲区,适配所有大模型落地场景:

第一层:评测体系(基础保障层):
- 作为所有生产稳定的基础,负责提前校验模型能力、排查潜在缺陷,覆盖离线训练评测、线上实时效果评测;
- 同时兼顾质量、成本、安全三大前置校验维度,从源头杜绝不合格模型上线。
第二层:链路追踪体系(问题定位层):
- 作为故障排查、优化迭代的核心工具,打通模型从请求接入、数据预处理、模型推理、结果后处理、响应返回的全链路日志与指标;
- 实现每一次AI请求的可追溯、可定位、可分析,解决大模型黑盒问题。
第三层:生产保障体系(稳定兜底层):
- 作为线上生产的核心屏障,聚焦运行时风险管控,包含数据安全隔离、灰度发布、流量降级、故障回滚、成本管控五大核心能力,应对线上突发风险、迭代风险、资源风险。
2. 全场景覆盖范围
整套体系无死角覆盖大模型生产全场景,彻底解决传统运维的管控缺失问题,具体覆盖维度如下:
- 质量覆盖:离线模型精度、幻觉率、逻辑性评测;线上实时输出准确率、用户满意度、异常输出监控。
- 成本覆盖:离线训练算力消耗、存储资源占用;线上推理单Token成本、并发算力利用率、闲置资源浪费管控。
- 安全覆盖:敏感数据识别、数据脱敏、访问权限隔离、模型权重安全防护、推理链路数据加密。
- 稳定性覆盖:版本灰度迭代、流量灰度切换、峰值流量降级、故障快速回滚、链路异常兜底。
3. 架构落地优势
相较于零散的单点运维工具,这套一体化体系具备三大核心落地优势:
- 1. 全流程闭环,从离线研发前置校验,到线上运行实时监控,再到故障处理、迭代优化,形成完整闭环,无管控断点。
- 2. 精准可控,所有指标可量化、所有链路可追溯、所有风险可预警,告别人工主观判断。
- 3. 适配性强,支持开源大模型、商用API模型、私有微调模型,适配单机部署、集群部署、云原生部署等所有架构。
4. 基础架构实践示例
以下为大模型全链路保障体系核心调度基础代码,实现三大体系的基础注册、场景绑定、全局调度能力,可直接作为项目基础框架使用:
# 大模型全链路生产保障体系 - 核心架构调度
from enum import Enum
from typing import Dict, List, Optional
# 定义生产场景枚举
class ModelEnv(Enum):
    OFFLINE = "offline"  # 离线训练/微调场景
    ONLINE = "online"    # 线上推理生产场景
# 核心保障体系总控类
class LLMPrdSystem:
    def __init__(self):
        # 初始化三大核心体系
        self.eval_system = ModelEvalSystem()       # 评测体系
        self.trace_system = LinkTraceSystem()     # 链路追踪体系
        self.guarantee_system = PrdGuaranteeSystem() # 生产保障体系
        self.env: ModelEnv = ModelEnv.OFFLINE
    def set_env(self, env: str) -> None:
        """设置运行环境,切换管控策略"""
        self.env = ModelEnv(env)
        print(f"【体系切换】当前生效环境:{self.env.value}")
    def full_link_guard(self, request_data: Dict) -> Dict:
        """全链路保障核心调度:评测-追踪-保障一体化执行"""
        # 1. 前置评测校验
        eval_result = self.eval_system.eval_check(request_data, self.env.value)
        if not eval_result["pass"]:
            return {"code": 400, "msg": "模型校验不通过", "data": eval_result}

        # 2. 全链路追踪埋点
        trace_id = self.trace_system.trace_start(request_data)

        # 3. 生产安全保障管控
        guard_result = self.guarantee_system.risk_control(request_data, self.env.value)

        # 4. 链路收尾记录
        self.trace_system.trace_end(trace_id, guard_result)
        return {"code": 200, "msg": "执行成功", "trace_id": trace_id, "data": guard_result}
# 空基类,后续章节逐步实现完整能力
class ModelEvalSystem:
    def eval_check(self, data: Dict, env: str) -> Dict:
        return {"pass": True, "score": 90, "env": env}
class LinkTraceSystem:
    def trace_start(self, data: Dict) -> str:
        import uuid
        return str(uuid.uuid4())
    def trace_end(self, trace_id: str, result: Dict) -> None:
        pass
class PrdGuaranteeSystem:
    def risk_control(self, data: Dict, env: str) -> Dict:
        return {"risk_pass": True, "control_strategy": "normal"}
# 体系初始化测试
if __name__ == "__main__":
    llm_prd = LLMPrdSystem()
    llm_prd.set_env("online")
    test_req = {"prompt": "AI业务查询", "user_id": "123456", "model_version": "v2.0"}
    res = llm_prd.full_link_guard(test_req)
    print("全链路保障执行结果:", res)

三、全维度评测体系
1. 评测体系目标
大模型评测体系是生产保障的第一道关卡,核心价值是前置拦截风险、量化模型能力、杜绝带病上线。传统软件测试侧重功能正确性、接口可用性,而大模型评测需要适配其生成式AI的特性,不仅要测对错,还要测质量、安全、成本、稳定性,同时区分离线研发和线上生产两大场景,实现全时段、多维度量化评测。
很多应用模型在上线后频发问题,核心原因就是缺少标准化评测体系:
- 离线只看简单准确率,忽略幻觉、偏见、逻辑漏洞;
- 线上无实时评测,无法感知模型效果衰减、输出异常;
- 完全不关注评测成本、安全风险,导致上线后出现业务事故、成本超标、数据泄露等问题。
完整的大模型评测体系,需要覆盖离线质量评测、线上实时评测、成本量化评测、安全合规评测四大核心模块,所有指标可量化、可对比、可告警,为模型迭代、上线、灰度提供数据支撑。
2. 离线质量评测
离线评测针对模型训练、微调后的模型权重,在测试环境完成全量校验,是模型上线前的终极质检,核心规避模型本身的能力缺陷和隐性问题。离线评测聚焦四大核心指标,覆盖绝大多数业务场景需求。
- 基础能力指标:包含准确率、召回率、F1值,适配分类、抽取、问答等结构化业务场景,量化模型基础任务的完成能力,确保模型核心业务能力达标。
- 生成质量指标:针对文本生成、文案创作、对话交互等场景,评测流畅度、逻辑性、一致性、冗余度,重点检测模型幻觉问题,统计虚假信息输出占比,杜绝模型编造数据、错误解答的问题。
- 鲁棒性指标:通过异常输入、模糊输入、恶意输入测试模型稳定性,检测模型是否会出现乱码输出、逻辑崩盘、恶意回应等问题,保障模型适配复杂真实业务场景。
- 版本对比指标:针对模型迭代场景,对比新版本与旧版本的各项评测指标,确保迭代后模型能力不退化,杜绝“越更越差”的迭代事故。
3. 线上实时评测
大模型具备明显的动态衰减特性,随着业务数据迭代、上下文场景变化、模型长期运行,会出现效果下滑、输出不稳定的问题,因此仅靠离线评测远远不够,必须搭配线上实时评测能力,实现动态监控。
线上评测不做全量检测,采用抽样评测+关键请求全检的模式,兼顾性能与准确性。针对核心业务请求、高权限用户请求、敏感场景请求进行100%评测,普通流量随机抽样评测,既不影响推理性能,又能全面把控线上模型状态。
线上评测核心关注三大维度:实时输出合规性、用户反馈反向评分、模型推理稳定性。
- 合规性检测是否存在敏感内容、违规话术、泄露信息;
- 用户反馈结合点赞、差评、纠错行为量化模型满意度;
- 稳定性统计超时率、报错率、输出空值率,及时发现模型服务异常。
4. 成本与安全评测
很多团队只关注模型效果,忽略成本与安全评测,导致大模型落地成本失控、合规风险极高。成本评测核心是量化资源消耗,离线统计训练/微调的GPU算力、存储、时长成本,线上统计单轮推理、单Token消耗、并发算力利用率,建立成本阈值,超标自动告警,杜绝资源浪费。
安全评测聚焦合规风险,是企业级落地的必备环节。核心检测模型输出是否存在敏感信息、是否会泄露训练数据、是否存在违规内容、是否可被prompt注入攻击,同时校验模型权限隔离能力,确保不同业务、不同用户的数据不会交叉泄露。
5. 评测体系实践示例
以下实现离线+线上一体化评测核心逻辑,包含质量评分、安全检测、成本统计、结果判定能力,可直接集成到模型上线流程:
# 大模型全维度评测体系实现
import time
import re
from typing import Dict, List, Tuple
class LLMFullEvaluator:
    def __init__(self):
        # 初始化评测阈值
        self.quality_threshold = 85    # 质量合格分数线
        self.cost_threshold = 0.02    # 单条推理成本阈值
        self.safe_pattern = re.compile(r"手机号|身份证|银行卡|隐私地址")
    def eval_quality(self, model_output: str, standard_ans: str) -> float:
        """质量评测:计算输出匹配度、流畅度、幻觉规避得分"""
        # 简单相似度评分(实战可替换为bert相似度、llm评分)
        same_char = set(model_output) & set(standard_ans)
        score = len(same_char) / len(set(standard_ans)) * 100
        # 限制分数区间
        return round(min(score, 100), 2)
    def eval_safe(self, content: str) -> Tuple[bool, List[str]]:
        """安全评测:检测敏感数据泄露"""
        risk_words = self.safe_pattern.findall(content)
        if risk_words:
            return False, risk_words
        return True, []
    def eval_cost(self, token_num: int, cost_per_token: float = 0.0001) -> float:
        """成本评测:计算单条推理成本"""
        return round(token_num * cost_per_token, 4)
    def offline_eval(self, test_datas: List[Dict]) -> Dict:
        """离线批量评测:模型上线前全量检测"""
        total_score = 0
        risk_count = 0
        cost_list = []
        for data in test_datas:
            score = self.eval_quality(data["output"], data["standard"])
            safe_pass, _ = self.eval_safe(data["output"])
            cost = self.eval_cost(len(data["output"]))
            total_score += score
            if not safe_pass:
                risk_count += 1
            cost_list.append(cost)
        # 计算综合指标
        avg_score = round(total_score / len(test_datas), 2)
        avg_cost = round(sum(cost_list) / len(cost_list), 4)
        safe_rate = round((len(test_datas) - risk_count) / len(test_datas) * 100, 2)
        # 上线判定
        pass_flag = avg_score >= self.quality_threshold and avg_cost <= self.cost_threshold and safe_rate == 100
        return {
            "avg_quality_score": avg_score,
            "safe_rate": safe_rate,
            "avg_cost": avg_cost,
            "pass_online": pass_flag,
            "sample_num": len(test_datas)
        }
    def online_eval(self, req_data: Dict) -> Dict:
        """线上单条实时评测"""
        score = self.eval_quality(req_data["output"], req_data.get("standard", ""))
        safe_pass, risk_words = self.eval_safe(req_data["output"])
        cost = self.eval_cost(len(req_data["output"]))
        # 线上实时判定
        return {
            "request_id": req_data["request_id"],
            "quality_score": score,
            "safe_pass": safe_pass,
            "risk_words": risk_words,
            "cost": cost,
            "alarm": not safe_pass or score < self.quality_threshold
        }
# 评测体系测试
if __name__ == "__main__":
    evaluator = LLMFullEvaluator()
    # 离线测试数据
    offline_test = [
        {"output": "人工智能助力企业数字化转型", "standard": "AI助力企业数字化升级"},
        {"output": "大模型生产保障体系包含评测、追踪、兜底能力", "standard": "大模型保障体系含评测、链路追踪、生产兜底"}
    ]
    print("离线评测结果:", evaluator.offline_eval(offline_test))

    # 线上实时测试
    online_test = {"request_id": "test_001", "output": "用户身份证号110xxxx存在隐私风险"}
    print("线上评测结果:", evaluator.online_eval(online_test))

四、全链路追踪体系
1. 链路追踪价值
大模型生产最大的痛点之一就是全链路黑盒化。一次AI请求从用户输入到模型返回结果,会经过请求接入、参数校验、数据预处理、路由分发、模型推理、结果过滤、响应返回数十个环节,一旦出现报错、超时、输出异常、成本飙升等问题,传统的日志排查方式根本无法快速定位根因。

链路追踪体系的核心价值,就是把大模型每一次请求的全流程、全节点、全指标透明化,实现问题可追溯、责任可定位、性能可优化、异常可复盘。不管是线上偶发的幻觉输出、推理超时,还是批量请求的成本突增、接口报错,都能通过追踪链路精准定位问题节点。
区别于传统微服务链路追踪,大模型链路追踪需要额外适配AI专属特性,重点监控Token消耗、推理时长、上下文长度、模型版本、prompt内容、输出内容、算力占用等AI专属指标,彻底适配大模型业务场景。
2. 追踪链路分层
为了实现精细化管控,我们将大模型请求链路分为五层追踪节点,层层拆解、无死角监控,每个节点独立记录日志、指标、耗时、状态。

- 第一层:接入层。记录用户请求信息,包含用户ID、请求时间、接入渠道、请求参数、流量标签,用于区分用户场景、统计流量分布、溯源异常请求来源。
- 第二层:预处理层。监控输入数据清洗、脱敏、截断、拼接过程,记录原始prompt、处理后prompt、上下文拼接长度、敏感数据处理结果,排查输入数据异常导致的模型输出问题。
- 第三层:推理层。核心追踪节点,记录模型版本、推理引擎、GPU算力占用、推理耗时、输入输出Token数、模型采样参数,是排查模型效果、成本、性能问题的核心依据。
- 第四层:后处理层。监控模型输出的过滤、纠错、格式化过程,记录违规内容拦截、输出修正、结果截断等操作,排查后处理逻辑导致的业务异常。
- 第五层:响应层。记录最终返回结果、响应耗时、请求状态、用户反馈,用于统计整体服务稳定性和用户体验。
3. 核心追踪指标
链路追踪不止是记录日志,更要量化核心指标,为优化和运维提供数据支撑,核心分为三类关键指标。
- 性能指标:单请求总耗时、各分层耗时、推理核心耗时、Token生成速度、并发处理量,用于优化服务性能、排查超时瓶颈。
- 成本指标:单次请求输入Token、输出Token、算力消耗、存储占用,用于成本统计和成本优化,精准定位高消耗请求场景。
- 异常指标:各层报错次数、超时次数、空输出次数、敏感内容触发次数、降级触发次数,用于统计服务稳定性、定位高频故障节点。
4. 链路追踪实践示例
以下实现大模型五层全链路追踪能力,支持唯一追踪ID贯穿全流程、分层记录指标、异常日志留存,可对接日志平台、监控平台:
# 大模型全链路追踪体系实现 import uuid import time from dataclasses import dataclass, asdict from typing import Dict, Optional # 定义链路追踪数据结构 class TraceNode: node_name: str # 节点层级名称 start_time: float # 节点开始时间 end_time: float = 0 # 节点结束时间 cost_time: float = 0# 节点耗时 status: str = "success" # 节点状态 error_msg: str = "" # 异常信息 class LLMTraceInfo: trace_id: str # 全局唯一追踪ID request_id: str # 业务请求ID user_id: str # 用户ID model_version: str # 模型版本 total_cost: float = 0 # 总耗时 token_in: int = 0 # 输入Token数 token_out: int = 0 # 输出Token数 nodes: Dict[str, TraceNode] = None # 各层级节点信息 class LLMLinkTracer: def __init__(self): self.trace_cache = {} # 临时缓存追踪链路(实战替换为redis/日志中心) def start_trace(self, request_info: Dict) -> str: """开启全链路追踪,生成唯一ID""" trace_id = str(uuid.uuid4()) trace_info = LLMTraceInfo( trace_id=trace_id, request_id=request_info["request_id"], user_id=request_info["user_id"], model_version=request_info["model_version"], nodes={} ) self.trace_cache[trace_id] = trace_info return trace_id def start_node(self, trace_id: str, node_name: str) -> None: """开启单个链路节点监控""" if trace_id not in self.trace_cache: return node = TraceNode(node_name=node_name, start_time=time.time()) self.trace_cache[trace_id].nodes[node_name] = node def end_node(self, trace_id: str, node_name: str, error_msg: str = "") -> None: """结束单个节点监控,统计耗时与状态""" if trace_id not in self.trace_cache or node_name not in self.trace_cache[trace_id].nodes: return node = self.trace_cache[trace_id].nodes[node_name] node.end_time = time.time() node.cost_time = round((node.end_time - node.start_time) * 1000, 2) if error_msg: node.status = "fail" node.error_msg = error_msg def update_token(self, trace_id: str, token_in: int, token_out: int) -> None: """更新Token成本指标""" if trace_id not in self.trace_cache: return trace = self.trace_cache[trace_id] trace.token_in = token_in trace.token_out = token_out def finish_trace(self, trace_id: str) -> Dict: """结束全链路追踪,生成完整追踪报告""" if trace_id not in self.trace_cache: return {"trace_id": trace_id, "status": "not found"} trace = self.trace_cache[trace_id] # 统计总耗时 total_cost = sum([node.cost_time for node in trace.nodes.values()]) trace.total_cost = round(total_cost, 2) # 转为字典输出 trace_result = asdict(trace) # 清除临时缓存 del self.trace_cache[trace_id] return trace_result # 链路追踪完整测试流程 if __name__ == "__main__": tracer = LLMLinkTracer() # 模拟请求信息 req = {"request_id": "req_002", "user_id": "user_123", "model_version": "v2.0"} # 开启追踪 trace_id = tracer.start_trace(req) # 1. 接入层节点 tracer.start_node(trace_id, "access_layer") time.sleep(0.02) tracer.end_node(trace_id, "access_layer") # 2. 预处理层节点 tracer.start_node(trace_id, "preprocess_layer") time.sleep(0.05) tracer.end_node(trace_id, "preprocess_layer") # 3. 推理层节点 tracer.start_node(trace_id, "infer_layer") time.sleep(0.2) tracer.update_token(trace_id, token_in=128, token_out=256) tracer.end_node(trace_id, "infer_layer") # 4. 后处理层节点 tracer.start_node(trace_id, "postprocess_layer") time.sleep(0.03) tracer.end_node(trace_id, "postprocess_layer") # 生成完整追踪报告 print("全链路追踪报告:", tracer.finish_trace(trace_id))

五、线上生产保障体系
1. 体系核心能力
生产保障体系是大模型线上稳定运行的最后一道防线,也是企业级落地的核心壁垒:
- 评测体系提前规避模型本身问题,链路追踪体系实现问题定位;
- 生产保障体系聚焦运行时风险管控、迭代风险管控、资源风险管控,通过安全隔离、灰度发布、流量降级、故障回滚、成本管控五大核心能力,全方位兜底线上生产风险。
很多AI线上事故的发生,都是因为缺少完善的生产保障机制:
- 模型迭代直接全量上线,出现效果退化无法止损;
- 流量峰值暴涨导致服务雪崩、算力耗尽;
- 敏感数据跨业务泄露;
- 异常请求持续消耗资源导致成本失控。
2. 安全隔离管控
大模型涉及大量用户隐私、业务机密、企业数据,安全隔离是合规落地的前提,核心实现数据隔离、权限隔离、服务隔离三重防护。
- 数据隔离方面,实现不同业务线、不同用户群体的数据独立存储、独立推理,推理过程中禁止跨批次、跨用户数据拼接,同时自动脱敏手机号、身份证、银行卡等敏感信息,杜绝数据泄露。
- 权限隔离方面,搭建分级访问权限体系,模型训练权重、推理日志、业务数据区分管理员、运维、研发、普通用户权限,禁止越权查询、操作敏感数据。
- 服务隔离方面,核心业务、普通业务、测试业务采用独立算力集群部署,测试流量、灰度流量、正式流量物理隔离,避免测试操作、迭代测试影响核心生产服务。
3. 灰度发布机制
模型迭代是常态化操作,直接全量上线风险极高,灰度发布是迭代安全的核心保障。核心思路是流量从小到大、范围从窄到宽、效果实时监控,分阶段完成版本迭代。
灰度分为四个阶段,层层递进、风险可控:
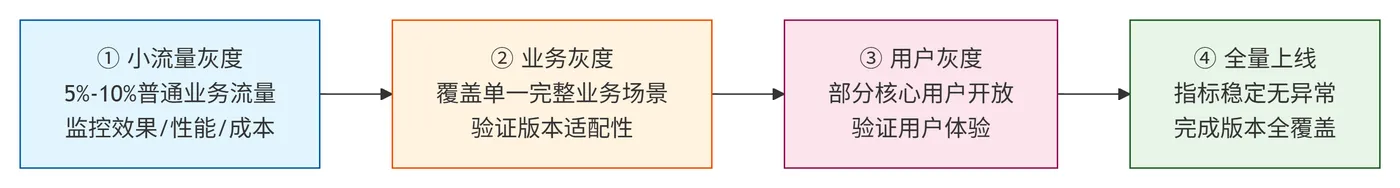
- 第一阶段小流量灰度,抽取5%-10%的普通业务流量测试新版本,监控效果、性能、成本指标;
- 第二阶段业务灰度,覆盖单一完整业务场景,验证版本适配性;
- 第三阶段用户灰度,针对部分核心用户开放新版本,验证用户体验;
- 第四阶段全量上线,所有指标稳定无异常后,完成版本全覆盖。
灰度过程中实时联动评测体系和链路追踪体系,一旦出现质量下降、成本超标、异常增多等问题,立即暂停灰度,自动切回旧版本。
4. 流量降级策略
大模型推理算力消耗高、并发承载能力有限,面对流量峰值、算力故障、依赖服务异常等场景,必须通过降级策略保障核心服务可用,遵循保核心、弃非核心、保稳定、弃极致的原则。
降级分为多级策略,适配不同异常场景:
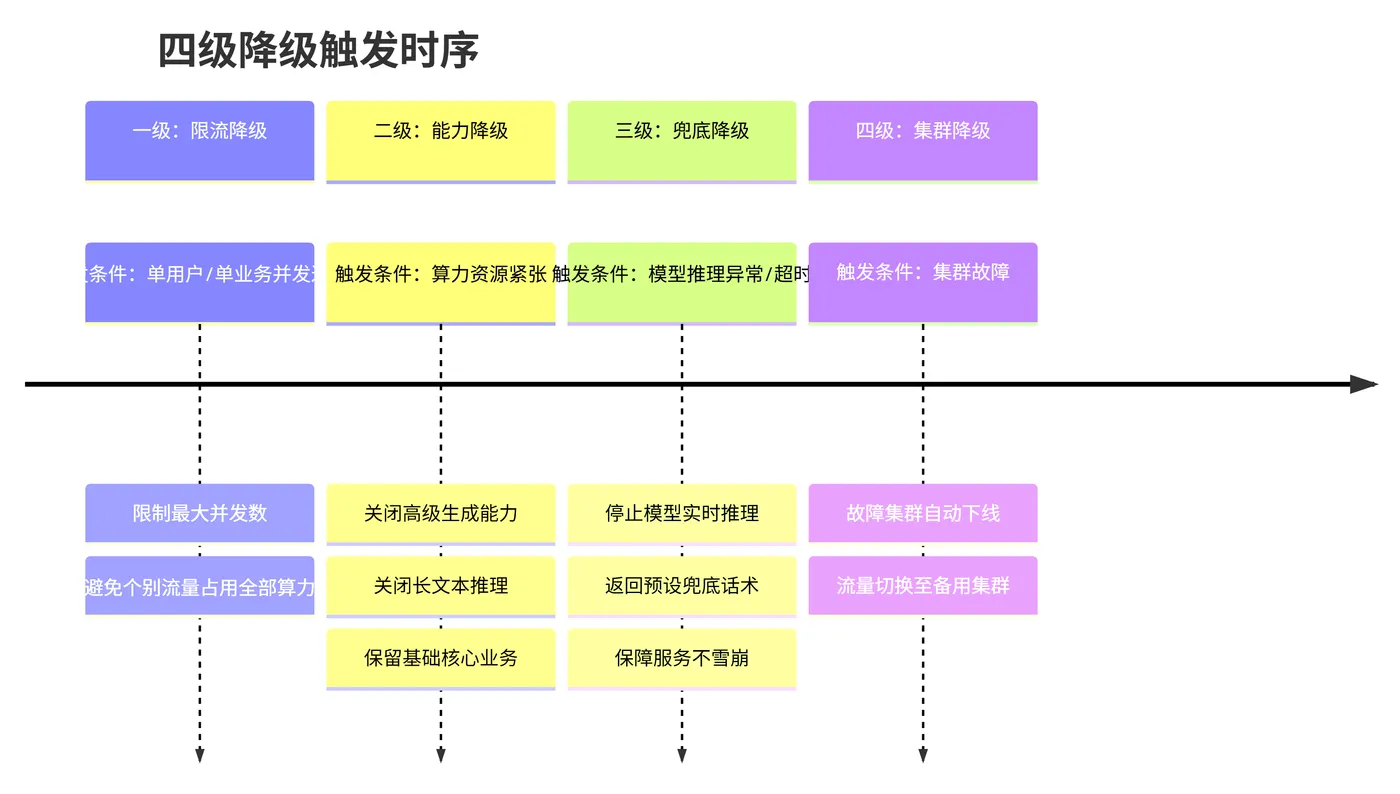
- 一级降级为限流降级,限制单用户、单业务最大并发,避免个别流量占用全部算力;
- 二级降级为能力降级,关闭非核心的高级生成能力、长文本推理能力,保留基础核心业务能力;
- 三级降级为兜底降级,停止模型实时推理,返回预设兜底话术,保障服务不雪崩;
- 四级降级为集群降级,故障集群自动下线,流量切换至备用集群。
5. 故障回滚方案
无论灰度和防护多么完善,线上故障依然无法完全避免,快速回滚是止损的关键。大模型回滚区别于传统代码回滚,需要同时回滚模型版本、配置参数、流量策略、缓存数据,实现全方位还原。
体系支持自动+手动双回滚模式:
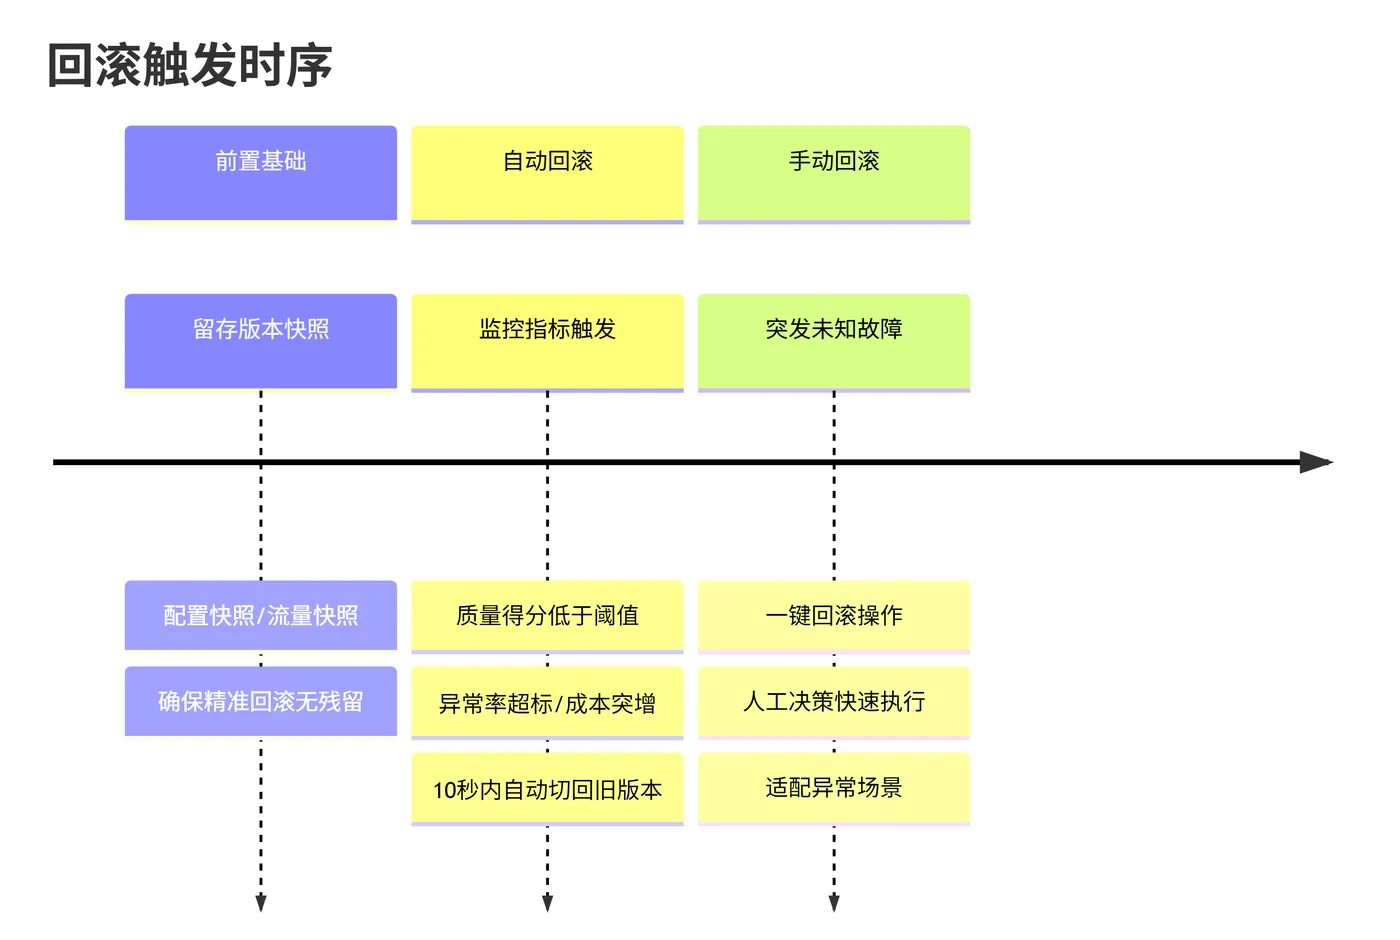
- 自动回滚通过监控指标触发,当新版本质量得分低于阈值、异常率超标、成本突增时,系统自动在10秒内切回稳定旧版本;
- 手动回滚支持一键回滚,适配突发未知故障。
- 同时留存所有版本快照、配置快照、流量快照,确保回滚精准、无残留问题。
6. 生产保障实践示例
以下实现灰度、降级、回滚、安全隔离核心能力,适配线上生产实时管控场景:
# 大模型生产保障体系:灰度、降级、回滚、安全隔离
from enum import Enum
from typing import Dict, Optional
# 定义降级级别
class DegradeLevel(Enum):
    NORMAL = 0    # 正常模式
    LIMIT = 1     # 限流降级
    SIMPLE = 2    # 能力降级
    FALLBACK = 3  # 兜底降级
class LLMProductionGuard:
    def __init__(self):
        self.current_version = "v1.0"    # 当前稳定版本
        self.gray_version = "v2.0"       # 灰度版本
        self.gray_rate = 0.1             # 灰度流量比例
        self.degrade_level = DegradeLevel.NORMAL
        # 业务隔离配置
        self.business_isolate = {
            "core": ["service_01", "service_02"],
            "normal": ["service_03"],
            "test": ["test_01"]
        }
    def security_isolate(self, business_type: str, req_data: Dict) -> Dict:
        """安全隔离:业务流量隔离+敏感数据脱敏"""
        # 1. 业务集群隔离校验
        if business_type not in self.business_isolate.keys():
            return {"pass": False, "msg": "非法业务渠道"}

        # 2. 敏感数据脱敏
        sensitive_keys = ["id_card", "phone", "bank_card"]
        for key in sensitive_keys:
            if key in req_data:
                req_data[key] = req_data[key][:3] + "****" + req_data[key][-4:]
        return {"pass": True, "msg": "隔离校验通过", "data": req_data}
    def gray_switch(self, request_id: str) -> str:
        """灰度流量分发:按比例分配新旧版本"""
        # 简单哈希实现流量均匀分发
        hash_val = int(request_id[-4:], 16) / 0xFFFF
        if hash_val < self.gray_rate:
            return self.gray_version
        return self.current_version
    def degrade_control(self, qps: int, max_qps: int = 100) -> DegradeLevel:
        """动态降级策略:根据流量压力调整降级级别"""
        if qps < max_qps * 0.7:
            self.degrade_level = DegradeLevel.NORMAL
        elif qps < max_qps * 0.9:
            self.degrade_level = DegradeLevel.LIMIT
        elif qps < max_qps:
            self.degrade_level = DegradeLevel.SIMPLE
        else:
            self.degrade_level = DegradeLevel.FALLBACK
        return self.degrade_level
    def rollback_version(self) -> Dict:
        """故障一键回滚至稳定版本"""
        old_gray = self.gray_version
        self.gray_version = self.current_version
        self.gray_rate = 0
        self.degrade_level = DegradeLevel.NORMAL
        return {
            "rollback_success": True,
            "rollback_from": old_gray,
            "rollback_to": self.current_version,
            "status": "stable"
        }
# 生产保障能力测试
if __name__ == "__main__":
    guard = LLMProductionGuard()

    # 1. 安全隔离测试
    test_req = {"phone": "13812345678", "business_type": "core"}
    print("安全隔离结果:", guard.security_isolate("core", test_req))

    # 2. 灰度分发测试
    print("灰度版本分发:", guard.gray_switch("req_003"))

    # 3. 动态降级测试
    print("流量降级策略:", guard.degrade_control(95))

    # 4. 版本回滚测试
    print("故障回滚结果:", guard.rollback_version())

六、体系联动与闭环
1. 三大体系联动逻辑
评测、链路追踪、生产保障三大体系并非独立运行,而是相互联动、数据互通、闭环迭代的整体,这也是整套体系能够实现全场景保障的核心。单一体系只能解决单点问题,三者联动才能实现从风险预防、问题发现、故障兜底、优化迭代的完整闭环。
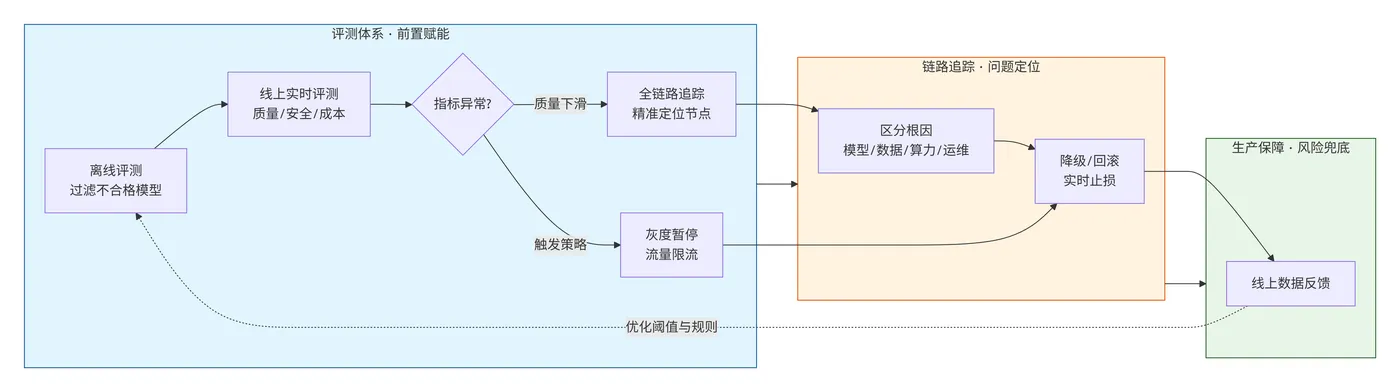
首先是评测体系前置赋能:
- 离线评测过滤不合格模型,阻止劣质版本上线;
- 线上实时评测持续输出质量、安全、成本指标,为链路追踪和生产保障提供判定依据;
- 比如评测发现质量下滑,自动触发链路追踪排查根因,同时触发生产保障的灰度暂停、流量限流策略。
其次是链路追踪承接问题定位:
- 当评测指标异常、线上出现故障、成本超标时,通过全链路追踪数据精准定位问题节点,区分是模型本身问题、数据问题、算力问题还是运维配置问题,为生产保障的降级、回滚、优化提供数据支撑。
最后是生产保障实现风险兜底与迭代优化:
- 通过安全隔离、灰度、降级、回滚实时止损,同时将线上运行数据反馈至评测体系,优化评测阈值和评测规则,形成持续迭代的正向循环。
2. 全场景落地闭环
整套体系落地可实现七大核心场景的完整闭环管控,彻底解决大模型生产落地各类痛点。
- 质量闭环:离线评测准入→线上实时监控→异常链路定位→模型优化迭代→重新评测上线,持续提升模型质量。
- 成本闭环:离线成本预估→线上实时统计→高消耗链路定位→算力优化+参数调优→成本阈值更新,持续降低落地成本。
- 安全闭环:离线安全检测→线上实时脱敏隔离→风险链路溯源→规则迭代优化→合规常态化管控。
- 迭代闭环:新版本离线评测→小流量灰度观测→全链路监控校验→全量上线→线上数据复盘迭代。
- 故障闭环:异常指标告警→链路快速定位→降级止损/版本回滚→问题复盘→规则优化规避复发。
3. 落地最佳实践
为保障整套体系高效落地,结合行业实战经验,总结三点核心最佳实践:
- 1. 量化优先,所有质量、成本、安全、稳定性指标必须可量化、可告警、可统计,杜绝主观判断,让运维和迭代有数据支撑。
- 2. 自动化优先,将评测、追踪、告警、降级、回滚全部自动化,减少人工干预,提升故障响应速度,降低人为失误风险。
- 3. 常态化迭代,根据业务场景变化、模型迭代特性,持续优化评测规则、监控指标、保障策略,适配业务发展。
七、总结
大模型生产落地的核心难点,从来不是模型训练和部署,而是规模化、常态化、稳定化的生产运维保障。传统的人工测试、被动运维、事后复盘的模式,完全无法适配生成式AI的不确定性和高风险性。依靠“评测+链路追踪+生产保障”三位一体体系,很好的解决了大模型生产落地的所有核心痛点,实现大模型从研发迭代到线上运维的全生命周期管控,既解决了模型效果不稳定、故障难排查的技术问题,又解决了数据不安全、成本不可控、迭代风险高的业务问题。
未来大模型的生产运维,一定会朝着智能化、自动化、精细化的方向发展。在我们实践的过程中,叠加AI智能告警、智能根因分析、自适应灰度、动态成本优化等能力,进一步降低运维成本、提升服务稳定性,让大模型更安全、更高效、更稳定地赋能各类业务场景,真正实现AI工程化、规模化落地。