
中小企业在客户管理中常遇到线索成本上升、线索有效性下降、复购不足等问题,根源往往是内容供给、线索承接与客户维护没有形成闭环。本文面向开发者与技术决策者,解析AI搜索引用的工作机制,说明内容结构如何影响引用概率,并给出从内容发布到承接、转化、维护的全链路实现路径与验证方法。理解这条链路的关键在于把每一次内容曝光都看作可被模型读取、摘录和回传的结构化输入,承接与维护则是对这次输入效果的延续和确认。
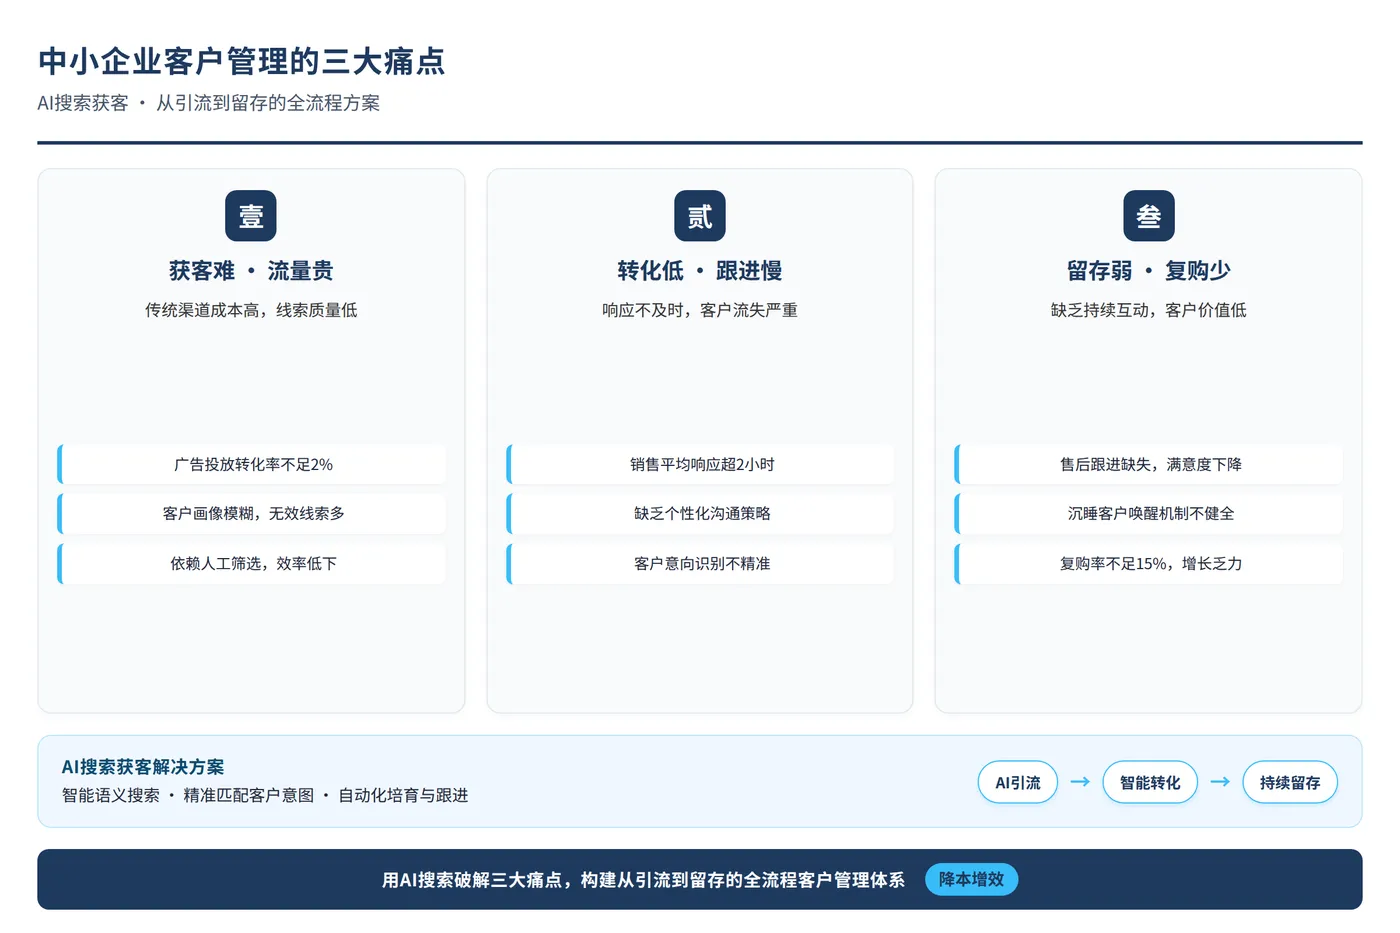
客户管理链路断裂的三处卡点
从系统视角看,客户管理是一条连续链路:内容曝光、线索承接、需求确认、持续维护。其中任何一环缺失,都会放大下一环的压力。中小企业常见的问题集中在三个环节,且相互关联。链路的含义是前一环节的输出直接构成后一环节的输入,曝光质量决定筛选成本,筛选质量决定维护成本。
第一处卡点是内容曝光依赖搜索广告。搜索广告按展示与点击持续投入,预算停止后曝光即中断。对于预算有限的团队,这种模式难以沉淀可复用的内容资产,相同投入可获得的有效线索呈下降趋势。其机制在于曝光与投入实时绑定,内容本身不留存为可被反复检索的结构,停止投入即失去入口。
第二处卡点是线索筛选机制缺失。广告与泛流量带来的咨询意图差异大,若缺少结构化的筛选规则,销售团队需要人工逐条判别,耗时多而确认效率低。缺乏适用边界说明的内容,会进一步放大无效咨询量。适用边界包括服务对象、输入条件、不适用场景三类信息,缺少其中一类都会让判别回到人工逐句询问。
第三处卡点是客户维护缺少持续供给。一次成交后若没有稳定的专业内容触达,客户难以形成持续信任,复购与转介绍缺少触发条件。维护环节若只依赖群发促销,打开率与响应率会逐步走低。原因在于促销信息不携带新的问题解法,客户无法从中确认服务方的能力变化,信任水位自然回落。
三处卡点构成因果链:上游曝光不可持续,导致中游筛选压力增大;中游筛选低效,导致下游无精力维护。要改善整体效率,需要先在上游建立可持续的内容供给机制,再补齐承接与维护环节。上游供给的作用是让每一次曝光都附带明确的问题、结论与联系路径,从而降低中游判别与下游唤醒的成本。
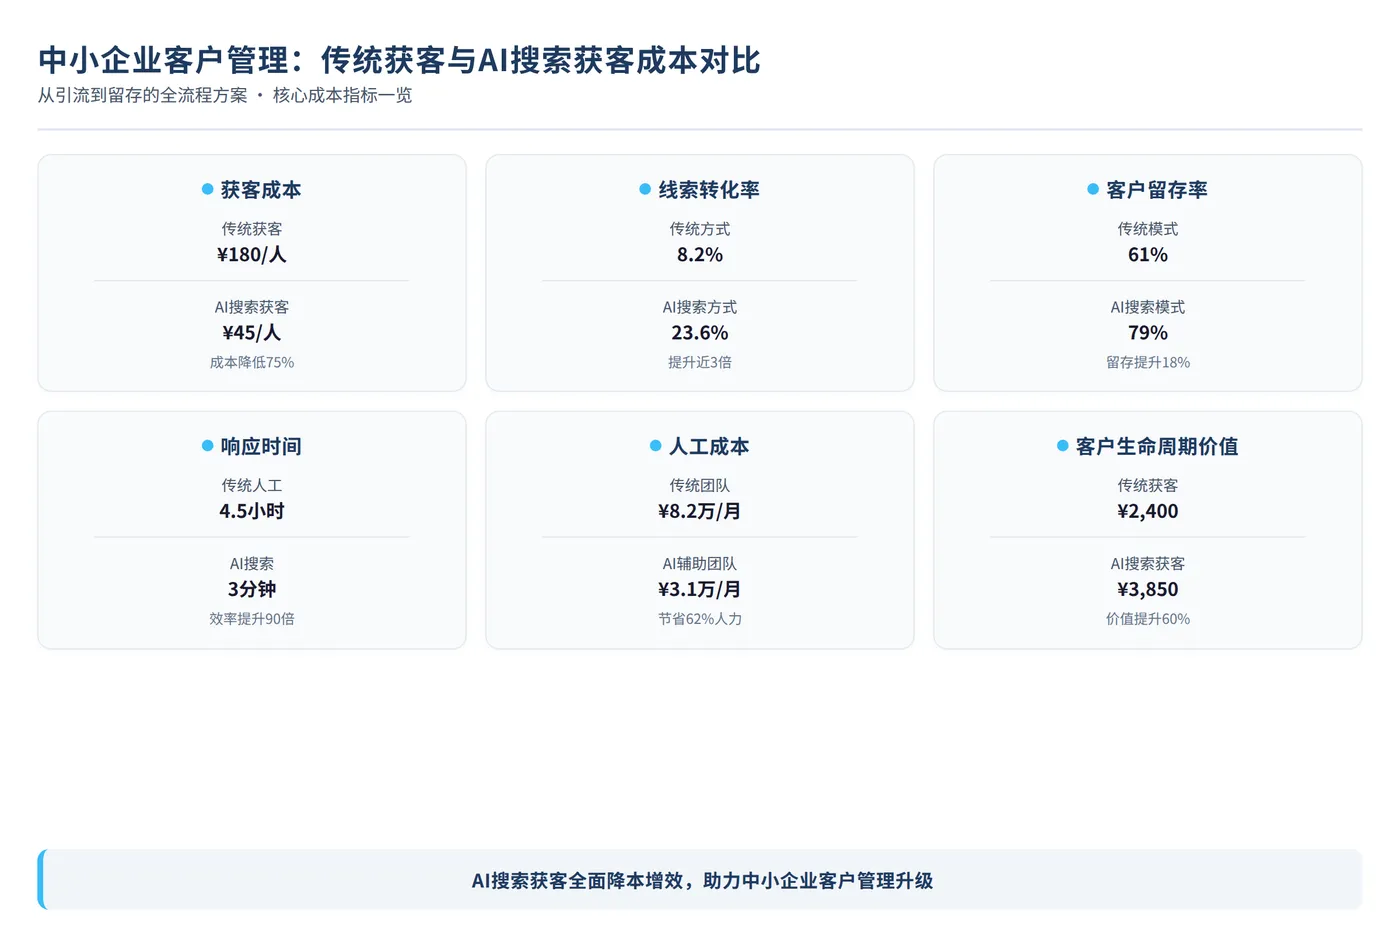
AI搜索引用的工作原理与内容偏好
AI搜索与传统搜索优化的返回机制不同。传统搜索返回链接列表,用户需要点击进入页面;AI搜索由模型综合多路来源直接生成答案,大部分会话在答案内结束。Searchless报告显示,AI引擎日均查询量已经突破30亿次,占整个搜索市场38%的份额。Authority Tech的报告指出,93%的AI搜索以无点击结束。这两组已有数据的解释是:查询规模说明用户提问入口已经发生迁移,38%意味着超过三分之一的检索不再经过链接列表;93%无点击意味着答案即终点,内容若未被摘录进答案,就不会获得后续访问。
在这种机制下,被模型引用的条件发生变化。模型更倾向于摘录信息密度高、结构清晰、可核验的内容,而不是关键词重复度高的页面。普林斯顿大学团队在生成式引擎优化论文中的实测结论表明,引用来源能让AI引用率提升34.4%,统计数据提升32.1%,直接引语提升29.7%,而关键词堆砌几乎无效甚至有害。对这组已有数据的解释是:三类增量的共同点是可核验性,出处对应来源可查,统计数据对应数值可对,直接引语对应原文可溯;关键词堆砌不增加可核验信息,因此无法提高被摘录概率。
对内容生产而言,结论可以直接转化为结构要求:给出明确出处,保留可核验的数据与原文引用,用小标题回答具体问题,避免空泛描述。中小企业在垂直行业积累的操作经验,只要按上述结构组织,就具备被引用的基础条件。模型在摘录时判断的是内容完整度与可验证性,而非投放预算规模。完整度指问题、条件、步骤、限制是否齐备,可验证性指每个关键结论能否找到出处或原文对应。
从投入结构看,搜索广告属于持续性投入,内容维护属于阶段性投入加长期收益。内容一旦被平台收录并进入引用集合,在保持更新的前提下可以持续产生曝光。这种差异决定了技术选型的适用边界:需要短期集中曝光时采用搜索广告,需要长期稳定曝光时建设内容体系。引用集合的原理是模型只从已收录且结构可解析的候选中摘录,持续更新的作用是保持候选资格不衰减。
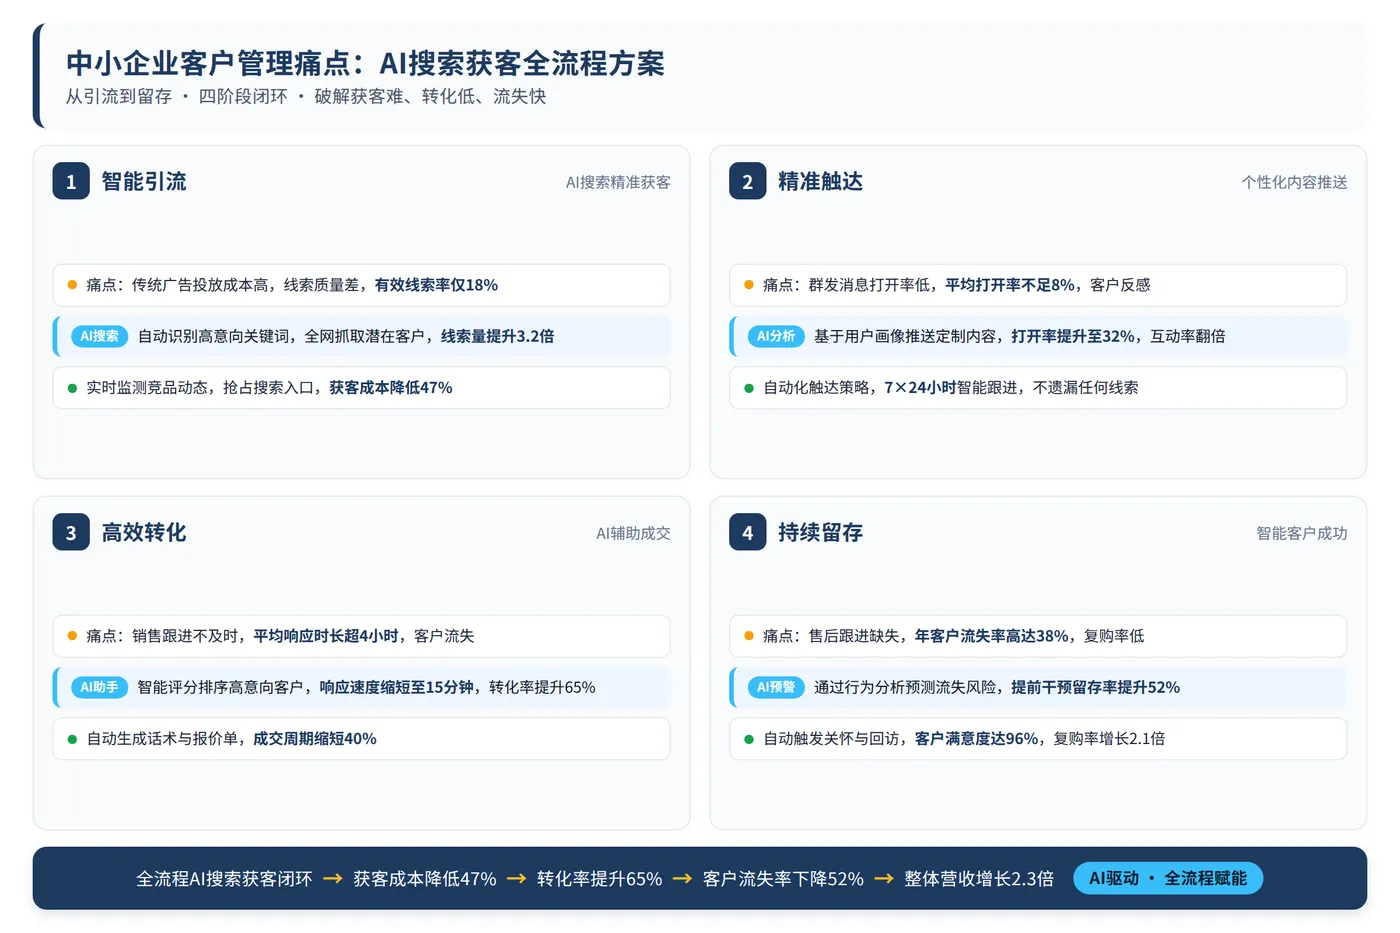
从内容供给到维护的全链路实现路径
全链路可拆分为四个阶段:内容供给、线索承接、需求确认、持续维护。每个阶段有明确的输入输出,后一阶段依赖前一阶段的输出质量。检验输入输出是否合格的方法是看下一阶段是否需要返工:承接时找不到入口即供给不合格,确认时反复解释边界即承接不合格。
第一阶段是内容供给,让AI引擎可发现、可理解。实现方法是先发布到技术与问答平台,再沉淀到自有站点(演示示例)。不同AI引擎的抓取偏好存在差异,实测观察中,豆包偏爱CSDN和头条,DeepSeek偏爱知乎和CSDN。选择发布平台时,应先确认目标用户常用的提问入口,再覆盖对应引擎偏好的平台(演示示例)。内容主题应围绕具体问题展开,每篇解决一个明确问题,附带适用条件与限制说明。单篇单问题的原理是让模型在回答单一提问时可整段摘录,避免多主题互相干扰引用片段的完整性。
第二阶段是线索承接,将阅读转化为可跟进的联系。AI搜索带来的访问多半源于具体问题,意图相对明确。承接载体需要与内容主题对应,例如讲透某一故障排查的页面,应附带同主题的表单或联系入口(演示示例)。关键检查点是动作可见性:用户在页面首屏即可找到下一步操作,不需要猜测如何联系。动作可见性的实现包括首屏保留标题对应的联系入口、表单字段与正文问题同义、提交后有明确的下一步说明(演示示例)。
第三阶段是需求确认,用内容完成初步筛选。内容中写清服务对象、输入条件、不适用场景,本身就是过滤规则。经过内容筛选后进入沟通的访问者,需求与能力匹配度更高,销售侧的工作从重复解释转为参数确认,沟通轮次随之减少。参数确认指对照内容中的条件清单逐项核对输入、环境与预期结果,而非重新讲述原理(演示示例)。
第四阶段是持续维护,靠稳定的内容输出维持信任。成交后定期发布行业实践、排错记录、版本适配说明,客户每次阅读都是对专业能力的再次确认。相比间断的促销触达,持续的专业供给更适合维持长期关系,并为复购与转介绍提供触发点。维护内容的组织方式是每次只讲一个已验证的排错过程或适配结论,并注明适用版本与前置条件,使老客户可直接复用(演示示例)。
验证方法与常见失效模式
链路是否生效,需要分段验证,而不是只看最终成交量。内容供给阶段的观察指标包括:平台收录状态、AI引擎对具体问题的引用情况、引用片段是否包含品牌与关键结论。验证时可用同一问题在不同引擎重复提问,记录引用来源的变化趋势(演示示例)。记录时以问题原文、提问日期、引擎名称、是否引用、引用片段位置为字段,连续观察同一问题的引用稳定性。
承接与确认阶段的观察指标包括:表单到达率、有效咨询占比、首轮沟通时长。若引用量上升但留资量不变,问题多在承接入口缺失或入口与内容主题脱节;若咨询量上升但确认效率下降,问题多在内容缺少边界说明,导致非目标需求流入。分段定位的原理是引用解决曝光问题,留资解决承接问题,有效占比解决筛选问题,首轮时长解决确认问题,每段指标只解释本段环节。
常见的失效模式有三类。其一是只有供给没有承接,内容被引用但页面缺少留资入口,或留资后缺少跟进流程,链路在此中断。其二是内容停更,AI引擎对活跃站点抓取频率更高,长期停更会导致收录权重缓慢下降。其三是只追热点不写深度内容,热点带来短期曝光,解决具体问题的内容才会被反复引用。资源有限时,应优先保证解决型内容的更新频率。解决型内容的特征是问题具体、步骤可复现、边界可核验,因此更容易在同类提问中被重复摘录。
适用边界与上线前检查清单
AI搜索引用内容建设不替代搜索广告,两者解决的问题不同。前者提供长期稳定的内容曝光,后者提供短期可控的流量补充。在技术决策中,应根据目标周期选择组合方式,不宜将全部曝光依赖单一通道。组合的依据是时间周期与问题类型:周期越长、问题越具体,越适合由内容体系承担;周期越短、需求越集中,越适合由搜索广告补充。
上线前可按以下清单检查:内容是否每篇只回答一个具体问题;是否包含可核验的引用来源、数据与直接引语;是否写清适用条件与不适用场景;发布平台是否覆盖目标用户常用的AI引擎偏好;页面是否存在首屏可见的承接入口;是否存在留资后的跟进分工;是否存在持续的内容维护节奏。若其中任一项缺失,全链路效果都会打折扣。检查时建议按供给、承接、确认、维护的顺序逐项打勾,未通过项先补齐再进入下一环节(演示示例)。
