一、前言
我们的第一个RAG示例,大家应该都是一样,简单接一两个业务接口,页面效果看着很不错,演示的时候回答流畅,看起来一切完美。可一旦推到真实业务环境,各种问题就接踵而至:大模型随便编造业务数据、越权调用内部接口、重复执行接口产生脏数据、找不到历史对话上下文、调用工具返回结果错乱,出了问题还查不到调用链路,故障排查两眼一抹黑。
原型环境只关心 “能不能回答”,生产环境要关心 “回答对不对、调用安不安全、出问题可追溯”。真正企业级大模型应用,不是单纯提升模型本身的推理能力,而是要补齐上下文管理、知识底座、工具调用整套能力,按需选用 RAG、长短期记忆、业务 API、MCP 协议,同时把校验、鉴权、最小权限、幂等、审计这套安全底座做扎实。
开发过程种容易陷入误区:把全部希望寄托大模型本身,认为模型越强大,业务应用就越稳定。但现实中,大模型本质是概率生成模型,天生会幻觉、会输出错误参数、会随意选择工具。模型负责理解用户意图,而确定性、安全性、业务正确性,必须由应用层框架来兜底。

二、核心工具体系
1. 了解上下文‑知识‑工具体系
大模型本身的知识存在两大短板:一是模型训练截止之后,没有新增的实时业务知识;二是模型不具备访问外部系统、操作业务数据的能力。
- 上下文:承载本轮、多轮对话的会话信息,包含用户提问、模型回复、工具入参出参,让模型理解对话历史;
- 知识能力:外部私有知识,解决模型不知道的业务文档、规则、静态资料,典型实现就是 RAG 检索增强;
- 工具能力:让模型可以主动调用外部能力,包含自研业务 API、MCP 标准化工具协议,实现查询数据库、提交工单、查询业务状态等操作。
三者不是互相替代,而是互补关系:
- 上下文解决 “对话记得住”;
- 知识 RAG 解决 “静态资料答得准”;
- 工具 API/MCP 解决 “真实业务做得到”。
大模型只做意图理解与参数生成,业务正确性、安全约束绝对不能交给模型自主决定,所有外部调用必须经过应用层校验拦截,不能完全信任大模型输出的参数。很多项目直接把模型输出的 JSON 直接拿去调用接口,这是生产环境重大隐患。模型输出随时可能格式错乱、参数越界、传入非法字段,必须在应用侧增加一层校验网关。
2. 各组件简单区分
- RAG:面向静态知识库,文档、手册、历史台账,读多写少,查询已有知识,不修改业务;
- 记忆 Memory:面向会话历史,分为短期会话记忆、长期用户记忆,记住用户偏好、历史对话事件;
- 业务 API:企业内部已有接口,查询订单、提交审批,处理真实业务读写逻辑;
- MCP:标准化工具调用协议,统一管理多源工具,屏蔽不同工具的调用差异。
通常容易混淆RAG和记忆:RAG是知识检索,查文档资料;记忆是会话记忆,记住用户交互历史。一个查资料,一个记对话,二者使用场景完全不一样。
典型场景简单说明:
- 用户问产品手册、制度文档 → 使用 RAG,检索知识库,把参考片段塞进上下文;
- 用户多轮聊天,记得上一轮用户输入、用户个人偏好 → 使用会话记忆 / 长期记忆;
- 需要查询订单、提交业务单据,读写业务数据 → 调用业务 API;
- 需要对接大量异构工具,统一注册、发现、调用工具 → 使用 MCP 协议做工具管理层。
切忌万能组件思维,不要所有场景全部上RAG,动态实时业务强行用RAG,会带来大量数据更新、同步开销。动态数据优先走 API 查询。
3. 完整链路流程
Agent处理用户请求的完整推理链路:先加载会话记忆、判断是否检索RAG知识或调用外部工具,经校验后执行工具调用并记录审计日志,最后将结果回填上下文、整合输出回答。全程实现知识增强、安全管控与可追溯性。

步骤说明:
- 1. 用户提问:用户输入自然语言问题,触发请求处理流程。
- 2. 加载会话记忆:加载当前会话的历史记录、对话上下文、用户偏好等状态数据。
- 3. 判断是否需要检索RAG知识:根据问题类型判断是否需要从知识库检索补充信息。
- 4. 检索知识库:从RAG知识库中检索与问题相关的文档片段或知识内容。
- 5. 知识注入上下文:将检索到的知识内容注入到模型推理上下文中。
- 6. 判断是否需要调用外部工具:判断是否需要调用外部工具(如API、MCP服务)获取实时数据或执行业务操作。
- 7. 模型生成工具调用参数:大模型根据用户需求生成标准化的工具调用参数(工具类型、入参等)。
- 8. 应用层校验:执行鉴权、权限拦截、幂等判断等多重校验,确保调用合规安全。
- 9. 返回校验失败提示:校验不通过时返回标准化错误信息。
- 10. 执行工具调用:校验通过后调用对应工具,完成搜索、数据查询、代码执行等操作。
- 11. 记录审计日志:记录工具调用的完整信息(调用时间、入参、结果等),用于后续审计和追溯。
- 12. 工具结果回填上下文:将工具执行结果封装后回填到上下文和状态库中。
- 13. 大模型整合结果:大模型基于原始问题、会话记忆、检索知识和工具结果进行综合推理。
- 14. 输出回答:生成最终回答返回给用户。
三、RAG私有知识能力
1. RAG场景适配
RAG全称检索增强生成,把私有文档切片向量化存储,用户提问时检索相关片段,把片段送入Prompt,约束大模型基于参考资料回答,抑制幻觉。
适合场景:
- 静态业务文档:制度、操作手册、FAQ、产品说明,更新频率较低;
- 历史归档资料,不需要实时变更;
- 问答类场景,以读取信息为主,不会修改业务数据。
不适合场景:
- 实时变化业务数据:订单实时状态、用户账户余额,不建议 RAG;数据变更就要重新切片入库,同步延迟高;
- 需要写入、修改业务的操作,RAG 只能读,不能执行业务动作;
- 高频频繁改动的短数据,维护切片版本成本很高。
RAG落地不只是向量库检索,完整生产级 RAG 分为文档解析、切片、向量化入库、检索重排、上下文组装几个环节。通常容易只实现检索,忽略文档质量、切片策略、重排过滤,会出现检索无关片段,误导大模型输出错误答案。
2. RAG常见问题
- 切片过大:上下文塞满无关内容,模型注意力被稀释;切片过小,丢失完整语义;
- 不做重排,单纯依靠向量相似度,出现语义相似但是业务无关片段;
- 没有来源溯源,模型输出答案,无法返回引用文档,出问题无法核对依据;
- 知识库更新不及时,旧数据残留,模型输出过时规则。
生产RAG必须带上元信息:文档 ID、来源文件名、更新时间,模型输出的时候可以输出引用来源,同时可以过滤过期文档版本。
3. RAG基础示例
以下示例基于LangChain的RAG检索增强生成基础流程:先将业务审批规则文本进行切片,利用OpenAIEmbeddings向量化并存入Chroma向量库;随后针对用户提问进行相似度检索,召回相关知识片段,最后将其组装成Prompt送入大模型,从而实现基于私有知识库的精准问答。
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings
# 1.加载业务文档文本
biz_doc = """
业务审批规则:金额小于1万由部门主管审批,1万到10万需要经理审批,大于10万提交总监审批。
审批提交时间工作日9点‑18点,非工作时间不予受理。
"""
# 2.文档切片
splitter = RecursiveCharacterTextSplitter(
    chunk_size=300,
    chunk_overlap=50
)
chunks = splitter.split_text(biz_doc)
# 3.向量化存入向量库
embedding = OpenAIEmbeddings()
vector_db = Chroma.from_texts(chunks, embedding, persist_directory="./chroma_biz")
# 4.检索,拿到参考知识片段
query = "5万金额审批找谁"
docs = vector_db.similarity_search(query, k=2)
ref_context = "\n".join([d.page_content for d in docs])
# 组装送入大模型prompt
prompt = f"""参考下面资料回答问题,禁止编造内容:
【参考资料】
{ref_context}
【用户问题】{query}
"""
print(prompt)

RAG的环节我们也做了很多细节说明,这里提供基础示例参考,生产环境还需要补充:文档解析 PDF/Word、重排器、过期文档过滤、检索结果数量限制,防止上下文超长溢出。
同时,RAG 输出的知识片段,同样属于输入上下文,要做长度截断,不能无限制塞给大模型,超出模型上下文窗口会造成性能暴跌。
四、记忆会话能力
1. 短期与长期记忆区分
很多人把记忆等同于直接把全部聊天历史全部丢进 Prompt,会话轮次一多,上下文就爆炸,token 消耗飙升,推理变慢。记忆分为短期会话记忆、长期用户记忆,二者设计目标不一样。
短期会话记忆:
- 当前这一次会话窗口,保存最近N轮对话,用于多轮交互,比如一轮一轮聊天,记住用户上一轮提问。
- 实现方式:Redis存储会话id,保存用户、模型、工具交互记录,设置会话过期时间。会话结束自动失效。
长期用户记忆:
- 跨会话持久记忆,用户关闭页面,下次再来,依然记住用户信息。
- 例如记住用户岗位、常用业务、用户偏好。
- 不会把完整对话全部存进Prompt,会做摘要抽取,提取关键事实,只把关键事实加入上下文,避免token爆炸。
记忆的场景分配:
- 短期记忆场景:单次会话多轮对话,连续问答、连续工具调用;
- 长期记忆场景:用户多次访问系统,记住用户身份、业务习惯;
- 错误做法:把用户几百轮完整聊天全部塞进Prompt,上下文超限,成本高,效果变差。
2. 记忆处理核心流程

- 1. 会话初始化,根据session_id读取短期会话;根据用户id读取长期记忆摘要;
- 2. 对历史会话做裁剪,保留最近N轮,超长做摘要压缩;
- 3. 将关键记忆信息注入Prompt头部,不要无限制追加全部原始对话;
- 4. 用户每一轮交互结束,更新会话存储;定时抽取长期记忆事实存入数据库。
记忆模块本身不提供知识,它保存交互事实。如果用户问制度文档,不要指望记忆,交给 RAG检索。记忆解决 “人”,RAG 解决 “资料”。
3. 记忆基础示例代码
以下实现了一个轻量级的多轮对话会话记忆管理。通过模拟Redis存储,SessionMemory类实现了按 session_id 隔离对话上下文,并在每次追加消息时自动裁剪,仅保留最近的N轮对话,从而有效防止上下文膨胀,为大模型提供精准的对话历史。
import json
from typing import List
# 模拟Redis会话存储,生产替换真实Redis
session_store = {}
class SessionMemory:
    def __init__(self, session_id: str, max_round:int=6):
        self.session_id = session_id
        self.max_round = max_round
        if session_id not in session_store:
            session_store[session_id] = []

    def add_msg(self, role:str, content:str):
        msgs = session_store[self.session_id]
        msgs.append({"role":role, "content":content})
        # 裁剪,只保留最近max_round轮,防止上下文膨胀
        if len(msgs) > self.max_round:
            session_store[self.session_id] = msgs[-self.max_round:]

    def get_history(self) -> List[dict]:
        return session_store.get(self.session_id, [])
# 使用示例
mem = SessionMemory(session_id="sess_001", max_round=4)
mem.add_msg("user","我要提交5万的审批")
mem.add_msg("assistant","5万需要经理审批")
mem.add_msg("user","经理不在怎么办")
history = mem.get_history()
print(json.dumps(history, ensure_ascii=False, indent=2))

重点说明:
- 短期会话放Redis设置 TTL 过期;
- 长期记忆存入数据库,后台 LLM 做事实抽取,把大量对话提炼为简短事实;
- 例如{"user_id":"u001","fact":"用户经常提交金额3‑10万审批"},避免原始大段对话全部送入 Prompt。
五、业务API与MCP工具调用
1. 业务API直接调用
当需要操作真实业务数据,查询订单、提交工单、发起审批,RAG 和记忆无能为力,这时候就需要调用后端业务API。
这里要注意:
- 大模型只负责生成调用参数,绝对不能直接执行请求。模型输出的 tool‑call 参数,必须经过应用网关层做参数校验、身份鉴权、权限过滤、幂等校验,之后才转发业务接口。
- 如果将代码拿到模型输出 json,直接 requests.post 发起请求,这是高危做法。模型可能输出恶意参数、超范围 ID,会造成业务故障。
业务API工具调用完整链路:

- 1. 系统 Prompt 告诉模型可用工具名称、入参说明;
- 2. 用户提问结合上下文,大模型输出 tool_call 工具调用参数;
- 3. 应用层捕获工具调用,不直接执行;
- 4. 参数校验:字段类型、取值范围、必填项;
- 5. 鉴权校验:当前登录用户是否有权限调用该工具,是否可以操作该业务 ID;
- 6. 幂等判断:防止重复调用接口;
- 7. 调用真实业务 API;
- 8. 完整记录审计日志;
- 9. 接口返回结果回填上下文,交给大模型整理自然语言回答。
2. MCP工具协议定位
MCP是工具调用标准化协议,解决多工具统一管理问题。企业里面工具会越来越多:查询订单、查询库存、提交审批、查询知识库、查询数据库。
如果每个工具手写解析代码,工具一多维护成本爆炸。MCP 实现:工具注册、能力发现、标准化入参出参格式、统一调用入口。
- 业务 API:适合企业内部已有的业务接口,业务逻辑已经开发完成;
- MCP:面向大量异构工具场景,统一托管工具集合,支持动态注册新增工具,不用修改主业务代码。
简单选型:工具数量少(1‑3 个)直接封装业务 API;工具多,持续新增工具,引入 MCP 管理层。
3. 工具调用基础示例
以下示例实现了一个大模型工具调用的安全网关层。利用Pydantic对模型输出的参数进行严格校验,随后执行最小权限鉴权,并引入幂等键Idempotency-Key防止重复提交,最终将安全合规的请求转发至业务接口,保障了 Agent 工具调用的安全性与稳定性。
import requests
from pydantic import BaseModel, Field
# 工具入参模型,做参数校验
class SubmitApprovalTool(BaseModel):
    amount: float = Field(gt=0, description="审批金额,大于0")
    reason: str = Field(min_length=2, description="审批原因")
    user_id: str
# 模拟应用网关:校验+鉴权+幂等,模型输出的参数先过这一层
def tool_gateway(tool_name:str, raw_params:dict, login_user:str, request_id:str):
    # 1.参数校验
    if tool_name == "submit_approval":
        valid_param = SubmitApprovalTool(**raw_params)
        # 2.鉴权,最小权限校验,示例:只能操作自己的单据
        if valid_param.user_id != login_user:
            raise PermissionError("无权操作他人审批单据")
        # 3.幂等:request_id作为幂等键,避免重复提交
        headers = {"Idempotency‑Key": request_id}
        resp = requests.post(
            url="http://biz‑api/submit_approval",
            json=valid_param.model_dump(),
            headers=headers,
            timeout=10
        )
        return resp.json()
    else:
        raise ValueError("不存在该工具")
# 模拟模型输出原始参数
model_output_params = {"amount":50000,"reason":"项目采购","user_id":"u1001"}
try:
    result = tool_gateway(
        tool_name="submit_approval",
        raw_params=model_output_params,
        login_user="u1001",
        request_id="req_abc123"
    )
    print("工具调用结果:", result)
except Exception as e:
    print("调用拦截:", str(e))

重点说明:
- 这里tool_gateway就是生产最重要一层防护,不管大模型输出什么内容,全部在这里校验拦截。
- 哪怕模型编造非法 user_id,鉴权环节直接抛出错误,不会流向业务后端。
六、安全底座设计
1. 参数校验
大模型输出是概率生成,JSON 格式可能残缺、字段缺失、数值越界、传入非法字符。不要信任模型输出。
校验要点:
- 使用 Pydantic 做结构化校验,必填字段、数据类型、数值范围、字符串长度全部约束;
- 枚举值限制,只能选择业务允许的枚举,拒绝模型自己编造枚举;
- 过滤特殊危险字符,防止注入风险;
- 校验失败直接返回错误,不要尝试修复模型参数交给下游。
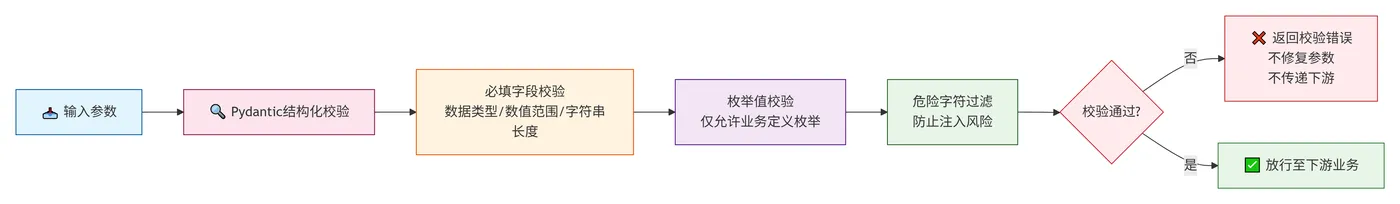
不要写逻辑:“模型输出错了,代码帮它自动修正参数”,自动修复会掩盖问题,带来不可预期业务行为。校验失败直接终止调用,告诉大模型参数错误,让模型重新生成。
2. 鉴权与最小权限
鉴权:确认当前登录用户是否允许调用该工具,是否允许操作对应业务资源。
最小权限原则:
- 用户只拥有完成业务必须的最小工具集合,不需要的工具不给开通;
- 数据层面,用户只能访问自己归属业务数据,不能越权查看别人订单单据;
- 区分只读工具、写入工具,查询类权限宽松,提交修改类接口严格管控;
- 禁止大模型拥有超权限账号,所有工具继承登录用户身份权限,工具层不能使用万能管理员账号。
典型反面案例:工具内部写死管理员token,不管是谁访问,都用管理员账号调用业务API,用户通过大模型就可以越权操作全部业务数据,属于严重安全漏洞。
3. 幂等设计
大模型会出现重试调用工具:网络超时,模型认为调用失败,再次发起同样工具调用。写入接口如果不做幂等,会重复创建单据、重复扣款,造成业务事故。
幂等实现方式:
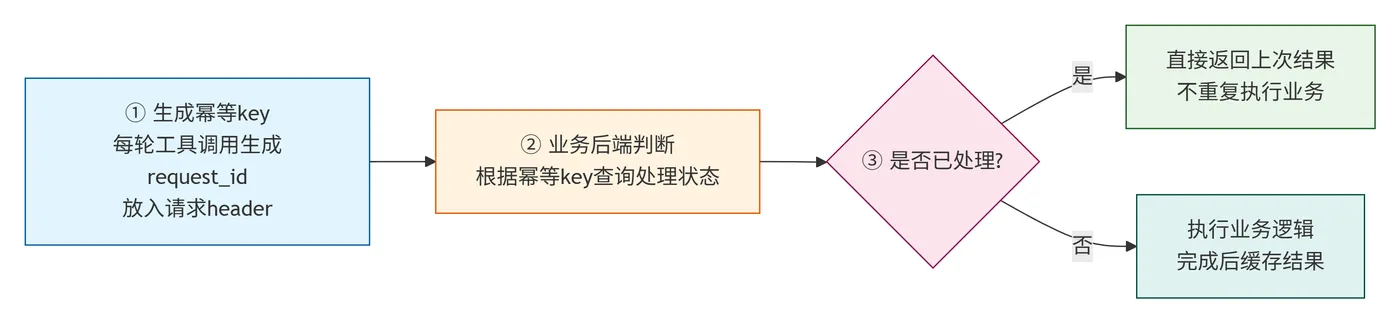
- 1. 每一轮模型工具调用生成全局唯一request_id,作为幂等key,放到请求header;
- 2. 业务后端根据幂等key判断,如果已经处理过,直接返回上次结果,不再执行业务;
- 3. 幂等key绑定会话,单次工具调用生命周期内保持唯一。
注意:只读查询接口不需要幂等;新增、修改、提交类写接口必须强制开启幂等保护。
4. 全链路审计日志
线上大模型系统出故障,经常遇到:到底是用户说了什么?模型输出了什么?调用了什么工具?入参出参是什么?是谁调用?时间点?没有日志完全无法排查。
审计日志需要记录字段:
- 全局 request_id,串联整条链路;
- 用户 ID、会话 session_id;
- 用户原始 query;
- RAG 检索出来的知识库片段;
- 送入大模型完整上下文(做脱敏,屏蔽敏感手机号身份证);
- 模型输出内容,工具调用入参;
- 工具调用返回结果、错误堆栈;
- 时间戳;
- 权限校验是否通过,拦截原因。
日志不能只存内存,持久化存储,支持查询。敏感信息必须脱敏,不能明文保存用户隐私。审计日志用于故障排查、安全溯源,是生产环境硬性要求。
5. 安全逻辑完整实例
完整的安全链路实现,覆盖:request_id 生成、会话记忆、RAG 模拟、prompt 组装截断、LLM 推理模拟、tool‑call 分支、Pydantic 参数校验、鉴权、幂等、调用 API/MCP、脱敏审计日志全链路。
import uuid
import json
import logging
from typing import Optional, Dict, Any, List
from pydantic import BaseModel, Field
# --------------------------
# 0. 初始化日志(审计日志,自动脱敏)
# --------------------------
audit_logger = logging.getLogger("llm_audit")
audit_logger.setLevel(logging.INFO)
handler = logging.StreamHandler()
audit_logger.addHandler(handler)
def audit_record(request_id: str,
                 user_id: str,
                 session_id: str,
                 user_query: str,
                 rag_refs: List[str],
                 prompt_snippet: str,
                 tool_call_raw: Optional[Dict],
                 tool_valid_params: Optional[Dict],
                 tool_result: Optional[Dict],
                 llm_reply: str,
                 is_blocked: bool = False,
                 block_reason: str = "",
                 error: str = ""):
    """审计日志:敏感字段简单脱敏"""
    record = {
        "request_id": request_id,
        "user_id": user_id,
        "session_id": session_id,
        "user_query": user_query,
        "rag_refs": rag_refs,
        "prompt_snippet": prompt_snippet[:500],  # 截断,不存超长上下文
        "tool_call_raw": tool_call_raw,
        "tool_valid_params": tool_valid_params,
        "tool_result": tool_result,
        "llm_reply": llm_reply,
        "is_blocked": is_blocked,
        "block_reason": block_reason,
        "error": error
    }
    audit_logger.info(json.dumps(record, ensure_ascii=False))
# --------------------------
# 1. 数据模型:工具入参定义(Pydantic校验)
# --------------------------
class SubmitApprovalTool(BaseModel):
    """提交审批工具参数"""
    amount: float = Field(gt=0, description="审批金额必须大于0")
    reason: str = Field(min_length=2, max_length=200, description="审批原因")
    target_user_id: str = Field(description="操作单据所属用户ID")
# --------------------------
# 2. 模拟存储层:会话记忆、长期记忆、幂等记录表
# --------------------------
mock_session_store: Dict[str, List[Dict[str, str]]] = {}   # session_id -> message list
mock_long_memory: Dict[str, List[str]] = {}                 # user_id -> 用户长期记忆事实
mock_idempotent_table: Dict[str, bool] = {}                 # request_id幂等表
mock_biz_api_db: List[Dict] = []                            # 模拟业务后端存储
# --------------------------
# 3. 模拟底层能力:记忆、RAG、大模型、MCP/API调用
# --------------------------
def load_session_memory(session_id: str) -> List[Dict[str, str]]:
    """读取会话短期记忆"""
    return mock_session_store.get(session_id, [])
def load_long_memory(user_id: str) -> List[str]:
    """加载用户长期记忆事实"""
    return mock_long_memory.get(user_id, [])
def mock_rag_retrieve(query: str) -> List[str]:
    """模拟RAG检索,返回参考知识片段"""
    if "审批" in query:
        return [
            "业务审批规则:金额小于1万部门主管审批;1万‑10万经理审批;大于10万总监审批。",
            "审批仅工作日9‑18点受理。"
        ]
    return []
def truncate_context(messages: List[Dict], max_msg_count: int = 8) -> List[Dict]:
    """上下文截断:只保留最近N轮消息,防止token爆炸"""
    if len(messages) <= max_msg_count:
        return messages
    return messages[-max_msg_count:]
def mock_llm_infer(prompt_messages: List[Dict]) -> Dict[str, Any]:
    """模拟大模型推理:两种返回,普通回答 / tool_call工具调用"""
    last_user_msg = prompt_messages[-1]["content"]
    if "提交审批" in last_user_msg:
        # 模拟模型输出工具调用
        return {
            "reply_content": "",
            "tool_call": {
                "tool_name": "submit_approval",
                "raw_params": {"amount": 50000.0, "reason": "项目物料采购", "target_user_id": "u_001"}
            }
        }
    else:
        return {
            "reply_content": "已收到你的咨询,审批相关规则已参考制度说明。",
            "tool_call": None
        }
def mock_biz_api_submit_approval(params: Dict, idempotency_key: str) -> Dict:
    """模拟业务API,自带幂等判断"""
    global mock_biz_api_db
    if idempotency_key in mock_idempotent_table:
        return {"code": 0, "msg": "幂等命中,已处理过", "data": None}
    mock_idempotent_table[idempotency_key] = True
    mock_biz_api_db.append(params)
    return {"code":0, "msg":"审批单据提交成功", "data":{"approval_id":"ap_10086"}}
# --------------------------
# 4. 核心网关:鉴权、最小权限校验
# --------------------------
def check_permission(user_id: str, tool_name: str, parsed_params: BaseModel) -> tuple[bool, str]:
    """
    鉴权&最小权限校验
    return (是否通过, 拒绝原因)
    """
    if tool_name == "submit_approval":
        p = parsed_params.model_dump()
        # 业务规则:用户只能操作属于自己的单据 target_user_id == 当前登录user_id
        if p["target_user_id"] != user_id:
            return False, f"权限拒绝:用户{user_id}不允许操作target_user_id={p['target_user_id']}的单据"
        return True, ""
    return False, f"不支持工具:{tool_name}"
# --------------------------
# 5. 主流程函数:完整复现你伪代码逻辑
# --------------------------
def llm_agent_entry(user_id: str, session_id: str, user_query: str) -> Dict[str, Any]:
    """
    完整链路:
    接收用户请求
    生成全局request_id
    读取会话记忆、加载长期记忆
    执行RAG检索,获取参考知识片段
    组装Prompt上下文,做长度截断
    传给大模型推理
    if 模型返回工具调用:
        拿到模型输出raw_params
        【参数校验】Pydantic校验,失败返回错误
        【鉴权最小权限】校验用户是否允许调用该工具,资源是否归属用户,不通过直接拦截
        【幂等】带上request_id幂等键
        执行工具调用(API/MCP)
    记录完整审计日志(脱敏)
    把工具返回结果放回上下文
    大模型整合结果输出回答
    """
    request_id = str(uuid.uuid4())
    # 1.读取记忆
    session_msgs = load_session_memory(session_id)
    long_facts = load_long_memory(user_id)
    # 2.RAG检索
    rag_refs = mock_rag_retrieve(user_query)
    # 3.组装prompt上下文
    system_parts = []
    if long_facts:
        system_parts.append(f"【用户记忆】:{';'.join(long_facts)}")
    if rag_refs:
        system_parts.append(f"【参考知识库】:{'\n'.join(rag_refs)}")
    system_msg = {"role":"system", "content":"\n".join(system_parts)}
    prompt_messages = [system_msg] + session_msgs + [{"role":"user", "content": user_query}]
    prompt_messages = truncate_context(prompt_messages)
    prompt_snippet = json.dumps(prompt_messages, ensure_ascii=False)
    # 4.调用大模型推理
    llm_out = mock_llm_infer(prompt_messages)
    tool_call = llm_out.get("tool_call")
    tool_raw_params: Optional[Dict] = None
    valid_parsed_obj: Optional[BaseModel] = None
    tool_response: Optional[Dict] = None
    blocked = False
    block_msg = ""
    error_msg = ""
    # ========== 工具调用分支 ==========
    if tool_call is not None:
        tool_name = tool_call["tool_name"]
        tool_raw_params = tool_call["raw_params"]
        try:
            # 【参数校验 Pydantic】
            if tool_name == "submit_approval":
                valid_parsed_obj = SubmitApprovalTool(**tool_raw_params)
            else:
                raise Exception(f"未知工具 {tool_name}")
            # 【鉴权、最小权限校验】
            permit_ok, reason = check_permission(user_id, tool_name, valid_parsed_obj)
            if not permit_ok:
                blocked = True
                block_msg = reason
            else:
                # 【幂等:request_id作为幂等key】执行业务调用
                if tool_name == "submit_approval":
                    tool_response = mock_biz_api_submit_approval(
                        params=valid_parsed_obj.model_dump(),
                        idempotency_key=request_id
                    )
                # 将工具结果追加到上下文,给大模型二次整合
                prompt_messages.append({
                    "role": "tool",
                    "content": json.dumps(tool_response, ensure_ascii=False)
                })
                # 模拟大模型拿到工具结果后再生成最终回复
                final_llm = mock_llm_infer(prompt_messages)
                llm_out["reply_content"] = final_llm["reply_content"] or json.dumps(tool_response)
        except Exception as e:
            blocked = True
            error_msg = str(e)
    final_answer = llm_out.get("reply_content", "")
    # 记录审计日志(脱敏)
    audit_record(
        request_id=request_id,
        user_id=user_id,
        session_id=session_id,
        user_query=user_query,
        rag_refs=rag_refs,
        prompt_snippet=prompt_snippet,
        tool_call_raw=tool_raw_params,
        tool_valid_params=valid_parsed_obj.model_dump() if valid_parsed_obj else None,
        tool_result=tool_response,
        llm_reply=final_answer,
        is_blocked=blocked,
        block_reason=block_msg,
        error=error_msg
    )
    # 更新会话记忆
    if session_id not in mock_session_store:
        mock_session_store[session_id] = []
    mock_session_store[session_id].append({"role":"user", "content": user_query})
    mock_session_store[session_id].append({"role":"assistant", "content": final_answer})
    return {
        "request_id": request_id,
        "final_answer": final_answer,
        "blocked": blocked,
        "block_reason": block_msg,
        "error": error_msg,
        "tool_response": tool_response
    }
# --------------------------
# 测试运行示例
# --------------------------
if __name__ == "__main__":
    # 测试用例1:正常提交审批,身份匹配
    res1 = llm_agent_entry(user_id="u_001", session_id="sess_001", user_query="帮我提交审批,50000,项目物料采购")
    print(json.dumps(res1, ensure_ascii=False, indent=2))
    print("-"*60)
    # 测试用例2:越权场景,user_id u_002尝试操作u_001单据,会被鉴权拦截
    res2 = llm_agent_entry(user_id="u_002", session_id="sess_002", user_query="帮我提交审批,50000,项目物料采购")
    print(json.dumps(res2, ensure_ascii=False, indent=2))

重点说明:
- uuid.uuid4():生成全局request_id,同时充当幂等 Key;
- load_session_memory / load_long_memory:读取短期会话、长期记忆;
- mock_rag_retrieve:RAG 获取知识片段;
- truncate_context:上下文长度截断;
- mock_llm_infer:大模型推理;
- tool‑call 分支:
- SubmitApprovalTool(**tool_raw_params):Pydantic 参数校验;
- check_permission:鉴权 + 最小权限校验,校验资源归属;
- idempotency_key=request_id:幂等保护;
- mock_biz_api_submit_approval:执行业务 API 调用;
- audit_record:脱敏审计日志完整落盘;
- 工具结果重新塞回prompt_messages,交给大模型整合输出自然语言。
七、场景化选型参考
1. 应用场景组件选择
我们面对应用场景最大的困惑:业务来了,我到底上RAG?记忆?API?MCP?这里给出现实业务选型参考。
内部客服问答场景,查制度文档FAQ:
- 先RAG + 短期会话记忆;
- 不需要写业务,不调用API;
- 注意RAG做好切片、重排,会话记忆控制轮次,防止上下文爆炸;
- 不需要MCP。
智能业务助手:查询自己订单,提交审批:
- 记忆(短期会话 + 少量长期记忆) + RAG(加载业务规则文档) + 业务 API。
- 规则文档走 RAG,真实订单读写走 API。
- 工具数量少不用 MCP,网关层做好校验鉴权幂等审计。
复杂智能 Agent,几十种工具,不断新增工具:
- 记忆 + RAG + MCP 工具管理层。
- 通过MCP统一注册各类工具,网关层依然保留校验鉴权幂等审计,MCP 只负责工具分发,安全校验不能交给 MCP。
避坑总结:
- 实时业务数据,不要存入RAG向量库,优先API实时查询;
- 不要把全部历史对话一股脑塞Prompt,做记忆裁剪、摘要;
- 模型输出的工具参数,永远不要直接放行,网关层校验拦截;
- 写操作接口强制幂等,只读接口按需处理;
- 无论成功失败,全部链路完整审计日志;
- 权限跟随登录用户,工具不使用万能管理员账号。
2. 上下文窗口管控
所有RAG返回片段、记忆对话历史、工具返回结果,全部会占用大模型上下文token。生产极易发生上下文超限。
处理策略:
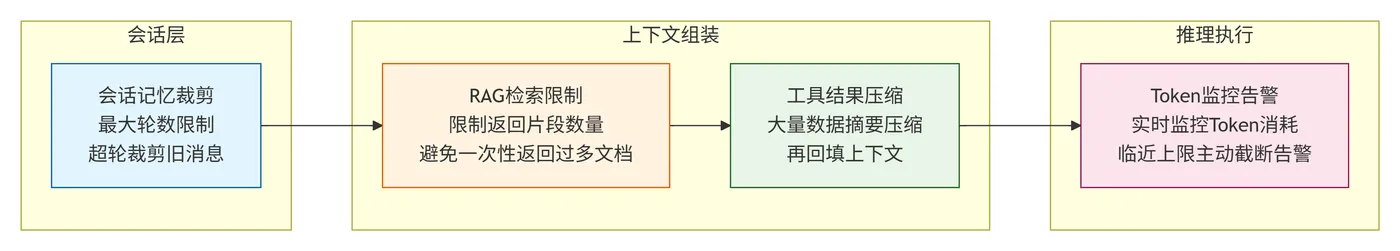
- 1. 会话记忆设置最大轮数,超轮裁剪旧消息;
- 2. RAG检索限制返回片段数量,不要一次性返回几十条文档;
- 3. 工具返回结果如果返回大量数据,做摘要压缩,再回填上下文;
- 4. 监控token消耗,临近模型上下文上限主动截断告警。
八、总结
大模型生产落地,不是一味追求更强的大模型,而是构建一套 “模型做意图理解,应用层做确定性与安全约束” 的完整系统。上下文、知识、工具三者构成整套能力底座:记忆管好会话交互,RAG补齐静态私有知识,业务API和MCP完成外部业务操作。RAG、记忆、API、MCP 没有绝对好坏,核心看业务场景,按需选用,不要盲目堆砌组件。
而校验、鉴权、最小权限、幂等、审计,是上线不可省略的安全防线。大模型是概率系统,会幻觉、输出错误参数,千万不能把业务正确性、安全性交给模型自主决定。所有外部调用必须经过应用网关层做防护,这是原型和生产级系统最大分水岭。原型只需要跑通流程;生产系统要兼顾正确性、安全性、可追溯。理清这些节点过程,助力构建稳定可控、可真正落地的大模型业务应用。