
在智能体完成特征时序压缩与可分性优化后,系统需要一个具备离散状态决策与多类辨识能力的逻辑控制中枢。论文《Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios》设计了基于决斗双重深度Q网络的类型识别模块作为智能体的决策核心组件。该组件位于特征提取网络后端,负责接收经过对比微调的紧凑时序表征,并通过解耦状态自身价值与各候选动作的相对优势,将连续的气路特征映射为离散的故障诊断结论。
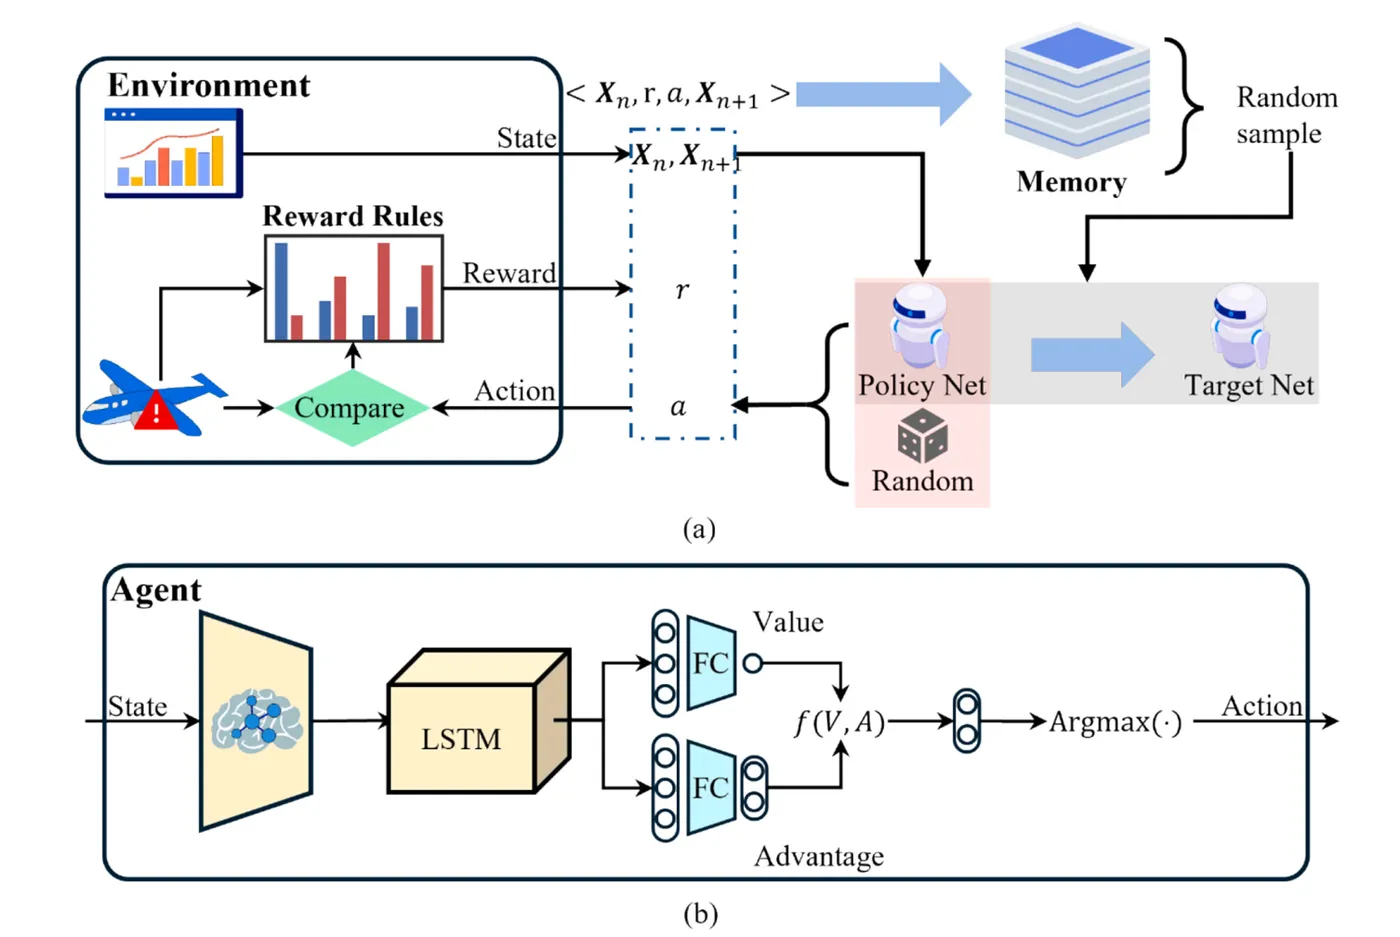
价值解耦型决策网络在物理拓扑上由主干循环层与双支路线性评估层串联构成。前序特征区分模块中输出的低维特征向量首先进入决策网络新建的长短期记忆主网络中,主网络负责进一步提取高阶决策相关的时序动态演变信息,并将最终时间步的隐层向量作为当前状态的综合决策向量。然后,该向量被并行送入两条结构独立的线性全连接支路,分别执行状态全局固有价值的解算与各个诊断动作相对优势度的独立度量。
状态价值支路与动作优势支路的结构解耦构成了决斗网络的核心机理。状态价值支路通过全连接层将决策向量压缩为一个标量,用于量化发动机当前处于某种特定健康水平或退化状态的全局基准价值,该指标独立于具体采取何种维护判断;动作优势支路则输出一个维度与诊断类别总数相等的向量,分别评估将当前状态归类为正常或某一具体故障模式相对于其他备选类别的相对优势程度。在最终的动作价值合成单元中,网络通过减去优势向量的内部均值并叠加状态价值标量,在一定程度上消除了由于状态本身价值过大对动作优劣判定造成的掩盖,提升了数值评估的稳定性。
为了在强化学习训练中彻底规避标准Q学习对动作价值的正向过估计问题,该决策组件在架构上采用了策略网络与目标网络的双网络协作机制。系统中部署了两个结构完全一致的网络实体:策略网络直接与环境交互并实时更新参数,负责在给定状态下输出具有最大Q值的候选诊断动作;目标网络则保持参数处于冻结状态,专门用于计算策略网络所选动作的目标评价值。这种将动作选择与动作评估物理隔离的设计,在一定程度上阻断了因噪声引起的误差正反馈,较好地确保了价值评估函数的平稳收敛。
在优化执行层面,决策组件依赖贝尔曼时序差分机制构建梯度反向传播回路。目标网络结合环境反馈的即时奖励与低折扣率的未来期望计算出目标Q值,由于连续两次诊断任务之间的关联性较弱,极低的折扣系数使模型专注于当前飞行特征与即时分类反馈的准确映射。系统通过计算策略网络实时估计Q值与目标Q值之间的均方误差,仅对决策长短期记忆主网络与双支路全连接层的权重进行梯度更新,而上游的特征编码器参数保持完全冻结。
在完成收敛并部署于在线诊断流程时,决策组件以确定性的前向推理模式运行。当新的多航段特征输入后,决策网络计算出所有备选健康状态与典型故障模式的动作价值向量,最大动作选择器直接提取具有最高Q值的类别索引作为故障诊断输出。作为智能体的决策大脑,价值解耦型决斗深度决策网络在结构上实现了状态评估、优势比较与误差抑制的严密闭环,为复杂多气路故障的分类识别提供了较为可靠的逻辑执行架构。
参考文献:
Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios[J]. Advanced Engineering Informatics, 2025, 65(C): 103297.
https://www.sciencedirect.com/science/article/pii/S1474034625001909




