
打开 Playwright 官方文档,你会发现一个多数团队都用错的能力:它把无障碍树(accessibility tree)当作定位与断言的一等公民。getByRole、getByLabel 这些定位器,走的正是浏览器为辅助技术构建的那棵 a11y 树——这也是 Playwright MCP 选择用无障碍树而非像素做输入的原因。
可现实里,绝大多数团队只用这棵树来「点得准」:拿 getByRole('button') 定位一个按钮,点它,断言页面跳转了。没人意识到,同一棵 a11y 树,本身就是一份现成的无障碍合规数据源。 于是无障碍问题总是这么被发现——上线后,视障用户的读屏软件念不出图片含义、表单没有可朗读的 label、正文对比度低到弱视用户看不清,一纸投诉或监管点名,团队才连夜补救。
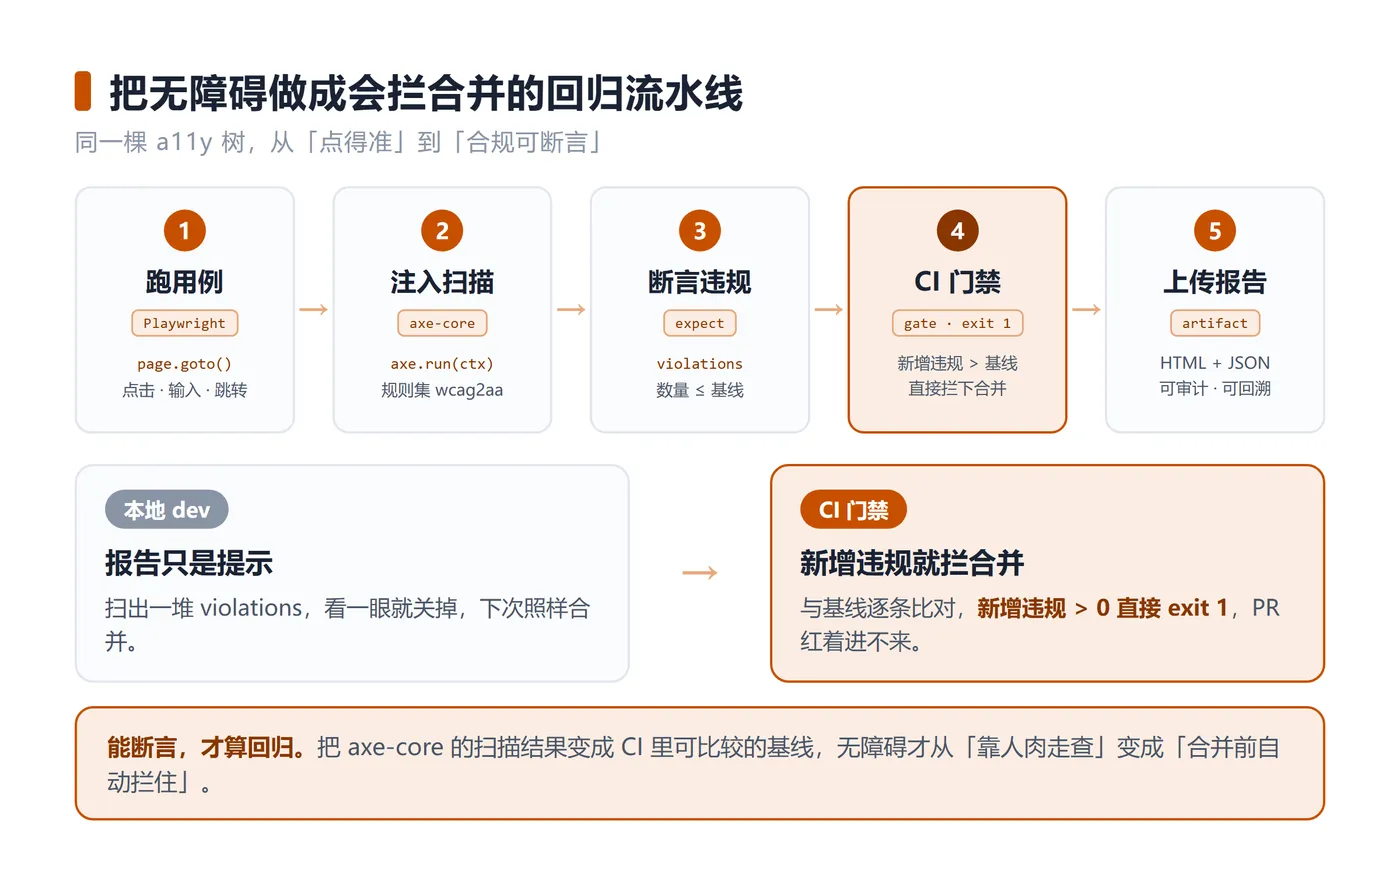
本篇讲一件事:怎么把 axe-core(Dequelabs 的开源无障碍规则引擎)挂进 Playwright 用例,自动扫出对比度不足、缺 alt、缺 label、标题层级跳级这些 WCAG 违规,再用 CI 把「违规数超基线」做成一道会拦合并的门禁。让无障碍从「上线后被投诉」变成「合并前就被拦下」。
一、a11y 树不只是用来定位的,它天生可断言
先给结论:你已经有的那棵无障碍树,缺的不是数据,而是把它当合规资产来断言的意识。
浏览器为每个页面构建的 accessibility tree,记录了每个元素的语义角色(role)、可访问名称(name)、状态。Playwright 用它做定位,是因为「一个能被读屏软件正确识别的按钮」本来就该是测试的稳定锚点。但反过来看:如果一个元素在 a11y 树里根本没有可访问名称、角色错乱、或者压根没进树,那它对辅助技术用户就是不可见的——这正是无障碍缺陷的本质。
axe-core 做的事,就是遍历这棵树,用一整套 WCAG 规则去检查每个节点:图片有没有 alt、表单控件有没有关联 label、标题层级有没有跳级(h1 直接跳到 h4)、文本对比度够不够。它返回一份结构化的 violations 列表。把这些 violations 断言成 Playwright 用例里的 expect,无障碍就从「人工走查的主观判断」变成了「机器可复现的红绿」。
二、把 axe-core 挂进 Playwright:注入、扫描、断言
官方提供的 @axe-core/playwright 让接入只需三行:拿到 page、注入 axe、scan。下面是一条可运行的用例:
// a11y.spec.ts —— 用 axe-core 给页面做无障碍合规扫描
// 依赖:npm i -D @playwright/test @axe-core/playwright
import {
    test, expect } from '@playwright/test';
import AxeBuilder from '@axe-core/playwright';

test('首页不得存在 WCAG 违规', async ({
    page }) => {

  await page.goto('https://staging.example.com/');

  const results = await new AxeBuilder({
    page })
    .withTags(['wcag2a', 'wcag2aa'])   // 只跑 WCAG 2.1 A/AA 级规则(合规常用基线)
    .analyze();

  // 把 violations 断言成 expect:有任何违规,这条用例就红
  expect(
    results.violations.map(v => ({
    id: v.id, impact: v.impact, nodes: v.nodes.length }))
  ).toEqual([]);
});
为什么这么写、踩过什么坑。 第一个坑是不加 withTags 全量扫描,结果一堆 impact: minor 的实验性规则也报红,团队被噪音淹没,最后干脆把用例注掉。用 withTags(['wcag2a', 'wcag2aa']) 锁定合规真正关心的 A/AA 级,信号才干净。第二个坑是直接 expect(results.violations).toEqual([])——一旦红,报错信息是一坨巨大的原始对象,根本看不出哪违规了;先 map 成 {id, impact, nodes} 的精简结构再断言,红灯时一眼就知道「是 color-contrast 违规、影响 3 个节点」。第三个坑是拿生产域名扫,合规扫描应该在 staging 上跑,避免脏数据和真实用户会话互相干扰。
还有一个更隐蔽、专属于单页应用(SPA)的坑:扫描时机。page.goto 返回时,前端框架的异步渲染、懒加载的模块、接口回来后才填充的列表往往还没落到 DOM 上。这时立刻 analyze(),axe 扫的只是半个页面——首屏骨架合规、真正承载内容的区域还没渲染出来,于是漏扫,门禁假绿。正确的做法是先等页面「稳定」再扫:用 await page.waitForLoadState('networkidle') 等网络空闲,或者更稳妥地 await expect(page.getByRole('main')).toBeVisible() 显式等到关键内容区出现,再触发扫描。对含弹窗、下拉、折叠面板的交互态,还要在 click 展开之后单独扫一次——因为这些元素只有激活时才进 a11y 树,收起状态下的缺 label 问题是扫不出来的。把「扫描时机」当成和「断言内容」同等重要的事,才不会让一道本该拦住违规的门禁,因为扫早了而形同虚设。
三、三类最高频违规:axe-core 到底在替你盯什么
把 axe-core 接进来之前,最好先知道它最常报的是哪几类,这样红灯时你不会一头雾水。实际项目里,八成违规集中在三类。
第一类是对比度不足(color-contrast)。 浅灰字配白底、橙色按钮上压深橙文字,看着「高级」,弱视用户却根本分不清。axe 会算前景色与背景色的对比度比值,低于 WCAG AA 要求的阈值就报。这也是设计稿阶段最容易被忽略、上线后最容易被投诉的一类。
第二类是缺可访问名称(缺 alt / 缺 label)。 图片没写 alt,读屏软件就只能念文件名或者直接跳过;<input> 没有关联的 <label>,视障用户聚焦到输入框时听不到「这里该填什么」。这一类恰好和你用 getByLabel 定位表单是同一棵 a11y 树——如果 axe 报某个 input 缺 label,那你的 getByLabel 多半也定位不到它,无障碍缺陷和定位困难其实是同一个根因。
第三类是结构问题(标题层级跳级、landmark 缺失)。 h1 直接跳到 h4、页面没有 main/navigation 这些语义地标,读屏用户就没法靠标题快速跳转、只能一行行硬听。这类违规肉眼几乎看不出来(页面渲染完全正常),恰恰是纯人工走查最容易漏、而 axe 遍历 a11y 树一抓一个准的地方。
明白这三类,你就懂了 axe-core 的定位:它不是替你做审美判断,而是把「辅助技术用户会遇到什么障碍」翻译成了机器可枚举的规则。
四、CI 门禁:违规数超基线就 exit 1
单条用例能扫出违规,但真正让它「拦得住」的是 CI。无障碍回归的实用策略不是「零违规才算过」——存量老页面往往有一堆历史违规,一刀切会让门禁永远红、最后被绕过。可落地的做法是基线比对:把当前认可的违规数固化成基线,只对「新增违规」拦合并。
# .github/workflows/a11y.yml —— 无障碍回归门禁
name: a11y-regression
on: [pull_request]
jobs:
  axe:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: npm ci && npx playwright install --with-deps
      - name: Run axe-core a11y scan
        run: npx playwright test a11y.spec.ts --reporter=json > a11y-report.json
      - name: Fail on NEW violations over baseline
        run: node scripts/check-a11y-baseline.js   # 新增违规 > 基线 => exit 1
      - name: Upload a11y report as artifact
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: a11y-report
          path: a11y-report.json
配套的基线校验脚本,核心就是「本次违规数不得超过基线,超了就 exit 1」:
// scripts/check-a11y-baseline.js —— 只对新增违规拦合并
const fs = require('fs');
const BASELINE = Number(process.env.A11Y_BASELINE ?? 0);  // 基线违规数(本文示例,按存量实际设)
const report = JSON.parse(fs.readFileSync('a11y-report.json', 'utf8'));

// 从 playwright json 报告里汇总 axe violations 总数(结构按你的报告解析)
const violations = collectViolations(report);
console.log(`本次违规 ${
     violations.length} 条,基线 ${
     BASELINE} 条`);

if (violations.length > BASELINE) {

  console.error(`新增无障碍违规!超基线 ${
     violations.length - BASELINE} 条,拦下本次合并:`);
  violations.forEach(v => console.error(`  - [${
     v.impact}] ${
     v.id} (${
     v.nodes} 处)`));
  process.exit(1);   // 非 0 退出 => GitHub Actions 该 step 失败 => PR 被拦
}
console.log('无障碍回归通过:未超基线');

function collectViolations(report) {

  // 解析 playwright json,抽出每条 axe violation(示例实现,按实际报告字段调整)
  const out = [];
  for (const suite of report.suites ?? []) {

    for (const spec of suite.specs ?? []) {

      for (const test of spec.tests ?? []) {

        for (const res of test.results ?? []) {

          if (res.status !== 'passed' && res.attachments) {

            out.push(...(res.a11yViolations ?? []));
          }
        }
      }
    }
  }
  return out;
}
为什么用基线而不是一刀切零违规。 存量系统一上来就要求零违规,门禁会长期飘红,团队很快就会 --no-verify 绕过它,门禁形同虚设。基线策略的精髓是「冻结存量、拦截增量」:老违规记进基线慢慢还债,但任何一条新违规都过不了合并。if: always() 保证即使门禁失败,a11y 报告 artifact 也照样上传——因为红灯时那份报告恰恰是修复最需要的证据,不能因为 step 失败就丢掉。基线数值本身随存量债务清理逐步下调,最终收敛到 0。
五、人工走查 vs axe-core 进 CI:五个维度看清差别
把两种做法放到五个维度上对照,为什么「别再等上线后被投诉」就很清楚了:
| 维度 | 靠人工走查 / 上线后被投诉 | axe-core 进 Playwright + CI 回归 |
|---|---|---|
| 覆盖面 | 抽查几个页面,靠人眼和经验 | 每个 PR 全量扫 a11y 树,规则一致 |
| 可复现 | 主观判断,换个人结论就变 | violations 结构化,同一页面同一结果 |
| 拦合并时机 | 上线后被投诉才补救 | 合并前门禁 exit 1,增量违规进不来 |
| 修复成本 | 线上事故级返工,牵连发版 | PR 阶段就报出,改一行 alt 即可 |
| 合规可追溯 | 无记录,说不清何时达标 | artifact 留存每轮报告,可审计 |
差别不在于 axe-core 有多先进,而在于它把无障碍从「上线后靠投诉驱动的被动补救」变成了「合并前由门禁驱动的主动拦截」——同一棵你早就在用的 a11y 树,只是终于被拿来当合规资产断言了。
六、落地建议:先挑一条核心链路跑成闭环
别一上来就要求全站零违规。先挑一条最核心的链路(比如登录或下单页),把 axe-core 扫描、violations 断言、CI 基线门禁跑通,形成第一版基线;跑顺了再逐页复制,基线随存量清理逐步下调。无障碍合规这件事,难的不是接入 axe-core,而是让每次变更都被同一套规则挡住——只要有一条链路先跑成闭环,团队就会开始信这道门禁,剩下的页面自然愿意接进来。
本篇不讨论视觉像素比对与截图基线矩阵,那是视觉回归的切面;我们只解决一个很窄的问题:怎么把无障碍违规做成一条会拦合并的回归流水线。
你用来定位按钮的那棵无障碍树,本就是现成的合规数据源——差的只是把它断言成一条会失败的用例。




