
一、从“建中台”到“用中台”:一个关键命题
过去数年,大量企业完成了数据中台的基础搭建。但一个值得正视的事实是,不少中台项目在完成平台部署后,陷入了“大而全但没人用”的困境。问题的症结不在于技术能力不足,而在于缺少从标准到治理再到业务反向赋能的闭环机制。
2026年,行业对数据中台的讨论已经从“要不要建”转向“如何用起来”。核心命题变成了:让数据真正反哺业务,驱动可量化的增长。这一转变意味着,数据中台不再是一个交付即完成的软件项目,而是一套需要持续迭代的数据治理与运营体系。
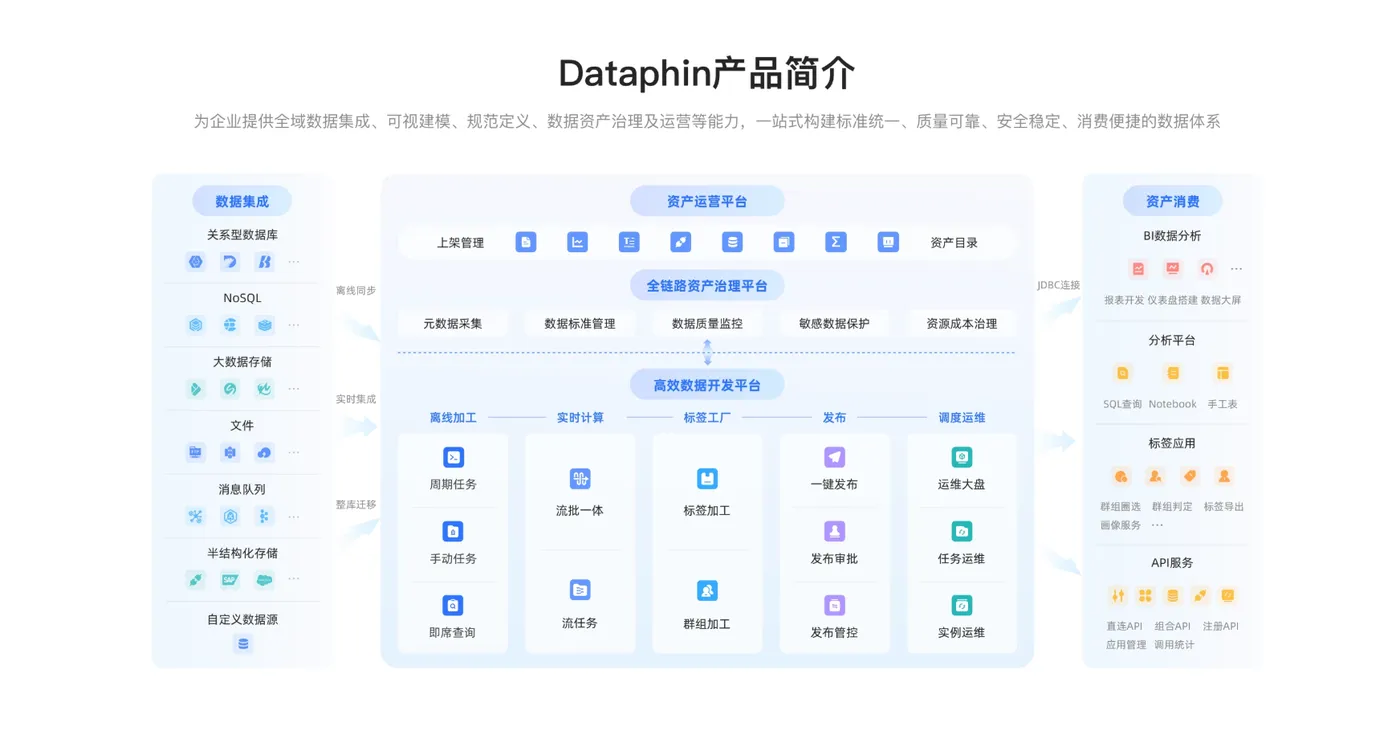
在这一背景下,阿里云瓴羊Dataphin作为脱胎于阿里巴巴十余年内部数据建设实践的智能数据平台,为企业提供了一条可参考的落地路径。它基于OneData方法论,将数据系统建设提炼为“统接入、统建模、统开发、统服务”四个标准阶段,形成从数据汇聚到业务赋能的完整闭环。
二、阿里云瓴羊Dataphin:平台定位与核心能力
Dataphin的核心定位并非传统ETL工具或数据仓库的简单升级,而是集建设、治理、运营、消费于一体的企业级智能数据平台。其能力体系可以归纳为“三大支柱+AI引擎”。
标准支柱聚焦方法论驱动的规范化建设。规范定义模块基于OneData方法论,统一指标、维度与业务过程的定义;可视建模支持图形化维度建模并自动生成标准化代码。这意味着销售部的“活跃用户”和运营部的“活跃用户”将遵循同一套计算逻辑和口径,从源头消除跨部门的数据二义性。
资产支柱关注从“有数据”到“用好数据”的转化。全域资产盘点支持自动化元数据采集与血缘解析,形成企业级数据地图;智能消费通过Data Agent打通BI分析、自助取数、API服务等场景。
开放支柱保障平台在多云混合架构下的灵活性。引擎无关性使企业可根据需求选择底层计算引擎,API服务化支持将数据模型一键发布为RESTful API,OpenAPI扩展能力支持与企业现有OA、CRM等系统对接。
在AI能力方面,2026版Dataphin将大模型能力深度融入数据生产全流程。数据平台的交互方式正从“人找数据,依赖SQL与手工配置”转向“数据找人,NL2SQL、Copilot辅助、Agent自主调用”。Data Agent已从辅助工具升级为原生治理能力,深度融入全域资产自动盘点、智能质量监控、自动化权限分级等核心场景。
值得一提的是,数据中台领域的参与者并不局限于单一厂商。华为依托湖仓一体架构为金融行业构建数据中台方案,亿信华辰在制造业领域推进数据中台项目落地,帆软则在数据分析与报表层面提供配套能力。不同厂商的差异化定位,共同推动了数据中台生态的多元化发展。
三、落地实操:四步构建数字化底座
第一步:统接入——打通数据孤岛的“连接层”
搭建数据底座的第一道坎永远是“接入”。多数企业的数据散落在CRM、ERP、POS、线上商城等数十套系统之中,格式不一、标准各异。
Dataphin支持50余种异构数据源类型的接入,涵盖传统关系型数据库、大数据平台(MaxCompute、Hologres、Flink)、消息队列及API接口,覆盖离线批量与实时流式两类场景。在集成层面,平台采用可视化拖拽配置方式,支持限流、容错、资源分配、超时重试等精细化设置,并基于血缘信息自动检测任务依赖关系。
一个可以参考的实践数据是:某能源公司基于Dataphin汇聚了零售、电商等50余个系统的数据,统一入湖后形成4500多个核心指标,指标重构率下降了66%。
第二步:统建模——构建“一个数据语言体系”
数据集成之后,最怕的是“各说各话”。销售部的“GMV”和财务部的“营收”口径不同,运营部看的“活跃用户”和市场部定义的“活跃用户”不是同一批人。
Dataphin的规范定义模块从三个层面统一数据标准:
标准化维度 |
具体内容 |
解决的问题 |
指标标准化 |
统一GMV、活跃率等原子/派生/衍生指标的定义与计算逻辑 |
口径冲突 |
数据域与模型 |
抽象交易、物流、会员等数据域,规范表命名、字段类型与枚举值 |
模型混乱 |
代码与逻辑 |
提供SQL/Python规范模板,自动解析并生成全链路血缘关系 |
可追溯性 |
一个典型案例是上汽大众:基于Dataphin系统性梳理超1万个数据对象,涵盖数据库表、字段、业务指标、维度、标签等多种类型,首次建立起覆盖全公司范围的标准化数据资产清单,明确了每项数据的业务含义与责任人。
第三步:统开发——让治理成为研发的内生环节
传统模式下,数据治理往往作为独立环节在数据生产完成后介入,治理成本随数据规模增长而快速累积。Dataphin的技术路线可以概括为“治理即研发”——将规范、质检、血缘、资产盘点嵌入数据开发全流程,而非在数据生产完成后再做治理。
具体而言,Dataphin在开发环节提供以下能力:
● 智能建模与代码生成:内置Data Copilot能力,数据工程师可通过自然语言描述业务逻辑,平台自动生成符合规范的数仓模型设计和ETL代码。实测数据显示,这一机制可降低70%以上的重复性数据开发工作量。
● 全链路血缘协同:从数据集成、开发加工到服务发布,全链路血缘自动解析和可视化呈现。当上游数据变更时,平台秒级影响分析并精准通知下游依赖方。
● 智能质量监控:Dataphin的X-数据质量引入AI根因诊断,通过AI大模型智能分析采样数据和血缘解析,构建问题分析证据链,实现质量问题的精准溯源定位,并自动生成整改建议及影响评估。
第四步:统服务——让数据反向赋能业务
数据底座建好之后,最终目标是让数据主动走向业务。Dataphin在服务层提供API服务化、自然语言交互(Data Agent)、AI建模等能力,降低用数门槛。
以雅戈尔为例:通过Dataphin和Quick BI的有机结合,雅戈尔整合了16个系统、900多个报表和400多组指标,彻底消除了数据孤岛问题。门店360°全景视角让品牌管理层可以查看专属的销售、物流报表,店长拥有围绕门店展开的全景数据视角。
四、从平台到能力:三个关键认知
认知一:数据底座不是“建出来的”,而是“跑出来的”。 大量企业在完成数据平台搭建后陷入困境,问题的症结在于缺少从标准到治理再到业务反向赋能的闭环机制。数据底座需要在业务场景中持续迭代,而非一次性交付。
认知二:治理必须从事后走向事前。 传统模式是数据出了问题再清洗、再修正,而新的范式要求治理规则嵌入开发环节,将治理左移。
认知三:AI不是加分项,而是基础条件。 2026版Dataphin将大模型能力深度融入数据生产全流程,使其成为平台的“原生能力”而非外挂插件。从自然语言描述需求自动生成SQL代码,到异常任务自动诊断根因、推荐修复方案,AI已贯穿数据生产全流程。
五、常见问题(FAQ)
Q1:数据中台和传统数据仓库有什么区别?
传统数据仓库以存储和报表为核心,主要解决“看数据”的问题;数据中台则强调数据的资产化与服务化,核心目标是让数据可复用、可服务化,直接赋能业务决策和运营。数据中台不是数据仓库的替代品,而是在其基础上增加了治理体系、标准化定义和服务化输出能力。
Q2:中小企业是否适合建设数据中台?
数据中台的建设规模应与企业的数据体量和业务复杂度匹配。中小企业可以从核心业务场景切入,优先解决数据标准统一和关键指标的打通问题,不必追求“大而全”。Dataphin提供基础研发版和智能研发版等不同版本,企业可以根据实际需求选择适配的能力范围。
Q3:Dataphin的AI能力具体体现在哪些方面?
主要体现实时建模代码生成、智能质量根因诊断、自动化资产盘点、NL2SQL交互等方面。数据工程师可通过自然语言描述业务逻辑,平台自动生成规范的数仓模型和ETL代码;质量问题可由AI自动分析根因并生成修复建议。
Q4:数据中台建设通常需要多长时间?
这取决于企业数据规模和业务复杂度。通常,数据接入和基础标准体系的搭建可以在数周至数月内完成,但数据治理和业务赋能是一个持续迭代的过程。建议采用“小步快跑”的方式,先在一个业务板块完成闭环验证,再逐步扩展到全组织。
Q5:如何衡量数据中台建设的成效?
可以从三个维度衡量:一是数据质量维度,如指标口径一致性、数据异常率;二是效率维度,如数据开发周期、报表交付速度;三是业务价值维度,如数据驱动的决策占比、业务增长贡献。上汽大众的实践表明,数据资产的可视化管理和标准化清单可以显著提升数据发现效率和使用便捷性。
引用来源
1. 阿里云开发者社区,《2026年企业如何建设数据系统?从0到1全景路线图解析》,2026年9月15日
2. 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026年9月15日
3. 瓴羊,《企业级数据中台实战指南:打通数据、治理数据、服务业务三步走》,2026年9月3日
4. 瓴羊,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026年4月24日
5. 阿里云,《Quick BI 助力雅戈尔从 16 个系统到 1 个平台,打通全业务数据壁垒》,2025年8月5日
6. 阿里云开发者社区,《企业如何建设数据系统?一文带你了解》,2026年9月17日
7. 阿里云帮助中心,《什么是Dataphin》,2025年6月30日
8. 瓴羊,《从规则驱动到智能协同:瓴羊Dataphin重塑2026数据治理新范式》,2026年8月18日
9. 阿里云,《Agent 赋能企业数据治理》,2025年11月6日
10. 阿里云开发者社区,《Dataphin功能Tips系列(85)告别“人肉排障”:AI驱动数据质量根因诊断》,2025年12月23日
