
把这一周的更新拉成一张清单,会看到一个挺意外的画面。
这些平时互相较劲、拼模型、拼补全速度的工具,这一周发布的东西出奇地一致——没有一个是关于"更聪明"的,几乎全是关于"更可控"。
这一周,各家都发了什么
Cursor 上线了 Projects。它的结构和以前不一样:新增了一个"协调者"角色,负责拆解任务、把子任务派给并行的执行单元,自己不动源码,只做调度和汇总。任务跑在云端,关掉本地编辑器也不中断;所有执行单元维护同一份文件目录,前一个跑出来的发现会写进项目上下文,交给后面的继承。官方还给了它几个触发入口:绑定到某个频道、跟随定时计划、或者监听新提交的PR。
GitHub Copilot 把企业托管权限推到了正式可用。配置文件里能用 deny / ask / allow 三档规则,分别管三件事:能执行哪些Shell命令、能读写文件系统的哪些位置、能访问哪些网络域名。关键点在于——这套策略不能被开发者本地设置或自动批准规则绕过。
Claude Code 这一周的版本节奏照旧很快,其中一个修复值得单独提:修掉了macOS和Linux上的符号链接权限绕过问题。原来的规则写在软链别名上,通过引用真实路径的命令可以绕过去。同一批更新里还给工具结果加了1GB上限,给插件生命周期命令加了JSON输出。
Devin 把技能、规则、hooks和MCP配置打包成一个可安装单元,安装时会逐项列出申请的权限能力,企业管理员可以把它标记为必需或可选。
为什么会集体转向这一步
因为Agent的形态变了。
一年前,这些工具的定位是"补全":你写一行,它给一行;你圈一段,它改一段。这个形态下,权限问题不突出——所有的动作都要你按一次确认。
现在主流的形态是"自己动手":它能读多个文件、能跑命令、能调工具、能连着做几十步。能力越强,能造成的后果就越大。一句被污染的上下文,就可能变成一条被执行的命令。
企业客户是最先感受到这个变化的一方。他们的问题不再是"这个模型强不强",而是:它能碰哪些文件?能不能发出网络请求?一次任务会花掉多少钱?出了事,日志在哪里?
Cursor那个"协调者+并行执行单元"的结构,也顺势带来了新的管理问题——官方自己列了三个试点检查点:上下文增长与漂移、并发带来的资源消耗、本地执行单元的边界。
对Java团队来说,选型标准多了一条
以前选AI编程工具,看的是补全质量、支持的模型、对框架的理解程度。这三条现在依然重要,但不够了。
如果Agent要在你的生产代码库上跑,还得加一条:它能不能被管住。
具体是三个问题:
- 边界在哪。它能访问的目录、能执行的命令、能访问的域名,有没有地方能统一配,还是只能靠开发者自觉
- 上限在哪。一次任务的时间、token、花费有没有硬上限,还是跑飞了才知道
- 痕迹在哪。它做过的每一步,事后能不能查
这三条对一个只有几万行代码的个人项目或许无所谓,但对一个跑了五年、有合规要求的Java系统来说,是能不能上桌的前提。
三个问题里,痕迹这条最难落地
边界和上限都有明确的技术形态:一份配置文件、一个配额参数,能读出来就能验收。痕迹这条最虚,因为"痕迹"其实分两层。
飞算JavaAI的智能体计划模式,处理的是第二层:复杂任务先被拆成多个步骤,再逐步执行,中途可以停下来看当前这一步产出了什么。每一步的产物——需求整理、接口定义、表结构、处理逻辑说明——以文件形式落在项目工作区里。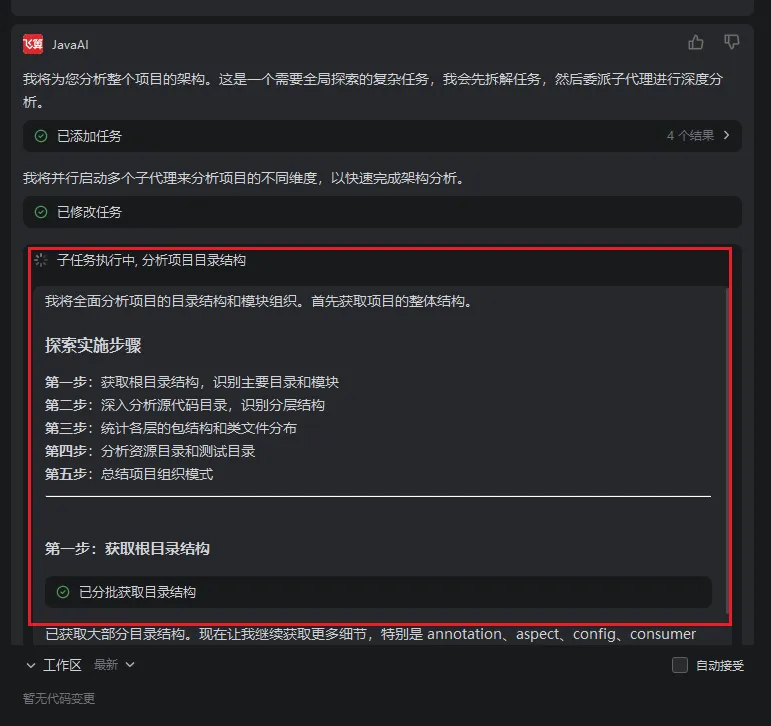
差别就在产物的形态上。沙箱和权限日志能回答"它执行了哪条命令、动了哪个目录",回答不了"它这一步的判断对不对"。前者是操作级记录,后者需要业务级产物:把需求理解和设计结论落成能打开、能对照的文件,复盘才有对象。所以"痕迹"这一条的验收标准,不是有没有日志,而是记录能不能支撑一次事后审核。
它管不到的地方,也是这条线的分界:留痕不等于做对。产物摆在眼前,需求是不是理解偏了、表结构是不是合理,仍然要人来判断,这一步没有工具能替你走完。
但治理只管得住"能不能做"
有一点需要说清楚,避免高估这一波更新的意义。
沙箱和权限门解决的是"Agent能做什么"。它解决不了"Agent做出来的东西对不对"。
代码能不能通过评审、表结构设计得合不合理、这个改动有没有破坏别的东西——这些依然回到工程纪律上。治理是底线,不是质量。
这也是为什么,同样是让AI干活,有人把范围限定得清清楚楚、每一步都留下可查的产物,有人丢一句话然后收拾三天残局。差别不在工具权限,在使用方式。
最后
这一周各家发的更新,其实在传递同一个信号:AI编程工具的竞争轴,正在从"模型多强"转向"Agent怎么被管住"。
能力已经够用来干活了,接下来比的是谁能让企业敢用。
一个问题留给大家:如果明天要在一个有合规要求的生产项目上开Agent,你们团队最先要确认的三件事是什么?我从这次更新里挑的是边界、上限、痕迹——你们呢?




