◆ 博主名称: QuZhengRong
AI生产者,样式苦手
目录

文档切完之后,下一步是从切片里召回上下文。 向量检索 是上下文召回的主流方案,但仅靠向量检索容易召回语义相近但事实无关的切片,影响后续回答质量,因此生产环境普遍采用混合检索的方案来提高召回效果,这一篇要讲的就是混合检索。
一、概念:什么是混合检索
混合检索就是同时采用向量检索和关键词检索,将两者检索的结果汇总成一份候选列表。
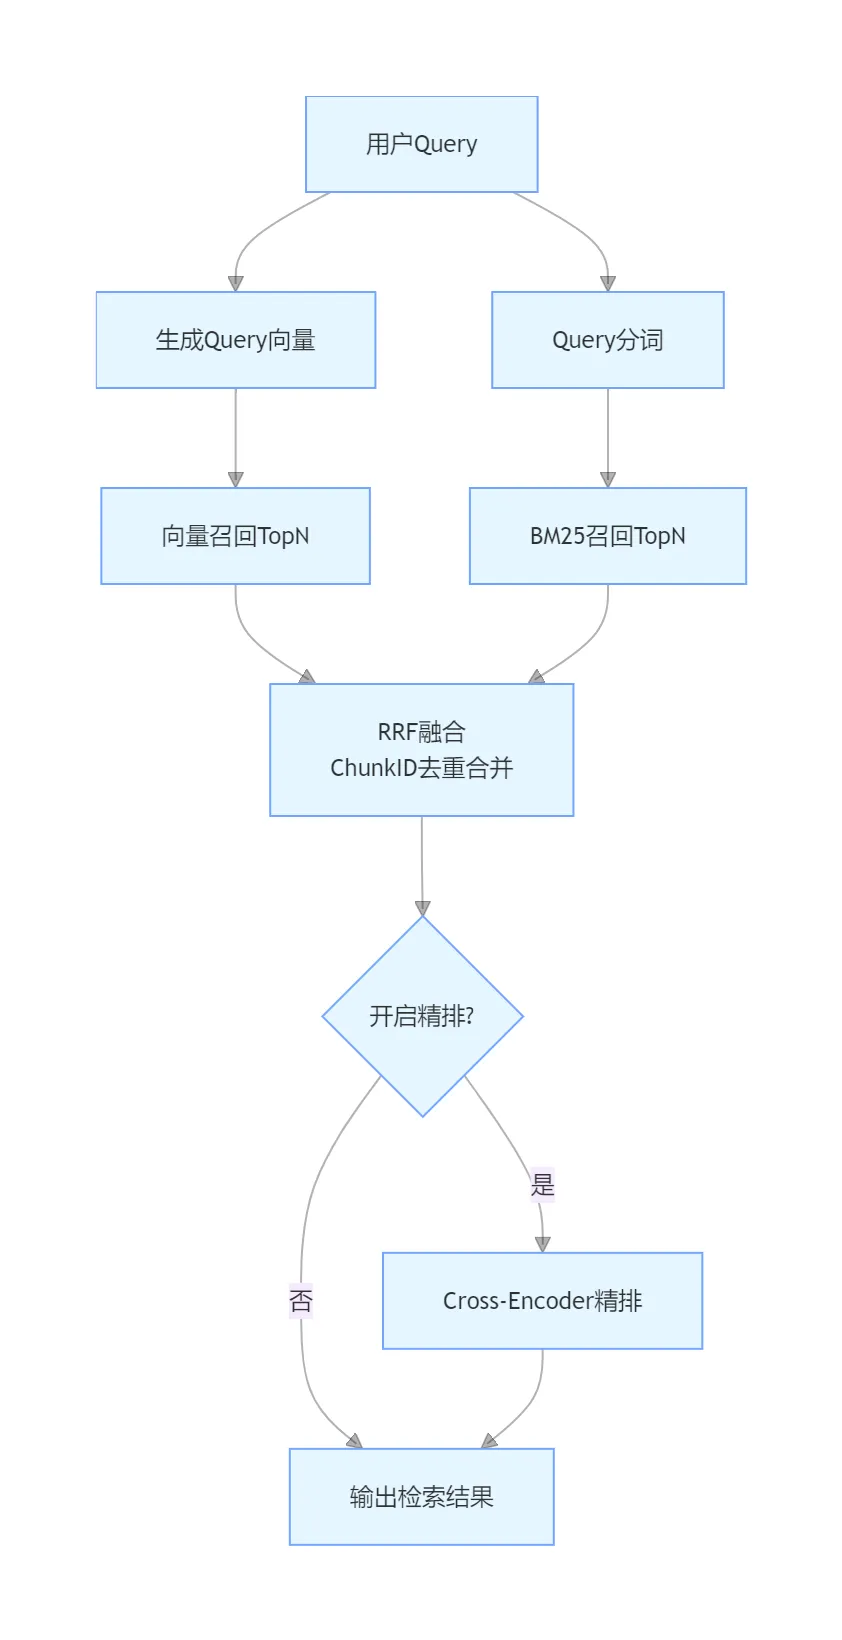
向量检索:使用嵌入 模型 将文本转换为向量,在向量数据库中做相似度匹配,依据余弦相似度做结果排序。
关键词检索(主流为 BM25):基于字面词语重合度打分,擅长处理编号、专有名词、数字与固定术语。
两种检索都有短板:向量检索对精确字面不敏感,容易丢失业务 ID、标识符等关键字;BM25 则没法理解语义。
因此采用双路并行检索的策略,向量补语义,BM25 补精确匹配。代价是要建两套索引、做一次融合,延迟和实现复杂度都比单路高。
二、混合检索实现方案
混合检索可以分成四步:建立索引 → 双路召回 → 统一排名 → 精排(可选)。
1、建立索引
BM25 和向量共用同一批切片,chunk id 保持一致,这样两路检索的结果合并时才能识别出哪些 chunk 是重复的。
向量路用 embedding 入库,关键字路则需要建立倒排索引,
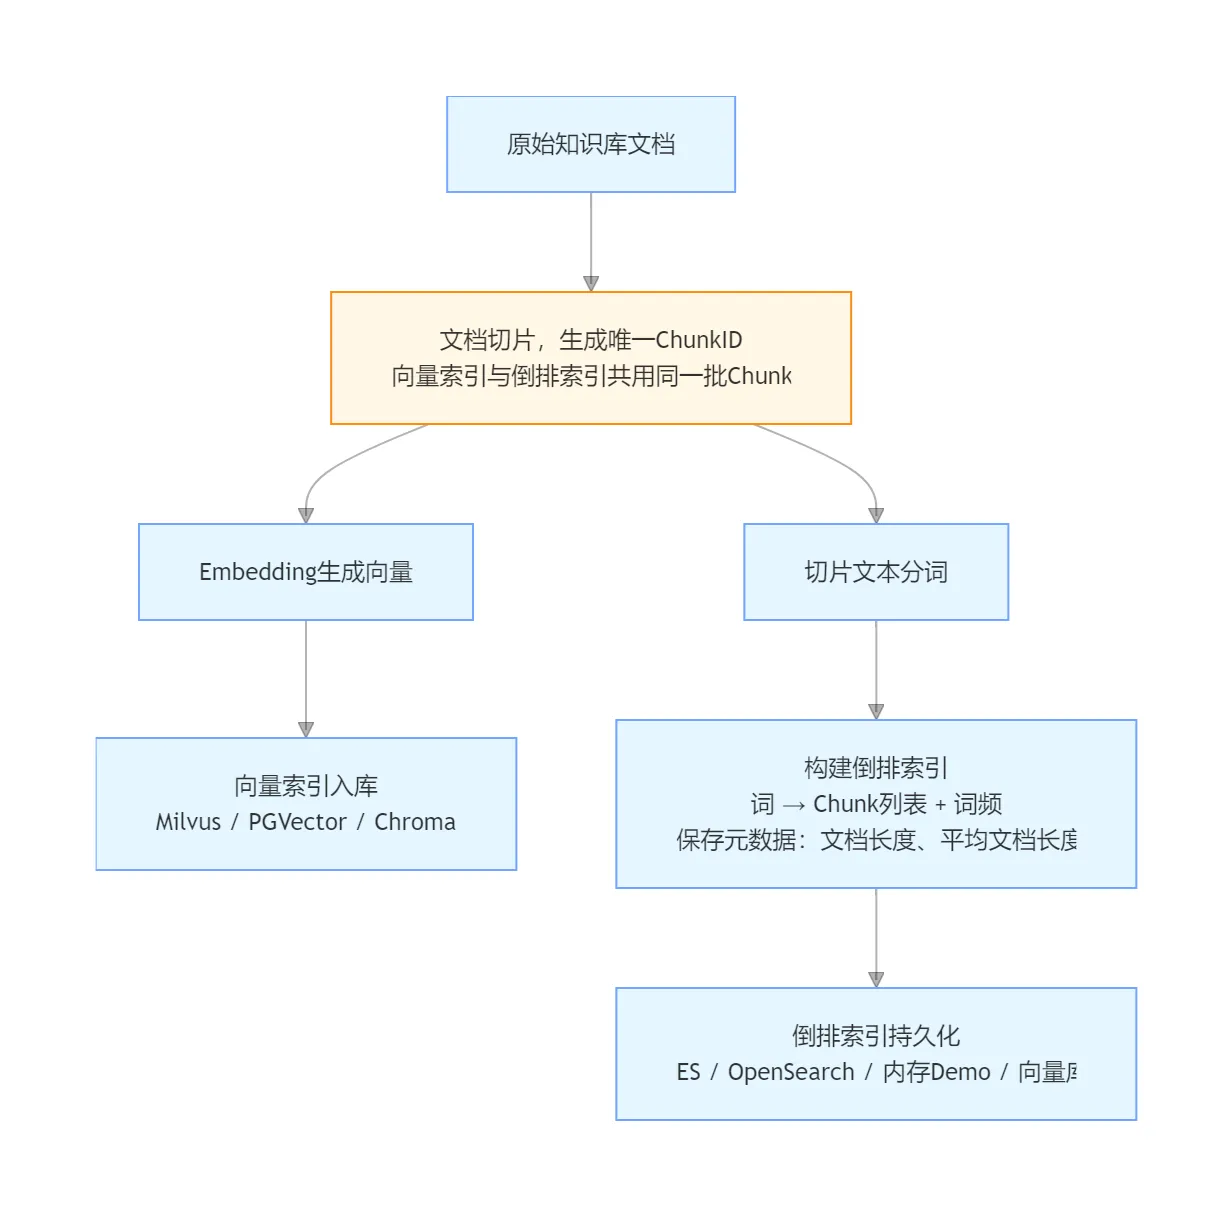
重点讲下关键字路的步骤,关键字路在切片前要先分词。在垂直领域场景下,Jieba 默认词典缺少大量行业专有术语,会出现错误单字拆分,例如将「动线」切分为「动」「线」。单字词文档频率 DF 普遍偏高、IDF 权重极低,导致核心术语失效,实质等同于关键词丢失。因此垂直知识库在建索引前,必须提前导入领域术语自定义词典,保证专业词正确分词。
分完词写入倒排索引:词 → 出现过该词的文档列表(以及词频)。另外存每篇文档长度、语料平均长度、每个词的 DF,打分时直接取。demo 可以全放内存;生产一般交给 Elasticsearch / OpenSearch 维护倒排,文档更新时同步写入或重建索引。部分向量库也带稀疏检索,本质仍是倒排 + 类似 BM25 的打分。
2、双路召回
查询时两路并行,各出一份 top-k ,再交给后面融合。向量路用余弦相似度;BM25 路把查询同样分词,按词去倒排取候选,再算分。
BM25 用于计算查询词与文档之间的字面相关性得分,得分主要由三部分构成:
- 词频(TF):查询词在文档中出现次数越多,得分越高。
- 逆文档频率(IDF):词语在语料库中越稀有,命中后贡献的分数越高。
- 长度归一化:相同词频条件下,长文档会做分数折扣,避免长文档天然获得更高分数。
3、统一排名
两路分数计算方式不同,所以不能直接拿来比较排名,常见的融合方式有以下两种:
归一化加权:将两路得分通过 min‑max 归一化至 0~1 区间,再按权重求和。希望偏向语义匹配则调高向量检索权重;文档中术语、编号较多时,则调高 BM25 权重。缺点是归一化结果依赖当前候选集合,候选集发生变化,同一文档归一化后的分数也会变动,不同查询之间分数不具备可比性。
RRF(Reciprocal Rank Fusion):舍弃原始得分,仅依靠结果排名计算分数:
score = Σ 1 / (k + rank)
rank 从 1 起,k 常取 60。此时第 1 名 ≈ 0.0164,第 10 名 ≈ 0.0143。
无明确偏向需求时优先选用 RRF;业务需要刻意倾斜某一路检索结果,再选择归一化加权。
4、精排
融合仅完成粗排阶段。RRF 算法 本身不会解析 Query 和文档的实际内容,如果两路检索都召回了无关切片,依然会被排在靠前位置。
精排把候选和 query 配对,按对回答有没有用重打分。有专用 rerank 模型最好;没有的话,可以把候选一次性塞进 大模型 打 0~10 分再排序。
三、实战
做一个餐饮门店经营避坑手册的混合检索实战:手册切成 23 块,自拟 12 道题,每题标一个答案片段里必须出现的关键词,对比向量、BM25、混合三路在 top1 / top3 的命中率。
向量:命中率@1 8/12 = 67%,命中率@3 12/12 = 100%
BM25:命中率@1 9/12 = 75%,命中率@3 10/12 = 83%
混合:命中率@1 9/12 = 75%,命中率@3 12/12 = 100%
混合把 BM25 漏掉的改写题补回来了;@1 没有超过 BM25,样本只有 12 条,当参考。
1、切片与词典
from langchain_text_splitters import RecursiveCharacterTextSplitter

CN_SEPARATORS = ["\n## ", "\n### ", "\n\n", "\n", "。", "!", "?", ";", ",", " ", ""]

def load_chunks() -> list[str]:
    text = DOC_PATH.read_text(encoding="utf-8")
    splitter = RecursiveCharacterTextSplitter(
        separators=CN_SEPARATORS,
        chunk_size=250,
        chunk_overlap=40,
        length_function=len,
    )
    return splitter.split_text(text)
# 不加会切成单字,BM25 基本废掉
for word in ["动线", "坪效", "扣点", "档口", "毛利", "复购", "引流款", "利润款", "形象款", "SKU"]:
    jieba.add_word(word)
2、BM25
class BM25:
    def __init__(self, corpus: list[str], k1: float = 1.5, b: float = 0.75):
        self.k1 = k1
        self.b = b
        self.doc_count = len(corpus)
        self.doc_terms = [tokenize(doc) for doc in corpus]
        self.doc_lens = [len(terms) for terms in self.doc_terms]
        self.avg_len = sum(self.doc_lens) / self.doc_count
        self.term_freqs = [Counter(terms) for terms in self.doc_terms]

        doc_freq: Counter = Counter()
        for terms in self.doc_terms:
            doc_freq.update(set(terms))
        self.doc_freq = doc_freq

    def _idf(self, term: str) -> float:
        df = self.doc_freq.get(term, 0)
        return math.log(1 + (self.doc_count - df + 0.5) / (df + 0.5))

    def scores(self, query: str) -> list[float]:
        terms = tokenize(query)
        result = []
        for i in range(self.doc_count):
            score = 0.0
            for term in terms:
                tf = self.term_freqs[i].get(term, 0)
                if tf == 0:
                    continue
                # 长文档同样词频要打折
                norm = 1 - self.b + self.b * self.doc_lens[i] / self.avg_len
                score += self._idf(term) * tf * (self.k1 + 1) / (tf + self.k1 * norm)
            result.append(score)
        return result
3、融合
def min_max_normalize(scores: dict[int, float]) -> dict[int, float]:
    if not scores:
        return {
   }
    values = list(scores.values())
    low, high = min(values), max(values)
    if high == low:
        return {
   key: 1.0 for key in scores}
    return {
   key: (value - low) / (high - low) for key, value in scores.items()}

def weighted_fusion(vector_hits, bm25_hits, vector_weight=0.5, bm25_weight=0.5):
    vector_scores = min_max_normalize(dict(vector_hits))
    bm25_scores = min_max_normalize(dict(bm25_hits))

    fused = {
   }
    for idx in set(vector_scores) | set(bm25_scores):
        fused[idx] = (
            vector_weight * vector_scores.get(idx, 0.0)
            + bm25_weight * bm25_scores.get(idx, 0.0)
        )
    return sorted(fused.items(), key=lambda x: x[1], reverse=True)

def rrf_fusion(vector_hits, bm25_hits, k: int = 60):
    fused = {
   }
    for hits in (vector_hits, bm25_hits):
        for rank, (idx, _) in enumerate(hits):
            fused[idx] = fused.get(idx, 0.0) + 1 / (k + rank + 1)
    return sorted(fused.items(), key=lambda x: x[1], reverse=True)
问 “1.2 租金红线” 时,两路第一名一样,差在二三名:
问题:1.2 租金红线
  向量路召回 8 条,BM25 路召回 4 条
  纯向量排序
    1. [分 0.6568] ### 1.2 租金红线
    2. [分 0.5076] ## 二、成本结构:三条红线
    3. [分 0.5032] ## 一、选址:先看动线,再谈租金
  纯 BM25 排序
    1. [分 6.9532] ### 1.2 租金红线
    2. [分 3.5932] ## 一、选址:先看动线,再谈租金
    3. [分 2.6597] ### 1.1 三种铺位类型
  归一化加权融合
    1. [分 1.0000] ### 1.2 租金红线
    2. [分 0.3826] ## 一、选址:先看动线,再谈租金
    3. [分 0.2353] ### 1.1 三种铺位类型
  RRF 融合
    1. [分 0.0328] ### 1.2 租金红线
    2. [分 0.0320] ## 一、选址:先看动线,再谈租金
    3. [分 0.0318] ## 二、成本结构:三条红线
4、精排
RERANK_PROMPT = """你是检索排序助手。请判断下面每个候选片段对回答用户问题的有用程度,给 0~10 的整数分。
10 分表示片段直接回答问题,0 分表示完全无关。片段之间分数可以相同。
只输出 JSON 数组,不要任何解释文字:形如 [{"id": 0, "score": 8}]

用户问题:{query}

候选片段:
{candidates}
"""

def rerank(query: str, candidates: list[str]) -> list[tuple[int, float]]:
    formatted = "\n".join(f"[{i}] {text[:200]}" for i, text in enumerate(candidates))
    response = llm.invoke(RERANK_PROMPT.format(query=query, candidates=formatted))
    content = re.sub(r"^```json|```$", "", response.content.strip(), flags=re.MULTILINE).strip()

    try:
        scored = json.loads(content)
    except json.JSONDecodeError:
        print("  精排返回解析失败,沿用召回顺序")
        return [(i, 0.0) for i in range(len(candidates))]

    ranked = [(item["id"], float(item["score"])) for item in scored]
    return sorted(ranked, key=lambda x: x[1], reverse=True)
外卖满减这题,RRF 把 “出餐速度” 排进前三;精排后掉出去,“定价错误” 顶上来——满减亏不亏本质是定价,得读内容才分得清:
问题:外卖满减怎么设计才不亏本
  召回候选 10 条
  RRF 融合排序 top3:
    1. [分 0.0328] ## 六、线上运营与外卖
    2. [分 0.0320] ### 2.1 容易被忽略的隐性成本
    3. [分 0.0312] ### 6.1 出餐速度是外卖的生命线
  精排后 top3:
    1. [分 10] ## 六、线上运营与外卖
    2. [分 9] ### 3.1 定价的常见错误
    3. [分 8] ### 2.1 容易被忽略的隐性成本
评测脚本在 recall_eval.py,题集要掺改写问法,不然数字偏向 BM25:
TEST_SET = [
    ("加盟品牌怎么判断靠不靠谱", "品牌直营店"),
    ("1.2 租金红线", "百分之十五"),
    ("金角银边草肚皮", "草肚皮"),
    ("厨师走了配方怎么办", "料包"),
    ("外卖满减怎么设计才不亏本", "反推利润"),
    ("供应商出事了怎么办", "三文鱼"),
    ("店长每天要盯什么", "顾客投诉"),
    ("关店前要算哪些账", "储值卡"),
    # 改写问法,字面对不上,专门打向量路
    ("后厨师傅一走顾客就不来了,怎么防", "料包"),
    ("每天生意看着还行,月底一算没利润", "折旧"),
    ("平台抽完成到手还剩多少", "百分之七十"),
    ("亏到什么程度就该收手了", "一点五倍"),
]
四、总结
混合检索整体流程包含:索引构建、双路召回、结果归并排序,必要时追加精排环节。
向量检索负责语义匹配,BM25 负责字面关键词匹配;结果融合优先选用 RRF 算法,若需要侧重某一路结果,可改用加权融合;精排会读取文本实际内容,用于修正粗排输出的顺序。
五、LuckReport 项目推荐
导航:LuckReport专栏
1、项目简介
Luck-Report 是一款基于开源项目 UReport2 重构的 Java 高性能报表引擎,通过迭代单元格可以实现任意复杂的中国式报表。相较于 UReport2,Luck-Report 在技术架构上进行了全新升级,后端基于 SpringBoot 框架开发、前端采用 Vue 框架构建,技术选型贴合当下主流项目开发标准,可精准适配各类实际开发需求。
Luck-Report 提供了全新的基于网页的报表设计器,可以在 Chrome、Firefox、Edge 等各种主流浏览器运行(IE 浏览器除外)。使用 Luck-Report,打开浏览器即可完成各种复杂报表的设计制作。
Luck-Report 基于 Apache-2.0 开源协议 开源