
先说这个痛点有多普遍
做工程投标的人对下面这个场景应该不陌生。
一份施工组织设计(技术标),几百页、几十万字。真正"因这个项目而异"的内容——重难点分析、针对性措施——可能不到 20%。剩下 80% 是:翻历史标书、翻工法库、把项目名和数字换一遍、调整章节顺序。
换一个项目重来一遍,换一个标段重来一遍。经验留不下来。
最难受的是时间分配反了:精力全耗在"找素材 + 复制粘贴"上,真正需要人来判断的地方反而没时间深想。
我做了个工具来解决这件事,最近把它开源了:
BidCraft 标书匠 —— 对话式工程标书编制智能体。Apache-2.0,免费开源。
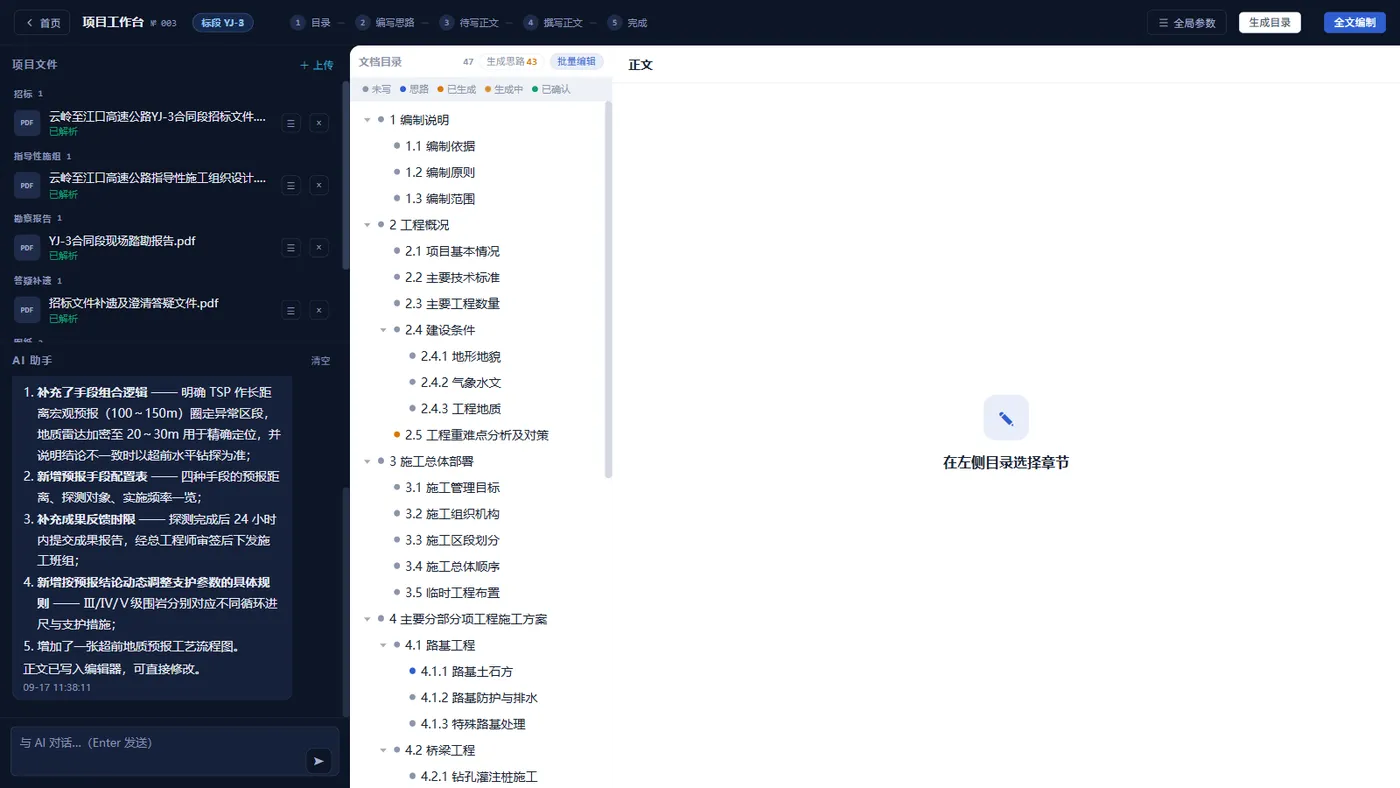
它能做的事:上传招标文件 → 自动解析出标段划分、评分办法、技术要求、规定的目录结构 → 生成目录 → 逐章生成编写思路 → 生成正文 → 你在编辑器里改 → 不满意就对话下达指令。
界面长这样(演示项目是虚构的):
但这不是一篇"看我又做了个 AI 套壳"的文章
先说结论:这个项目的 LLM 走的是阿里云百炼的 qwen 系列(OpenAI 兼容接口,所以换模型只要改 LLM_BASE_URL),文档解析用 MinerU。
但重点不是我又做了个 AI 套壳 —— 是我在知识库这一层踩的坑。
因为这个项目最有意思的技术决策,是我最后没有用 RAG——而且不是一开始就没用,是用到一半把整个向量库删掉了。
如果你正在做"让 LLM 读懂一堆私有文档"这类需求,这段经历可能对你有用。
起点:我一开始是打算用 RAG 的
做知识库的第一反应几乎都是 RAG:
文档 → 切片 → 向量化 → 存向量库
问题 → 向量化 → 相似度检索 → Top-K 片段 → 塞进 prompt
这条路成熟、有大量现成方案、社区验证充分。我一开始就是这么立项的,.env 里甚至预留了 embedding 模型和向量维度的配置,代码里也实装了"三级匹配都零命中时用向量补召回"的兜底路径。
然后我发现它在这个场景下对不上。
问题一:这不是"问答",是"照章办事"
RAG 的隐含假设是:用户有个问题,答案散落在文档某几段里,检索出那几段就够了。
但"写一章施组"不是这样。
当我要写「2.3 隧道超前地质预报」这一节时,我需要的不是"文档里关于地质预报最相似的 5 个片段",我需要的是:
- 这一节应该怎么写(先写什么、后写什么、详略怎么分配)
- 有哪些典型表格(预报手段一览表?频率表?)
- 有哪些典型图(预报流程图?孔位布置图?)
- 适用范围(什么情况下用 TSP,什么情况下用地质雷达)
这些是结构化的编写知识,不是一堆文本片段。
把它切成 512 token 的块再靠相似度捞回来,捞回来的是"文本",不是"知识"。
问题二:切片的边界,恰好切在最不该切的地方
这个我实测过。一份历史施组里,「超前地质预报」这一节的真实结构是:
超前地质预报
├─ 预报目的与依据
├─ 预报手段(TSP / 地质雷达 / 超前钻探 / 瞬变电磁)
│   ├─ 各手段原理与适用条件
│   ├─ 各手段实施方法
│   └─ 各手段成果形式
├─ 预报频率与段落划分
├─ 预报成果的反馈与施工调整
└─ 组织机构与职责
固定长度切片之后会发生什么:
- "TSP 的适用范围"和"地质雷达的适用范围"被切到了不同的块里
- 块与块的边界完全取决于字符数,跟章节结构毫无关系
- 检索召回了三块,但缺了"频率与段落划分"那块——因为那块单独看相似度不高
结果就是:模型拿到了一堆相关知识,但拿不到完整的写法。
写出来的东西,像是从几篇不同文章里各抄了一段拼起来的。
问题三(最本质):这个场景里,"怎么写"比"写什么"重要得多
RAG 解决的是"写什么"(事实性知识)。
但在标书编制里,"怎么写"的权重远大于"写什么":
- 一个「施工组织安排」章节,专业内容谁都知道,难的是怎么把这个项目的具体情况组织成一段有说服力的文字
- 一篇历史施组的价值,很多时候不在于它写了什么数字,而在于它的行文习惯、章节展开方式、详略取舍
这些是风格与方法论层面的知识——切碎了就没了。
所以我换成了什么:LLM-Wiki
核心思路一句话:
不要在生成时去"检索文本",而要在解析时就把知识整理成"条目",生成时让模型读条目做判断。
具体做法分三步。
1. 历史施组 → 知识页(不是切片,是提炼)
一份历史施组进来,先按标题结构切章建树,然后逐章调一次 LLM 提炼,产出一条结构化知识页:
{

  "title": "隧道工程 > 超前地质预报",
  "chapter_type": "施工方案",
  "tags": ["隧道"],
  "content": {

    "method": "先讲预报目的与依据,再按手段分述(TSP/地质雷达/超前钻探),最后写成果反馈与动态调整",
    "key_points": ["长短结合、多手段相互印证", "断层破碎带加密探测"],
    "tables": [{
    "name": "超前地质预报手段一览表", "columns": ["手段","预报距离","探测对象","频率"] }],
    "images": [{
    "name": "超前地质预报工艺流程图", "caption": "预报工作流程" }],
    "usage": "适用于隧道超前地质预报类章节,尤其需要说明多种手段组合与成果反馈机制时"
  },
  "source_location": "第 3 章 3.4 节"
}
注意几个字段:
method是"怎么写" —— 这一节的展开方式。这是 RAG 拿不到的东西。tables/images是清单 —— 不是图表本身,而是"这里该有什么表/图"的提示usage是使用方式 —— 决定它什么时候该被引用(下面会讲这个字段为什么重要)
2. 项目文件 → 章节索引(不切片,索引 + 完整原文)
招标文件、指导性施组动辄几百页。全给塞不下,切片又会切碎。
所以走两段式:
- 解析时:每一章调一次 LLM,生成
章节全路径标题 + 概要 + 适用范围作为索引 - 使用时:AI 看索引选章节 → 选中后取该章节的完整原文(不截断、不切片)
这个思路本质上是借了 skill 的思路:先给模型一份目录和"这节讲什么"的说明,让它自己判断"我要写这个章节,应该看哪几节",然后给完整的。
3. 工艺工法 → 一工法一条概况
更简单:一篇工法一条"名称 + 概况 + 适用范围",用时 AI 选,选中的整篇注入。
效果差异
| RAG 切片 | LLM-Wiki | |
|---|---|---|
| 知识单位 | 固定长度文本块 | 结构化条目(含"怎么写") |
| 检索方式 | 向量相似度 | AI 读索引/使用方式做判断 |
| 上下文质量 | 相关但不完整、边界随机 | 完整且结构对应章节 |
| 可追溯性 | 知道来自哪个文件,不知道来自哪一节 | 精确到"某文件 · 某章节" |
| 成本 | 需要 embedding + 向量库运维 | 解析时多花 LLM 调用,无额外基础设施 |
最后两行其实很关键:
做标书的人必须能核对来源。 向量相似度 0.83 对编制人员毫无意义;
"这条写法来自《XX 项目施组》第 3.2 节"才有意义。
而且我少维护了一套基础设施。 没有向量库、没有 embedding 服务、没有索引重建。
顺便说一句:我后来把向量库整个删掉了——
llm.embed()直接raise NotImplementedError,
那个"零命中时向量兜底"的路径实测几乎从没被有效触发过,触发的场景往往是"本来就没有相关知识",
硬捞回来的东西反而引入噪声。这个兜底从一开始就是心理安慰。
顺着这条路线,衍生了几个有意思的设计
① 三级漏斗:让便宜的手段先拦掉大部分
知识页有了,"写某一章时怎么找到该用的那条"又是问题。
朴素做法两种都不行:全给(上下文浪费、模型在长列表里选择质量下降)、让模型自由发挥(它会说要库里根本没有的东西)。
最后做成三级漏斗(matching.py):
待写章节路径
   ↓
第一级 · 专业标签过滤        「隧道」只保留 tags 含"隧道"的页
   ↓  1000 条 → 几十条
第二级 · 标题相似度(字符 bigram Dice)
        ≥ 0.80 直接命中 / 0.35~0.80 进模糊带 / < 0.35 淘汰
   ↓
第三级 · LLM 终判(只在模糊带触发,每章最多一次调用)
关键点:大部分章节在第二级就结束了,根本不需要调 LLM。
② usage 字段:不要让模型猜用途,把用途写下来让它读
第三级要给模型候选列表让它判断。一开始只给标题,结果判断得很随意——光看标题,"超前地质预报"和"超前支护"确实很难说哪个更该用。
后来把知识页的 usage(使用方式/适用场景) 加进判断输入,准确率明显提升:
候选 1:隧道工程 > 超前地质预报
       使用方式:适用于隧道超前地质预报类章节,尤其需要说明多种手段组合时

候选 2:隧道工程 > 超前支护
       使用方式:适用于洞口段、断层破碎带的超前支护措施章节
模型看到"使用方式"就知道该选哪个了。
这个字段现在是整个知识页 schema 里性价比最高的一个——它把"什么时候该用我"这个只有人类知道的信息,显式写进了数据里。
③ 防"抄错 ID":给模型看序号,不给真实 ID
模型会编造 ID。给它看 id=317 / id=892,它可能返回不存在的 id=445,或者把 317 记成 371。
解决很土但有效:给模型看的是连续序号,程序再把序号映射回真实 ID。
候选 1: 超前地质预报
候选 2: 超前支护
模型只回答"候选 1",抄错的概率大幅下降,而且即使抄错也能被程序立刻发现(序号越界),不会静默写入错误引用。
④ 上下文取舍:什么该全给,什么必须精挑细选
这条界线我划得很明确:
约束类和事实类的东西,宁可全给也不漏;素材类和参考类的东西,必须精挑细选,给多了有害。
全给的:标段档案(放在最前面当"硬边界")、全局事实表、用户本次要求、同级章节标题。
精挑的:知识页、项目文件原文、工法。
其中有个反直觉的决定:知识页的 method(怎么写的)反而不注入正文生成。
因为实测发现——一旦把历史章节的"编制方式/要点"结构给模型,它会照着这个结构复制,写出来的东西和历史上那一章高度同构,丧失本项目应有的针对性。
最终方案是"给风格,不给内容;给形状,不给数字":
- 只给该历史章节的完整原文作行文风格示范
- 只给表格/图片清单(该配什么表、什么图),不给历史表格里的数据
⑤ 降幻觉:把"编内容"转化成"待办事项"
AI 写几十万字专业文档,指望它 100% 正确不现实。所以目标不是"消除幻觉",而是把人工核对的工作量压到最低。
最有效的一条硬规则是:
所有数字必须来自「本项目事实」或「本项目文件原文」;两者都找不到的数值,一律标注
[待补充],禁止借用历史资料里的数值。
设计意图很直接:把"幻觉"转化成"待办事项"。
- 模型编一个数字 → 你无法察觉,直到出事
- 模型标
[待补充]→ 你一眼看到,去查一次,填上
宁可留一个显眼的空,也不要填一个看不出问题的错。
而且这些数字单独抽出来存进"全局事实表",标明出处、人工可改、改动不会被后续重抽取覆盖。这样"同一个工期在文档里出现三种写法"这种问题从机制上就不会发生。
代价是什么(诚实版)
LLM-Wiki 不是没有代价,我不想只讲好的一面:
- 解析成本更高。一份 500 页的历史施组,切片入库几乎免费;逐章提炼要几百次 LLM 调用。所以做了 20 并发和 MD5 缓存(同文件不重复解析)。
- 解析质量决定上限。提炼出来的知识页质量差,后面全差。这也是提炼 prompt 改了很多轮的原因。
- 放弃了"模糊联想"能力。RAG 有时能捞到"字面不像但语义相关"的内容,章节索引做不到——索引概要里没写的就找不到。靠"概要写全一点"来补偿。
- 知识库扩容不是即时的。新加一份历史施组要等提炼跑完才能用(几百页十几分钟)。
这些代价我认为值得,因为换来的是上下文质量。而"生成几十万字专业文档"这个场景下,上下文质量基本等于输出质量。
其他值得一提的
对话式而不是按钮式。 编制是"边想边改"的过程,不是一条流水线。所以交互做成了对话:直接说"第三章重写一下,突出隧道超前地质预报"、"把工期那几个数字统一成 26 个月",模型自主决定调哪些工具(目前 15 个)。
特别做了执行核验:模型声称"已生成第三章"时,系统会核验本轮是否真有对应的工具成功记录,没有就否决——因为对话式最大的可用性风险不是"AI 答不好",而是"AI 说它做好了但没做"。
docx 解析路线改了三版。 最终结论是:有样式可读的(docx)直接读样式,没有的(PDF/图片)才交给 OCR。中间一度改成"docx 转 PDF 再 OCR",结果发现既依赖本机 Office(部署门槛高),又主动丢掉了 docx 本来的结构信息,绕一圈精度还降了。
开源信息
仓库:https://github.com/zeronezer/bidcraft
- Apache-2.0 —— 可商用、可修改、可闭源分发,唯一要求是注明来源
- 完全免费,无付费墙、无企业版
- 数据全部在你自己服务器上,除了你主动调用的 LLM 和文档解析服务,没有数据外流
- 不锁定模型:走 OpenAI 兼容接口,改个
LLM_BASE_URL就能换任何厂商
技术栈:FastAPI + Vue 3 + TipTap + LangGraph + MySQL + MinerU + 阿里云百炼(通义千问 qwen 系列)
为什么是百炼:这个场景每个标段要处理几十万字文档,还要反复调用做知识提炼和正文生成,对长上下文和调用成本都敏感。qwen 的长上下文实测一次能吃下 40 万字不截断,配合 OpenAI 兼容接口,切换成本几乎为零。
部署最省事的方式:把仓库丢给你的 AI 编程助手(项目自带 AGENTS.md,Claude Code / Codex / Cursor / Trae 等会自动读取),说一句"按 AGENTS.md 把这个项目跑起来"就行。
仓库里还有个 思路/ 目录,把这篇文章讲的东西展开成了 7 篇完整复盘,包括每个决定的代价和踩过的坑。
如果这个项目对你有用,欢迎给个 Star。 也欢迎来提 Issue 聊聊你在自己领域里做知识库的经验——我现在越来越觉得,"该不该用 RAG"这件事,答案取决于你的文档是不是强结构的。这个判断我可能还没想到所有情况。




