
摘要:乳品厂数字化的第一道坎不是"上系统",是收奶环节的数据建模。本文以实际项目中的数据库设计为例,拆解生牛乳从牧场到厂内生产线的批次绑定逻辑,并给出核心表结构和数据流。适合做工业软件、MES 开发、IoT 数据采集的开发者参考。
一、为什么收奶不能用"一张表搞定"
很多通用 MES 在乳品厂上线后,追溯做不出来的根因,出在收奶建模阶段。
牧场送一车奶到工厂,实际上携带了三层身份:
- 牧场批号:同一牧场、同一天、同一牛群产出的奶,有独立检测报告(脂肪、蛋白、菌落总数、抗生素)
- 槽车批号:同一辆车可能装了 2-3 个牧场的奶(拼车),每车有独立的 COA(Certificate of Analysis)
- 厂内收奶批号:工厂收奶时生成的内部批号,关联净乳机、暂存罐、验收结果
如果只用一张 raw_material_lot 表,把牧场批和槽车批混在一起,后面一旦客诉,你只能查到"用了哪车奶",查不到"这车奶里混了哪几个牧场的、哪个牧场的指标超标"。
所以正确做法是:三层独立建表,通过外键关联,系统自动绑定,不靠人填。
二、核心表设计
1. 牧场批次表 pasture_lot
CREATE TABLE pasture_lot (
pasture_lot_no VARCHAR(64) PRIMARY KEY,
pasture_name VARCHAR(128),
cow_group VARCHAR(32), -- 牛群编号
milk_date DATE, -- 挤奶日期
fat_rate DECIMAL(5,2), -- 脂肪含量 %
protein_rate DECIMAL(5,2), -- 蛋白含量 %
bacteria_count INT, -- 菌落总数
antibiotic_result VARCHAR(16), -- 抗生素检测:阴性/阳性
quality_status SMALLINT, -- 0待检 1合格 2拒收
created_at DATETIME
);
2. 槽车批次表 tanker_lot
CREATE TABLE tanker_lot (
tanker_lot_no VARCHAR(64) PRIMARY KEY,
tanker_no VARCHAR(32), -- 槽车编号
driver_name VARCHAR(32),
departure_time DATETIME, -- 离开牧场时间
arrival_time DATETIME, -- 到厂时间
temperature_on_arrival DECIMAL(4,1), -- 到厂温度
total_volume DECIMAL(10,2), -- 总体积 L
coa_no VARCHAR(64), -- COA 报告编号
created_at DATETIME
);
3. 槽车-牧场关联表 tanker_pasture_mapping
CREATE TABLE tanker_pasture_mapping (
id BIGINT PRIMARY KEY,
tanker_lot_no VARCHAR(64),
pasture_lot_no VARCHAR(64),
volume DECIMAL(10,2), -- 该牧场奶在此车中的体积
sequence_no SMALLINT, -- 装车顺序
FOREIGN KEY (tanker_lot_no) REFERENCES tanker_lot(tanker_lot_no),
FOREIGN KEY (pasture_lot_no) REFERENCES pasture_lot(pasture_lot_no)
);
拼车场景靠这张表解决:一车奶对应多个牧场批,每个批有多少升,系统自动记录。
4. 厂内收奶批表 milk_receive_lot
我们在万界星空科技乳制品MES里用 milk_receive_lot 这张表承接厂内收奶动作:
CREATE TABLE milk_receive_lot (
receive_lot_no VARCHAR(64) PRIMARY KEY,
tanker_lot_no VARCHAR(64),
receiving_line VARCHAR(32), -- 收奶线编号
clarifier_no VARCHAR(32), -- 净乳机编号
storage_tank VARCHAR(32), -- 暂存罐编号
receive_start DATETIME,
receive_end DATETIME,
received_volume DECIMAL(10,2),
temperature_in DECIMAL(4,1), -- 进线温度
temperature_out DECIMAL(4,1), -- 出线温度
fat_actual DECIMAL(5,2), -- 实际检测脂肪
protein_actual DECIMAL(5,2), -- 实际检测蛋白
status SMALLINT, -- 0收奶中 1待检 2合格 3隔离 4拒收
operator VARCHAR(32),
created_at DATETIME,
FOREIGN KEY (tanker_lot_no) REFERENCES tanker_lot(tanker_lot_no)
);
这张表是追溯链路的总入口:输入厂内收奶批号,系统自动展开 → 槽车批号 → 牧场批号列表(含每个牧场的脂肪/蛋白/菌落/抗生素结果)。
三、数据流:从收奶到杀菌到灌装
pasture_lot (牧场批)
↑
tanker_pasture_mapping (拼车映射)
↑
tanker_lot (槽车批)
↑
milk_receive_lot (厂内收奶批)
↑
processing_batch (生产工单)
├── sterilization_record (杀菌参数)
├── cip_record (清洗报告)
├── filling_record (灌装记录)
│ └── package_unit (箱码/托盘码)
正向追溯:成品箱码 → 灌装记录 → 生产工单 → 收奶批 → 槽车批 → 牧场批
反向召回:某牧场抗生素阳性 → 关联槽车 → 关联收奶批 → 关联生产工单 → 关联成品批 → 关联出库客户
四、几个容易踩的坑
- 槽车温度超限但牧场批合格
到厂温度 > 6℃ 时,即使牧场检测全部合格,也要标记"待复检"。系统里不能只存最终判定,要存每个环节的原始数据,审计时才说得清。
- 拼车奶混罐后无法拆分
多车奶进同一个暂存罐后,物理上已经混合。系统要做"混合批"标记:一旦混罐,追溯粒度只能到"罐"级别,不能假装还能精确到"哪车哪牧场"。提前告诉质量部门这个限制,别等飞检时解释不清。
- 收奶批和杀菌工单不是 1:1
一罐奶可能供 2-3 个杀菌工单(巴氏和 UHT 同时用),也可能一个工单用了 2 个罐的奶。系统要支持多对多映射,不能简单假设一对一。
- 拒收奶的去向要记
牧场批拒收后,槽车退回还是转做工业奶粉原料?这个决策和去向必须留痕,不能"口头处理"。
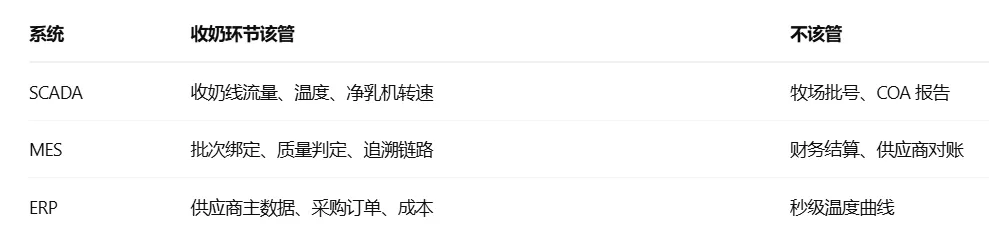
五、和 SCADA / ERP 的边界
六、小结
乳品厂批次追溯能不能做出来,80% 取决于收奶建模对不对。
核心原则:
• 牧场批、槽车批、厂内批三层独立,不合并不省略
• 拼车场景用映射表,不靠人脑记
• 每个环节的原始数据全留,不只有最终判定
• 追溯链路从第一天就跑通,别等飞检来了再补
把 milk_receive_lot 这张表设计扎实,后面的杀菌参数绑定、CIP 互锁、灌装赋码都是顺着这条链路往下接,不会散。
