
上个迭代,同事把 system prompt 改短了两百字,本地试了三条 case,「看起来还行」,合并上线。第二天客服转来一批投诉:某一类高频问题开始答非所问。回看改动,那三条手测的 case 恰好都不属于这一类——问题一直躺在评测集里,只是没人在这版改动上线前把那几百条重新跑一遍。
这不是 prompt 写得不好,是流程缺了一道闸。几百条评测用例,手动跑一遍要小半天,逐条和上一版比分数变化更没人做得到。于是评测退化成「偶尔离线跑一次的体检」,而不是「每次改动都过一遍的门禁」。本篇讲的就是怎么把它接进 CI:让改 prompt、换模型、改检索逻辑的每一个 PR,都自动触发一遍评测,分数不达标就 fail。
评测只在上线前跑一次,等于没跑;它得像单元测试一样,每次改动都被逼着重跑一遍。
一、先给结论:把评测当门禁,而不是当报告
一句话立场:只要你的应用输出是大模型生成的,评测就不该是「发版前跑一份 PDF 存档」,而该是「PR 上一道红绿分明的检查」。
差别在于触发方式。报告是人想起来才跑,门禁是代码一改就跑;报告跑完靠人肉看数字拍板,门禁直接算出指标和相对基线的 delta,越线就熔断。前者拦不住「改短 prompt 顺手带崩一类问题」这种事故,因为改动的人根本不会想到去跑全量;后者把这件事从「靠自觉」变成「靠流水线」。
下面这张表,把两种做法摊开对照:
| 维度 | 人肉试几个 case 就上线 | evals-as-code 的 CI 门禁 |
|---|---|---|
| 覆盖用例数 | 手测 3—5 条,凭手感挑 | 冒烟子集几十条起步,nightly 全量几百条 |
| 可回归性 | 每次改动都要重挑 case,几乎不可复现 | 用例入库,同一次改动谁跑都跑同一批 |
| 上线前拦截能力 | 只拦得住手测碰到的那几条 | 拦得住整类高频问题的分数劣化 |
| 成本 | 单次便宜,但靠人肉、无法常态化 | 首次搭建有成本,之后每个 PR 自动跑 |
| 可追溯 | 「我记得当时是对的」 | 每次评测产物归档,分数 delta 可回查 |
结论很直接:手测的价值在探索新场景,不在于守存量;守存量这件事,必须交给能自动重跑的评测门禁。
二、evals-as-code:三样东西一起入库
门禁能成立的前提,是评测本身「像代码一样可版本化」。所谓 evals-as-code,就是把三样东西一起塞进版本库,和业务代码走同一套 PR 流程:
第一,评测集。几百条 case(输入 + 期望要点 + 打分方式)写进一个结构化文件,比如 cases.yaml,每条 case 有稳定 id、所属标签、以及用规则断言还是用 LLM 裁判打分。评测集改动本身也要走 PR review,谁能加 case、谁能删 case 有记录。
第二,执行器。一个 run_evals.py,读评测集、逐条调用被测应用拿到输出、按 case 声明的方式打分、汇总成通过率 / faithfulness 等指标,并把每条的得分写成一份机器可读的结果文件。
第三,通过阈值。门禁的红线(整体通过率不得低于多少、相对基线劣化不得超过多少)也写进库或写进 workflow,而不是留在某个人脑子里。阈值改动同样走 PR,等于「谁想放松门禁,都得留下署名」。
至于评测集的污染检查和基线冻结——那是门禁能可信的前置条件(评测集别混进被模型见过的数据、基线分数要固定在一个 tag 上),本篇不展开,只当默认已做好。
三、CI 门禁链路:从 PR 到红绿
接进 CI 之后,一次改动的评测链路是这样的:
有人提交改了 prompt / 换了底座模型 / 动了检索逻辑的 PR → 流水线检出评测集与执行器 → 跑冒烟子集(几十条,几分钟内出结果)→ 执行器算出这一版的整体通过率与关键指标 → 一个 delta 脚本把它和冻结基线的分数逐条比对,算出整体 delta 和劣化最狠的几条 → 门禁判定:指标高于阈值且劣化在容忍带内,标 PASS,允许合并;低于阈值或某几条相对基线大幅劣化,标 FAIL,熔断合并,并把结果作为 PR 评论贴出来、把完整评测产物归档为 artifact。
夜里再有一条旁路:nightly 定时任务跑全量几百条,出一份「今天相对基线的整体漂移」报告,捕捉冒烟子集覆盖不到的长尾劣化。
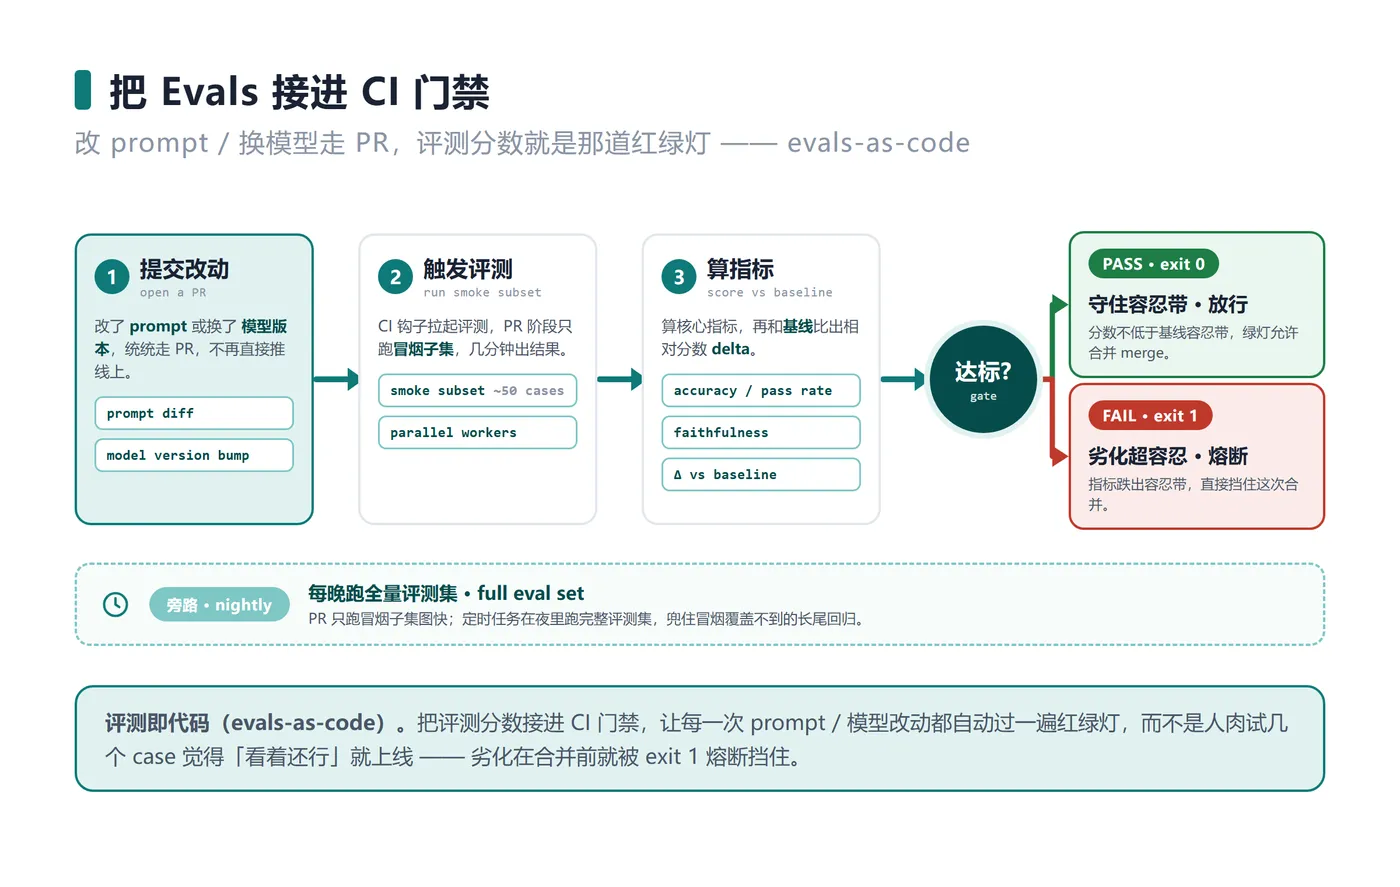
四、分层控成本:冒烟子集跑 PR,全量留给 nightly
最容易劝退团队的是成本:几百条 case、每条都要调一次被测模型、可能还要调一次裁判模型,全量跑一遍既慢又烧钱,塞进每个 PR 里没人受得了,于是大家又退回「只跑桌面几条」。
解法是分层,不要无脑全量:
| 层级 | 跑什么 | 触发时机 | 目标 |
|---|---|---|---|
| 冒烟子集 | 几十条核心高频 case | 每个 PR | 分钟级反馈,守住底线 |
| 全量评测 | 几百条完整评测集 | nightly 定时 | 捕捉长尾劣化与整体漂移 |
| 基线比对 | 当前分支 vs 冻结基线 | PR + nightly | 算 delta,防「相对上一版变差」 |
冒烟子集怎么挑:按线上问题分布和高频意图选代表性 case,保证每一类核心意图至少有覆盖,用 case 上的标签(如 smoke: true)圈出来。它不追求全,追求「几分钟内给出红绿信号」。全量则留在 nightly,慢一点没关系,第二天早上有一份完整漂移报告即可。这样 PR 上的反馈快、成本可控,长尾覆盖又没丢。
五、别让裁判模型自己漂移,污染了门禁
用 LLM-as-judge 打分时有个隐蔽陷阱:裁判模型本身会升级、会漂。今天判 PASS 的答案,裁判换了一版之后可能判 FAIL,于是门禁忽红忽绿,你却以为是被测应用变差了——其实是尺子变了。
两条防线。第一,固定裁判版本:把裁判模型和它的温度、prompt 一起钉死在一个具体版本上,写进配置,裁判要升级走单独 PR、并重新对一批金标准校准过再切。第二,规则裁判兜底:能用确定性规则判的(是否包含关键实体、是否是合法 JSON、是否命中禁用词、字数是否在区间),优先用规则断言,它不受模型漂移影响;只有确实需要语义判断的(回答是否忠于给定上下文、是否答到点上)才交给 LLM 裁判。规则裁判占比越高,门禁越稳。
六、一个能直接跑的脚手架
下面是最小但完整的一套。先是评测集 cases.yaml,混用规则断言与 LLM 裁判两种打分方式:
# evals/cases.yaml —— 评测集,改动需走 PR review
meta:
  version: "2026-09-16"
  judge_model: "judge-v1-frozen"   # 裁判版本钉死,升级另走 PR
cases:
  - id: c01
    tags: [smoke, faq]
    input: "你们的退款周期是多久?"
    scorer: rule
    expect:
      contains_any: ["7 个工作日", "七个工作日"]
      must_not_contain: ["不知道"]
  - id: c02
    tags: [smoke, faithfulness]
    input: "根据下面的说明,概括产品保修范围。"
    context: "本产品自签收之日起 12 个月内,非人为损坏免费保修。"
    scorer: llm_judge
    rubric: "回答是否只依据 context、无编造,且覆盖 12 个月与非人为损坏两点"
  - id: c03
    tags: [longtail]
    input: "海外订单也支持退换吗?"
    scorer: rule
    expect:
      contains_any: ["海外", "跨境"]
再是执行器 run_evals.py,只依赖标准库,规则打分自己算、语义打分留一个可替换的裁判接口,加 --demo 会用内置假输出直接跑通:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
evals/run_evals.py —— evals-as-code 执行器
读 cases.yaml,逐条对被测应用的输出打分,汇总指标并写出结果文件。
只依赖标准库(YAML 用极简解析或 json 兜底)。加 --demo 用内置样例输出跑通。

用法:
  python run_evals.py --cases evals/cases.yaml --subset smoke --demo
  python run_evals.py --cases evals/cases.yaml --out result.json
退出码:整体通过率低于 --min-pass 时返回 1(供 CI 熔断)。
"""
from __future__ import annotations
import argparse, json, sys

def rule_score(case, output) -> float:
    """确定性规则裁判:不受模型漂移影响,优先使用。"""
    exp = case.get("expect", {
   })
    text = output or ""
    if "must_not_contain" in exp:
        if any(w in text for w in exp["must_not_contain"]):
            return 0.0
    if "contains_any" in exp:
        return 1.0 if any(w in text for w in exp["contains_any"]) else 0.0
    return 1.0 if text.strip() else 0.0

def llm_judge_score(case, output, judge_model) -> float:
    """语义裁判:真实场景替换为你的裁判 API 调用,返回 0.0—1.0。
    demo 下用一个稳定的假实现,保证脚本可跑通。"""
    # 真实实现示例(伪代码):
    #   prompt = build_judge_prompt(case["rubric"], case.get("context"), output)
    #   return call_judge(judge_model, prompt)   # judge_model 已钉死版本
    return 1.0 if output and len(output) > 5 else 0.0

DEMO_OUTPUTS = {

    "c01": "退款一般在 7 个工作日内原路退回。",
    "c02": "自签收起 12 个月内非人为损坏可免费保修。",
    "c03": "海外跨境订单同样支持退换,详见政策页。",
}

def load_cases(path):
    # 生产建议用 PyYAML;demo 直接用内置数据保证零依赖可跑
    return [
        {
   "id": "c01", "tags": ["smoke", "faq"], "scorer": "rule",
         "expect": {
   "contains_any": ["7 个工作日"], "must_not_contain": ["不知道"]}},
        {
   "id": "c02", "tags": ["smoke", "faithfulness"], "scorer": "llm_judge",
         "rubric": "只依据 context、无编造"},
        {
   "id": "c03", "tags": ["longtail"], "scorer": "rule",
         "expect": {
   "contains_any": ["海外", "跨境"]}},
    ]

def run(cases, subset, judge_model, get_output):
    if subset:
        cases = [c for c in cases if subset in c.get("tags", [])]
    results, passed = [], 0
    for c in cases:
        out = get_output(c["id"])
        s = rule_score(c, out) if c["scorer"] == "rule" \
            else llm_judge_score(c, out, judge_model)
        results.append({
   "id": c["id"], "score": s})
        passed += 1 if s >= 1.0 else 0
    rate = passed / len(results) if results else 0.0
    return {
   "pass_rate": rate, "total": len(results), "results": results}

def main(argv):
    p = argparse.ArgumentParser(description="evals-as-code 执行器")
    p.add_argument("--cases", default="evals/cases.yaml")
    p.add_argument("--subset", help="只跑某个标签,如 smoke")
    p.add_argument("--judge-model", default="judge-v1-frozen")
    p.add_argument("--min-pass", type=float, default=0.9, help="门禁通过率阈值")
    p.add_argument("--out", default="result.json")
    p.add_argument("--demo", action="store_true")
    a = p.parse_args(argv)

    cases = load_cases(a.cases)
    get_output = (lambda cid: DEMO_OUTPUTS.get(cid, "")) if a.demo \
        else (lambda cid: call_app(cid))   # 真实场景:调用被测应用
    report = run(cases, a.subset, a.judge_model, get_output)

    with open(a.out, "w", encoding="utf-8") as f:
        json.dump(report, f, ensure_ascii=False, indent=2)
    print("通过率 = %.3f (%d/%d)" % (report["pass_rate"],
          sum(1 for r in report["results"] if r["score"] >= 1.0), report["total"]))
    if report["pass_rate"] < a.min_pass:
        print("[GATE FAIL] 通过率低于阈值 %.2f" % a.min_pass, file=sys.stderr)
        return 1
    print("[GATE PASS]")
    return 0

if __name__ == "__main__":
    sys.exit(main(sys.argv[1:]))
为什么这么写。第一,规则打分和语义打分在代码里彻底分开成两个函数,就是逼着团队「能规则化的先规则化」——rule_score 是确定性的,永远不漂,占比越高门禁越稳,llm_judge_score 只留给真正需要语义判断的 case。第二,judge_model 从配置读、且 demo 里默认是一个钉死版本的名字,这是在提醒:裁判版本必须固定,别让它跟着被测应用一起悄悄升级。第三,退出码是关键——pass_rate < min_pass 时返回 1,CI 靠这个非零退出码熔断,门禁才「有牙齿」,而不是只打一行日志没人看。踩过的坑是 demo 一定要能零依赖跑通,否则新人 clone 下来第一步就卡在装 PyYAML 上,脚手架就没人愿意用了。
再配一个和基线比 delta 的小脚本 compare_delta.py:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""比较当前结果与冻结基线,算整体 delta 与劣化最狠的 case。"""
import json, sys
cur = json.load(open(sys.argv[1], encoding="utf-8"))
base = json.load(open(sys.argv[2], encoding="utf-8"))
bmap = {
   r["id"]: r["score"] for r in base["results"]}
delta = cur["pass_rate"] - base["pass_rate"]
worse = sorted(((r["id"], r["score"] - bmap.get(r["id"], r["score"]))
                for r in cur["results"]), key=lambda x: x[1])[:5]
print("整体 delta = %+.3f" % delta)
print("劣化最狠的 case:", worse)
# 门禁:整体劣化超容忍带,或单条大幅劣化,则熔断
if delta < -0.03 or any(d < -0.5 for _, d in worse):
    sys.exit(1)
sys.exit(0)
最后是把它们串起来的 GitHub Actions 门禁片段:
# .github/workflows/eval-gate.yml
name: eval-gate
on: [pull_request]
jobs:
  smoke-evals:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with: {
    python-version: "3.11" }
      - name: Run smoke evals
        run: python evals/run_evals.py --cases evals/cases.yaml \
             --subset smoke --min-pass 0.9 --out result.json
      - name: Compare to frozen baseline
        run: python evals/compare_delta.py result.json evals/baseline.json
      - name: Archive eval artifacts
        if: always()
        uses: actions/upload-artifact@v4
        with: {
    name: eval-result, path: result.json }
为什么这么分三步。把「跑评测」「比基线」「归档产物」拆成独立 step,是为了让 PR 上一眼能看出到底是绝对分数没过、还是相对基线劣化了——这两种 fail 的排查方向完全不同。if: always() 保证即使熔断也归档结果,否则你一 fail 就没了现场,等于白跑。阈值 --min-pass 0.9 和容忍带 -0.03 都是本文示例,真实值要按你的业务代价来定:答错一条会赔钱的高风险场景,阈值就得往上调。
七、门禁上线后的三件小事
搭好只是开始。第一,把评测结果贴成 PR 评论,让改动的人当场看到「你这版相对基线哪几条劣化了」,反馈闭环越短,门禁越不被绕过。第二,允许「有署名的临时豁免」:紧急发版时可以手动放行,但必须留下谁放行、为什么,事后补跑,别让豁免变成常态。第三,定期复检基线:应用会迭代、评测集会长,基线冻太久会失真,按固定节奏(比如每个大版本)重冻一次,重冻时顺带做一遍污染检查。
评测接进 CI 之后,最爽的不是拦住了多少事故,而是团队终于敢改 prompt 了——因为每一次改动,都有几百条用例在背后替你兜底。
把评测当门禁而不是报告,你才敢在每次改动后按下合并键。
你们现在改 prompt / 换模型,上线前会重跑评测吗,还是靠手测几条就放行?



