现在用 AI 写代码已经不是什么新鲜事了。
Codex、Claude Code、Cursor、OpenCode,基本都可以帮我们:
写代码
改 Bug
重构
写测试
读项目
但我最近发现一个很有意思的问题:
AI 会写代码,不代表 AI 就会 Code Review。
你把一个 Git Diff 直接丢给 Claude、GPT,让它:
帮我 Review 一下这次代码修改。
它当然也能给出结果。
但是项目稍微复杂一点,很容易遇到几个问题:
1. 改了 30 个文件,只看了其中几个
2. 找到问题,但行号对不上
3. 缺少其他文件上下文,误判
4. 给出一堆“看起来正确”的废话
5. 一个 PR 吃掉大量 Token
最近阿里开源了一个专门解决这个问题的项目:
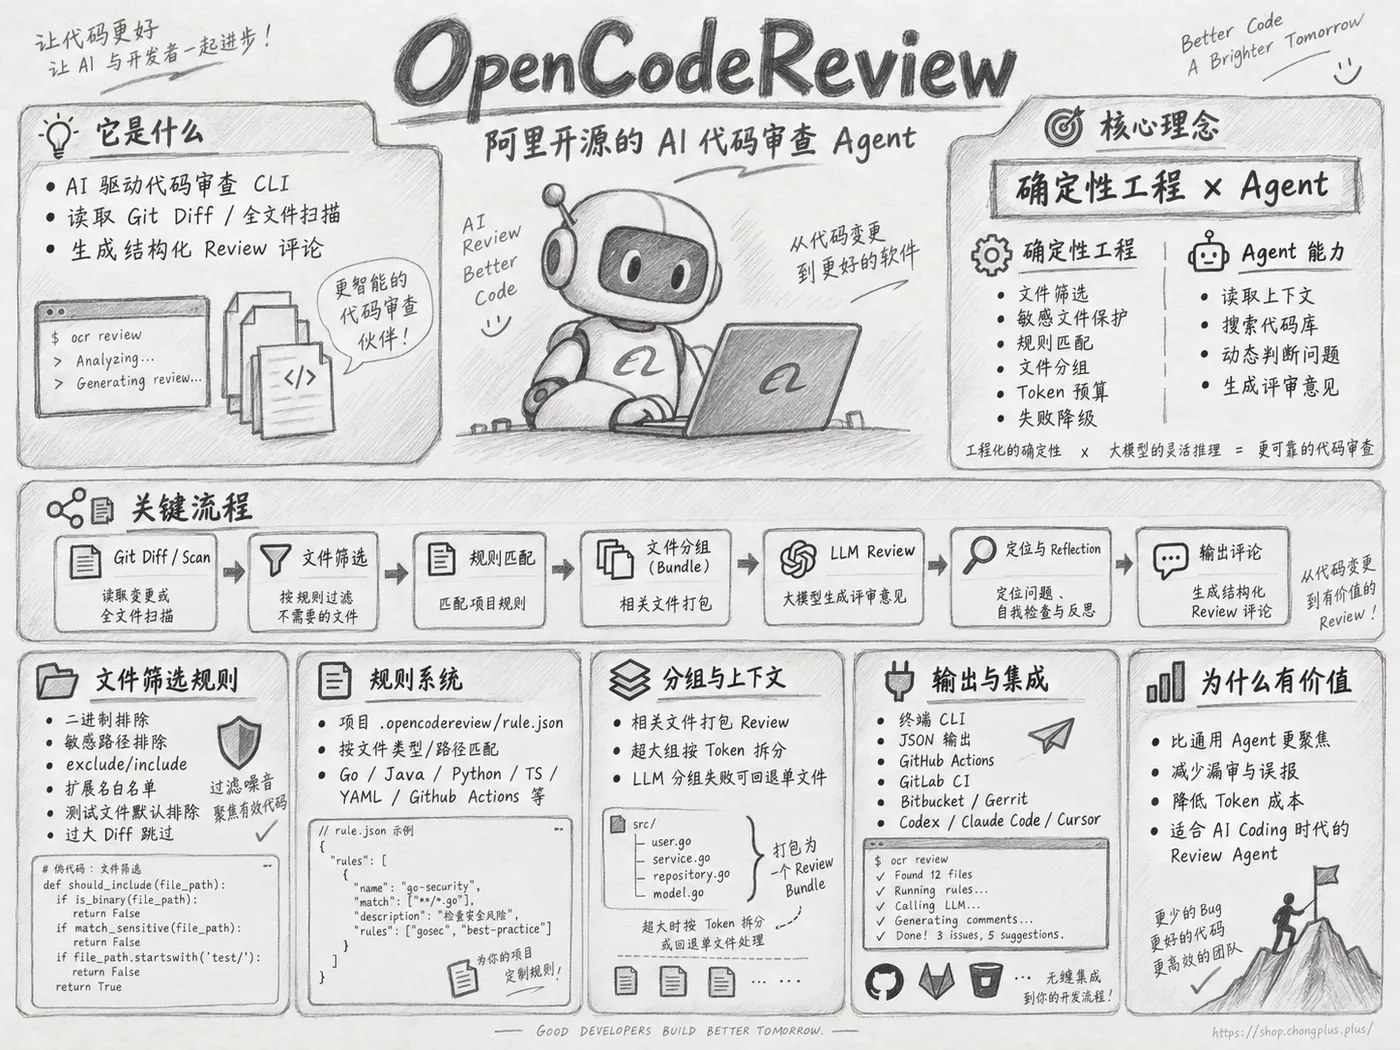
OpenCodeReview
GitHub:
https://github.com/alibaba/open-code-review
它不是一个普通 Prompt,也不是简单把:
git diff
直接塞进大模型。
而是一套专门围绕 AI Code Review 设计的 Agent 系统。
项目官方介绍显示,它的前身是阿里内部使用的 AI 代码审查助手,过去两年服务过数万名开发者,并识别了数百万代码缺陷,现在被独立开源。
今天我们就拆一下这个项目。
一、OpenCodeReview 到底是什么?
一句话理解:
OpenCodeReview 是一个专门负责 AI 代码审查的 CLI Agent。
安装之后你会得到一个命令:
ocr
比如你刚修改完代码:
git status
看到:
modified:   internal/user/service.go
modified:   internal/user/repository.go
modified:   api/user_handler.go
直接执行:
ocr review
它就会审查当前:
staged
unstaged
untracked
这些代码变化。
如果要审查两个分支之间的修改:
ocr review --from main --to feature-user
如果只想 Review 一个 Commit:
ocr review --commit 7ab32cd
甚至整个项目没有 Git Diff,也可以直接扫描:
ocr scan
扫描某个目录:
ocr scan --path internal/user
所以它本质上支持两种模式:
Git Diff Review
        +
Full File Scan
这一点对接手老项目尤其有用。项目官方 CLI 也提供 Workspace、分支区间、单 Commit、全文件 Scan 和断点恢复等方式。
二、先安装跑起来
OpenCodeReview 可以直接通过 npm 安装。
npm install -g @alibaba-group/open-code-review
安装完成:
ocr --version
然后进入自己的项目:
cd my-project
第一次需要配置模型:
ocr config provider
选择模型供应商。
然后:
ocr config model
选择具体模型。
接下来直接:
ocr review
就可以开始了。
它要求 Git >= 2.41。
三、也可以接 OpenAI Compatible API
这点我觉得对国内开发者比较友好。
它并没有把模型写死。
例如 CI 环境里可以通过:
export OCR_LLM_URL="https://example.com/v1/chat/completions"

export OCR_LLM_TOKEN="sk-xxxx"

export OCR_LLM_MODEL="your-model"
然后:
ocr review
项目本身提供了 OpenAI Compatible、Anthropic 等模型接入方式,CI 示例中也直接通过 OCR_LLM_URL、Token 和 Model 配置模型。
这意味着实际上可以形成:
OpenCodeReview
      ↓
OpenAI Compatible API
      ↓
GPT / Claude / 其他兼容模型
OpenCodeReview 负责:
Git Diff
文件过滤
规则匹配
上下文检索
Agent 调度
结果定位
模型负责:
理解代码
判断问题
分析逻辑
这个分工很重要。
四、为什么不直接让 Claude Code Review?
这其实是这个项目最值得分析的地方。
假设我们有 50 个修改文件。
最简单的 AI Review 架构是什么?
Git Diff
   ↓
Claude / GPT
   ↓
请 Review 代码
看起来非常合理。
但这里有一个问题:
你把整个流程的控制权全部交给了模型。
模型可能决定:
这个文件重要
那个文件不重要

这个看一下
那个跳过

这个需要读完整源码
那个只看 Diff
问题是:
LLM 本身并不是一个确定性的程序。
相同代码:
Prompt 稍微变化
上下文稍微变化
模型版本稍微变化
最终行为都可能不同。
OpenCodeReview 的解决方法非常有意思:
确定性工程 + Agent
也就是:
工程系统负责确定性
Agent 负责智能判断
官方 README 就把这个称为:
Deterministic Engineering × Agent
它把文件选择、文件打包、规则匹配、评论定位等容易“跑偏”的步骤尽量交给工程逻辑,把上下文召回和问题判断留给 Agent。
五、第一个关键:先确定哪些文件应该 Review
比如这次 Git Diff:
src/user.go
src/order.go
src/payment.go

node_modules/xxx.js

dist/app.js

.env

README.md

user_test.go
如果直接把所有东西发给模型:
非常浪费。
所以 OpenCodeReview 有一层专门的:
File Selection
项目里的 internal/agent/selection.go 会在真正调用 LLM 之前执行确定性的文件筛选。
逻辑大致可以理解为:
func shouldReview(file File) bool {


    if file.IsBinary {

        return false
    }

    if isSecretFile(file.Path) {

        return false
    }

    if userExcluded(file.Path) {

        return false
    }

    if userIncluded(file.Path) {

        return true
    }

    if !supportedExtension(file.Path) {

        return false
    }

    if defaultExcludedPath(file.Path) {

        return false
    }

    return true
}
真实实现中还会判断:
binary
secret path
user exclude
user include
extension
default path
token size
deleted file
而且 selectFiles 被设计成纯确定性逻辑,不依赖 Git、LLM 或额外副作用,这样 --preview 和真正执行 Review 时能够使用同一套选择结果。
这一点非常值得 Agent 开发者学习。
六、甚至 .env 这种文件默认都会特殊处理
假设你的 PR 里面不小心包含:
.env.production
里面可能有:
DATABASE_PASSWORD=123456

OPENAI_API_KEY=sk-xxx

JWT_SECRET=abcdef
你当然不希望它被直接发给第三方模型。
OpenCodeReview 在文件筛选阶段就专门增加了:
secret_exclude
并且:
敏感路径检查发生在用户 include 规则之前。
也就是说,即使用户配置了 include,也不能轻易把内置敏感路径重新放进去。
这个思路其实很重要:
安全规则不能完全依赖 Prompt。
应该在 Agent 外层增加确定性的保护。
七、可以先 Preview,不花 Token
一个非常实用的功能:
ocr review --preview
它不会立刻调用大模型。
而是先告诉你:
哪些文件会被 Review

哪些文件被排除

为什么被排除
例如可以想象成:
src/user.go
→ will_review

src/user_test.go
→ default_path

.env.production
→ secret_exclude

dist/app.js
→ excluded

image.png
→ binary
这样在真正消耗模型 Token 之前,你已经知道:
OCR 到底准备审哪些东西。
对于大型仓库非常有价值。
八、第二个关键:不是每个文件都单独 Review
假设你修改:
UserController.java
UserService.java
UserRepository.java
UserMapper.xml
如果完全独立 Review:
Controller → Agent 1

Service → Agent 2

Repository → Agent 3

Mapper → Agent 4
会出现什么问题?
比如:
public User getUser(Long id) {

    return userService.findById(id);
}
单看 Controller:
可能没问题。
但是 Service:
public User findById(Long id) {

    return userMapper.findById(id);
}
Mapper:
<select id="findById">
    SELECT *
    FROM user
    WHERE id = ${id}
</select>
真正的问题其实在:
${id}
应该考虑参数绑定和 SQL 注入问题。
如果四个文件完全隔离审查:
Agent 很可能缺失整个调用链上下文。
所以 OpenCodeReview 增加了一层:
File Grouping
九、相关文件会被打成一个 Bundle
项目中有:
type FileGroup struct {

    Label string
    Diffs []Diff
}
可以理解为:
一个业务相关的文件集合
例如:
用户模块

├── user_handler.go
├── user_service.go
├── user_repository.go
└── user_model.go
放进一个 Review Group。
另外:
订单模块

├── order_handler.go
├── order_service.go
└── order_repository.go
放到另外一个 Group。
然后:
Group 1 → Sub Agent

Group 2 → Sub Agent
这样既有上下文,又不会让单个 Agent 一口气吃完整个仓库。
十、这里还做了 Token 保护
假设一个 Group 有:
50 个文件
全部放进一个上下文依然可能爆掉。
所以源码中定义了:
const maxFilesPerGroup = 10
一个 Group 太大时会继续拆分。
同时还会计算:
Diff Token
如果整个 Group 超过 Token Limit:
继续拆成更小的 Review 单元。
源码中的核心思路类似:
for _, group := range groups {


    totalTokens := countTokens(group)

    if totalTokens <= limit {

        result = append(result, group)
        continue
    }

    for _, file := range group.Files {

        result = append(result, singleFileGroup(file))
    }
}
真实 grouping.go 中不仅限制每组最多 10 个文件,还会根据 Token Budget 将过大的组合降级成单文件 Group;如果 LLM 分组失败,同样会回退到 per-file 模式。
这是非常典型的:
AI 可以失败
但是系统不能失败
设计。
十一、第三个关键:不同文件使用不同 Code Review 规则
这也是我觉得 OpenCodeReview 很强的一点。
Java 文件和 SQL 文件的 Review 重点肯定不一样。
比如 Java:
public User get(Long id) {

    return repository.find(id);
}
关注点可能是:
空指针
并发
异常处理
事务
资源释放
但 MyBatis:
<select id="search">
    SELECT *
    FROM user
    WHERE name = '${name}'
</select>
更应该重点检查:
SQL Injection
参数绑定
SQL 性能
XML 标签
GitHub Actions:
permissions:
  contents: write

on:
  pull_request_target:
重点又应该变成:
Secret 泄露
Token 权限
第三方 Action
供应链攻击
pull_request_target 风险
如果所有文件都使用:
请检查这段代码有没有 Bug
实际上非常浪费模型能力。
十二、OpenCodeReview 有专门的 Rule 系统
项目级规则可以放:
.opencodereview/rule.json
例如:
{

  "rules": [
    {

      "path": "internal/api/**/*.go",
      "rule": "重点检查参数校验、权限验证、错误处理和敏感数据泄露。"
    },
    {

      "path": "**/*mapper*.xml",
      "rule": "重点检查 SQL 注入、参数绑定、全表扫描和缺失索引风险。"
    }
  ]
}
这意味着:
Go API
    ↓
API Review Rule

Mapper XML
    ↓
SQL Review Rule
规则系统本身有四层优先级:
--rule 参数
     ↓
项目 .opencodereview/rule.json
     ↓
用户 ~/.opencodereview/rule.json
     ↓
系统内置规则
第一条匹配的规则生效。
十三、比如给 Go 项目单独制定规则
假设我的项目:
cmd/
internal/
pkg/
我可以创建:
.opencodereview/rule.json
然后:
{

  "exclude": [
    "**/mock/**",
    "**/*.pb.go",
    "**/generated/**"
  ],
  "rules": [
    {

      "path": "internal/handler/**/*.go",
      "rule": "重点检查 HTTP 参数校验、鉴权、错误码以及用户输入是否可信。"
    },
    {

      "path": "internal/service/**/*.go",
      "rule": "重点检查业务逻辑、事务边界、并发安全以及错误处理。"
    },
    {

      "path": "internal/repository/**/*.go",
      "rule": "重点检查 SQL 注入、事务使用、N+1 查询和数据库错误处理。"
    }
  ]
}
现在整个项目 Review 就有明显的层次。
十四、再比如专门检查 Gin API
代码:
func DeleteUser(c *gin.Context) {


    id := c.Param("id")

    db.Exec(
        "DELETE FROM users WHERE id = " + id,
    )

    c.JSON(200, gin.H{

        "message": "success",
    })
}
我们可以配置:
{

  "rules": [
    {

      "path": "internal/api/**/*.go",
      "rule": "重点检查用户输入验证、SQL 注入、权限绕过、错误处理和 HTTP 状态码。"
    }
  ]
}
这个接口至少存在几个值得检查的地方:
1. id 来自用户输入
2. SQL 使用字符串拼接
3. 没有检查删除权限
4. 没检查数据库错误
5. 无论删除成功失败都返回 200
理想情况下 Agent 给出的重点应该是:
SQL Injection
Authorization
Error Handling
而不是:
建议添加注释,提高代码可读性。
这就是规则匹配的价值:
把有限的模型注意力放在真正重要的问题上。
十五、项目本身已经内置了大量语言规则
OpenCodeReview 并不是只支持 Java 或 Go。
内置规则包含:
Go
Java
Python
TypeScript
JavaScript
Kotlin
Rust
C
C++
PHP
Solidity
Vyper
Terraform
GraphQL
ProtoBuf
Prisma
YAML
JSON
GitHub Actions
Cargo.toml
pom.xml
package.json
...
甚至:
FreeMarker
Handlebars
Mustache
这种模板文件也有对应的专项检查规则。项目文档列出了按路径和文件类型匹配的大量系统规则,并最终回退到默认 Rule。
所以它更像:
Code Review Rule Engine
        +
Agent
而不仅仅是一个 CLI。
十六、如何判断一个文件最终使用哪条规则?
有一个很好用的命令:
ocr rules check src/user/service.go
它会告诉你:
File:
src/user/service.go

Source:
Project Rule

Pattern:
src/**/*.go
以及最终实际使用的 Rule。
例如:
ocr rules check internal/user/service.go
特别适合排查:
为什么我写的规则没有生效?
官方文档专门提供了 ocr rules check 来查看最终命中的 Rule 来源和 Pattern。
十七、甚至可以把测试文件重新加入 Review
默认情况下很多测试文件会被过滤。
例如:
*_test.go

*.test.ts

*.spec.ts

__tests__/

*_test.py
如果你偏偏希望 Review 测试:
可以:
{

  "include": [
    "**/*_test.go"
  ]
}
或者:
{

  "include": [
    "src/**/*.test.ts"
  ]
}
这里的 include 并不是传统意义上的完整白名单,而是可以绕过后续默认路径排除等规则;敏感文件保护仍然位于它前面。
十八、一个很值得学习的 Agent 设计:Tools 不是越多越好
很多人在设计 Agent 时有一个误区:
给它越多 Tool 越强。
例如:
read_file
write_file
grep
search
terminal
browser
git
database
http
python
shell
...
最后恨不得给 Agent 50 个工具。
但 OpenCodeReview 走的是另一个方向:
场景化工具集。
因为 Code Review Agent 真正需要的可能就是:
读取文件
搜索代码
查看相关 Diff
定位代码
生成评论
而不是:
操作浏览器
改服务器
创建 Docker
部署项目
减少工具之后:
Tool Selection 更稳定
Prompt 更短
Token 更少
调用链更可预测
官方也明确表示,它的工具集是针对代码审查场景优化出来的,而不是简单套用一个通用 Agent 工具箱。
十九、AI 找到 Bug 之后,还有一道“反思”过程
这是另一个很有意思的设计。
LLM 第一次说:
这里存在空指针问题。
系统并不一定马上把它作为最终评论输出。
而是可以继续:
Review Comment
      ↓
定位
      ↓
Re-Tracking
      ↓
Reflection
      ↓
Suggestion Validation
      ↓
最终 Comment
项目中甚至专门实现了:
CommentWorkerPool
用来异步处理:
line-range tracking
re-tracking
reflection
suggestion validation
而不是阻塞主 Agent Loop。
这个设计其实非常有启发性。
二十、为什么需要 Reflection?
例如模型第一次判断:
if user == nil {

    return nil
}
它可能说:
这里可能产生 nil pointer dereference。
但继续读取上下文发现:
if user == nil {

    return nil
}

return user.Name
实际上这里已经判断了。
第一次判断就是误报。
所以可以增加一个:
Critic / Reflection
再问一次:
这个问题真的存在吗?

是否已经被上下文中的代码处理?

是否能够从当前 Diff 中证明?

是不是仅仅属于编码风格建议?
只有通过这一关:
才真正输出。
这也是降低:
False Positive
非常重要的一种方式。
二十一、可以输出 JSON,接入自己的系统
如果你不想只在终端看结果:
ocr review \
  --format json \
  --output result.json
然后:
cat result.json
接下来就可以自己处理。
例如 Python:
import json

with open("result.json", "r") as f:
    result = json.load(f)

comments = result.get("comments", [])

for comment in comments:
    print("=" * 50)
    print("文件:", comment.get("path"))
    print("问题:", comment.get("body"))
进一步还可以:
OpenCodeReview
      ↓
result.json
      ↓
Python Script
      ↓
企业微信 / 飞书 / Slack
于是它就不只是一个 CLI。
而可以作为:
公司内部 Code Review 基础设施。
官方也把 JSON 输出作为 AI Host Agent 等自动化场景的推荐方式之一。
二十二、还能接进 GitHub Actions
这个可能是团队场景最实用的地方。
例如:
开发者创建 PR
      ↓
GitHub Actions
      ↓
OpenCodeReview
      ↓
LLM
      ↓
自动生成 Review
      ↓
评论 PR
仓库本身已经提供了完整的:
examples/github_actions
示例。
可以基于官方 Action 做一个简化版本:
name: AI Code Review

on:
  pull_request_target:
    types:
      - opened
      - synchronize
      - reopened

permissions:
  contents: read
  pull-requests: write

jobs:
  review:
    runs-on: ubuntu-latest

    steps:
      - name: Run OpenCodeReview
        uses: alibaba/open-code-review@main

        with:
          llm_url: ${
   {
    secrets.OCR_LLM_URL }}
          llm_auth_token: ${
   {
    secrets.OCR_LLM_AUTH_TOKEN }}
          llm_model: ${
   {
    vars.OCR_LLM_MODEL }}
实际官方示例做得比这个完整得多,还处理了:
PR 更新
评论触发重新 Review
并发控制
Bot 评论过滤
成员权限
base/head ref
官方工作流使用 pull_request_target,但明确限制为读取 Diff、不执行 PR 中的代码,同时设置了 contents: read 和 pull-requests: write 权限。
二十三、甚至可以在 PR 评论区手动触发
官方 Workflow 还支持类似:
/open-code-review
或者:
@open-code-review
重新触发。
这意味着整个协作流程可以变成:
程序员
  ↓
提交 PR
  ↓
AI Review
  ↓
修改代码
  ↓
/open-code-review
  ↓
重新 Review
越来越像真正的:
AI Reviewer。
二十四、还可以和 Codex、Claude Code 配合
这也是 OpenCodeReview 一个很有意思的定位。
它并不一定要和 AI Coding Agent 竞争。
反而可以和:
Codex
Claude Code
Cursor
OpenCode
组合。
项目官方已经提供这些 Coding Agent 的集成,其中 Codex 可以通过 Plugin / Skill 调用 Review,Claude Code 和 Cursor 也有对应方式。
整个工作流就可以变成:
Codex
  ↓
写代码
  ↓
OpenCodeReview
  ↓
发现问题
  ↓
Codex
  ↓
修改
  ↓
OpenCodeReview
这里最有意思的地方在于:
Coding Agent
负责创造。
Review Agent
负责挑错。
这实际上比:
让同一个 Agent 写完以后问自己有没有问题。
更符合工程团队的角色分工。
二十五、Delegation Mode 也值得注意
OpenCodeReview 还有:
ocr delegate preview
和:
ocr delegate rule src/main.go
这种模式。
意思是:
OpenCodeReview 不一定自己调用 LLM。
它负责:
文件筛选
规则解析
Review 上下文准备
然后真正执行 Review 的模型可以来自:
Codex
Claude Code
其他 Coding Agent
这样:
OCR
负责工程流程

Host Agent
负责模型推理
甚至不需要单独给 OCR 配 API Key。项目把这种模式称为 Delegation Mode。
二十六、这个设计其实非常值得做 Agent 的人研究
如果只是把 OpenCodeReview 当成:
AI 检查代码工具
其实有点可惜。
我觉得这个项目最值得学习的是它背后的 Agent 工程思想。
很多 Agent 项目现在都是:
Prompt
+
Tools
+
while loop
例如:
while True:

    response = llm(messages, tools)

    if response.tool_call:
        result = run_tool()
        messages.append(result)
        continue

    break
Demo 没问题。
但到了生产环境:
问题就出现了。
如何保证覆盖?

如何保证预算?

如何保证文件不遗漏?

如何保证敏感信息不发出去?

如何保证结果位置正确?

如何处理大上下文?

如何降低幻觉?

如何失败降级?
这些问题靠 Prompt 很难彻底解决。
OpenCodeReview 给出的答案是:
能够工程化解决的问题
不要让 LLM 决定。
例如:
文件筛选 → 代码

敏感文件过滤 → 代码

Token Limit → 代码

文件分组限制 → 代码

规则优先级 → 代码

失败降级 → 代码
真正需要理解代码的地方:
LLM
来解决。
我觉得这是这个项目最值得关注的一点。
二十七、官方 Benchmark 也比较有意思
项目提供了一个:
AACR-Bench
数据集。
官方介绍中:
50 个热门开源仓库

200 个真实 Pull Request

10 种编程语言

80+ 位资深工程师参与标注

1505 个 Ground Truth 问题
并用:
Precision

Recall

F1

Avg Time

Avg Token
这些指标做评测。
根据项目公布的 benchmark,在使用相同底层模型比较时,OpenCodeReview 主打更高的 Precision 和 F1,同时 Token 消耗约为通用 Claude Code Agent 方案的 1/9;官方同时明确说明,它的 Recall 更低,这是为了减少噪声所做的取舍。
这个说明反而让我觉得比较合理。
因为 Code Review 并不是:
问题越多越好。
如果 AI 每次 PR 给你输出:
73 个问题
其中:
60 个是误报
那程序员很快就不会看了。
真正有价值的是:
少一点
但尽量是真的。
二十八、一个实际可用的项目配置
如果我是一个 Go 后端项目,我可能会这样开始。
目录:
project
├── cmd
├── internal
│   ├── api
│   ├── service
│   ├── repository
│   └── model
├── pkg
└── .opencodereview
    └── rule.json
rule.json:
{

  "exclude": [
    "**/generated/**",
    "**/*.pb.go",
    "**/mock/**"
  ],

  "rules": [
    {

      "path": "internal/api/**/*.go",
      "rule": "重点检查认证、鉴权、参数校验、敏感信息泄露以及 HTTP 错误处理。"
    },

    {

      "path": "internal/service/**/*.go",
      "rule": "重点检查业务逻辑错误、事务边界、并发问题、context 传递和错误处理。"
    },

    {

      "path": "internal/repository/**/*.go",
      "rule": "重点检查 SQL 注入、数据库错误处理、事务使用、慢查询和 N+1 查询。"
    },

    {

      "path": "**/*.{yaml,yml}",
      "rule": "重点检查 Secret 泄露、错误权限、危险默认值以及 CI/CD 安全风险。"
    }
  ]
}
然后每天开发完:
ocr review
提交之前:
ocr review --from main
PR:
GitHub Actions
    ↓
OpenCodeReview
实际上就已经形成了一套比较完整的 AI Code Review 流程。
二十九、我认为最适合它的几个场景
第一种:
个人开发者。
写完代码以后:
ocr review
相当于提交代码之前多一个 Reviewer。
第二种:
AI Coding。
比如:
Codex 连续写了 20 个文件
人根本来不及逐行检查。
可以:
ocr review
再做一次专项 Review。
第三种:
接手老项目。
直接:
ocr scan --path internal/payment
扫描支付模块。
第四种:
团队 Pull Request。
直接接:
GitHub Actions
GitLab CI
Bitbucket Pipelines
Gerrit
项目仓库本身也提供了多个 CI/CD 平台的示例,而不只是 GitHub Actions。
三十、AI Coding 之后,下一个问题就是 AI Code Review
过去一两年大家都在讨论:
AI 能不能写代码?
现在这个问题其实已经没有那么重要了。
真正开始出现的问题是:
AI 一天能写过去一个程序员一周才能写完的代码。

那谁来 Review?
如果代码产出速度提升:
5 倍
10 倍
20 倍
人工 Review 很容易成为新的瓶颈。
所以未来的软件开发流程可能越来越像:
人
 ↓
Coding Agent
 ↓
代码
 ↓
Review Agent
 ↓
问题
 ↓
Coding Agent 修复
 ↓
CI
 ↓
人工最终确认
OpenCodeReview 做的,本质上就是中间的:
Review Agent
这一层。
而我觉得它真正值得学习的地方,并不是用了哪个大模型。
而是:
它开始把 Agent 当成一个真正的软件工程系统来设计。
不是所有事情都交给 LLM。
确定性的事情交给程序。
需要理解和推理的事情交给模型。
模型失败了,有降级方案。
上下文太大,拆分。
文件太多,分组。
规则不同,匹配。
发现问题,再反思。
最后才产生真正的 Code Review Comment。
这可能才是 AI Agent 从:
Demo
真正走向:
Production
最重要的一步。
项目地址:
https://github.com/alibaba/open-code-review
如果你平时大量使用 Codex、Claude Code 或 Cursor 写代码,这个项目我觉得非常值得拉下来亲自跑一次。