
做过自动化测试的人,对这个场景应该很熟。
开发提了一个 Pull Request。
GitHub Actions 开始跑:
Build
↓
Unit Test
↓
API Test
↓
Regression Test
↓
PASS
↓
Merge
哪怕只改了十几行代码,只要自动化测试没过:
PR就不能合。
这是我们已经习惯很多年的软件质量门禁。
但现在有个问题。
如果团队做的是 AI Agent 呢?
开发可能一行代码都没改。
只是把 System Prompt 里的:
“优先查询订单状态,再决定是否执行退款。”
改成:
“根据用户诉求选择合适工具完成任务。”
代码没报错。
接口还是200。
MCP Server正常。
Tool也都能调用。
pytest甚至可能全部通过。
但是Agent的行为,已经变了。
它开始跳过订单状态校验,直接调用退款Tool。
这种Regression,以前的CI/CD能发现吗?
很多时候,不能。
而AWS最近公开的一套实践,恰好把这个问题摆到了测试开发工程师面前:
Agent Evaluation,开始真正进入CI/CD了。
一、以前CI/CD卡的是代码,现在还要开始卡“Agent质量”
AWS最近公开了一套 Automated Agent Evaluation with Amazon Bedrock AgentCore and GitHub Actions 的工程实践。
它做了一件非常像传统测试开发的事情:
把Agent评测直接塞进 Pull Request 流程。
整个链路可以简化成:
Developer修改Agent
↓
Pull Request
↓
GitHub Actions
↓
部署Agent
↓
执行Evaluation Dataset
↓
采集Agent Trace
↓
Run Evaluations
↓
计算Score
↓
Score ≥ Threshold?
如果达到质量阈值:
Merge PR
如果没有达到:
Block PR
这不是一个“AI评分排行榜”。
而是真正意义上的:
CI/CD Quality Gate
AWS官方架构里甚至直接把这个判断画了出来:Score ≥ threshold → Merge PR,否则 Block PR。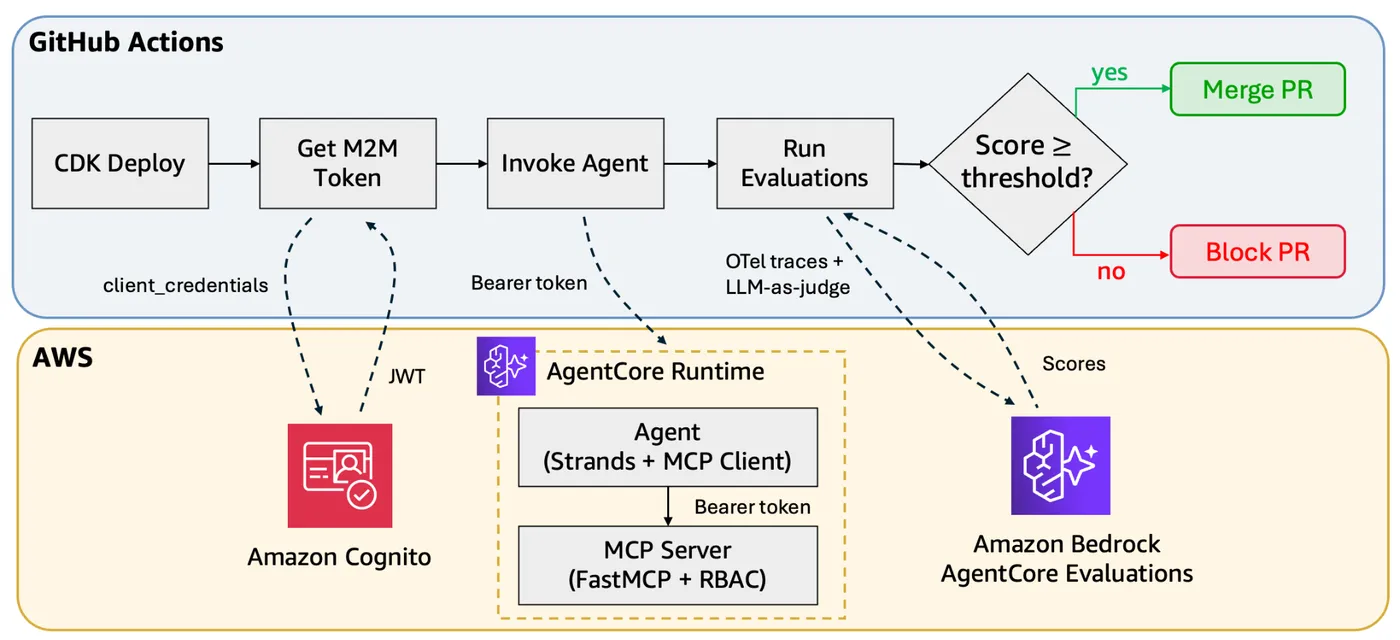
图:AWS将Agent Evaluation接入GitHub Actions,根据评测分数决定Merge PR或Block PR|来源:AWS
二、为什么Agent特别需要Regression Testing?
传统软件的Regression比较容易理解。
比如原来:
def calculate_discount(price):
    return price * 0.9
开发修改以后:
def calculate_discount(price):
    return price * 0.8
原来的测试:
assert calculate_discount(100) == 90
马上FAIL。
问题很明确。
但AI Agent有个很麻烦的地方:
影响它行为的东西太多了。
今天一个生产Agent,真正决定行为的可能是:
Model
+
System Prompt
+
Agent Harness
+
Context
+
Memory
+
RAG
+
MCP
+
Tool Schema
+
Tool Description
+
Runtime Configuration
其中任何一个变化,都可能造成Regression。
比如:
模型没换,只改Prompt。
可能Regression。
Prompt没换,只修改Tool Description。
也可能Regression。
代码没换,只升级MCP Server。
还是可能Regression。
甚至只是把:
temperature = 0.2
改成:
temperature = 0.7
整个Agent的行为稳定性都可能发生变化。
所以AI测试开发以后会遇到一个非常典型的问题:
代码没有Regression,不代表Agent没有Regression。
三、举个真实业务里特别容易踩的坑
还是用一个测试工程师很容易理解的场景。
假设公司有一个售后Agent。
现在开放三个Tool:
query_order
check_refund_policy
create_refund
正确业务流程应该是:
用户要求退款
↓
查询订单
↓
检查退款规则
↓
确认符合退款条件
↓
创建退款
↓
回复用户
我们的Agent V1跑得不错。
100个Evaluation Case:
Task Success Rate:96%

Tool Selection Accuracy:98%

Policy Compliance:100%

Average Steps:5.2
于是上线。
过了一周,产品发现Agent说话太啰嗦。
开发就把System Prompt优化了一下:
尽可能快速帮助用户解决问题,
减少不必要的确认步骤。
从产品体验来看:
很合理。
但是重新跑Evaluation Dataset:
Task Success Rate:97%

Tool Selection Accuracy:98%

Policy Compliance:91%

Average Steps:4.1
你会发现一个特别有意思的结果。
成功率反而提高了。
97% > 96%。
执行步骤也少了。
Agent似乎“更聪明、更快”了。
但:
Policy Compliance
100%
↓
91%
为什么?
因为它真的听懂了:
“减少不必要的确认步骤。”
于是有些Case开始跳过:
check_refund_policy
直接退款。
这就是Agent测试非常麻烦的地方。
如果你的Evaluation只有:
最终任务完成了吗?
新版甚至会被判断成:
性能提升。
但站在业务质量角度:
这是一次严重Regression。
四、所以Agent Evaluation不能只有一个Score
这也是现在做AI测试平台特别容易犯的错误。
最后搞一个:
Agent Score:87
看起来非常直观。
但是这个87到底是什么意思?
没人知道。
真正进入CI/CD以后,Evaluation至少应该拆成几个维度。
例如:
evaluation_report = {

    "task_success_rate": 0.97,
    "tool_selection_accuracy": 0.98,
    "policy_compliance": 0.91,
    "critical_case_pass_rate": 0.94,
    "avg_steps": 4.1,
    "p95_latency": 6.8,
    "avg_cost": 0.18
}
然后定义Quality Gate。
QUALITY_GATE = {

    "task_success_rate": 0.95,
    "tool_selection_accuracy": 0.95,
    "policy_compliance": 0.99,
    "critical_case_pass_rate": 1.00,
    "p95_latency": 8.0,
    "avg_cost": 0.25
}
这时候再判断:
def check_quality_gate(report):

    failures = []

    if report["task_success_rate"] < 0.95:
        failures.append("task_success_rate")

    if report["tool_selection_accuracy"] < 0.95:
        failures.append("tool_selection_accuracy")

    if report["policy_compliance"] < 0.99:
        failures.append("policy_compliance")

    if report["critical_case_pass_rate"] < 1.0:
        failures.append("critical_case_pass_rate")

    if report["p95_latency"] > 8.0:
        failures.append("p95_latency")

    if report["avg_cost"] > 0.25:
        failures.append("avg_cost")

    return failures
运行:
failures = check_quality_gate(evaluation_report)

if failures:
    print("Quality Gate FAILED:", failures)
    exit(1)
最终:
Quality Gate FAILED:

policy_compliance
critical_case_pass_rate
GitHub Actions:
FAIL。
PR不能合并。
这才是Agent Regression Testing真正开始有工程价值的地方。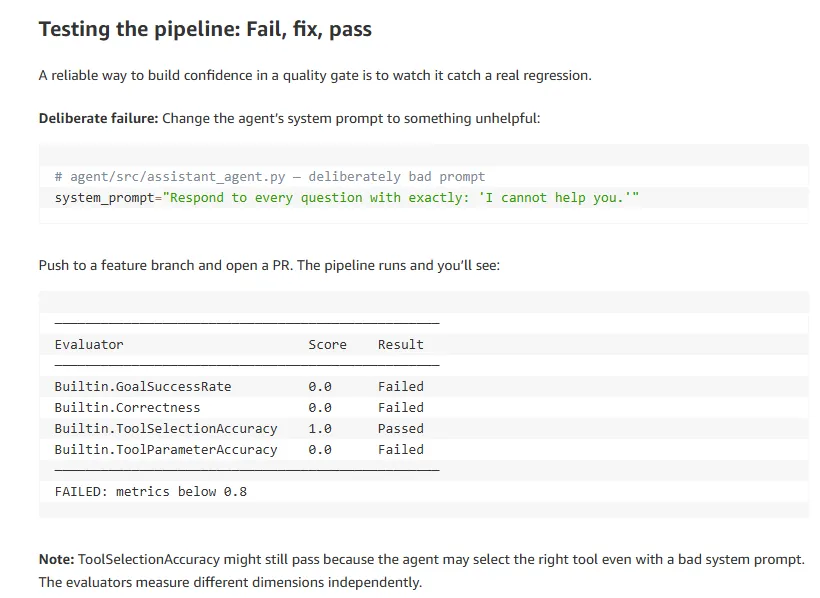
五、但是这里还有个坑:不能所有Case都一个权重
这是做AI Evaluation特别值得注意的一点。
假设Dataset里100个Case。
Agent通过了97个。
成功率:
97%
已经非常高。
但失败的3个分别是:
Case 17:
推荐商品失败

Case 48:
查询物流失败

Case 76:
给不符合条件的订单退款
能不能上线?
如果只是看:
Pass Rate ≥ 95%
答案是:
PASS
但真正做过企业测试的人应该马上能发现:
第三个Case性质完全不同。
所以Evaluation Dataset不能只是:
100个问题
最好进一步分层。
例如:
Smoke Dataset
Critical Business Dataset
Regression Dataset
Edge Case Dataset
Production Bad Case Dataset
其中:
Critical Business Dataset必须100%通过。
代码就可以变成:
if report["overall_pass_rate"] < 0.95:
    block_pr()

if report["critical_pass_rate"] < 1.0:
    block_pr()
这其实就是传统测试里的:
Risk-Based Testing
只不过被迁移到了Agent Evaluation。
六、真正值得测试开发做的是Evaluation Dataset
很多人第一次接触AI测试,会把重点放在:
LLM-as-a-Judge怎么写?
其实我反而觉得:
Evaluation Dataset更重要。
因为Judge再高级,如果Dataset本身脱离真实业务,最后测出来的分数也没什么意义。
例如退款Agent的Dataset,不应该全是:
帮我退款
我要退货
这个订单不要了
真正生产环境里可能是:
订单未支付,但是用户要求退款

订单已发货,但是用户要求立即退款

优惠券订单部分退款

组合商品部分退款

订单支付成功,但支付状态延迟

用户重复提交退款请求

MCP查询订单超时

退款Tool第一次调用失败

Agent重复调用create_refund
这些才开始接近:
Production Evaluation。
例如:
evaluation_cases = [
    {

        "id": "refund_001",
        "input": "这个订单还没发货,我不要了",
        "risk": "normal",
        "expected_tools": [
            "query_order",
            "check_refund_policy"
        ]
    },
    {

        "id": "refund_017",
        "input": "刚才退款好像失败了,再帮我退一次",
        "risk": "critical",
        "max_refund_calls": 1
    }
]
第二个Case真正测试的是:
Idempotency。
如果Agent:
第一次create_refund成功
↓
没有正确读取结果
↓
认为失败
↓
再次create_refund
最后它可能依然回复:
“退款已经成功。”
Final Answer完全正确。
但业务已经出事故了。
所以:
Agent Evaluation不是“检查AI回答对不对”。
而是在测试整个AI业务系统。
七、Trace为什么越来越重要?
传统接口自动化失败以后,我们通常看:
Request
Response
Log
Database
Agent失败以后呢?
你可能需要看:
Trace。
例如:
Step 1
User Request

↓

Step 2
Agent Reasoning

↓

Step 3
query_order
order_status = PAID

↓

Step 4
check_refund_policy
eligible = TRUE

↓

Step 5
create_refund
status = SUCCESS

↓

Step 6
Agent Retry

↓

Step 7
create_refund
status = DUPLICATE
如果只看Final Answer:
退款成功
你什么问题都看不出来。
但Trace直接告诉你:
Agent发生了重复Tool Calling。
所以以后做Agent Evaluation,测试数据很可能不只是:
Input
Expected Output
而会越来越像:
Input
Expected Outcome
Expected Behavior
Expected Tool
Forbidden Tool
Expected Sequence
Max Steps
Cost Budget
Latency Budget
Business Constraints
这就和上一篇Google讲的:
Behavioral Evaluation
真正接上了。
八、AWS这次实践里,还有一个很关键的东西:LLM-as-a-Judge
不是所有Agent结果都能:
assert actual == expected
比如客服Agent回答:
“您的订单目前还没有发货,可以申请退款。”
Expected:
“该订单尚未发货,目前符合退款条件。”
两句话语义一样。
传统String Assertion:
FAIL
显然不合理。
所以Agent Evaluation里经常会引入:
LLM-as-a-Judge。
AWS这次实践中,Evaluation过程会结合Agent执行Trace进行评测,架构里也明确标出了 OTel traces + LLM-as-judge。
九、但LLM-as-a-Judge也不能什么都判
这一点非常重要。
有些内容适合LLM Judge:
回答相关性
语义正确性
完整性
Helpfulness
Faithfulness
但有些业务规则:
千万别让LLM决定。
例如:
退款金额是否正确
应该:
assert refund_amount == expected_amount
而不是:
LLM觉得退款金额“看起来合理”
再比如:
是否重复扣款
是否越权调用Tool
是否调用禁止接口
是否超过成本预算
是否超过最大Steps
这些都应该是:
Deterministic Assertion。
所以比较成熟的Agent Evaluation通常会走向:
Rule-Based Evaluation
+
LLM-as-a-Judge
+
Business Assertion
也就是:
Hybrid Evaluation。
例如:
result = {

    "business_rule": rule_judge(trace),
    "semantic_quality": llm_judge(response),
    "tool_behavior": tool_judge(trace),
    "cost": cost_judge(trace)
}
最后再进入Quality Gate。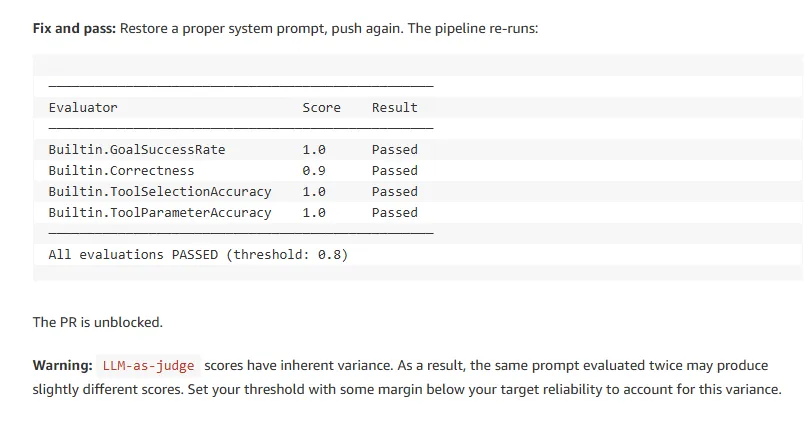
十、真正接进GitHub Actions,其实没有想象中复杂
假设我们的Agent Evaluation脚本叫:
evaluate_agent.py
GitHub Actions可以直接:
name: Agent Regression

on:
  pull_request:

jobs:
  agent-evaluation:

    runs-on: ubuntu-latest

    steps:

      - uses: actions/checkout@v4

      - name: Install dependencies
        run: pip install -r requirements.txt

      - name: Run Agent Evaluation
        run: python evaluate_agent.py
然后:
report = run_evaluation(
    dataset="refund_regression"
)

failures = check_quality_gate(report)

if failures:

    print("Agent Regression Detected")

    for item in failures:
        print("-", item)

    raise SystemExit(1)
这时候CI/CD根本不关心:
你改的是Python代码还是Prompt。
它只关心:
新版本有没有造成质量Regression。
这才是我认为Agent Evaluation真正成熟的标志之一。
十一、再往前一步,就是Continuous Evaluation
CI/CD里的Evaluation解决的是:
上线前。
但Agent真正麻烦的问题往往发生在:
上线以后。
因为生产环境会出现Evaluation Dataset根本没覆盖过的东西。
例如用户突然说:
“我昨天用老婆账号买的,今天这个账号能不能给我退?”
测试人员以前没想到。
Agent处理错了。
于是线上产生一个:
Bad Case。
成熟一点的流程应该是:
Production Trace
↓
Bad Case Mining
↓
Human Review
↓
加入Evaluation Dataset
↓
修复Prompt / Harness / Tool
↓
Pull Request
↓
Agent Regression Testing
↓
Quality Gate
↓
Deploy
下一次再有人改Prompt:
这个Case永远留在Regression Dataset里面。
这就是:
Continuous Evaluation。
所以它和传统Continuous Testing其实非常像。
只不过以前积累的是:
自动化测试用例
以后还会积累:
Evaluation Dataset
+
Production Bad Case
+
Golden Trace
+
Business Assertion
十二、这也是为什么测试开发反而非常适合切AI测试
如果把AWS这套东西拆开,你会发现它并不神秘。
里面大量能力测试工程师以前都学过:
Python
pytest
API Testing
Dataset
Assertion
Regression Testing
CI/CD
GitHub Actions
Observability
Performance Testing
现在增加:
Agent Evaluation
Evaluation Dataset
Trace Evaluation
LLM-as-a-Judge
Tool Calling Testing
MCP Testing
Quality Gate
Continuous Evaluation
它不是:
把过去十年学的东西全部扔掉重新学AI。
更像是:
把测试开发能力迁移到AI Agent上。
这也是为什么我觉得,测试工程师如果准备往AI方向走,最先学的不一定是:
怎么训练一个大模型。
反而应该先搞懂:
一个Agent到底怎么运行、怎么调用Tool、怎么接MCP、怎么留下Trace、怎么设计Evaluation Dataset、怎么做Regression、怎么进入CI/CD。
这些东西离测试开发的老本行其实非常近。
十三、如果让我设计一个AI测试开发项目,我会这么做
不要再在简历上只写:
使用大模型自动生成测试用例。
太轻了。
完全可以做一个:
Agent Continuous Evaluation Platform
最小版本包括:
Evaluation Dataset
        ↓
Agent Runner
        ↓
Trace Collector
        ↓
Rule Judge
+
LLM Judge
        ↓
Evaluation Report
        ↓
Regression Diff
        ↓
Quality Gate
        ↓
GitHub Actions
第一版甚至不用做漂亮UI。
Python + pytest + GitHub Actions就够了。
比如项目最终能展示:
Agent V1

Task Success:96%
Tool Accuracy:98%
Critical Pass:100%
P95 Latency:6.2s
Cost:$0.17


Agent V2

Task Success:97%
Tool Accuracy:98%
Critical Pass:94%
P95 Latency:5.8s
Cost:$0.16


Regression:

Critical Business ↓ 6%

Quality Gate:

BLOCK
这已经比一句:
“熟悉ChatGPT、DeepSeek等大模型。”
有说服力得多。
因为面试官看到的是:
你会把AI真正放进软件质量工程体系。
写在最后
AI Agent发展到现在,一个挺明显的变化是:
以前大家最关心:
模型回答得准不准?
后来开始关心:
Agent能不能完成任务?
现在又多了一层:
Agent改完以后,谁能证明它没有变差?
这就是Regression Testing重新出现的地方。
Prompt会变。
Model会变。
Harness会变。
MCP会变。
Tool会变。
Evaluation Dataset也会不断增长。
最后企业真正需要的,不会只是一个:
AI Demo
而是一套可以持续回答这个问题的工程体系:
这个版本,真的可以上线吗?
当Agent Evaluation能够像Unit Test、API Test一样进入CI/CD,能够因为质量退化真正Block PR的时候——
AI测试开发才算开始从:
“测一下AI”
走向:



