
一、真实场景下的安全隐患
在大模型应用落地过程中,很多开发者和企业都遇到过类似的典型隐患:用户在查询或整理资料时,模型返回的内容具体到了让人警惕的程度。
溯其根源,往往是在此之前已有用户把内部未脱敏的数据原封不动地直接传给了模型服务。没有做任何前置过滤,客户名单、联系方式、内部架构等信息随着 Prompt 一起提交到了云端。
这些内容进入了服务端的请求日志,甚至可能成为后续迭代的语料。当其他请求命中相关上下文时,模型便“回忆”并输出了这些敏感信息。
这并不是模型出了故障,而是缺少了出网前的数据脱敏与隐私治理机制。
核心问题:未经治理的数据一旦进入模型请求,数据资产的边界便彻底失控。
二、传统脱敏与大模型交互的“两难困境”
在日常业务与日常办公中,敏感数据出网几乎是高频发生的:
整理业务名单:直接粘贴包含姓名、手机号、企业名称的表格;
调试接口与排查 Bug:随手把带有 API Key、Token 的配置或日志贴进对话框;
撰写报告与合同:直接输入项目代号、内部工号、银行账号或身份证号。
数据一旦明文出网,便存在不可逆的泄露风险:既无法撤回已经发送的请求,也无法确保第三方模型服务不会沉淀这批数据。
但如果简单粗暴地采用传统脱敏方案,往往会陷入两难:
不脱敏:敏感数据裸奔出网,安全合规无法通过;
单向打码(如掩码替换):将手机号打码为 138**0000,将姓名替换为 张*。此时模型失去了核心业务参数——如果指令是“帮我给张三发送包含该号码的确认通知”,数据被打码后,Agent 或工具调用链路便无法正确组装下游参数。
要安全还是要可用性? 解决这个问题的关键,在于构建一套“出网脱敏、回流还原”的双向可逆本地隐私网关。
三、架构思路:让数据“可逆脱敏后出网”
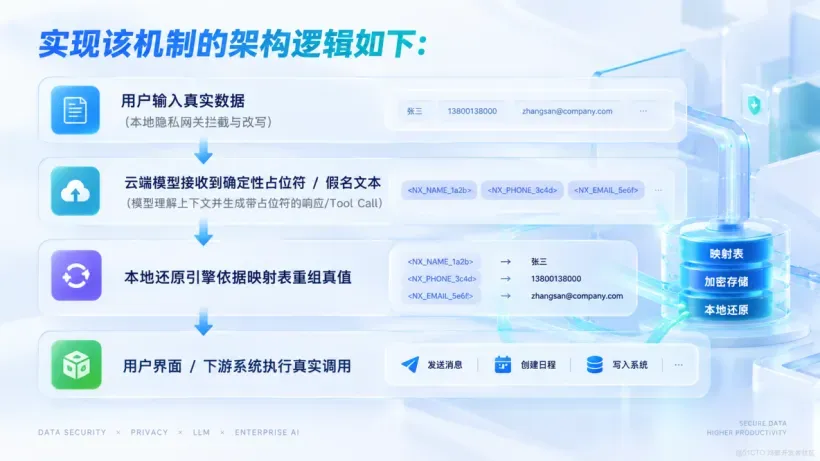
解决思路的核心,并不是完全禁止调用云端模型,而是确保离开本地运行环境的报文不包含任何真实敏感实体。
运行示例
用户输入:
把 13800138000 发给张三
经过本地隐私层拦截改写后,发往云端的实际报文为:
把 发给
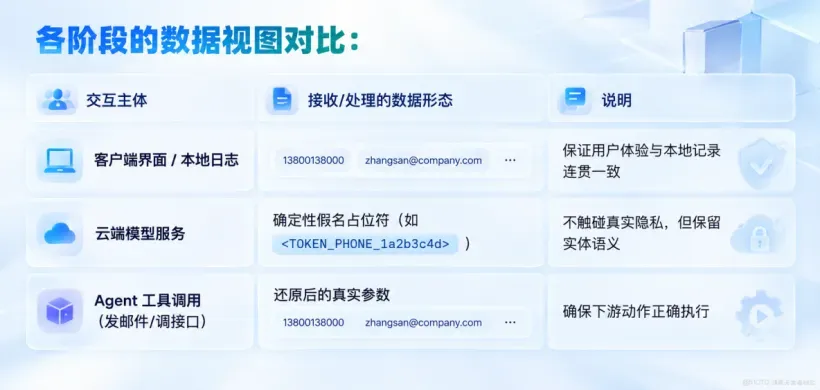
模型能清晰识别这是“一个电话实体”和“一个人名实体”,因而能顺利完成语义理解、推理及工具参数槽位填充;而在实际调用系统 API 发送消息前,网关在本地将假名重新逆向还原为真实数据。既复用了低成本、高算力的通用模型能力,又把核心数据牢牢锁定在本地。
四、核心防护策略与检测分流设计
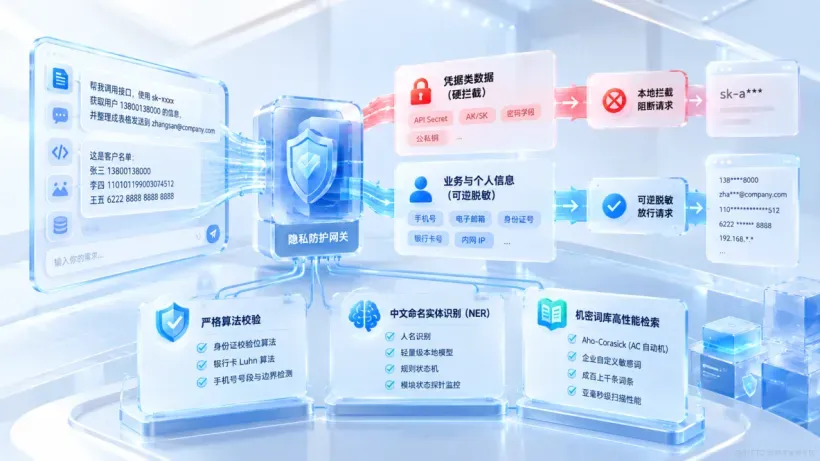
在网关的设计中,通常需要将敏感数据划分为两大治理等级:
1. 凭据类数据(硬拦截)
- 涵盖类型:各类公私钥(OpenSSH、RSA、PGP)、API Secret/Token(如 sk-...、云厂商 AK/SK)、密码字段等。
- 处理策略:阻断请求,坚决不出网。系统应直接在本地拦截并阻断请求流程,前端仅回显脱敏片段(如 sk-a*),禁止明文绕过。
2. 业务与个人信息(可逆脱敏)
- 涵盖类型:手机号、电子邮箱、身份证号、银行卡号、内网 IP 等。
- 处理策略:局部替换为可逆假名,放行请求。保证“整理名单”、“数据归纳”等常规业务任务不被阻断。
3. 规避误报与性能优化的工程考量
- 严格算法校验:避免仅凭简单正则匹配造成误报。例如,身份证需通过校验位算法验证,银行卡需配合 Luhn 算法,手机号需增加前后边界与有效号段检测,避免时间戳、业务订单号被过度脱敏导致语义崩塌。
- 中文命名实体识别(NER):中文人名模式复杂,通常需要轻量级本地模型或高性能规则状态机进行判定,并对模块状态做探针监控,避免脱敏引擎静默失效。
- 机密词库的高性能检索:针对企业自定义的项目代号、敏感术语,推荐采用 Aho-Corasick(AC 自动机)算法实现多模式匹配,保证在包含成百上千条词条时仍具备亚毫秒级的扫描性能。
五、假名机制的三个关键工程细节
如果只是将敏感词简单替换为 *,会导致大量功能性缺陷。实现高可用的脱敏引擎,需要关注以下几点:
1. 确定性映射(Deterministic Pseudonymization)
在同一个会话范围内,相同的敏感值应始终映射为唯一的假名哈希:
- 保障多轮对话一致性:避免上一轮的变量在下一轮随机变成了另一个代号;
- 友好支持云端 Prompt Cache:固定的前缀与占位符能最大程度命中云端大模型的 Prompt 缓存,降低推理延迟与 API 成本;
- 跨会话隔离:利用 Session Key 或会话 Salt,确保相同敏感实体在跨会话时生成不同假名,防止云端通过哈希特征将不同会话串联。
2. 杜绝信息覆盖与脏数据
若采用“保留姓氏 + 星号”打码(如将“张三”、“张伟”都替换为“张*”),会导致逆向反查表键值冲突,发生串人、错发的严重安全事故。每一个独立实体必须映射为唯一的 Token 占位符。
3. 规则流水线的优先级判定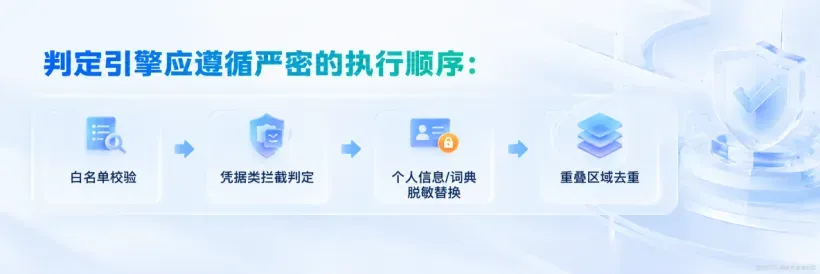
必须保证拦截规则优先于脱敏规则,杜绝“因命中较长的脱敏词而导致嵌在其中的密钥被放行”的逻辑漏洞。
六、流式响应(Streaming)下的参数还原挑战
在实际工程落地中,大模型普遍采用 SSE(Server-Sent Events)进行流式 Token 输出。这对逆向还原提出了额外挑战:
假名 在流式吐字时,极大概率会被模型切分成多段碎片(如 )。
若直接逐段输出,客户端将渲染出残缺的乱码片段;若完全等待整句响应结束再处理,又会彻底破坏流式输出的即时交互体验。
工程解决方案:引入滑动还原缓冲区(Sliding Window Buffer)
- 缓冲区监控进入的字符流;
- 当捕获到占位符起始标识(如 <TOKEN_)时,启动暂存缓冲; ## --- / 3. 4. API Call Calling Function JSON Tool
总结
参数反序列化后、真实网络请求发出前,对结构化参数进行一次确定性的全量还原替换。 在大模型深度融入业务系统的过程中,合规与效率不应是非此即彼的选择。 场景,则需在 对于 待完整的哈希闭合标签接收完毕后,完成内存查表映射并一次性下发真实文本; 若后续字符偏离假名模式,判定为普通文本,立即放行缓冲区内容。 通过在客户端或内网边界构建双向可逆的本地脱敏防护机制,我们既能放心地调用公网顶尖的大语言模型 降本增效,又能确保企业及个人核心隐私在出网前完成合规遮蔽,构建起一道稳健的数据安全防线。




