
压测报告审计:施压端自己先成了瓶颈——分布式压测的客户端饱和与冷启动
大促前那份容量压测报告写得很干净:5000 并发下 p99 稳定 180ms,被测服务 CPU 只到 60%,结论栏写着「容量充足,可支撑峰值」。评审顺利通过,按时上线。
大促当晚同样的量级压上来,p99 冲到 900ms,下单页转圈。第一反应总是「压测环境和线上不一样」——流量模型、数据量、下游依赖确实可能不同,但都不是这次的主因。
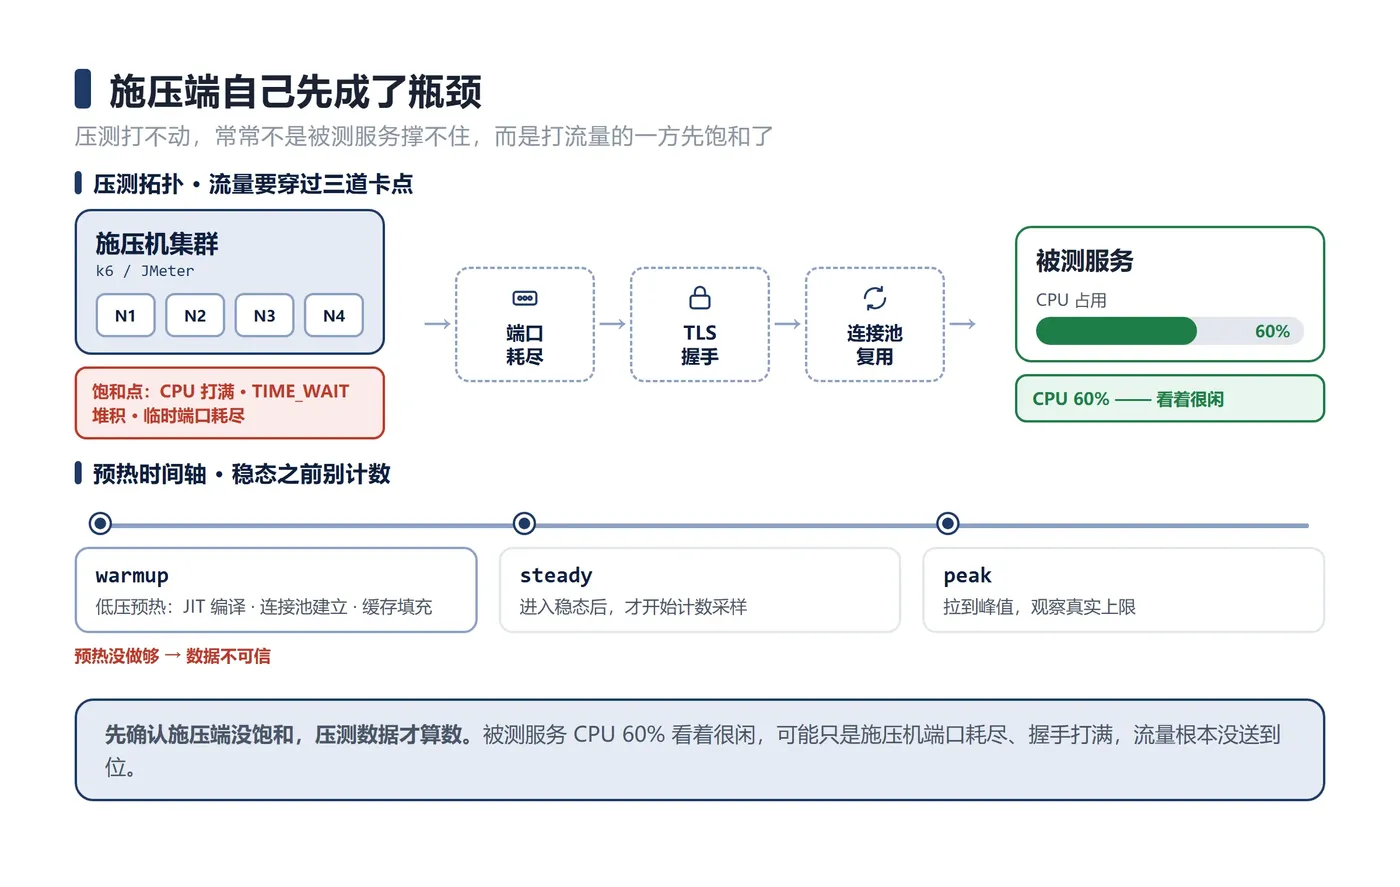
复盘到第三天才找到根因:那台施压机自己先饱和了。报告里的 180ms,量的不是被测服务的响应时间,而是请求在施压端排队等自己的时间。被测服务 CPU 只有 60%,不是因为它扛得住,而是因为压力根本没送到。
一、审计结论摘要
这次审计的对象不是被测服务,是产出这份报告的那台施压机。三条发现按风险从高到低。
第一,报告里没有任何一栏施压端数据:CPU、内存、网卡吞吐、临时端口占用、TIME_WAIT、文件句柄全部缺失。缺这一栏,「180ms 可不可信」事后就无法复核。
第二,压测从静止直接拉到 5000 并发,没有预热段。连接池是空的、TLS 会话没建立、服务端热点方法还没被 JIT 编译成本地码,这几段数据本就不该混进容量统计;而预热段恰好是施压端也还没打满的时候,它给出的是全程最好看的数字。
第三,这台施压机的单机 RPS 上限从未被标定过,于是「压到 5000 并发」有没有真正做到,没人能回答。
建议动作四条:给施压端加健康度采集、把预热段写进场景并单独留档、先标定单机上限再决定要不要分布式、在脚本里内置可信度门禁——施压机 CPU 或 TIME_WAIT 超阈值,本轮数据直接标记为不可信。第六节给实现,第七节给清单。
二、施压端饱和的四个物理根因
施压端饱和不像被测服务过载那样会报错。它是静默的:请求照样发、响应照样回、曲线照样漂亮,只是数字里混进了施压端自己的排队时间。
根因一,临时端口耗尽。每条新连接要从 ip_local_port_range 取一个本地端口,默认区间两万多个;高频建连时端口用完就得等回收,表现是施压端 RPS 上不去,被测服务却一片清闲。根因二,连接没复用导致 TIME_WAIT 堆积,/proc/net/sockstat 里的 tw 一路爬升就是物证。
根因三,TLS 握手没预热。HTTPS 压测里握手的 CPU 开销常常比业务处理还大,会话复用没开时施压端 CPU 全花在加解密上。根因四,施压进程 CPU 与句柄打满:序列化、响应体解析、日志落盘都在施压端,再叠加容器 CPU limit 太低被 cgroup 限流,脚本自己就成了最慢的一环。
四个根因的共同点:它们都让「把请求发出去」这一步变慢,而这段慢被算进了 http_req_duration。下面这张对照表是同一份报告在两种状态下的读数差别——被测服务越闲、施压机越忙,数据越假。
| 观测项 | 施压端饱和时的读数 | 施压端健康时的读数 | 判读要点 |
|---|---|---|---|
| 被测服务 p99 | 180ms,曲线平滑漂亮 | 430ms,有真实长尾 | 越好看越要怀疑施压端 |
| 实际打出的 RPS | 随时间悄悄下滑 | 与计划速率贴合 | RPS 下滑是饱和最早的信号 |
| 被测服务 CPU | 60%,还有大量余量 | 88%,接近拐点 | 服务闲而延迟低,压力没送到 |
| 施压机 CPU 与 TIME_WAIT | 96%;一万八且持续上涨 | 55%;两千以内平稳 | CPU 超七成本轮就不该采信 |
| 报告结论 | 容量充足 | 已接近拐点,需扩容 | 同一系统,两个相反结论 |
三、先标定单机 RPS 上限,再决定要不要分布式
要判断施压端有没有饱和,前提是知道它的上限在哪。这个上限不能猜,只能标:拿一个极轻的被测端点——返回固定 JSON、不查库、不走下游——在同一台施压机上阶梯加压,找到 RPS 不再随并发上升的拐点,记下拐点处的施压机 CPU、TIME_WAIT 与网卡吞吐。这条曲线就是这台机器的施压能力证书,一次标定长期可用,换内核参数或机型时重标。
标定完才有资格回答两个问题:本轮实际 RPS 有没有触到上限的七成,触到了数据就得打折;目标量级超过单机上限时,必须上分布式,而不是把单机硬压到极限。两者各有各的代价:
| 维度 | 单机施压 | 分布式施压(k6 多实例 / JMeter controller+server) |
|---|---|---|
| 适用量级 | 目标 RPS 低于单机上限七成时 | 目标量级逼近或超过单机上限时 |
| 协调遗漏风险 | 施压端饱和时 RPS 悄悄下滑,长尾被吃掉 | 单台压力小,饱和风险低,但需每台各自记账 |
| 施压端一致性 | 天然一致,只有一台机器 | 时钟、内核参数、网络路径都可能不同,最慢那台会带偏聚合 p99 |
| 结果聚合成本 | 一份 summary 即可 | 需统一时间基准与合并直方图,分位点不能直接平均 |
| 运维与费用 | 一台机器,起停简单 | 多机编排、镜像一致、网络放通、成本翻倍 |
| 可信前提 | 施压端健康度门禁通过 | 每一台施压机都独立通过同一份门禁 |
分布式最容易被忽略的代价是第三行:几台施压机环境不一致时,聚合分位点会被最慢那台带偏,而报告上看不出异常。所以它的前提不是机器够多,而是每台机器都过同一份健康度门禁。
四、冷启动预热:三类冷态资源要跑热才开始计数
预热不是「多跑一会儿」,它是把三类冷态资源跑热:施压端的连接池与 TLS 会话缓存、被测服务的 JIT 编译与本地缓存、中间件的线程池与数据库缓冲池。
做法分两段。第一段爬坡,从低速率线性爬到目标水位的三到五成,跑两到三分钟,让连接建满、会话建立、热点方法编译完;第二段预热稳态,维持这个水位再跑一分钟让指标收敛。两段都打 warmup 标签、不进容量统计,但要单独留一份——冷启动本身就是验收指标,扩容时新实例多久能接住流量,答案就在这份数据里。
判断预热够不够,不看表看指标:施压端 TIME_WAIT 是否还在爬升、http_req_waiting 的 p99 是否收敛、被测服务 CPU 是否进入平台期,三个都稳了才算热。最常见的错误是把预热段的低延迟当成系统能力——那一段施压端还没打满、队列还没堆积,p99 天然好看,算进平均值就是用最好看的一段代表整体。
五、施压端饱和会把协调遗漏放大
闭环模型(恒定并发)下,施压端与被测系统是绑在一起放慢的。施压端自己饱和时这条反馈链更短:施压进程 CPU 打满 → 发请求变慢 → 每个虚拟用户跑完一轮的时间变长 → 实际 RPS 掉下去 → 被测服务压力反而减轻 → 延迟读数更好看。施压机越累,报告越漂亮。
开环(恒定到达率)在这一点上更值钱:跟不上计划速率就产出 dropped_iterations,把「请求没发出去」变成写在报告里的数字。但边界要说清楚——开环解决的是请求有没有按计划发出,不解决施压端资源不够。物理侧的饱和,是统计侧一切修正的前提。
六、可运行实现:门禁写进脚本,体检跑在施压机上
实现分两段。第一段是 k6 脚本:预热、稳态、爬坡三段写进 scenarios,同时在每个响应上采三类施压端信号——timings.connecting 大于 0 说明新建了 TCP 连接(复用没生效)、timings.tls_handshaking 大于 0 说明发生了握手(会话没复用)、稳态段用 iterationInTest 反推计划发出时刻算出排队等待。三类信号全部进 thresholds,任一条不过,本轮就是不可信。
// order_capacity.js —— 带施压端可信度门禁的容量压测(k6)
// 在 Linux 施压机上三步运行:
//   1) python loader_health.py --interval 2 --duration 780 --out health.json &
//   2) k6 run --summary-export=summary.json --out json=raw.jsonl order_capacity.js
//   3) python loader_health.py --verdict --summary summary.json --health health.json
import http from 'k6/http';
import {
    check } from 'k6';
import {
    Trend, Counter } from 'k6/metrics';
import exec from 'k6/execution';

const BASE_URL = __ENV.BASE_URL || 'https://127.0.0.1:8443';
const STEADY_RATE = Number(__ENV.STEADY_RATE || 4000); // 稳态计划到达率
const PEAK_RATE = Number(__ENV.PEAK_RATE || 8000);     // 爬坡目标,用来找拐点

// 施压端自身信号:这三个越差,报告里的 p99 越不可信
const clientQueue = new Trend('client_queue_ms', true); // 请求在施压端的排队等待
const connRebuild = new Counter('conn_rebuild');        // 新建 TCP 连接(连接未复用)
const tlsHandshake = new Counter('tls_handshake');      // 发生 TLS 握手(会话未复用)

export const options = {

  noConnectionReuse: false,      // 关键:必须复用连接,否则 TIME_WAIT 会堆满
  discardResponseBodies: true,   // 施压端不解析响应体,省 CPU
  insecureSkipTLSVerify: true,
  scenarios: {

    warmup: {
                       // 预热:把连接池、TLS 会话、服务端 JIT 全部跑热
      executor: 'ramping-arrival-rate',
      startRate: 200,
      timeUnit: '1s',
      stages: [
        {
    duration: '2m', target: 1500 },
        {
    duration: '1m', target: 1500 },
      ],
      preAllocatedVUs: 200,
      maxVUs: 2000,
      exec: 'order',
      tags: {
    phase: 'warmup' },
    },
    steady: {
                       // 正式计数段:只有这段进容量统计
      executor: 'constant-arrival-rate',
      startTime: '3m',
      rate: STEADY_RATE,
      timeUnit: '1s',
      duration: '5m',
      preAllocatedVUs: 400,
      maxVUs: 6000,
      gracefulStop: '30s',
      exec: 'order',
      tags: {
    phase: 'steady' },
    },
    peak: {
                         // 爬坡段:找拐点,同时观察施压端是否先撑不住
      executor: 'ramping-arrival-rate',
      startTime: '8m',
      startRate: STEADY_RATE,
      timeUnit: '1s',
      stages: [{
    duration: '4m', target: PEAK_RATE }],
      preAllocatedVUs: 800,
      maxVUs: 12000,
      gracefulStop: '30s',
      exec: 'order',
      tags: {
    phase: 'peak' },
    },
  },
  thresholds: {

    // 可信度门禁:任一条不过,本轮数据不能作为容量结论依据
    'client_queue_ms': ['p(99)<50'],
    'conn_rebuild': ['count<500'],
    'tls_handshake': ['count<500'],
    'dropped_iterations': ['count<100'],
    'http_req_failed': ['rate<0.01'],
    'http_req_waiting{phase:steady}': ['p(99)<400'],
  },
};

export function order() {

  const phase = exec.scenario.name; // warmup / steady / peak
  const actualMs = Date.now();

  // 只有恒定到达率段能精确反推计划发出时刻;爬坡段速率在变,不做排队记账
  let plannedMs = actualMs;
  if (phase === 'steady') {

    plannedMs = exec.scenario.startTime + exec.scenario.iterationInTest * (1000 / STEADY_RATE);
    clientQueue.add(Math.max(0, actualMs - plannedMs));
  }

  const res = http.post(
    `${
     BASE_URL}/api/v1/orders`,
    JSON.stringify({
    skuId: 'SKU-1001', qty: 1, channel: 'loadtest' }),
    {

      headers: {
    'Content-Type': 'application/json' },
      timeout: '10s',
      tags: {
    planned_ts: String(plannedMs), actual_ts: String(actualMs) },
    }
  );

  if (res.timings.connecting > 0) connRebuild.add(1);
  if (res.timings.tls_handshaking > 0) tlsHandshake.add(1);

  check(res, {
    'status is 200': (r) => r.status === 200 });
}

export function handleSummary(data) {

  const pick = (name, key) => (data.metrics[name] ? data.metrics[name].values[key] : null);
  const failed = Object.entries(data.metrics)
    .filter(([, m]) => m.thresholds && Object.values(m.thresholds).some((t) => !t.ok))
    .map(([name]) => name);
  return {

    stdout: JSON.stringify({

      rps: pick('http_reqs', 'rate'),
      dropped_iterations: pick('dropped_iterations', 'count') || 0,
      client_queue_p99_ms: pick('client_queue_ms', 'p(99)'),
      conn_rebuild: pick('conn_rebuild', 'count') || 0,
      tls_handshake: pick('tls_handshake', 'count') || 0,
      http_req_waiting_p99_steady: pick('http_req_waiting{phase:steady}', 'p(99)'),
      gate_failed_metrics: failed,
      gate_passed: failed.length === 0,
      note: '门禁未过时请配合 loader_health.py --verdict 定位是端口、TIME_WAIT 还是 CPU',
    }, null, 2),
  };
}
第二段是跑在施压机上的健康度采集器,只依赖 Linux /proc 与标准库:定时采 TIME_WAIT、CPU、句柄与临时端口占用率写成 JSON;--verdict 模式再把它与 k6 的 summary 合到一起,直接输出「可信/不可信」与原因。
"""
loader_health.py —— 施压端健康度采集与压测数据可信度判定(Linux /proc + 标准库)

采集:python loader_health.py --interval 2 --duration 780 --out health.json
判定:python loader_health.py --verdict --summary summary.json --health health.json
      summary.json 来自 k6 run --summary-export=summary.json
"""

import argparse
import json
import os
import time
from datetime import datetime

CPU_LIMIT_PCT = 70.0        # 施压机整机 CPU p95 上限
TW_LIMIT = 5000             # TIME_WAIT 连接数上限
PORT_USE_LIMIT = 0.60       # 临时端口占用率上限
QUEUE_P99_LIMIT_MS = 50.0   # 施压端排队等待 p99 上限


def read_cpu_ticks():
    """返回 (idle, total),两次采样之差即为区间 CPU 占用。"""
    with open("/proc/stat") as f:
        for line in f:
            if line.startswith("cpu "):
                vals = [int(x) for x in line.split()[1:9]]
                return vals[3] + vals[4], sum(vals)
    raise RuntimeError("/proc/stat 中没有 cpu 汇总行")


def read_time_wait():
    with open("/proc/net/sockstat") as f:
        for line in f:
            if line.startswith("TCP:"):
                parts = line.split()
                for i, token in enumerate(parts):
                    if token == "tw":
                        return int(parts[i + 1])
    return 0


def read_port_range():
    with open("/proc/sys/net/ipv4/ip_local_port_range") as f:
        lo, hi = f.read().split()
        return int(lo), int(hi)


def count_used_local_ports():
    """统计当前被占用的本地端口数(/proc/net/tcp 第二列的本地端口为十六进制)。"""
    used = set()
    for path in ("/proc/net/tcp", "/proc/net/tcp6"):
        if not os.path.exists(path):
            continue
        with open(path) as f:
            next(f, None)  # 跳过表头
            for line in f:
                cols = line.split()
                if len(cols) < 4:
                    continue
                local = cols[1]
                if ":" in local:
                    used.add(int(local.rsplit(":", 1)[1], 16))
    return len(used)


def read_file_handles():
    with open("/proc/sys/fs/file-nr") as f:
        parts = f.read().split()
        return int(parts[0]), int(parts[2])  # 已分配, 上限


def sample_once():
    lo, hi = read_port_range()
    total_ports = hi - lo + 1
    used_ports = count_used_local_ports()
    alloc_fd, max_fd = read_file_handles()
    return {

        "ts": datetime.now().isoformat(timespec="seconds"),
        "time_wait": read_time_wait(),
        "port_total": total_ports,
        "port_used": used_ports,
        "port_use_ratio": round(used_ports / float(total_ports), 4),
        "fd_alloc": alloc_fd,
        "fd_use_ratio": round(alloc_fd / float(max_fd), 4) if max_fd else 0.0,
    }


def collect(interval, duration, out):
    prev_idle, prev_total = read_cpu_ticks()
    rows = []
    deadline = time.time() + duration
    while time.time() < deadline:
        time.sleep(interval)
        idle, total = read_cpu_ticks()
        d_total = total - prev_total
        cpu_pct = 0.0 if d_total <= 0 else round(100.0 * (1.0 - (idle - prev_idle) / d_total), 2)
        prev_idle, prev_total = idle, total
        row = sample_once()
        row["cpu_pct"] = cpu_pct
        rows.append(row)
        print("cpu=%.1f%% tw=%d port=%.1f%% fd=%.1f%%" % (
            cpu_pct, row["time_wait"], row["port_use_ratio"] * 100, row["fd_use_ratio"] * 100))
    with open(out, "w", encoding="utf-8") as f:
        json.dump(rows, f, ensure_ascii=False, indent=2)
    print("已写入 %s,共 %d 个采样点" % (out, len(rows)))


def percentile(values, p):
    s = sorted(values)
    if not s:
        return float("nan")
    k = (len(s) - 1) * (p / 100.0)
    lo = int(k)
    hi = min(lo + 1, len(s) - 1)
    return s[lo] + (s[hi] - s[lo]) * (k - lo)


def verdict(summary_path, health_path):
    with open(summary_path, encoding="utf-8") as f:
        metrics = json.load(f).get("metrics", {
   })
    with open(health_path, encoding="utf-8") as f:
        health = json.load(f)
    if not health:
        raise SystemExit("健康度采样为空,无法判定:采集器是否与压测同时段运行?")

    def val(name, key):
        return metrics.get(name, {
   }).get("values", {
   }).get(key)

    cpu_p95 = percentile([r["cpu_pct"] for r in health], 95)
    cpu_max = max(r["cpu_pct"] for r in health)
    tw_max = max(r["time_wait"] for r in health)
    port_max = max(r["port_use_ratio"] for r in health)
    fd_max = max(r["fd_use_ratio"] for r in health)
    queue_p99 = val("client_queue_ms", "p(99)")
    dropped = val("dropped_iterations", "count") or 0
    conn_rebuild = val("conn_rebuild", "count") or 0

    reasons = []
    if cpu_p95 > CPU_LIMIT_PCT:
        reasons.append("施压机 CPU p95=%.1f%% 超过 %.0f%%:压力卡在施压端,不是被测服务" % (cpu_p95, CPU_LIMIT_PCT))
    if tw_max > TW_LIMIT:
        reasons.append("TIME_WAIT 峰值 %d 超过 %d:连接复用没生效,检查 noConnectionReuse 与 keep-alive 超时" % (tw_max, TW_LIMIT))
    if port_max > PORT_USE_LIMIT:
        reasons.append("临时端口占用率峰值 %.1f%% 超过 %.0f%%:接近端口耗尽" % (port_max * 100, PORT_USE_LIMIT * 100))
    if fd_max > 0.8:
        reasons.append("文件句柄占用率峰值 %.1f%%:调高 nofile 上限或降低并发" % (fd_max * 100))
    if queue_p99 is not None and queue_p99 > QUEUE_P99_LIMIT_MS:
        reasons.append("施压端排队等待 p99=%.1fms 超过 %.0fms:这段延迟被算进了业务 p99" % (queue_p99, QUEUE_P99_LIMIT_MS))
    if conn_rebuild > 500:
        reasons.append("新建 TCP 连接 %d 次:TLS 与握手开销落在施压端" % int(conn_rebuild))
    if dropped > 0:
        reasons.append("dropped_iterations=%d:开环计划速率没打出去" % int(dropped))

    print("施压端体检:CPU p95=%.1f%% / max=%.1f%%,TIME_WAIT 峰值=%d,端口占用峰值=%.1f%%,句柄峰值=%.1f%%"
          % (cpu_p95, cpu_max, tw_max, port_max * 100, fd_max * 100))
    print("施压端排队 p99=%s ms,新建连接=%d,dropped_iterations=%d"
          % (queue_p99, int(conn_rebuild), int(dropped)))

    if reasons:
        print("\n判定:本轮压测数据【不可信】,不能作为容量结论依据")
        for r in reasons:
            print("  - " + r)
        print("\n处置顺序:先开连接复用与会话复用 → 加预热段 → 标定单机上限 → 仍不够就上分布式 → 重跑")
        return 1
    print("\n判定:本轮压测数据【可信】,施压端未成为瓶颈")
    return 0


def main():
    ap = argparse.ArgumentParser(description="施压端健康度采集与压测数据可信度判定")
    ap.add_argument("--interval", type=float, default=2.0, help="采样间隔秒")
    ap.add_argument("--duration", type=float, default=780.0, help="采集总时长秒,需覆盖整个压测")
    ap.add_argument("--out", default="health.json")
    ap.add_argument("--verdict", action="store_true", help="判定模式")
    ap.add_argument("--summary", help="k6 --summary-export 产物路径")
    ap.add_argument("--health", help="本脚本采集出的 health.json 路径")
    args = ap.parse_args()

    if args.verdict:
        if not args.summary or not args.health:
            raise SystemExit("--verdict 需要同时提供 --summary 与 --health")
        raise SystemExit(verdict(args.summary, args.health))
    collect(args.interval, args.duration, args.out)


if __name__ == "__main__":
    main()
为什么这么写:施压端健康度必须在施压机本地采,不能靠 k6 自己的指标反推——k6 报出的 http_req_duration 已经包含施压端排队时间,用被污染的数去证明施压端没被污染是循环论证。所以两个证据源要分开:k6 负责「计划 vs 实际」的排队证据,/proc 负责「这台机器到底累不累」的物理证据,两边都过阈值才判定可信。
踩过的坑有三个。一是 sockstat 的 tw 是整机口径,施压机上还跑别的服务时会被污染,最好用独立施压机。二是 cgroup 限流下 /proc/stat 读到的是宿主 CPU,会严重低估施压进程占用,这时要改读 /sys/fs/cgroup/cpu.stat 的 nr_throttled。三是 thresholds 只能让 k6 退出码非零,不会替你改写报告结论,判定逻辑必须落在采集器的 verdict 里,并作为固定一栏写进压测报告。
七、审计清单:对着报告逐条勾
| 审计项 | 报告里必须出现什么 | 缺失时的后果 |
|---|---|---|
| 施压端体检 | 施压机 CPU、TIME_WAIT、端口占用、句柄的峰值与 p95 | 无法判断数据是否可信 |
| 单机上限标定 | 施压机在轻端点上的 RPS 拐点值 | 不知道该不该上分布式 |
| 预热窗口 | 预热时长、丢弃依据、冷启动单独一份数据 | 前几十秒的假象混进统计 |
| 负载模型 | 执行器类型、rate、duration、maxVUs | 闭环下长尾被静默吃掉 |
| 排队记账 | 施压端排队等待 p99 | 施压端延迟被当成业务延迟 |
| 可信度结论 | 门禁通过/不通过,不通过则本轮作废 | 拿不可信数据做发布决策 |
这六项没有一项需要换工具或加预算,只是把已产生的数据多采一点、多算一遍,并在报告里留一栏。反过来说,一份连施压端 CPU 都没写的容量压测报告,它的 p99 就不该被拿来当发布依据。
压测报告最贵的错误,不是把系统测崩了,而是施压机先累了,却把它的疲惫写成了系统的从容。aaaaaaaaaaaaaaa




