随着大模型训练、AI图像视频生成、数字人渲染、科学仿真计算等业务快速普及,GPU算力已经成为AI项目落地的核心基础设施。本地搭建GPU服务器需要投入高额硬件采购成本,还要承担硬件维护、机房供电、散热、硬件故障维修等一系列运维压力,对于初创团队、个人研究者、小型AI项目来说,一次性投入硬件资金门槛很高。阿里云EGS弹性GPU服务,提供按需租用的 阿里云 EGS GPU云服务器 ,不需要一次性采购硬件,按照实际使用时长或者周期付费,支持弹性扩缩容,从单卡小实例到万卡大规模集群都可以灵活搭建,广泛用于大模型微调、模型推理、AIGC素材生成、视频渲染、生物医药仿真、气象模拟等高性能计算场景。很多开发者和企业在采购GPU算力时,容易混淆不同实例规格的价格,忽略云盘、公网带宽、快照等附加计费项目,最终导致实际账单远超预算。本文将完整梳理 阿里云 EGS GPU云服务器 的计费体系,整理主流实例T4、A10、V100、P100、L20的小时、包月、包年参考价格,讲解包年包月、按量付费、抢占式实例、节省计划等多种付费模式的差异,附带服务器性能检测命令、阿里云CLI账单查询命令、Python成本监控脚本,分析不同业务场景的选型策略,拆解GPU服务器采购过程中容易踩坑的隐性收费项,帮助用户精准评估算力成本,选择最适合业务的付费方案。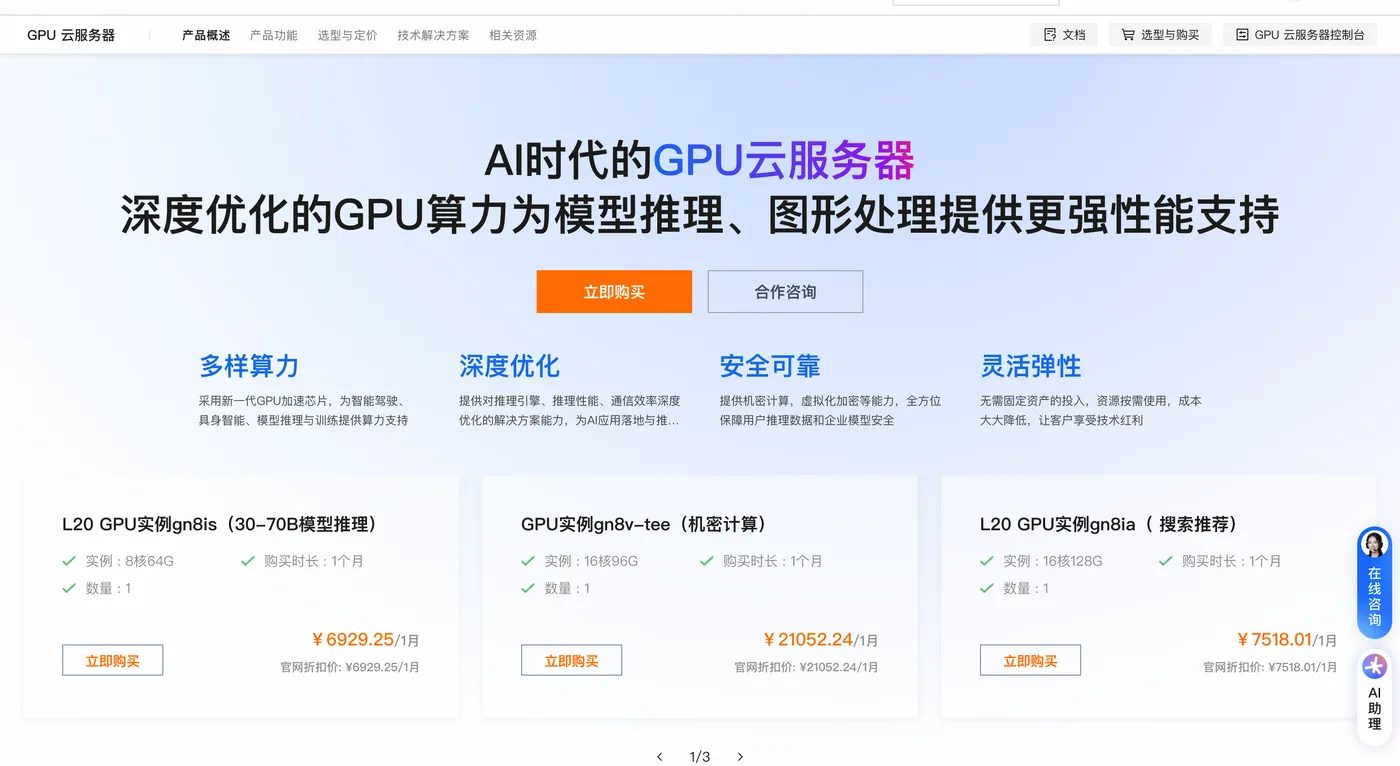
一、EGS GPU服务器基础计费体系与计费项拆解
阿里云 EGS GPU云服务器 的计费逻辑和ECS弹性服务器体系保持一致,整体费用由多个独立计费项共同组成,很多新手只关注GPU实例本身价格,忽略配套资源计费,造成预算失控。完整计费项分为实例计算资源、存储资源、公网网络、镜像、快照与备份五大模块。
- 实例计算资源(核心计费项):包含vCPU、内存、GPU显卡,是整个GPU服务器最大的成本来源。不同GPU型号、显存大小、CPU内存配比,价格差异巨大。同一款实例,在不同地域的标价会存在浮动,购买前需要确认目标地域定价。
- 块存储云盘:系统盘、数据盘单独计费,ESSD云盘按照容量和使用时长计费。包年包月实例的系统盘一般随实例周期购买;按量实例的云盘会按小时持续扣费,即使实例关机,云盘只要不释放,计费不会停止,这是最容易产生意外账单的项目。
- 公网带宽:支持固定带宽计费和按流量计费两种模式。固定带宽预先选定带宽规格,费用固定,流量不额外扣费;按流量计费模式下,实例基础费用较低,但是公网出网流量单独计费,大流量场景会产生高额流量账单。
- 镜像:公共操作系统镜像免费;部分第三方市场镜像、商业软件镜像会单独收取费用,自定义镜像本身不收费。
快照与备份:快照用于数据备份,快照占用的存储容量单独计费,如果长期大量保留快照,会持续产生存储开销。
阿里云 EGS GPU云服务器 一共支持四种主流付费模式,分别适配不同业务形态:
包年包月预付费:预先支付1个月、1年或者多年的费用,单位算力单价最低,适合长期稳定运行的业务,比如7×24小时在线的大模型推理服务、常态化AI生成业务,购买周期越长折扣力度越高。
按量付费(后付费):按秒计费,开机就开始计费,关机停止计算资源费用,适合短期实验、模型调试、临时跑训练任务,不需要长期占用算力。缺点是单价更高,长期持续运行成本远高于包年包月。
抢占式实例:基于闲置算力竞价,价格远低于普通按量实例,最高可以节省70%左右算力成本。但是平台在资源紧张时会随时回收实例,任务会被强制中断。适合容错性高、可以断点续跑的离线训练任务,不适合线上生产推理业务。
节省计划与预留实例券:适合长期稳定的按量业务,承诺固定的小时消耗,获取大额折扣,抵扣实例、云盘账单,兼顾灵活性和成本优势,适合企业级大规模AI推理集群。
二、主流EGS GPU实例规格与2026价格清单
下面列出市面上使用频率最高的几款 阿里云 EGS GPU云服务器 实例,包含硬件配置、包月参考价格、换算后的小时参考单价,方便快速估算成本。
- T4实例 gn6i:4核15G内存,搭载单张NVIDIA T4显卡,16GB显存。包月参考价格1681元,适合轻量级大模型推理、AI绘图、视频转码、小型向量检索服务。小时按量单价约2.3元,抢占式实例单价可降低至0.7元上下。
- A10实例 gn7i:32核188G内存,单张A10显卡,24GB显存。包月参考价格3203.99元,适合7B、13B大模型微调、AIGC图像视频生成、多模态推理业务。小时按量单价约4.4元,抢占式实例折扣后单价约1.4元。
- V100实例 gn6v:8核32G内存,单张V100显卡,32GB显存。包月参考价格3817元,适合中等规模模型训练、科学计算、高性能仿真,算力稳定性强。小时按量单价约5.3元,抢占式实例折扣后约1.6元。
- P100实例 gn5:4核30G内存,单张P100显卡,16GB显存。包月参考价格1847.5元,适合老旧模型推理、简单深度学习实验,性价比高,适合学生、科研人员做实验。小时按量单价约2.5元。
- L20实例 gn8is:8核64G内存,单张L20显卡,48GB显存,支持30B~70B大模型推理。包月参考价格6929.25元,适合部署大规模商用大模型服务。小时按量单价约9.6元。
重要说明:价格为优惠活动期间参考报价,不同地域、活动时段价格会产生浮动,报价仅包含实例本身计算资源,云盘、公网带宽、快照等资源需要额外计费。包年购买会在包月基础上叠加折扣,购买一年通常可以拿到8折左右优惠,多年采购折扣力度更大。新用户首次采购 阿里云 EGS GPU云服务器 实例还可以领取专属优惠券,部分规格支持限时免费试用时长。
三、GPU服务器部署实操命令,硬件检测与CUDA环境验证
成功创建 阿里云 EGS GPU云服务器 实例之后,登录SSH终端,执行下面命令,查看GPU硬件信息、CUDA环境,验证显卡是否正常识别,这是部署AI模型前必不可少的步骤。
# 查看GPU硬件信息,确认显卡型号、显存
nvidia-smi
# 查看CUDA版本
nvcc -V
# 查看CPU核心数
nproc
# 查看内存信息
free -h
# 查看磁盘分区
lsblk
nvidia-smi命令是GPU运维最常用指令,执行之后可以直接看到显卡型号、显存占用、GPU利用率、驱动版本。如果这条命令提示找不到NVIDIA驱动,代表实例没有预装GPU驱动,需要手动安装驱动与CUDA环境。
磁盘性能测试命令
# 顺序写测试
dd if=/dev/zero of=gpu_test bs=1M count=200 oflag=direct
# 顺序读测试
dd if=gpu_test of=/dev/null bs=1M count=200 iflag=direct
# 删除测试文件
rm -f gpu_test
AI模型训练会大量读写磁盘,特别是加载大模型权重文件,磁盘IO性能直接影响模型加载速度。ESSD云盘能够满足绝大多数AI业务需求;超大模型训练场景,可以搭配NAS文件存储,存放模型权重与数据集。
监控GPU实时负载命令
# 持续刷新GPU利用率、显存占用
watch -n 1 nvidia-smi
这条命令每秒刷新一次显卡状态,在模型训练、推理过程中,可以实时观察GPU显存占用,判断是否出现显存溢出、算力闲置的情况,方便调整模型参数、批处理大小。
四、阿里云CLI查询GPU实例账单,预估算力成本
使用阿里云CLI工具,可以直接在本地终端查询 阿里云 EGS GPU云服务器 实例账单,实时监控GPU算力消耗,提前控制预算,避免费用超标。
第一步,安装并配置阿里云CLI
# 一键安装CLI工具
curl -L https://aliyuncli.alibabacloud.com/install.sh | sh
# 配置访问凭证,填入AccessKey
aliyun configure
# 查看EGS实例列表
aliyun ecs DescribeInstances --RegionId cn-hangzhou --Filter "InstanceType=gn*"
筛选实例规格以gn开头的,就是 阿里云 EGS GPU云服务器 实例,可以快速获取实例ID、实例状态。
查询GPU实例月度账单
aliyun bssopenapi DescribeInstanceBill --BillingCycle 2026-08 --ProductCode ecs --InstanceTypeFamily gn
执行之后,会返回当月所有 阿里云 EGS GPU云服务器 实例的账单明细,包含实例ID、计费项目、产生的费用,快速统计当月GPU算力总开销。
Python脚本实现账单自动监控,设置费用告警
from alibabacloud_bssopenapi20171214.client import Client as BssClient
from alibabacloud_tea_openapi import models as open_api

def create_bill_client():
    config = open_api.Config(
        access_key_id="填入你的AccessKeyID",
        access_key_secret="填入你的AccessKeySecret",
        endpoint="business.aliyuncs.com"
    )
    return BssClient(config)

def get_gpu_bill(month):
    client = create_bill_client()
    request = {
   "BillingCycle": month, "ProductCode":"ecs", "InstanceTypeFamily":"gn"}
    response = client.describe_instance_bill(request)
    total_cost = 0
    print("=====GPU实例账单明细=====")
    for item in response.body.data.items:
        cost = float(item.pretax_amount)
        total_cost += cost
        print(f"实例ID:{item.instance_id},计费项:{item.billing_item},金额:{cost}元")
    print(f"本月GPU实例总费用:{total_cost:.2f}元")
    # 设置预算告警阈值,超过阈值输出提醒
    budget_limit = 8000
    if total_cost > budget_limit:
        print(f"警告:GPU算力账单已超过预算{budget_limit}元,请及时检查资源!")

if __name__ == "__main__":
    # 查询指定月份GPU账单
    get_gpu_bill("2026-08")
脚本运行前,需要提前安装阿里云SDK依赖包:
pip install alibabacloud_bssopenapi20171214 alibabacloud_tea_openapi
这个脚本可以集成到定时任务,每天自动拉取账单,一旦GPU算力开销超过预设预算,就输出告警,适合企业团队做成本管控,防止批量抢占式实例长期运行产生巨额账单。
五、不同付费模式选型策略,结合业务场景选择实例
场景1:短期实验、模型调试、临时跑微调任务
适合选择按量付费实例,任务完成之后及时释放实例。注意:只停止实例不会释放云盘,云盘会持续计费,任务结束后,需要销毁实例,同时释放数据盘,避免持续扣费。对于非核心离线任务,可以选用抢占式实例,大幅降低成本,但是代码必须支持断点续存,防止实例被回收导致任务中断。
场景2:7×24小时在线大模型推理服务,稳定对外提供API服务
优先选择包年包月实例,长期运行单价最低。推荐A10、L20实例,显存充足,适合部署多模态大模型、向量检索服务。可以搭配节省计划,进一步降低按量扩容节点的成本。
场景3:科研项目、学生毕业设计,短期深度学习实验
优先T4、P100实例,单价更低。可以关注新用户试用权益,领取免费GPU时长,用来做模型训练、代码调试。任务结束第一时间释放实例,避免闲置计费。
场景4:大规模离线训练集群,大批量数据集训练
采用混合方案,核心训练节点使用包年包月保障稳定性,批量离线任务使用抢占式实例,节省大量算力开支。搭配NAS存储存放数据集和模型权重,提升多节点之间的数据读写效率。
六、GPU服务器采购高频避坑指南
- 实例关机不等于停止计费:按量付费实例,停止实例之后,GPU、vCPU计算资源停止计费,但是系统盘、数据盘仍然持续计费。很多用户测试完成之后只关机不销毁实例,月底收到高额存储账单。如果不再使用,必须在控制台销毁实例,并且同步释放挂载的数据盘。
- 抢占式实例随时回收:抢占式实例价格低廉,但资源紧张时平台会回收实例,任务直接中断。绝对不能用于线上生产推理业务,仅用于离线、可重启的训练任务。
- 地域差异带来价格和库存波动:不同地域GPU实例价格、库存不一样,部分高端L20实例在部分地域资源紧张,购买前先确认实例是否可以在目标地域创建。
- 公网带宽成本容易被低估:如果模型对外提供公网接口,大量图片、视频输出会消耗公网流量,选择按流量计费模式时,要预估流量规模,业务流量大建议直接购买固定带宽。
- 快照备份持续扣费:自动快照策略会持续生成备份,占用存储容量,长期保留大量快照会产生额外费用,定期清理过期快照,或者设置快照自动过期时间。
- CUDA驱动环境配置成本:部分公共镜像没有预装NVIDIA驱动、CUDA、cuDNN,新手手动安装容易出错,建议直接选用预装GPU驱动的官方镜像,节省部署时间。
七、GPU算力成本优化高阶技巧
- 合理选择实例规格,不要盲目追求高端显卡:模型推理优先选择T4、A10,性价比更高;大规模训练再考虑L20等高显存实例。很多中小规模7B、13B模型推理,T4实例完全可以承载,不需要采购昂贵L20实例。
- 闲置资源及时释放:按量实例不用立刻销毁,不要长时间闲置。可以写自动化脚本,检测任务结束自动释放实例,减少无效算力消耗。
- 搭配节省计划抵扣账单:企业长期稳定使用GPU算力,购买节省计划,承诺小时消费,获得折扣,同时可以抵扣云盘费用,比单纯按量付费节省大量开支。
- 模型量化降低显存占用:使用量化技术,将FP16模型转为INT4、INT8量化版本,降低显存占用,使用更低规格显卡承载模型,减少算力采购成本。例如原本需要L20运行的模型,量化之后可以部署在A10实例。
- 批量任务错峰执行:抢占式实例的库存会随时段波动,在资源充足时段提交离线训练任务,更容易拿到低价算力。
八、全文总结
阿里云 EGS GPU云服务器 为AI开发者、科研人员、企业团队提供了弹性、可按需租用的高性能GPU算力,覆盖从T4入门卡到L20高端显卡的完整实例矩阵,支持包年包月、按量付费、抢占式实例、节省计划多种计费方案,适配模型训练、AI推理、AIGC生成、科学仿真等多元化高性能计算场景。
在评估 阿里云 EGS GPU云服务器 服务器成本时,不能只看实例本身标价,必须把云盘、公网带宽、快照等附加计费项纳入预算评估。借助nvidia-smi等本地检测命令,可以快速验证GPU硬件状态;通过阿里云CLI和Python监控脚本,能够实时查询账单,监控算力消耗,及时发现成本异常。
不同业务场景,适合的实例和付费模式完全不同。短期实验优先按量付费+抢占式实例;长期稳定线上推理业务优先包年包月,搭配节省计划降低成本;科研学习可以选用T4、P100入门实例,利用新用户试用权益降低试错成本。同时一定要牢记按量实例关机不等于释放资源,闲置存储会持续扣费,做好资源生命周期管理,定期清理快照和无用数据盘,规避隐性账单。
选择合适的 阿里云 EGS GPU云服务器 实例规格、合理的付费模式,配合模型量化、资源自动释放等优化手段,能够在保障业务算力需求的前提下,最大限度控制GPU算力投入,让AI项目的算力成本保持在可控范围。EGS弹性GPU服务,免除硬件采购、机房运维的繁琐工作,让开发者专注于模型研发和业务创新,不用投入大量精力维护底层硬件基础设施。