
开发者、小微企业、AI项目团队在上云的时候,往往会面对多种多样的算力产品,阿里云ECS云服务器、阿里云ECS云服务器 弹性云服务器、 阿里云 EGS GPU云服务器 、MaaS大模型服务,不同产品定位、能力、计费模式差异巨大。很多新手容易出现两种极端:盲目选购超高规格实例,造成资金大量浪费;或者一味压低预算选择低配,业务上线后频繁卡顿、推理超时,直接影响业务稳定性。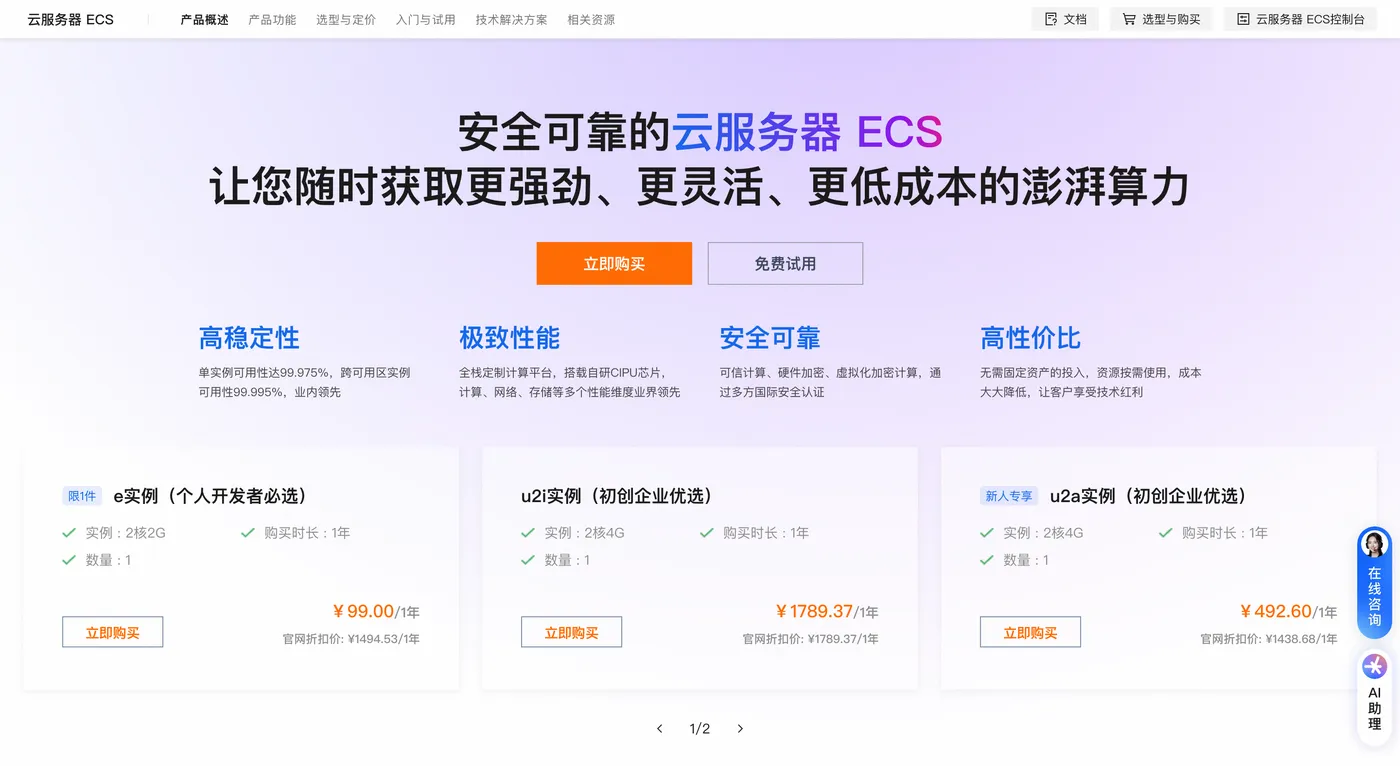
想要选对算力,不能只看CPU、内存纸面参数,需要理解每一类产品的能力边界、计费逻辑、适用场景。本文完整梳理四类主流算力产品的定位、规格族、计费规则,整理一套可以直接复制执行的Linux性能实测命令,结合不同业务给出选型方案,同时汇总高频踩坑点与成本优化思路,帮助使用者在业务稳定性和预算之间找到平衡点。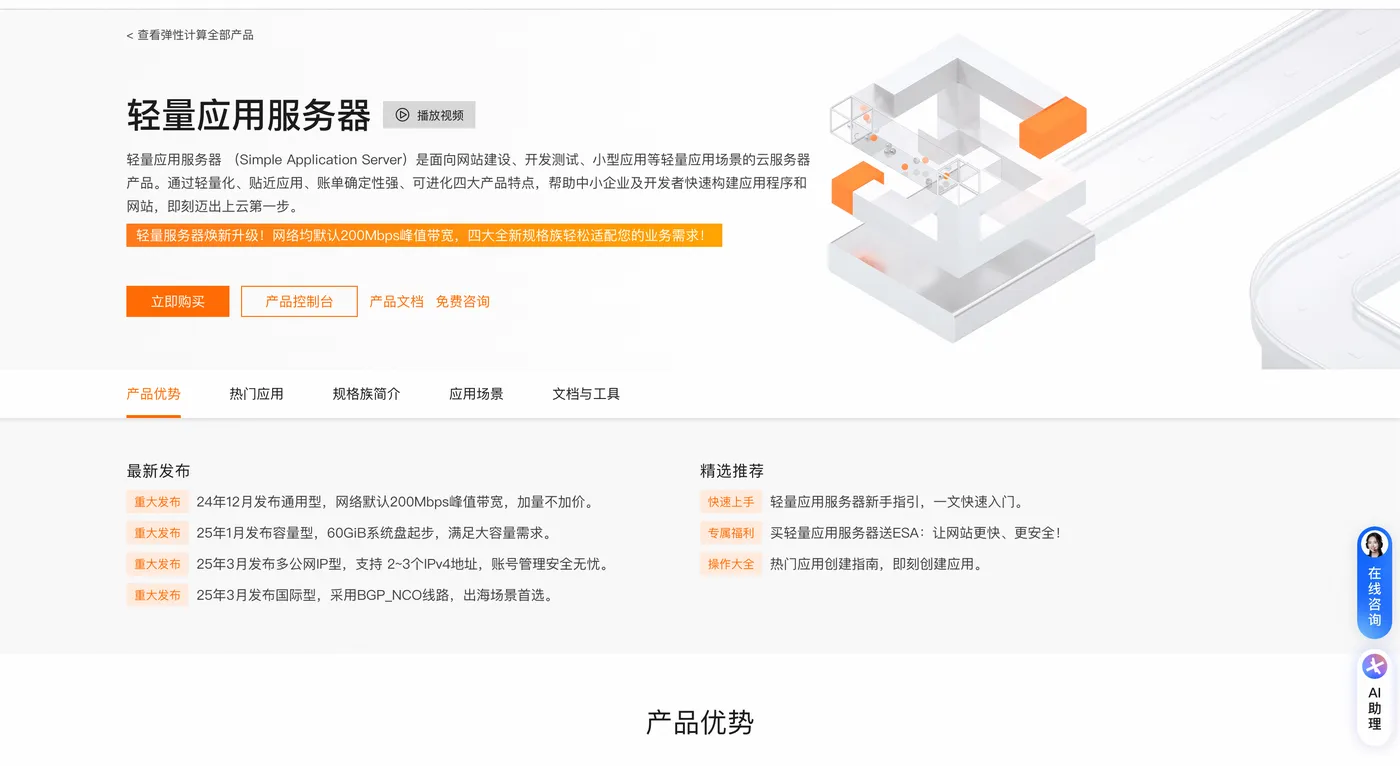
一、轻量应用服务器:开箱即用的入门一体化算力
阿里云轻量应用服务器 面向新手、个人站长、初创小团队,采用打包套餐模式,将CPU、内存、ESSD系统盘、峰值公网带宽、月度流量打包在一起,开箱即用。不需要深入学习VPC、复杂安全组等概念,控制台高度简化,内置大量预制应用镜像,几分钟就可以部署网站、小程序后端、测试环境,极大降低上手门槛。
规格族分为通用均衡型、CPU计算优化型、内存增强型、GPU轻量版、大容量存储型。通用均衡型是绝大多数新手首选,CPU主频维持2.0‑3.0GHz,适配博客、企业官网、开发调试;CPU优化型适合脚本批量处理、轻量推理;内存增强型适合小型缓存、轻量数据库;GPU轻量实例适合AI初学者做小规模模型推理实验;存储型侧重大容量磁盘,适合日志、文件留存场景。
网络方面自带较高公网峰值带宽,部分套餐流量包充足,对外访问场景性价比很高,但存在明确功能限制:不能单独升级CPU、内存、磁盘其中某一项资源,资源不足只能整体升级整套套餐;不支持弹性网卡、负载均衡、NAT网关等高级网络组件,不适合复杂分布式集群业务。
计费模式仅支持包年包月,分为月付、年付、多年套餐,不支持按量按小时计费,如果业务需要频繁启停销毁实例,轻量并不是最优选择。
适合场景:个人博客、静态展示网站、小程序测试后端、学习开发环境、单机小型业务。
不适合场景:多机器内网集群、需要独立升降单项硬件、高可用生产集群业务。
二、ECS弹性云服务器:企业级高度灵活的通用算力底座
阿里云ECS云服务器 是弹性计算体系的核心基础产品,CPU、内存、云盘、网卡、带宽全部解耦,可以自由组合,单项硬件资源能够独立升降配置。完整兼容VPC私有网络、弹性伸缩、负载均衡、多网卡、快照备份整套云原生组件,能够支撑分布式集群、数据库主从、中间件集群、微服务等高复杂度业务架构。
实例规格族十分丰富:g系列通用型适配绝大多数业务;c系列计算型侧重CPU算力,适合API网关、批量处理;r系列大内存规格,适配数据库、缓存、消息队列;自研倚天系列拥有不错综合性价比。
计费模式丰富多元:
- 包年包月:长期7×24小时运行业务,采购周期越长折扣越高;
- 按量付费:按小时结算,可以随时创建、释放,适合临时测试、压力测试;
- 抢占式实例:价格大幅降低,但资源存在被回收风险,仅用于离线可中断任务,禁止线上核心业务;
- 节省计划:针对按量实例提供长期折扣,适合业务波动大,无法固定包年包月的场景,最高可以降低七成成本。
带宽存在两种计费策略:固定带宽模式带宽上限固定,不计流出流量;按流量计费可以跑满峰值带宽,外网流出单独扣费,适合流量波动极大业务。
简单选型判断逻辑:单机简单业务、追求低运维门槛优先轻量;需要复杂组网、单项硬件独立升降配、搭建集群,优先选择 阿里云ECS云服务器 。
三、GPU云实例:AI训练推理、渲染场景的高性能异构算力
当业务进入大模型训练、高并发推理、视频渲染、科学计算阶段,普通CPU实例算力会出现明显瓶颈,此时需要 阿里云 EGS GPU云服务器 云实例。整体分为完整GPU计算型、vGPU虚拟化实例两大类。
GPU计算型实例搭载完整独立物理显卡,显存完整独占,适合大模型微调、完整模型训练、高并发线上推理,主流显卡包含T4、A10、A100。T4推理性价比突出,多用于线上推理服务;A10、A100拥有超大显存,面向大参数模型训练、分布式微调。
vGPU虚拟化实例:单张物理显卡切分为多份虚拟显卡,显存同步切分,成本更低。适合轻量模型推理、云工作站、CAD建模渲染、多用户共享GPU资源场景。
计费支持包年包月与按量付费。包年包月适合长期稳定AI业务,年付折扣可观;按量付费适合临时调试,任务结束必须及时释放实例,闲置状态依旧会产生高额账单。 阿里云 EGS GPU云服务器 实例整体成本远高于普通CPU实例,没有明确业务规划,不建议长时间保留。
四、MaaS大模型服务:免硬件运维,直接调用大模型能力
除了自己采购服务器部署开源模型,还可以直接使用MaaS大模型服务,无需管理GPU硬件,降低AI业务落地门槛。平台能力覆盖公有大模型API调用、自定义模型上传托管微调、弹性推理服务。业务流量上涨自动扩容,流量下降自动缩容,自动管理算力资源。
计费分为三类:Token计量,调用公有大模型,按照输入输出Token扣费;实例包年包月,私有化模型稳定线上业务;按量算力计费,适配阶段性微调任务。适合快速搭建RAG知识库、AI客服、智能体应用,不需要投入大量人力做驱动、环境、显卡运维。
选型提示:仅调用现成大模型API优先MaaS;需要完全私有化部署开源模型,才考虑采购GPU实例自行部署。
五、服务器性能实测,可直接复制Linux实操命令
实例创建完成之后,可以登录SSH终端,执行一系列命令,核验硬件、磁盘IO、网络带宽是否符合购买规格。
查看CPU型号信息:
cat /proc/cpuinfo | grep "model name" | uniq
查看内存总容量:
free -h
查看磁盘分区与磁盘占用:
df -h
读取实例元数据,获取实例规格(仅实例内部网络可访问):
curl http://100.100.100.200/latest/meta-data/instance/instance-type
speedtest‑cli测试公网带宽。
Debian/Ubuntu:
sudo apt update && sudo apt install speedtest-cli -y
speedtest-cli
CentOS:
sudo yum install speedtest-cli -y
speedtest-cli
fio磁盘IO测试,禁止在存有业务数据的磁盘执行,必须使用全新空白测试盘,避免损坏业务数据。
CentOS安装:
yum install fio -y
Ubuntu安装:
apt install fio -y
随机混合读写测试命令:
fio --name=disk_test --rw=randrw --bs=4k --numjobs=4 --size=1G --iodepth=4 --runtime=60 --direct=1
GPU实例查看显卡驱动、显存、进程状态,确认显卡正常识别:
nvidia-smi
本地安装CLI工具,查询全部ECS实例规格参数,用于选型对比:
aliyun ecs DescribeInstanceTypes --Output json
提示:测试环境的性能数据仅作为参考,真实生产环境性能受地域、可用区、业务并发、磁盘负载共同影响。
六、分场景完整选型方案
- 个人开发者、学生、博客、静态站点、小程序测试:优先轻量应用服务器,操作简单带宽性价比高,可支撑日均几千访问。中小企业简单官网、无集群需求的简单后端,也可以选中高配轻量。
- 需要数据库主从、负载均衡、多机器内网集群、需要频繁单独调整CPU/内存/磁盘:直接选用ECS。
- AI业务细分场景
- 仅调用现成大模型API,不需要本地跑模型:直接选用MaaS大模型服务,按Token计费,免去硬件运维;
- 7B‑13B规模模型,并发量不高:vGPU虚拟化实例;
- 大模型微调、高并发线上推理:完整GPU计算实例;
- 临时调试实验:GPU按量付费,用完立刻释放,杜绝闲置产生高额账单。
计费模式通用原则:
业务7×24小时稳定运行,可以预估使用时长,优先包年包月,周期越长折扣越高;短期测试、压力测试优先按量付费;离线可中断任务预算紧张,选用抢占式实例,同时做好任务断点保存,应对资源回收;业务波动巨大无法预估用量,搭配节省计划降低按量资源单价。
七、高频踩坑点梳理,规避业务故障与超额账单
- 产品边界混淆:把轻量应用服务器用来搭建复杂集群业务,后期发现缺少高级网络能力,业务必须整体迁移。前期规划有集群需求,直接上 阿里云ECS云服务器 。
- GPU实例忘记释放:按量GPU实例调试完毕不释放,持续产生高额账单,建议配置账单告警,消费到达阈值接收提醒。
- 磁盘选型失误:核心业务使用普通云盘,数据库高并发场景IOPS不足,数据库频繁卡顿;核心业务优先ESSD系列高性能云盘。
- 带宽计费选错: 阿里云ECS云服务器 使用按流量计费,业务出现大量图片文件下载,流出流量暴增带来账单突增,对外访问量大优先固定带宽。
- 实例规格与业务错配:数据库业务选用低内存实例,内存耗尽触发swap交换,性能暴跌;数据库、缓存优先内存优化规格族。
- AI业务硬件错配:盲目采购超大显存 阿里云 EGS GPU云服务器 ,业务实际需求很低,造成算力资源浪费。
- MaaS大模型服务风险:调用公有大模型API做好Token用量监控,设置用量上限,防止突发请求消耗大量额度;私有化部署评估模型显存占用,规格过小会出现OOM内存溢出、推理超时。
- 硬件配套瓶颈: 阿里云 EGS GPU云服务器 实例不能只看显卡型号,配套CPU、内存过低,会成为推理、训练瓶颈,出现GPU算力跑不满的现象。
性能层面额外注意:轻量套餐实例性能存在上限,高并发场景性能会衰减; 阿里云ECS云服务器 新一代实例硬件优于老版本,同等配置优先选择新一代规格族。
八、云上算力成本优化思路
- 拒绝盲目追求高配,资源规格贴合业务真实负载,不要预留过量闲置资源。
- 长期稳定运行业务优先包年包月,拉长采购周期拿到更高折扣;临时测试按量实例用完立刻释放,GPU资源尤其需要重视。
- 离线非核心任务,在业务允许中断的前提下合理使用抢占式实例降低开销。
- 按量付费业务开通节省计划,压低整体单价。
- 存储分层:热数据使用高性能ESSD云盘,冷数据迁移低成本存储介质。
- AI业务优先评估MaaS公有大模型API,对比自建GPU服务器的综合成本,很多中小业务调用API综合成本优于自建GPU集群。
业务上线之后持续监控负载,CPU、内存、磁盘IO长期高位及时升配;负载长期很低及时降配。选型不是一次性工作,业务迭代之后持续观测指标,动态调整算力规格。
九、总结
阿里云轻量应用服务器 、ECS、GPU云实例、MaaS大模型服务,没有绝对的好坏,核心在于业务场景匹配。
阿里云轻量应用服务器 主打开箱即用、打包套餐高带宽,面向单机简单业务、个人与初创小团队; 阿里云ECS云服务器 主打高度灵活可定制,面向企业复杂架构、集群业务; 阿里云 EGS GPU云服务器 云实例面向AI训练推理、渲染等算力密集场景;MaaS大模型服务降低AI落地门槛,不用维护底层硬件,直接调用模型能力。
选型流程建议:梳理业务访问规模、是否需要集群组网、是否需要GPU算力、业务运行周期,选定产品、规格、计费模式,配合命令行工具做性能核验。
上云之后持续观测服务器负载,随业务迭代调整算力配置,预留合理余量,既保障业务稳定运行,同时控制整体算力成本。




