
一、为什么把语音能力放在一起讲
开发者接触语音能力,通常是从单点需求开始的:要做短视频配音就去看语音合成,要做会议纪要就去看语音识别,要做语音助手才发现还得处理多模态输入和语音输出。三个需求分别找文档、分别接 SDK、分别管密钥,集成成本被切成了三份,用量和费用也散在三处。
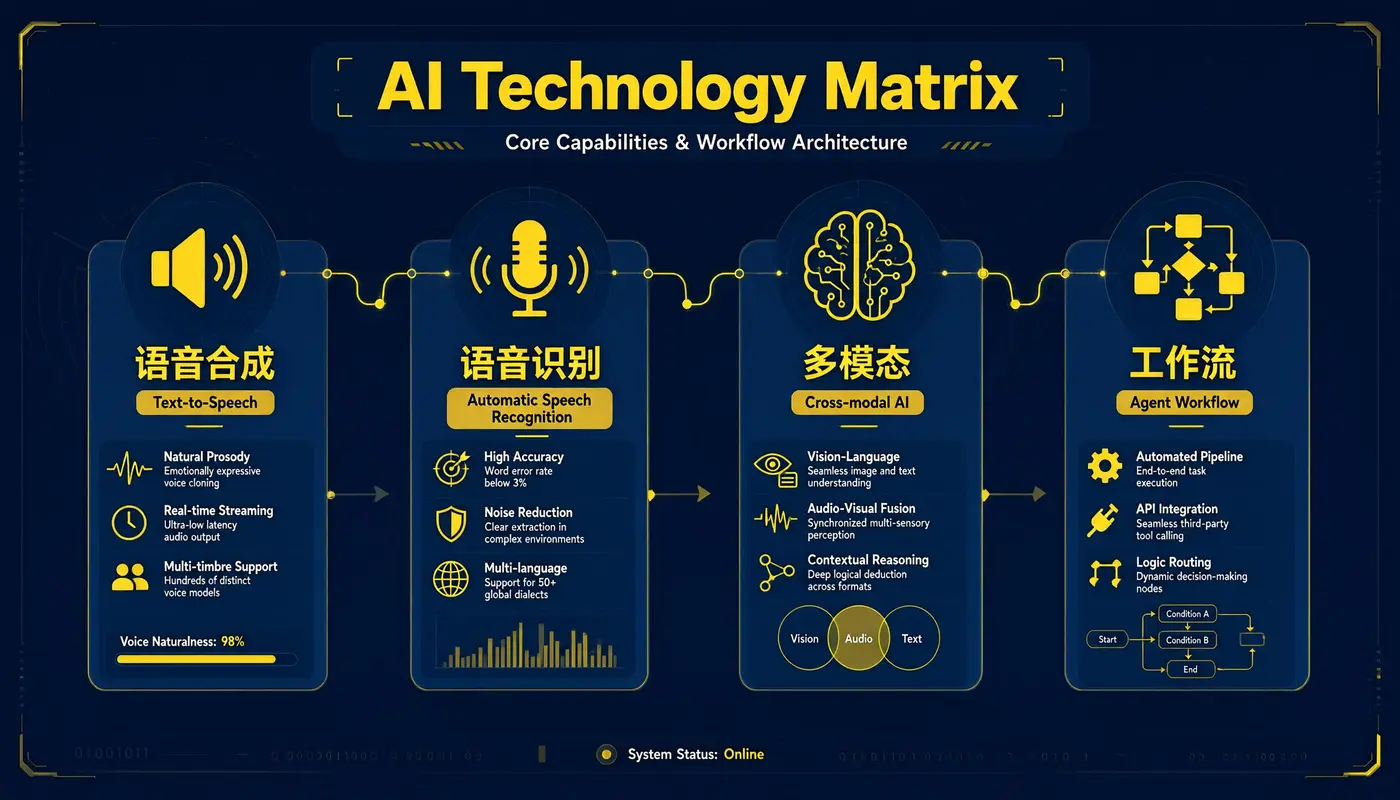
百炼把这三条能力放在同一个模型服务底座和同一个命令行工具下。本文按能力栈的顺序梳理一遍:模型矩阵、CLI 链路、编排与治理、定制路径,以及与开源生态的协同方式。文中命令签名以 bl 1.22.0 的 --help 输出为准,价格取自 bl model list 的实时返回,音色清单来自 --list-voices 实测。
二、模型能力矩阵
语音相关模型分三层,各自独立计价,可以在同一条链路里混用。
2.1 语音合成:CosyVoice 系列
| 模型 | 单价 | 定位 |
|---|---|---|
| cosyvoice-v3.5-flash | ¥0.8/万字符 | 最低成本档,承载克隆音色与设计音色(不接受系统音色 ID) |
| cosyvoice-v3-flash | ¥1/万字符 | 内置音色主力,64 个系统音色 |
| cosyvoice-v3.5-plus | ¥1.5/万字符 | 质量优先档 |
| cosyvoice-v3-plus | ¥2/万字符 | 长文本、有声书场景 |
| cosyvoice-clone-v1 | ¥2/万字符 | 声音复刻 |
| cosyvoice-v2 / cosyvoice-v1 | ¥2/万字符 | 历史版本,存量业务沿用 |
cosyvoice-v3-flash 的 64 个系统音色,语言分布是中文/英文 36(含童声 4、台式 1)、粤语 3、方言 3(东北话、陕西话、闽南话)、美式英语 10、英式英语 4、日语 5、韩语 2、印尼语 1。
bl speech synthesize --list-voices --model cosyvoice-v3-flash
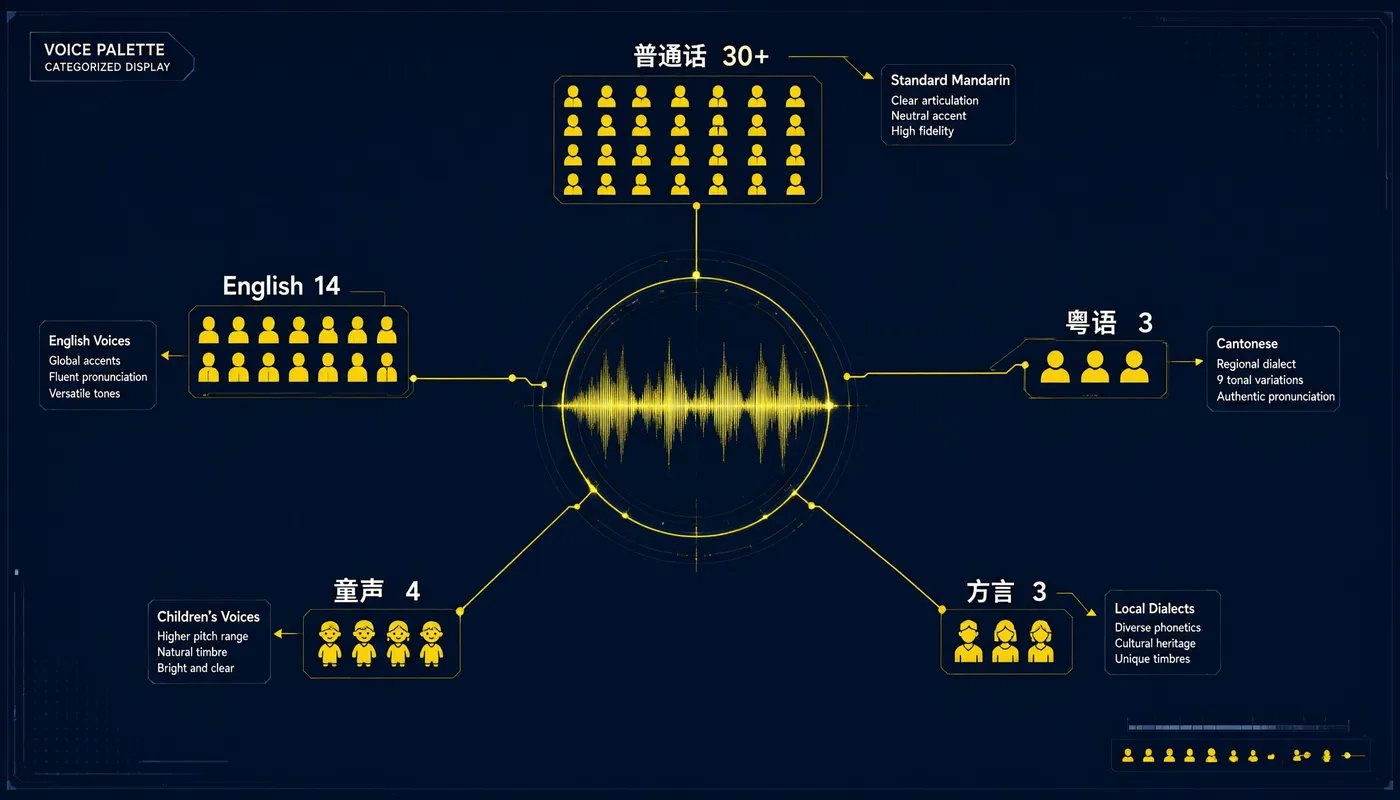
方言与粤语音色的存在,意味着区域性内容生产不需要额外训练或外包:地方文旅、农机、方言短剧、儿童内容可以直接选对应音色 ID。音色清单在控制台文档侧也有对应页面,CLI 输出末尾会附上链接。
2.2 语音识别:Fun-ASR 与 Qwen-ASR
| 模型 | 单价 | 模式 |
|---|---|---|
| fun-asr | ¥0.00022/秒(约 ¥0.792/小时) | 异步 |
| fun-asr-mtl 及各日期快照版本 | ¥0.00022/秒 | 异步 |
| qwen3-asr-flash / fun-asr-flash / qwen-audio-*-asr-flash | 见 bl model list |
同步 |
*-filetrans / paraformer-* |
见 bl model list |
异步 |
fun-asr 的模型自述是"通义百聆新一代语音识别大模型,主打中文、英文、日文语音识别,多地区方言覆盖,具备更强的噪声鲁棒性",实测 QPM 限流为 10。
选择依据是时延要求与功能要求:低时延走同步 Flash ASR,需要说话人分离(diarization)走异步 filetrans 模型。这两个能力目前不在同一个模型上,CLI 会在本地前置校验阶段拦下不支持的参数组合,不发起请求也不计费。
2.3 多模态交互:Qwen-Omni
qwen3.5-omni-plus 是 bl omni 的默认模型。模型自述能力:支持超过 10 小时的音频理解、超过 400 秒的 720P(1 FPS)音视频理解与对话,支持 60 多种语言的音频输入、30 多种语言的语音输出;上下文 262144,最大输出 65536;features 含 web-search、function-calling、batch。
| 计费项 | 标准价(每百万 token) | Batch File |
|---|---|---|
| 输入:文本/图片/视频 | ¥7 | ¥3.5 |
| 输入:音频 | ¥53 | ¥26.5 |
| 输出:纯文本 | ¥40 | ¥20 |
| 输出:文本+音频 | ¥213(输出的文本不再单独计费) | 同左 |
Omni 提供 13 个交互音色,其中包含北京、南京、四川(两个)、陕西、粤语(两个)、天津等地方口音,适配区域化语音客服与语音助手。语音输出与纯文本输出之间有 5 倍多的价差,--text-only 是开发期最直接的成本开关,Batch File 半价则是离线批量任务的成本杠杆。
三、CLI 链路:三层能力一个入口
3.1 安装与认证
npm install -g bailian-cli
bl skill init
bl auth login --api-key sk-xxxxx
bl auth login --console
bl auth status
npm 方式要求 Node.js 18.17 以上;macOS/Linux 可走 curl -fsSL https://bailian.aliyun.com/cli/install.sh | bash,Windows PowerShell 走 irm https://bailian.aliyun.com/cli/install.ps1 | iex,脚本方式不需要预装 Node。bl skill init 会一并装上 Bailian Skills,把 CLI 能力暴露给 Coding Agent 使用。
模型调用凭证与控制台凭证是两条:前者用于推理调用,后者用于 bl usage、bl workspace、bl quota history 这类查询与管理命令。安装说明见 百炼 CLI 页面,API Key 在控制台 API Key 页面创建(免费额度仅在华北2 北京地域生效)。
3.2 合成
bl speech synthesize --model cosyvoice-v3-flash --text-file script.txt --voice longcheng_v3 --rate 0.9 --instruction "用沉稳的语气" --out chapter-01.mp3
工程侧值得关注的参数:--seed(0-65535)保证同输入同输出,便于批量生产中单条重跑;--concurrent 控制并行请求数;--format 支持 mp3/pcm/wav/opus;--stream 输出裸 PCM 到 stdout,可直接管道接播放器或推流,链路上不需要临时存储。
bl speech synthesize --model cosyvoice-v3-flash --text "Hello" --voice loongabby_v3 --language en --stream | ffplay -nodisp -autoexit -f s16le -ar 24000 -ac 1 -
--model 的默认值来自 profile 配置(未配置时为 cosyvoice-v3-flash),而系统音色 ID 与模型绑定,因此生产脚本建议显式声明 --model,或一次性固定配置:
bl config set --key default_speech_model --value cosyvoice-v3-flash
bl speech synthesize --model cosyvoice-v3-flash --text "测试" --voice longcheng_v3 --dry-run
--dry-run 是全局 flag,打印实际请求体而不发起调用,排查参数与默认值问题不产生费用。
3.3 识别
bl speech recognize --model fun-asr --url ./meeting.wav --diarization --speaker-count 3 --vocabulary-id vocab-abc123 --out meeting.json
--url 支持网络地址与本地路径,可重复传入,单次上限 100 个文件。长音频用 --async 取任务 ID,--poll-interval 控制轮询间隔(默认 2 秒)。本地文件不便公开托管时,bl file upload 可推送至 DashScope 临时存储,有效期 48 小时。
3.4 多模态交互
bl omni --message "user:这张封面图上最抢眼的是什么" --image ./cover.jpg --voice Tina --audio-out reply.wav
输入侧还支持 --audio(wav/mp3/amr/aac/m4a/ogg/3gp/3gpp)与 --video(视频文件或逗号分隔的抽帧 URL);--message 可重复并用 role: 前缀组织多轮;--system 设定角色;--text-only 关闭语音输出。
bl omni --message "Answer in Sichuan dialect: How's the weather today?" --voice Sunny
四、编排与治理
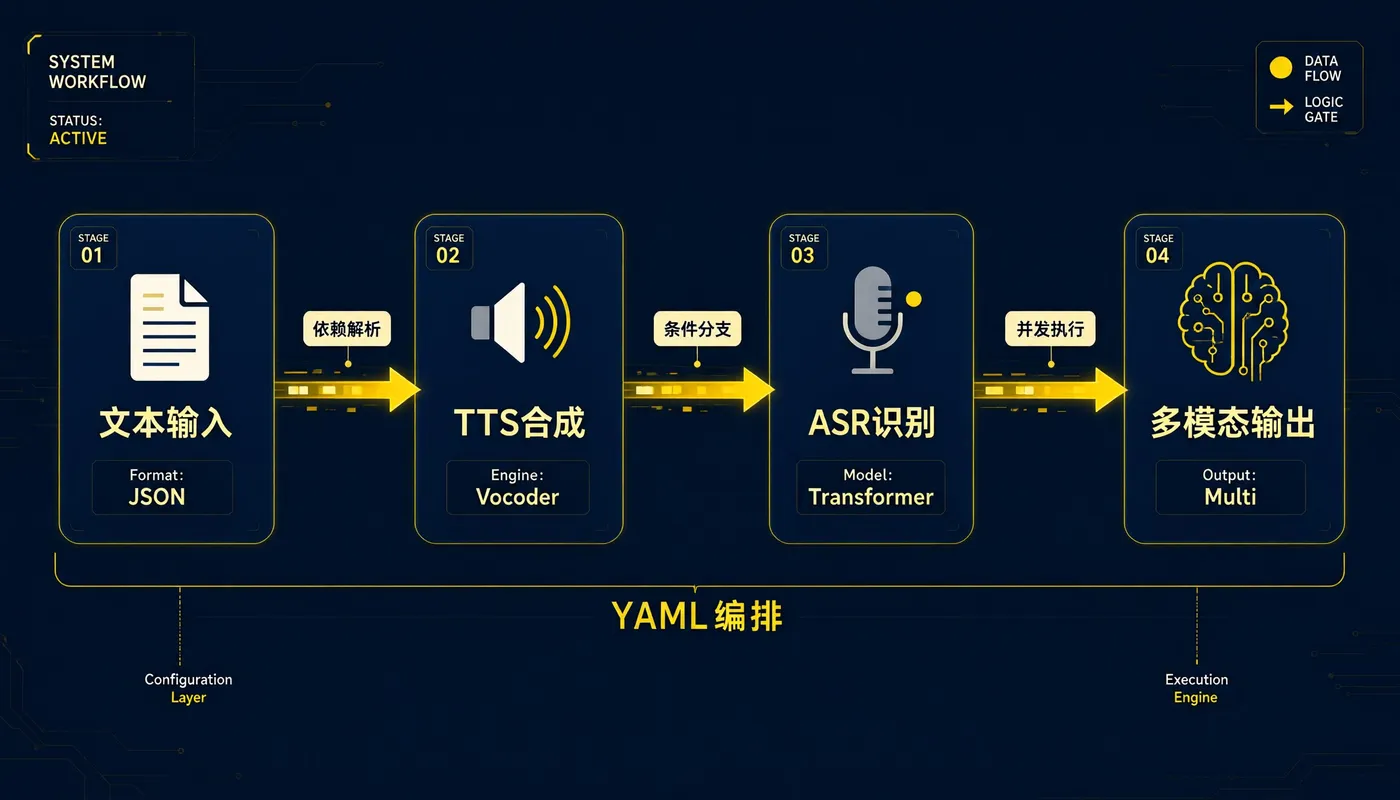
4.1 Pipeline:把三步串成一条流程
工作流定义是一个 YAML,骨架为 version: workflow/v1 加 steps 数组,步骤通过 {
{steps.<id>.output}} 引用上游产出:
version: workflow/v1
steps:
  - id: script
    type: text/chat
    input:
      message: "{
   {topic}}"
      system: "你是短视频口播文案作者。只输出口播稿正文,120字以内。"
  - id: voiceover
    type: speech/synthesize
    input:
      text: "{
   {steps.script.output}}"
      model: cosyvoice-v3-flash
      voice: longcheng_v3
      out: voiceover.mp3
步骤类型共 11 种:text/chat、vision/describe、image/generate、image/edit、video/generate、speech/synthesize、speech/recognize、script/js、logic/switch、logic/select、logic/assert。
bl pipeline validate --file voice-workflow.yaml
bl pipeline run --file voice-workflow.yaml --input '{"topic":"本地语音克隆工具的中文短板"}' --dry-run
bl pipeline run --file voice-workflow.yaml --input-file inputs.json --concurrency 3 --events events.jsonl
validate 只接受 --file。--dry-run 打印执行计划(Pipeline planned,逐步标注 planned),不调模型。--events 输出 JSONL 生命周期事件,可接入日志与监控;--step-timeout 为单步设置超时。pipeline 命令本身标注 No Auth、不直接产生费用,费用来自它调起的各步骤。
安全设计上有一处值得说明:script/js 步骤的 code 必须是字面字符串,校验器明确拒绝从上游步骤或表达式取代码,理由是那会把不可信文本当宿主机代码执行。需要在上游产出上做判断时,用 logic/assert(字段 condition,支持 {
{steps.X.output}} 插值)或 logic/switch。
典型的语音内容生产线可以这样编排:选题输入 → 文案生成 → 配音合成 → 素材转写 → 字幕校对 → 成品归档。
4.2 用量与额度治理
| 命令 | 用途 |
|---|---|
bl usage free |
查询各模型免费额度余量 |
bl usage summary |
额度 + 近期用量统一视图 |
bl usage stats |
模型用量统计,可接入内部报表 |
bl usage freetier --all |
为全部免费额度模型开启"用完即停" |
bl usage freetier --model <m> --off |
关闭指定模型的用完即停 |
bl quota list / bl quota check |
查看与核对 QPM/TPM 限流 |
bl quota update / bl quota request |
调整模型限流阈值 |
bl config show / bl config list / bl config use |
profile 与默认模型管理 |
新用户免费额度的规则需按官方口径理解:每个符合条件的模型各自一份(通常 100 万 token),有效期 90 天,仅华北2(北京)地域,过期不补发、不结转、不重置,模型之间不互相借用;已认证账号额度耗尽后自动转按量付费,开启"用完即停"后超额调用返回 HTTP 403 与错误码 AllocationQuota.FreeTierOnly。企业环境建议默认开启用完即停,再按业务逐个模型放开,避免试点期脚本把生产预算跑穿。
4.3 权限、工作空间与多团队隔离
bl workspace list
bl permission list
bl permission grant
bl permission revoke
permission 系列按推理、微调、部署三类权限分配,配合多工作空间可以把成本与权限归口到部门,这是多团队共用一套语音底座的前提。
4.4 从调用走向定制
bl finetune audio create
bl finetune price
bl finetune watch --follow
bl deploy audio create
bl deploy list
bl deploy scale
bl deploy pause
这条链路的意义在于:品牌音色、行业专属发音、特定方言风格可以从"选内置音色"升级到"训练自有音色并独占部署"。bl finetune price 可以在提交训练前估算成本,bl deploy pause 可以在非使用时段暂停部署、停止 mu/ptu 计费。
五、与开源生态的协同
语音领域的开源侧最近很活跃。以 VoiceStudio 为例:21.9k star,近一周新增约 7,499,提供声音克隆(短参考音频零样本)、声音设计、视频配音、听写转写与有声书制作,内部组合 16 个 TTS 引擎与 11 个 ASR 引擎、646 种语言目录,形态上包含 Tauri v2 桌面应用、FastAPI 后端、本地 REST/SSE/WebSocket 服务、OpenAI 兼容 audio API 与 MCP Server。GPU 为可选依赖,CPU 模式可运行,使用 GPU 时 4GB 显存起。
它 README 中自述的三个约束需要如实呈现:646 种语言的实际覆盖与音质取决于所选引擎;默认引擎权重为 CC-BY-NC(应用本体 AGPL-3.0),商用需逐个引擎核对许可;项目状态为 active beta,Intel Mac 无法运行本地 Python 后端。
两类方案在企业里通常并存,分工边界清晰:
| 维度 | 本地开源方案 | 百炼云端能力栈 |
|---|---|---|
| 数据出域 | 全程本地,不出域 | 走云端 API |
| 中文与方言音色 | 取决于所选引擎,需自行验证 | 64 个系统音色,含粤语 3、方言 3、童声 4 |
| 多模态语音交互 | 无此形态(音频向 + MCP/OpenAI 兼容 API) | 单次调用完成,13 个交互音色 |
| 声音克隆 | 强项,本地零样本克隆 | cosyvoice-clone-v1,音色 ID 由控制台侧生成 |
| 运维成本 | 自备算力、引擎选型、许可核对、版本维护 | 按量付费,免运维 |
| 成本模型 | 一次性硬件投入 | 合成 ¥0.8-2/万字符,识别 ¥0.00022/秒 |
| 定制路径 | 更换引擎 + 自行微调 | bl finetune audio create + bl deploy audio create |
对数据敏感、需要私有音色资产的场景,组合方式是:本地完成声音克隆与敏感素材处理,云端承担高并发的成品合成、识别与多模态交互。MCP 是两侧对接的现成接口:
bl mcp list
bl mcp tools
bl mcp call
六、不同角色的最短上手路径
- 内容团队:
bl speech synthesize --list-voices --model cosyvoice-v3-flash选音色 →--text-file批量出片 →bl usage stats做月度成本归口 - 企业 IT:
bl auth login --console→bl usage freetier --all开启用完即停 →bl quota list核对限流 →bl permission grant按团队分配权限 → 需要专属音色时走bl finetune audio create - 应用开发者:
bl omni验证多模态语音交互 →--stream接入实时推流 →bl pipeline run编排端到端流程,--events jsonl接入监控
三层能力共用一份凭证、一套计价视图、一个命令行入口,这是把语音需求从"三个项目"收敛成"一条链路"的关键。完整的模型清单可以在百炼控制台查看,也可以在终端直接检索:
bl model list --capability TTS
bl model list --capability ASR
bl model list --model qwen3.5-omni-plus




