
2026-08-26模型发布
Qwen3.8-Flash 上线千问AI平台:全新架构,迈向极致性价比
一、概览
Qwen3.8-Flash 现已上线千问AI平台,模型名称为 qwen3.8-flash,可直接通过 API 调用。它默认提供 1,000,000 token 上下文并内置官方工具,在能力、延迟和成本之间取得了较好的平衡,适用于高并发应用、工具驱动的工作流,以及编程与协同办公助手。
该模型的主模型参数量为 125B,额外配备 51B 的 N-gram Embedding,每 token 激活 6B 参数。相比于 Qwen3.7-Plus,其训练开销仅约为前者的 1/9,同时在编码和办公任务上具有更强的能力。
模型所采用的新架构以 Qwen3.8-Flash-Next 的形式同步发布开源权重,作为 Qwen4 所用模型结构的先导预览,围绕 Attention、Residual、Embedding 和 Optimization 四个方面对模型做了系统升级。完整技术介绍见 Qwen3.8-Flash-Next:全新架构,迈向极致性价比。
二、模型详情
Qwen3.8-Flash:面向高并发与智能体场景的高性价比模型
Qwen3.8-Flash 是 Qwen3.8-Flash-Next 架构的生产版本,在千问AI平台上以 1M 上下文与内置官方工具的形态提供服务。它同时支持文本与图像输入,具备思考模式与可调的推理强度,可直接用于长文档处理、多轮工具调用和跨应用的智能体任务。
极致稀疏的 MoE 设计让它在保持较大专家池的同时,每 token 只路由少量专家,因此在高并发场景下仍能维持较低的调用成本与延迟;GDN 与 QSA 组合的注意力结构则让它在长上下文下的吞吐随上下文增长仍保持优势。
模型详情:Qwen3.8-Flash
三、核心参数
| 项目 | 取值 |
|---|---|
| 模型名称 | qwen3.8-flash |
| 上下文长度 | 1,000,000 token(默认) |
| 输入模态 | 文本、图像 |
| 输出模态 | 文本 |
| 思考模式 | 支持,通过 enable_thinking 开启 |
| 推理强度 | reasoning_effort 支持 xhigh、medium、low |
| 接口协议 | 兼容 OpenAI 的 Chat Completions 与 Responses API,以及兼容 Anthropic 的接口 |
| 工具调用 | 支持并行工具调用,内置官方工具 |
最新的参数与调用限制以模型详情页为准。
四、模型能力与评测
以下评测结果为 Qwen3.8-Flash-Next 的公开评测数据,千问AI平台提供的 Qwen3.8-Flash 与其同源。完整评测设置与脚注见 Qwen3.8-Flash-Next 技术介绍。
编程与智能体任务
在智能体编程、仓库级代码生成、长周期办公与真实工具使用等任务上,模型在多项基准上取得了同规模激活参数下的领先结果,其中 DeepSWE 1.1、SWE-bench Pro、SWE-bench Multilingual、CoWorkBench、JobBench 与 Toolathlon Verified 均优于 Qwen3.7-Plus。
| 任务 | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 | Claude-Opus-4.6 (Max) |
|---|---|---|---|---|---|
| 智能体编程 DeepSWE 1.1 | 58.7 | 42.2 | 16.5 | 54.4 | -- |
| 智能体编程 SWE-bench Pro | 62.5 | 61.7 | 55.8 | 56.0 | 53.4 |
| 多语言软件工程 SWE-bench Multilingual | 81.0 | 73.8 | 75.8 | -- | 77.5 |
| 仓库级代码生成 NL2Repo-Bench | 48.1 | 42.3 | 41.1 | 54.2 | 47.6 |
| 长周期办公 CoWorkBench | 73.9 | 70.7 | 65.1 | 45.1 | 68.2 |
| 专业岗位任务 JobBench | 55.7 | 33.4 | 27.6 | 41.3 | 36.6 |
| 前沿智能体任务 Agents' Last Exam | Pass@1 24.3 / Score 51.2 | Pass@1 20.4 / Score 42.9 | Pass@1 13.2 / Score 33.6 | Pass@1 25.2 / Score -- | -- |
| 真实工具使用 Toolathlon Verified (Pass@1) | 73.5 | 67.1 | 50.6 | 70.3 | -- |
| 指令遵循 IFBench | 81.3 | 79.5 | 79.1 | 79.2 | 62.5 |
| 科学推理 GPQA Diamond | 91.7 | 89.2 | 90.3 | 90.8 | 91.3 |
| 跨学科推理 HLE | 35.9 | 30.8 | 34.7 | 33.8 | 40.0 |
| 竞赛编程 LiveCodeBench v6 | 91.9 | 90.3 | 89.6 | 90.6 | 88.8 |
DeepSWE 1.1、SWE-bench Pro、SWE-bench Multilingual 使用 Claude Code 与 mini-SWE-agent 评测框架,temp=1.0、top_p=0.95、上下文窗口 256K;CoWorkBench 为内部长周期办公与生产力智能体基准;HLE 由 GPT-4o 评判;空白单元格(--)表示分数尚不可用或不适用。
多模态理解与界面操作
在多模态工具使用、应用复现、移动端与桌面操作、视觉网页开发等任务上,模型相比 Qwen3.7-Plus 有明显提升,尤其在 OSWorld 2.0 与 Vision2Web 上差距较大。
| 任务 | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | Claude-Opus-4.6 (Max) |
|---|---|---|---|---|
| 多模态工具使用 ClawEval-MM | Pass@3 64.4 / 均分 60.4 | Pass@3 57.4 / 均分 56.9 | Pass@3 57.4 / 均分 60.1 | Pass@3 52.5 / 均分 54.7 |
| 应用复现 RecreationBench | 49.9 | 47.1 | 30.2 | -- |
| 移动端操作 AndroidWorld | 84.5 | 81.9 | 81.0 | 62.0 |
| 桌面操作 OSWorld 2.0 | Binary 19.4 / Partial 52.3 | Binary 19.4 / Partial 48.0 | Binary 2.8 / Partial 21.5 | -- |
| 视觉网页开发 Vision2Web | 64.0 | 62.9 | 42.1 | -- |
| 具身智能 ERQA | 72.3 | 65.5 | 69.8 | 40.8 |
| 长视频理解 LVBench | 76.6 | 72.4 | 76.2 | 63.0 |
| 真实世界感知 RealWorldQA | 88.5 | 85.9 | 86.9 | 73.9 |
| 视觉数学 MathVision | 不含 CI 90.6 / 含 CI 95.7 | 不含 CI 90.0 / 含 CI 94.6 | 不含 CI 90.3 / 含 CI 88.7 | 不含 CI 65.5 |
| 科学图表分析 CharXiv (RQ) | 不含 CI 84.6 / 含 CI 90.6 | 不含 CI 83.7 / 含 CI 90.2 | 不含 CI 85.8 / 含 CI 85.9 | 不含 CI 66.0 |
ClawEval-MM 以「pass@3 / 平均分」给出;OSWorld 2.0 以「binary / partial」给出;Vision2Web 取 frontend、webpage 与 website 三类平均;MathVision 与 CharXiv (RQ) 以「不含 CI / 含 CI」给出;空白单元格(--)表示分数尚不可用或不适用。
在 6B 激活参数下,其 Base 模型在 14 个预训练基准中的 8 个上取得最优结果,包括 MMLU-Pro、SuperGPQA、BBH、SWEBench-Pretrain、MGSM 与 MMMLU。
五、架构升级
Attention:GDN + QSA,高效记忆与精准检索
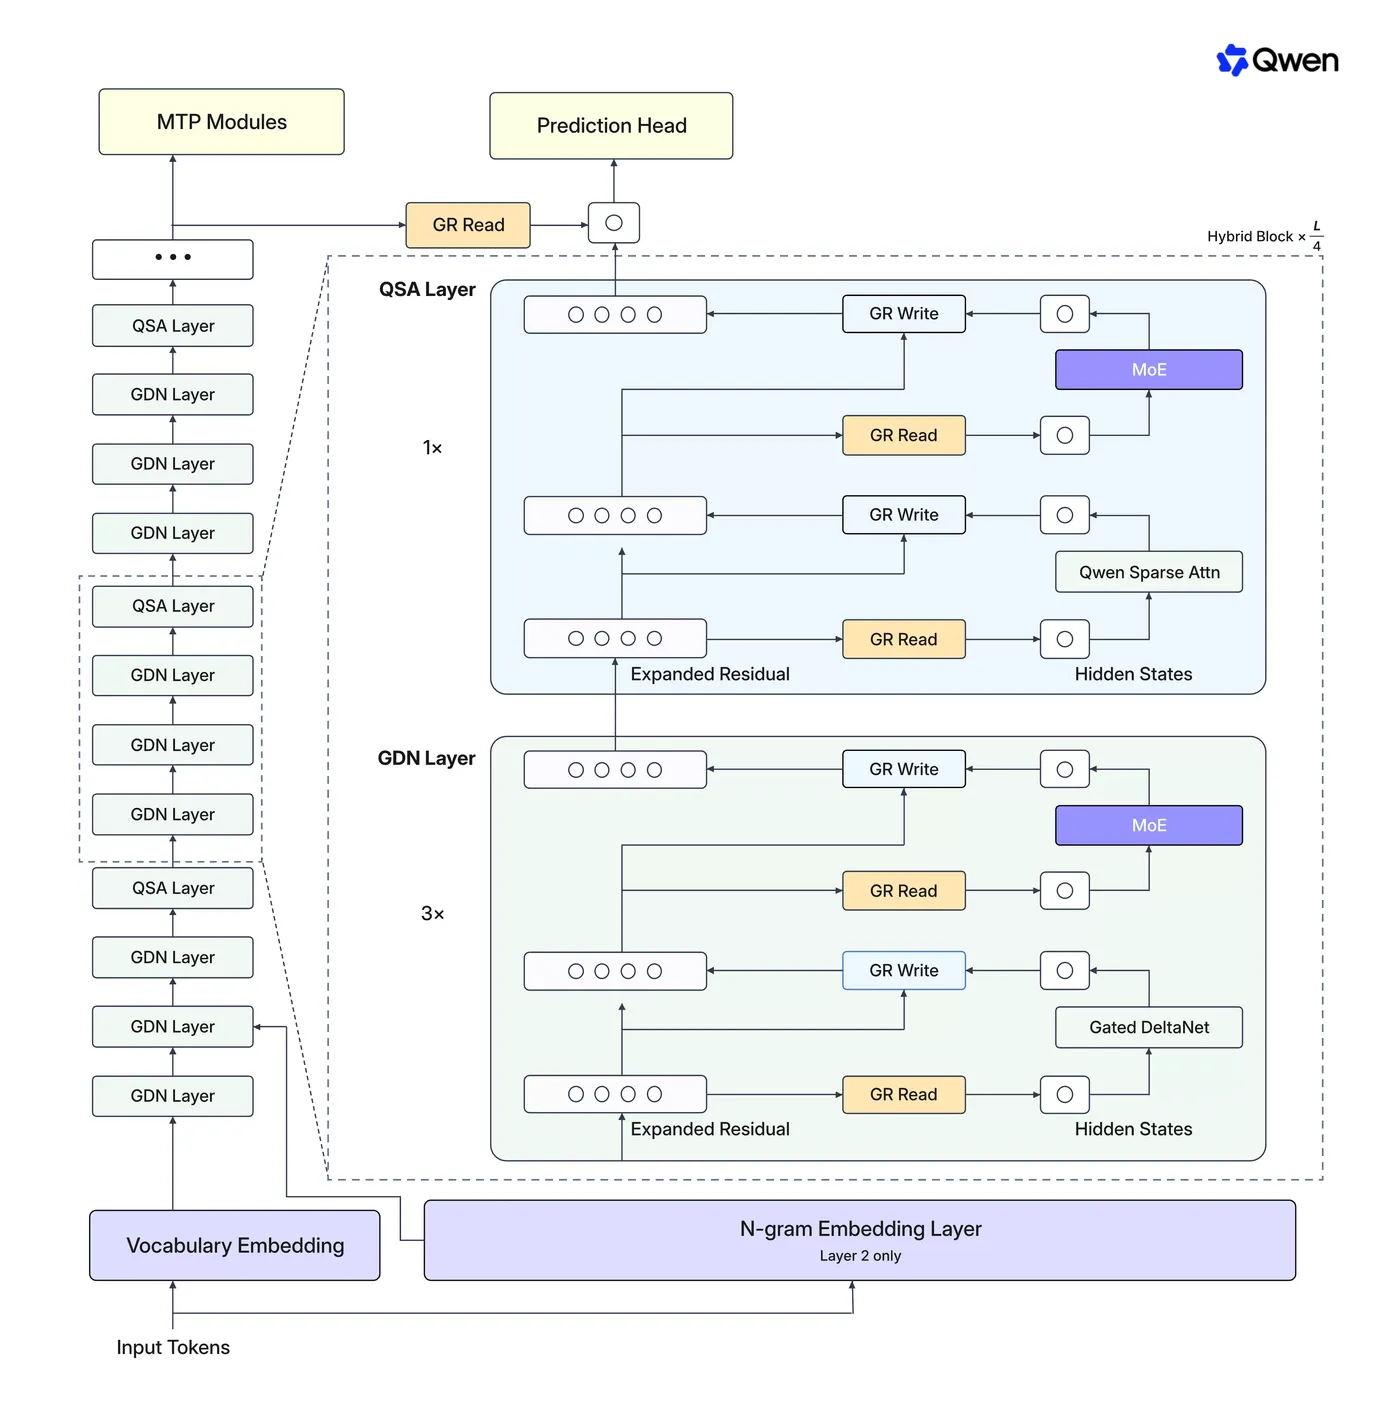
模型采用 Gated DeltaNet(GDN)与全局 Attention 的 Hybrid 架构:每四层中三层使用 GDN,将历史信息持续压缩到固定大小的状态中;另一层保留全局 Attention,负责精确检索全局信息。
全局 Attention 进一步引入 Qwen Sparse Attention(QSA)。轻量 indexer 先把序列聚合成 micro-block,在 block 粒度上估计上下文重要性,再选出最相关的区域执行 Attention,既减少了实际 Attention 的计算量,也显著降低了「寻找重要上下文」本身的 indexing 成本。可以简单理解为:GDN 负责高效「记住」,QSA 负责精准「查找」。
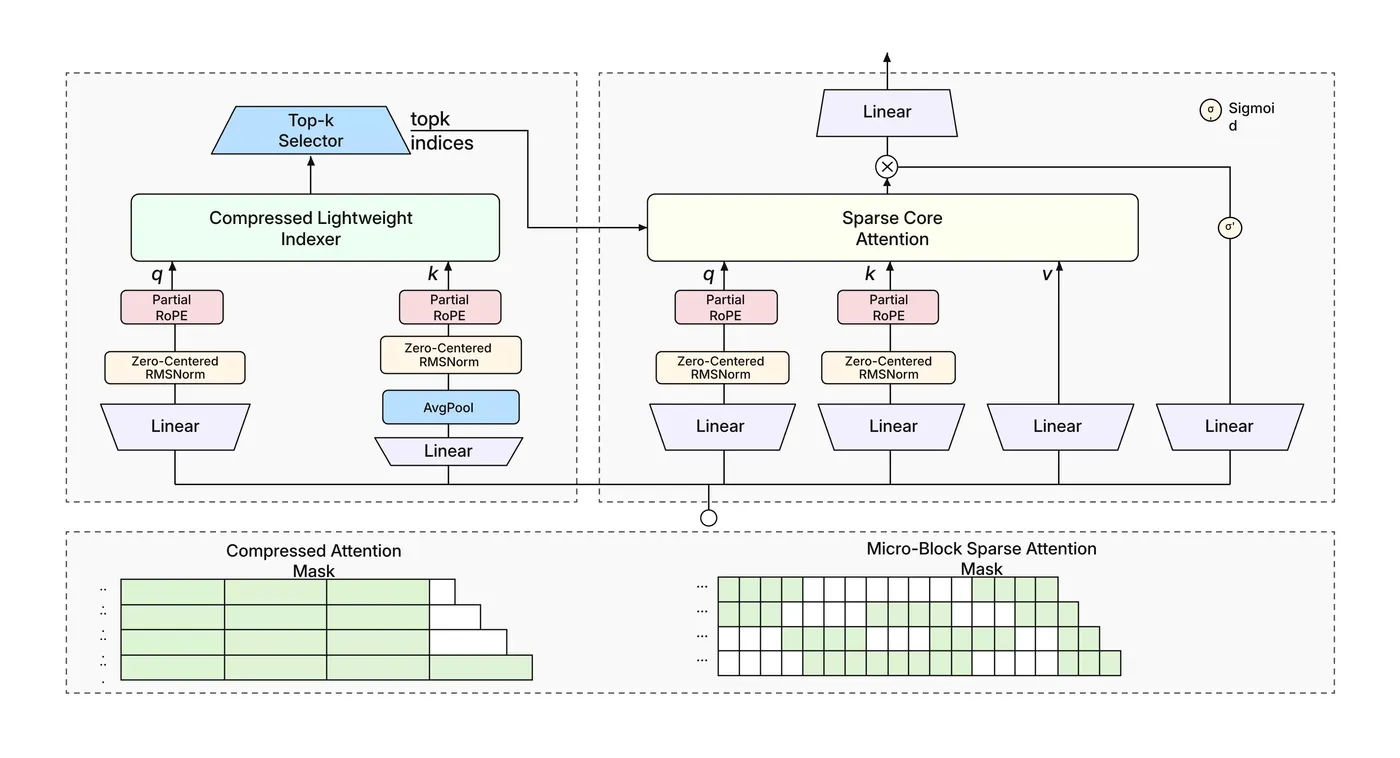
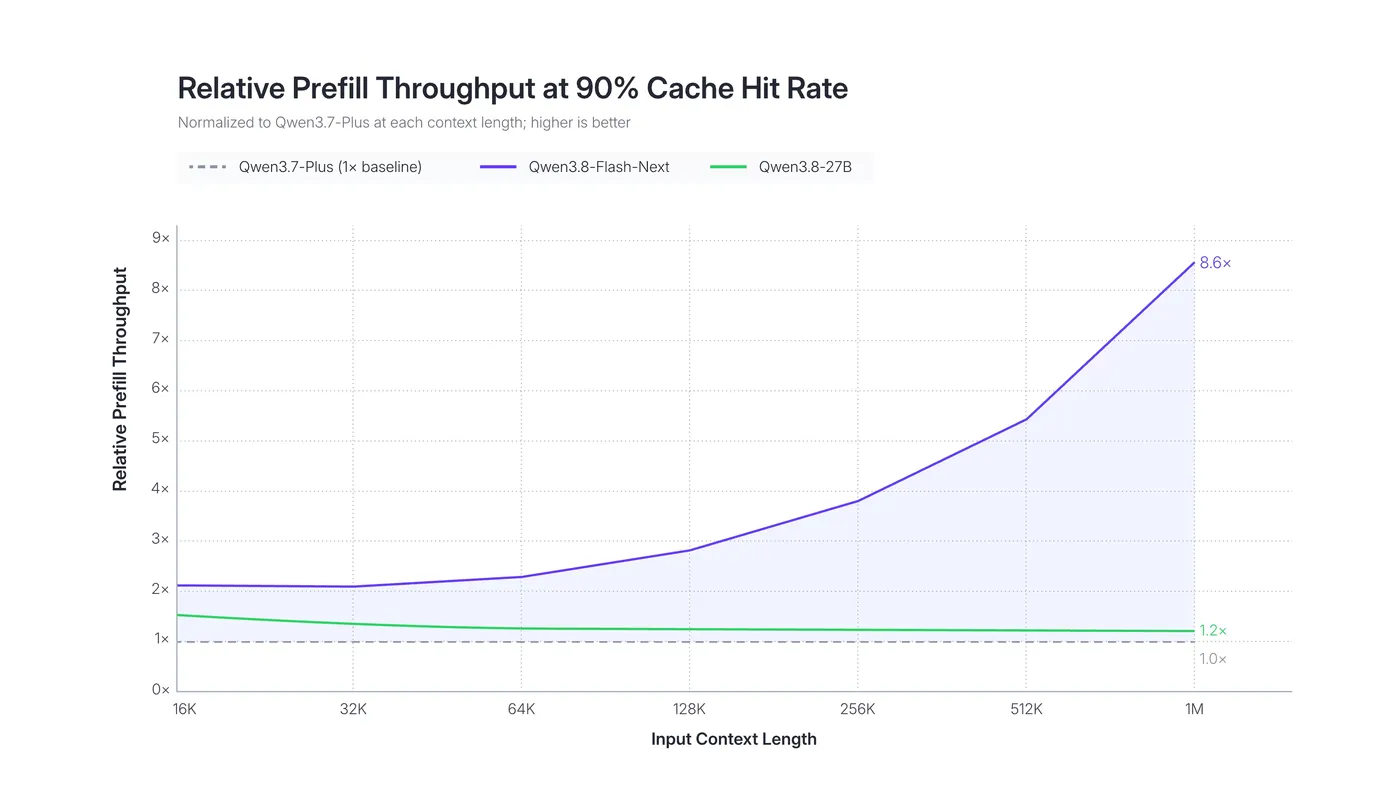
在 1M token 上,QSA 的 Attention Kernel 在 Prefill 和 Decode 阶段分别实现最高 7.6× 和 4.9× 的加速;在 90% Cache 命中率下,相对 Prefill 吞吐随上下文长度增长显著提升,在 1M context 下达到 Qwen3.7-Plus 的 8.6×。
Gated Residual:给信息更多传递路径
Gated Residual(GR)把原本单一的 residual stream 扩展成 4 条并行分支,模型可以根据当前内容动态决定从不同分支读取多少信息、向不同分支写入多少信息。相当于把一条信息通道扩展成多条车道:有些分支负责局部信息传递,有些则可以把早期信息直接保留到很深的网络层。归一化后的 Gate 同时能够抑制 activation outlier、提升训练稳定性,Residual State 还支持使用 FP8 存储以降低访存开销。
N-gram Embedding:低成本扩展模型容量
普通 Embedding 根据单个 token 查表,N-gram Embedding 则结合当前 token 与前几个 token 组成的局部上下文进行查表,为常见短语和局部模式提供额外表示,可以在几乎不增加每 token 计算量的前提下增加大量参数。模型额外引入了 51B N-gram Embedding 参数;由于查询位置可以提前确定,这些参数可以存放在 Host Memory 中,通过异步 Prefetch 与模型计算重叠,无需长期占用 GPU 显存。
Optimization:架构与优化协同设计
模型使用 Muon Optimizer 训练,并围绕正交化精度、Muon 与 AdamW 的参数分工,以及融合参数矩阵的拆分做了针对性优化:Attention、GDN 和 MoE Expert 中的主要权重使用 Muon,Embedding、MoE Router、GR 低秩参数等继续使用 AdamW;工程实现中融合存储的 QKV、SwiGLU 和 GDN Projection 先按实际对应的独立线性变换拆分,再分别执行正交化。针对新架构重新拟合 Scaling Law 后,模型可以稳定使用更大的 Learning Rate 和 Batch Size。
六、开发接入
API 调用
千问AI平台支持行业标准协议,包括兼容 OpenAI 的 Chat Completions 和 Responses API,以及兼容 Anthropic 的接口。API Key 可在千问AI平台获取。
01"""

02Environment variables:

03  DASHSCOPE\_API\_KEY: Your API Key from https://platform.qianwenai.com/home

04  DASHSCOPE\_BASE\_URL: (optional) Base URL for compatible-mode API.

05    - Beijing: https://dashscope.aliyuncs.com/compatible-mode/v1

06"""

07from openai import OpenAI

08import os

09

10api\_key \= os.environ.get("DASHSCOPE\_API\_KEY")

11if not api\_key:

12    raise ValueError(

13        "DASHSCOPE\_API\_KEY is required. "

14        "Set it via: export DASHSCOPE\_API\_KEY='your-api-key'"

15    )

16

17client \= OpenAI(

18    api\_key\=api\_key,

19    base\_url\=os.environ.get(

20        "DASHSCOPE\_BASE\_URL",

21        "https://dashscope.aliyuncs.com/compatible-mode/v1",

22    ),

23)

24

25messages \= \[{
   "role": "user", "content": "Write a Python function to merge two sorted linked lists."}\]

26

27completion \= client.chat.completions.create(

28    model\="qwen3.8-flash",

29    messages\=messages,

30    extra\_body\={


31        "enable\_thinking": True,

32    },

33    reasoning\_effort\="xhigh",  \# supported levels are xhigh, medium, and low

34    stream\=True,

35)

36

37for chunk in completion:

38    if not chunk.choices:

39        continue

40    delta \= chunk.choices\[0\].delta

41    if getattr(delta, "reasoning\_content", None):

42        print(delta.reasoning\_content, end\="", flush\=True)

43    if getattr(delta, "content", None):

44        print(delta.content, end\="", flush\=True)
智能体框架与编程助手
Qwen3.8-Flash 可直接接入主流智能体框架与编程助手。
Claude Code:千问AI平台支持 Anthropic API 协议,可直接配合 Claude Code 使用。
01npm install -g @anthropic-ai/claude-code

02

03export ANTHROPIC\_MODEL="qwen3.8-flash"

04export ANTHROPIC\_SMALL\_FAST\_MODEL="qwen3.8-flash"

05export ANTHROPIC\_BASE\_URL=https://dashscope.aliyuncs.com/apps/anthropic

06export ANTHROPIC\_AUTH\_TOKEN=<your\_api\_key>

07

08claude
Codex:千问AI平台支持 OpenAI Responses 协议。在 ~/.codex/config.toml 中把 base_url 指向 https://dashscope.aliyuncs.com/compatible-mode/v1、wire_api 设为 responses,并在 ~/.codex/model-catalog.local.json 中将 qwen3.8-flash 的 context_window 配置为 1000000,即可开始使用。
01npm install -g @openai/codex

02

03export OPENAI\_API\_KEY=<your\_api\_key>

04

05codex

**Qoder CLI**:[Qoder](https://qoder.com/) 与 Qwen 协同演进,专为智能体编程打造。

01curl -fsSL https://qoder.com/install | bash

02

03qoder

**Qwen Code**:[Qwen Code](https://qwen.ai/qwencode) 针对 Qwen 系列模型做了深度优化。

01npm install -g @qwen-code/qwen-code@latest

02

03qwen
OpenClaw:通过千问AI平台连接 OpenClaw,完整配置见开发者文档。
01curl -fsSL https://openclaw.ai/install.sh | bash

02

03export DASHSCOPE\_API\_KEY=<your\_api\_key>

04

05openclaw dashboard
七、立即体验
- 模型详情:Qwen3.8-Flash
- 立即体验:在线体验 Qwen3.8-Flash




