文章首发于 https://feinterview.poetries.top/blog/nextjs-sentry-feishu-alert
服务端报错只落在容器的 stdout 里,而容器日志是轮转的(--log-opt max-size),等有人在群里说「你那个页面白屏了」,我再去 docker logs,那段往往已经被冲掉了。浏览器端更彻底,压根看不见。更尴尬的是代码里那个组件级 ErrorBoundary,componentDidCatch 里只有一句 console.error,而生产构建开着 compiler.removeConsole,所以线上那个分支什么都没做,组件静默消失,没有任何人知道。
这周把这件事补上了:Sentry 收错误,飞书群收告警,卡片里直接带调用栈。整条链路从装包到上线跑通,中间踩了七八个坑,有几个是真的把我卡住了一阵,比如「本地怎么试都收不到上报」和「验签永远失败」。这篇就按我实际走的顺序记下来。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
@sentry/nextjs10.x 在Next.js 16里三端(client / server / edge)怎么接线,各自的入口文件放哪- 为什么本地
yarn dev收不到任何上报,以及这是我刻意做的 beforeSend脱敏层要防什么,以及怎么不发一条数据给 Sentry 就验证它生效了- Sentry 的
exception.values[].stacktrace.frames为什么顺序是反的,渲染进卡片前要怎么处理 - webhook 路由的完整实现:验签、payload 解析、堆栈渲染、推卡片,四段代码都给全
sentry-hook-signature验签失败,为什么多半是因为你用了JSON.stringify(req.body)- 飞书自建应用从建应用到发版怎么配:机器人能力、权限批量导入、事件订阅,以及配了不发版不生效
- 飞书推交互卡片的两个代码坑:
content必须是字符串、tenant_access_token必须缓存 - 集成建好了却在告警规则里选不到,是漏了哪个开关
next start在output: 'standalone'下直接不工作,本地怎么验生产行为- 上线后那两次「以为出事了其实没有」的误判,怎么用对照实验证伪
一、整体架构
先把链路画清楚,后面每个坑落在哪一段就有地方挂了:
浏览器                      我们的 Next.js 容器                   外部服务
┌──────────┐               ┌──────────────────────────────┐    ┌─────────────┐
│ 页面 JS  │               │ instrumentation.ts           │    │   Sentry    │
│          │──── 错误 ────▶│   register() 按 runtime 加载  │───▶│ (poetry-org)│
│ instrume-│   (直连或经   │   onRequestError 钩子         │    │             │
│ ntation- │   /monitoring │                              │    └──────┬──────┘
│ client   │    隧道)      │ src/libs/sentry/             │           │
└──────────┘               │   beforeSend 统一脱敏         │           │ 告警规则触发
                           │                              │           │ event_alert
                           │ /api/alerts/sentry-webhook   │◀──────────┘ (POST + 签名)
                           │   HMAC 验签 → 解析堆栈        │
                           │        │                     │    ┌─────────────┐
                           │        ▼                     │    │  飞书自建应用 │
                           │ server/notify/feishu.ts      │───▶│  告警群       │
                           │   token 缓存 + 节流 + 卡片    │    └─────────────┘
                           │ server/notify/alert.ts       │
                           │   邮件 + 飞书 并行扇出         │    ┌─────────────┐
                           │                              │───▶│  阿里企业邮   │
                           └──────────────────────────────┘    └─────────────┘
三件事值得先说清楚:
告警中转放在了自己的站点里,不是独立服务。少一套部署、少一份凭据,跟着现有 Docker 一起发版。代价是站点整个挂掉时这条通道也哑,但那个场景 Sentry 自带的邮件会兜底,而且站全挂通常比单个 issue 更早被别的方式发现。真正需要覆盖的是「站点活着但某个功能在报错」,那正是这条链路的主场。
邮件和飞书是并列的两条通道,不是替代关系。 飞书是「现在就有人看见」,邮件是「事后能翻到、能转发」。更关键的是它们的故障面不重叠,飞书挂了(换 token 失败、频控、应用被停用)邮件照发,SMTP 挂了飞书照发。告警系统最怕的就是出事的时候它自己也哑了,多一条独立通道比把单条做得更可靠划算。
卡片里必须有堆栈。 这是我第一版做漏的,当时卡片只有一行 位置: app:///src/app/(web)/(routes)/blog/page.tsx,看到告警还得去开 Sentry,那这条推送的价值就打了对折。
二、20 分钟跑通最小可用版本
下面这套是我实际跑通的顺序,环境是 Next.js 16.3.1 + @sentry/nextjs 10.74.0 + Node 22.23.1,output: 'standalone',部署在腾讯云 Docker 容器里。
Step 1:装包,注意 yarn 缓存这个坑
yarn add @sentry/nextjs
我第一次跑这条命令,终端最后打了 exit code 0,看起来是成功的。结果 node_modules/@sentry/nextjs 根本不存在,package.json 里也没有这一行。回头翻完整日志才看到藏在一堆 peer dependency warning 后面的这句:
error Error: ENOENT: no such file or directory, open '/Users/mac/Library/Caches/Yarn/v6/npm-@sentry-cli-darwin-2.58.6-.../node_modules/@sentry/cli-darwin/.yarn-metadata.json'
@sentry/cli-darwin 在 yarn 全局缓存里的那份元数据坏了。yarn 1.x 在这种情况下会报错但仍然退出 0,这个组合非常坑,你以为装好了其实什么都没发生。清掉那一份缓存重来就好:
rm -rf "$HOME/Library/Caches/Yarn/v6/npm-@sentry-cli-darwin-2.58.6-"*
yarn add @sentry/nextjs
装完记得 node -p "require('@sentry/nextjs/package.json').version" 确认一下,别只看 exit code。
Step 2:三端接线,文件位置不能放错
@sentry/nextjs 在 App Router 下有三个入口,位置是 Next 规定的,放错地方不会报错,只会静默不生效,这一点很要命。
浏览器端是 src/instrumentation-client.ts(和 src/app 同级):
import * as Sentry from '@sentry/nextjs'

import {
    initSentryClient } from '@/libs/sentry'

initSentryClient()

// 不接这个的话,App Router 的软导航在 Sentry 里完全看不到,
// 所有页面的性能数据都会算到首次进站的那个 pageload 上
export const onRouterTransitionStart = Sentry.captureRouterTransitionStart
服务端和 edge 各自是仓库根目录的 sentry.server.config.ts / sentry.edge.config.ts,由 src/instrumentation.ts 按 runtime 动态加载:
export async function register() {

  // 必须动态 import:这两个配置文件分别只在对应 runtime 下可用,
  // server 那份会拉进 node: 内置模块,顶层引会让 edge 编译直接失败
  if (process.env.NEXT_RUNTIME === 'nodejs') {

    await import('../sentry.server.config')
  }
  if (process.env.NEXT_RUNTIME === 'edge') {

    await import('../sentry.edge.config')
  }
  // …原有逻辑
}

// Next 15+ 提供的服务端请求出错钩子,RSC 和 route handler 都走它。
// 名字是 Next 约定的,不能改、也不能包一层
export const onRequestError = Sentry.captureRequestError
onRequestError 是我觉得最值回票价的一个。接上之前,服务端渲染阶段抛的错只有容器 stdout 知道;接上之后它和浏览器端错误进同一个项目,按 runtime tag 区分。
Step 3:包一层再给业务用
我没让业务代码直接 from '@sentry/nextjs',而是全部收到 @/libs/sentry 后面。这层隔离换来两件事:未 init 时所有调用自动 no-op,业务侧一行防御都不用写;所有出站数据都过同一份脱敏规则,不会有哪条路径漏掉。
function isInitialized(): boolean {

  try {

    return !!Sentry.getClient()
  } catch {

    return false
  }
}

export function captureException(error: unknown, options?: CaptureOptions): void {

  if (!isInitialized()) return
  Sentry.captureException(error, {
    tags: options?.tags, level: options?.level ?? 'error' })
}
然后把三层错误边界都接上:路由级 error.tsx、根级 global-error.tsx、组件级 ErrorBoundary。三者打不同的 boundary tag,因为严重程度差很远,global 意味着整站白屏,component 只是黑掉一块。
error.tsx 里有个细节值得单独说:生产构建下服务端错误的 message 会被 Next 抹掉,只留一个 digest。不把它带上的话,Sentry 上就是一条光秃秃的 An error occurred in the Server Components render,等于没有信息。
useEffect(() => {
  captureException(error, {
    tags: { boundary: 'route', ...(error?.digest ? { digest: error.digest } : {}) }
  })
}, [error])
三、为什么本地 yarn dev 收不到任何上报
接完之后我本地跑 yarn dev,手动抛错,Sentry 上一条都没有。折腾了一会儿才想起来,这是我自己写的门禁:
export function initSentryClient() {

  if (process.env.NODE_ENV !== 'production') return
  if (process.env.NEXT_PUBLIC_SENTRY_DISABLED === 'true') return
  const dsn = process.env.NEXT_PUBLIC_SENTRY_DSN
  if (!dsn) return
  // …
}
这条门禁我建议你也加。理由不是「怕吵」那么简单:dev 下 React StrictMode 会双跑、HMR 会抛一堆模块替换期的临时错误,混进去之后线上真实错误的趋势图就没法看了。宁可本地验证麻烦一点。
那本地怎么验?不能用 yarn start。 我一开始就是这么试的,得到的是:
⚠ "next start" does not work with "output: standalone" configuration. Use "node .next/standalone/server.js" instead.
output: 'standalone' 下必须跑 standalone 产物,而且要手动把 .env、.next/static、public 补进去,因为那三样构建时不会自动拷:
yarn build
cp .env .next/standalone/.env
cp -R .next/static .next/standalone/.next/static
cp -R public .next/standalone/public
cd .next/standalone && PORT=3111 node server.js
这一串我后来直接写进了仓库的运维手册,省得下次再想。
四、脱敏这层不能省,我是怎么验的
这个站有几样东西绝对不能进第三方系统。最要命的是登录落地页会带 ?token=xxx&_t=yyy,而这个 URL 会同时出现在 breadcrumb、event.request.url、navigation span 和 transaction 名里,只洗其中一处等于没洗。其次是 AI 助手和模拟面试的请求体,里面是用户写的简历和回答。
所以三端 init 都挂同一组 hook,保证不管哪条路径产生的事件,出站前都被同一份规则洗过一遍:
Sentry.init({

  dsn,
  dataCollection: {

    userInfo: false,
    cookies: false,
    httpHeaders: {
    request: false, response: false },
    httpBodies: [],        // 空数组 = 一条 body 都不收,不是「用默认值」
    urlQueryParams: false,
    stackFrameVariables: false
  },
  beforeBreadcrumb,        // console 类整条丢掉
  beforeSend: sanitizeEvent,
  beforeSendTransaction: sanitizeEvent,
  beforeSendSpan: sanitizeSpan,
  beforeSendLog: sanitizeLog
})
extra 我是整个删掉的,不做逐字段清洗。它是最容易「顺手塞一整个对象」的字段(extra: { config, response }),而那个对象的形状是调用方决定的、随时会变,白名单在这里维护不住。需要额外上下文就用 tags。
写 beforeSend 的时候踩了个 TypeScript 的坑。我一开始把堆栈帧类型写成 Record<string, unknown>,然后收到一屏几十行的类型错误,最后一句是:
Type 'StackFrame' is not assignable to type 'Record'. Index signature for type 'string' is missing in type 'StackFrame'.
Sentry 的 StackFrame 是具名属性接口、没有索引签名,结构化类型检查会拒绝赋值。后果不是报个错那么简单,是整个 beforeSend 挂不上去,脱敏静默失效。改成具名的 interface StackFrameLike { filename?: string; abs_path?: string; vars?: unknown } 就好了。
不发一条数据给 Sentry,怎么证明脱敏生效了
这是我觉得这次最值得分享的一个小技巧。直接发到线上项目去看,既污染数据又慢。更好的办法是把 DSN 指向一个本地的假接收端,DSN 的 host 和端口本来就是可以随便改的:
# 起一个假 Sentry,把收到的 envelope 打出来
node -e "require('http').createServer((q,r)=>{let b='';q.on('data',c=>b+=c);\
q.on('end',()=>{console.log(b);r.end('{}')})}).listen(3222)" &

# key 随便填,路径最后那个数字是 project id
SENTRY_DSN='http://anykey@127.0.0.1:3222/1' PORT=3111 node server.js
然后访问一个会抛错的页面,还故意在 URL 上挂个 ?token=SHOULD_BE_STRIPPED。假接收端打出来的东西是这样的:
>>> 收到上报: POST /api/1/envelope/?sentry_version=7&sentry_key=...
    type      : exception
    title     : Error : dev-only: preview error page
    tags      : {"site":"feinterview","runtime":"nodejs"}
    request   : {"method":"GET","url":"http://127.0.0.1:3111/dev-error-preview"}
    有 extra?: false
?token=SHOULD_BE_STRIPPED 被整段剥掉了,extra 字段不存在,tag 也挂上了。三件事一次性验完,全程零网络请求发给 Sentry。这个方法后来我又用了一次,见第五节。
五、Sentry 的调用栈是反的
要把堆栈渲染进飞书卡片,得先从 webhook payload 里把它挖出来。告警触发的 event_alert 里,异常在 data.event.exception.values[].stacktrace.frames。
我原本以为这就是个遍历拼字符串的活儿,直到把渲染结果打出来看了一眼。Sentry 的 frames 是按调用顺序存的,最外层在前、崩溃点在最后,和所有人读堆栈的习惯正好相反。不处理的话,群里看到的第一行是 node:internal/...,真正出错那行被挤到第八行开外。
还有两个处理是实际看了真实数据才加的。我用上一节那个假接收端抓了一条应用真实发出的异常,10 帧里有 5 帧是 in_app,另外 5 帧全是 next-server/app-page.runtime.prod.js。这就是为什么要优先取 in_app:
function renderStack(exception: SentryExceptionValue): string {

  const frames = exception.stacktrace?.frames
  if (!Array.isArray(frames) || !frames.length) return ''

  // 优先 in_app;一帧都没标记时才退回全量。取最后 8 帧再倒过来
  const inApp = frames.filter((frame) => frame.in_app)
  const picked = (inApp.length ? inApp : frames).slice(-MAX_FRAMES).reverse()

  return picked
    .map((frame, index) => {

      const where = `${
     frame.filename}:${
     frame.lineno ?? '?'}:${
     frame.colno ?? ''}`
      const head = `  at${
     frame.function ? ' ' + frame.function : ''} (${
     where})`
      // 只给最靠近崩溃点的那一帧附源码原文,多了太吵
      return index === 0 && frame.context_line ? `${
     head}\n      → ${
     frame.context_line.trim()}` : head
    })
    .join('\n')
}
第三个细节是异常链。values 是个数组,约定是最外层在前、最原始的在后,所以取的是 values[values.length - 1]。取第一个的话你拿到的往往是一句 An error occurred in the Server Components render,没有信息量。
最后渲染出来是这样,这是真实跑出来的,不是我编的示例:
【报错】Error: dev-only: preview error page
【调用栈(从崩溃点往外)】
  at ? (app:///_next/server/app/dev-error-preview/page.js:1:10383)
  at ? (app:///_next/server/chunks/7688.js:5:45369)
  at b.handleCallbackErrors (app:///_next/server/chunks/7688.js:12:91635)
函数名是 ?、行号是 :1:10383,因为我当时还没配 source map 上传。配上 SENTRY_AUTH_TOKEN + SENTRY_ORG + SENTRY_PROJECT 之后这里会变成真实的文件名、函数名和行号。这三个缺任意一个就跳过上传,构建照常绿,所以很容易忘。
顺带一提,deleteSourcemapsAfterUpload 千万别关。.next/static 里留着 .map 等于把源码公开,任何人都能从浏览器直接下载。
六、webhook 路由完整实现,以及为什么你的验签一直失败
Sentry 的 webhook 签名算法本身很简单,Sentry-Hook-Signature = HMAC-SHA256(body, Client Secret) 的 hex。官方文档给的示例是这样的:
const hmac = crypto.createHmac('sha256', secret)
hmac.update(JSON.stringify(request.body), 'utf8')
const digest = hmac.digest('hex')
照抄这段大概率会验不过。 JSON.stringify(request.body) 是把框架解析后的对象重新序列化,键顺序、空格、Unicode 转义都可能和 Sentry 发过来的原始字节不一样,签名自然对不上。而报错只会说「验签失败」,很难想到根因在这儿。
正确做法是拿原始 body 字符串。Next.js 的 Route Handler 里就是 await request.text():
export async function POST(request: Request) {

  const secret = env.SENTRY_WEBHOOK_SECRET
  // 没配 secret 时拒绝而不是放行。这个端点会往内部群发消息,
  // 放行等于给了任何人一个免费的推送入口
  if (!secret) return new NextResponse('not configured', {
    status: 401 })

  const rawBody = await request.text()
  const signature = request.headers.get('sentry-hook-signature')
  if (!verifySignature(rawBody, signature, secret)) {

    return new NextResponse('unauthorized', {
    status: 401 })
  }
  // …
}
比较用 timingSafeEqual 而不是 ===,成本只有两行。这里又碰到一个类型问题:@types/node 的 Buffer 和 TS 内置 lib 的 ArrayBufferView 在当前版本组合下对不上,crypto.timingSafeEqual(Buffer.from(a), Buffer.from(b)) 会报 TS2345。换成 TextEncoder 产出的 Uint8Array 两边都认,行为完全一样:
const encoder = new TextEncoder()
const received = encoder.encode(signature)
const expected = encoder.encode(crypto.createHmac('sha256', secret).update(rawBody, 'utf8').digest('hex'))
// 长度不同直接返回:timingSafeEqual 对长度不等会抛错,不是返回 false
if (received.length !== expected.length) return false
return crypto.timingSafeEqual(received, expected)
返回码的语义也值得定清楚。验签失败回 401;payload 解析不出来、被去重、飞书没配,一律回 200。中间那档必须是 200,因为 Sentry 对非 2xx 会重试,而解析不了的 payload 重试多少次还是解析不了,只会变成一轮无意义的重试风暴。
第二步,把 payload 拍平成一个摘要
Sentry 的 event 序列化形态不止一种,取决于这条是哪个资源发出来的。告警规则触发的走 data.event,issue 类的走 data.issue,指标告警又是另一套字段。与其在渲染的地方到处判空,不如先统一拍成一个自己的结构:
interface AlertSummary {

  title: string
  level: FeishuAlertLevel
  environment: string
  release: string
  culprit: string
  url: string
  ruleName: string
  issueKey: string   // 去重用,优先 issue id
  errorText: string  // TypeError: xxx is not a function
  stack: string      // 渲染好的调用栈
}

function summarize(payload: Record<string, unknown>): AlertSummary | null {

  const data = payload?.data as Record<string, unknown> | undefined
  if (!data) return null

  const event = data.event as SentryAlertEvent | undefined
  if (event) {

    const {
    errorText, stack } = renderException(extractExceptionValues(event))
    return {

      title: event.title || event.message || 'Sentry 告警',
      level: toAlertLevel(event.level),
      environment: event.environment || '-',
      release: event.release || '-',
      culprit: event.culprit || '-',
      url: event.web_url || event.issue_url || '',
      ruleName: String(data.triggered_rule ?? ''),   // 规则名,[P0] 前缀从这来
      issueKey: String(event.issue_id ?? event.web_url ?? event.title ?? ''),
      errorText,
      stack
    }
  }
  // …issue / metric_alert 两个分支同理,取不到堆栈就给空字符串
  return null
}
tags 有个小坑:它在 payload 里是 [key, value][] 的二元组数组,不是对象,直接 event.tags.environment 拿不到东西。我写了个 tagOf(tags, key) 去 find。
第三步,拼卡片推出去
拿到摘要之后,剩下的就是组装。这里有个刻意的设计:报错原文放在最后一行,紧挨着下面的堆栈块,读起来是连贯的一段。标题里其实也有它,但标题会被截到 140 字,长 message 看不全。
const isP0 = summary.ruleName.startsWith('[P0]')
const lines = [
  `**级别**:${
     summary.level}${
     isP0 ? ' · **P0**' : ''}`,
  `**环境**:${
     summary.environment}`,
  `**版本**:${
     summary.release}`,
  `**位置**:${
     summary.culprit}`,
  summary.ruleName ? `**规则**:${
     summary.ruleName}` : '',
  summary.errorText ? `**报错**:${
     summary.errorText}` : ''
].filter(Boolean)

const ok = await sendFeishuAlert({

  alertKey: `sentry:${
     summary.issueKey}`,     // 按 issue 去重
  title: summary.title,
  lines,
  level: summary.level,
  // 堆栈取不到时整块不渲染,卡片自动退化成没有堆栈那一版
  code: summary.stack ? {
    title: '调用栈(从崩溃点往外)', body: summary.stack } : undefined,
  link: summary.url ? {
    text: '在 Sentry 中查看', url: summary.url } : undefined,
  force: isP0                                  // P0 不吃节流
})

// ok === false 有两种可能:被节流(正常)和推送失败(异常)。
// 这里不区分,统一回 200。回 502 会让 Sentry 重试,而被节流的那条
// 重试多少次都还是会被节流,纯属浪费
return NextResponse.json({
    ok, deduped: !ok })
去重我没有单独维护一张表,直接复用了飞书那层按 alertKey 的 30 分钟节流。两套窗口会互相干扰,排查「为什么这条没发」时要同时看两处,而它们给出的答案还可能不一致。
最后是飞书卡片本身。堆栈用 plain_text 渲染是关键的一处,lark_md 会把堆栈里的 *、[、( 当 markdown 吃掉:
const card = {

  config: {
    wide_screen_mode: true },
  header: {

    template: TEMPLATE_BY_LEVEL[level],     // fatal/error 红,warning 橙,info 蓝
    title: {
    tag: 'plain_text', content: `${
     EMOJI_BY_LEVEL[level]} ${
     input.title}`.slice(0, 140) }
  },
  elements: [
    {
    tag: 'div', text: {
    tag: 'lark_md', content: input.lines.join('\n') } },
    ...(input.code?.body
      ? [
          {
    tag: 'hr' },
          {
    tag: 'div', text: {
    tag: 'lark_md', content: `**${
     input.code.title}**` } },
          // plain_text:原样渲染,不做 markdown 解析
          {
    tag: 'div', text: {
    tag: 'plain_text', content: truncateBlock(input.code.body) } }
        ]
      : []),
    ...(input.link
      ? [{
    tag: 'action', actions: [{
    tag: 'button', text: {
    tag: 'plain_text', content: input.link.text }, type: 'primary', url: input.link.url }] }]
      : [])
  ]
}
truncateBlock 是按行截断而不是按字符。直接 slice 会把最后一帧砍成半句,看起来像数据损坏;按行切至少每一帧都是完整的。上限我定在 1800 字符,不是因为飞书装不下(单条消息上限约 30KB),是因为群里刷过去二十屏堆栈和没推是一样的效果。
拼出来的卡片长这样,这是线上真实告警,不是示意图:

级别、环境、版本(commitHash)、位置、触发的规则名、报错原文,然后一条分割线下面是从崩溃点往外的调用栈,最后一个按钮直达 Sentry。看到这张卡基本就能判断要不要立刻处理,不用先去开控制台。
怎么在本地验这整条
不用等 Sentry 真的给你发告警。我的做法是让应用真实报一次错,用第四节那个假接收端抓下它发出的 envelope,再把里面的 exception 原样塞进一条 webhook 报文重放,这样堆栈是真的,不是手写的假数据:
const ev = JSON.parse(fs.readFileSync('/tmp/real-event.json', 'utf8'))
const primary = ev.exception.values.at(-1)
const payload = {

  action: 'triggered',
  data: {

    triggered_rule: '[P1] 新错误',
    event: {

      issue_id: 'local-replay',
      title: `${
     primary.type}: ${
     primary.value}`,
      level: ev.level,
      environment: ev.environment,
      exception: ev.exception          // 关键:原样带上真实堆栈
    }
  }
}
const body = JSON.stringify(payload)
const sig = crypto.createHmac('sha256', SECRET).update(body, 'utf8').digest('hex')
await fetch(url, {
    method: 'POST', headers: {
    'sentry-hook-signature': sig }, body })
我用这个脚本验了四种情况:真实 secret 返回 {"ok":true,"deduped":false} 且卡片送达;同一个 issue 再发一次返回 {"ok":false,"deduped":true};规则名换成 [P0] 开头能绕过节流重新推;故意改成错的 secret 返回 401 unauthorized。四条都对上了才敢发版。
七、集成建好了,却在告警规则里选不到
Sentry 这边要建一个 Internal Integration。入口在组织 Settings → Developer Settings → Custom Integrations,右上角 Create New Integration,类型选 Internal Integration:

Public Integration 是给要上架给所有 Sentry 用户装的场景用的,我们这种自己组织内部用的一律选 Internal。
下一步的表单里,有一个开关是决定成败的,叫 Alert Action(注意不叫 Alert Rule Action,我一开始按后者去找找了半天):

不打开它,这个集成根本不会出现在告警规则的 action 列表里,而界面上看不出任何原因,你只会觉得「我明明建好了啊」。它还有个前置条件:得先填了 Webhook URL 才点得开,描述里那句 "The notification destination is the Webhook URL specified above" 说的就是这个依赖。
往下是权限。收告警只需要两个 Read,其余一律 No Access:
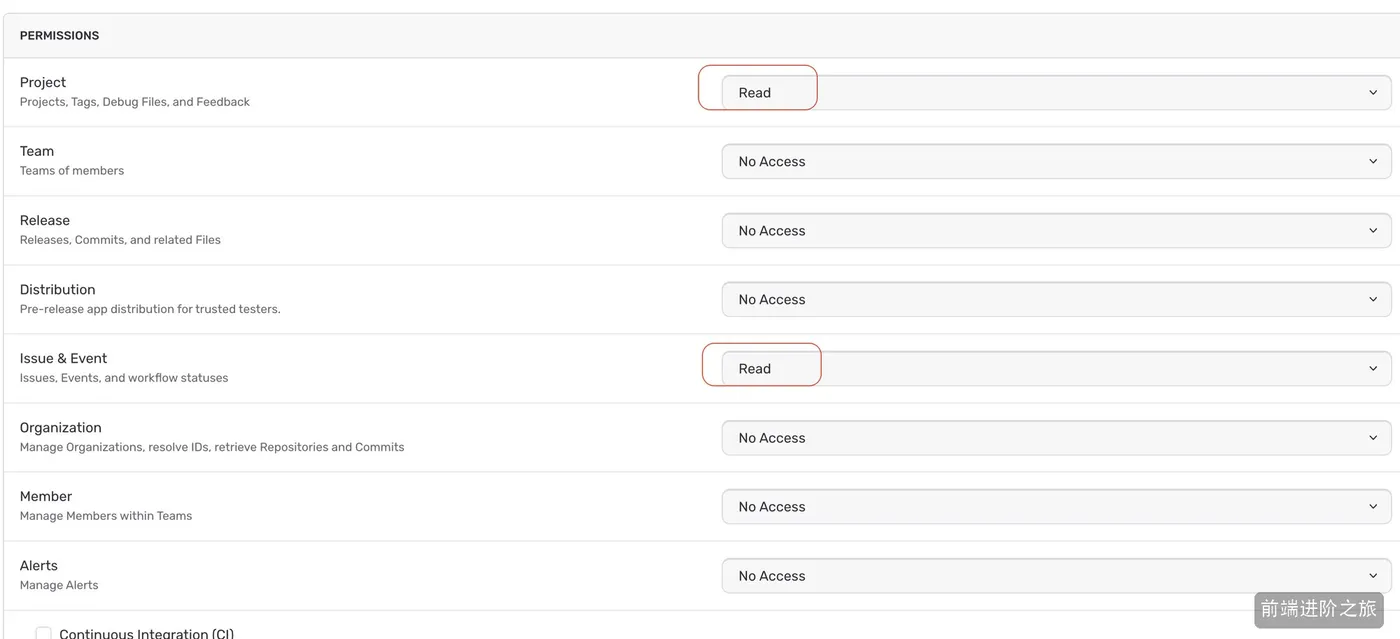
Alerts 那一项特别容易误勾,它管的是「创建和修改告警规则」的写权限,接收告警根本用不到,保持 No Access 就行。
另一个坑方向相反,是不该勾的勾了。表单再往下的 Webhooks 那一组里有个 Errors → Created,看名字很像我们要的东西,实际上它是 firehose,对每一条错误事件都推一次,既绕开告警规则、也绕开规则名分级。线上有真实流量时会把群刷爆。我们要的 event_alert 是由 Alert Action 开关提供的,跟那组勾选框没关系。
所以正确配置是这样:
| 字段 | 值 |
|---|---|
| Name | feinterview-feishu(会出现在告警规则的 action 下拉里) |
| Webhook URL | https://你的域名/api/alerts/sentry-webhook |
| Alert Action | 打开 |
| Permissions → Project | Read |
| Permissions → Issue & Event | Read |
| 其余 Permissions(含 Alerts) | No Access |
| Webhooks → Errors | 不勾 |
Client Secret 在保存后的 Credentials 区域,只显示一次,页面上写着 "Your secret is only available briefly after integration creation"。我截图存了一份,下次刷新回去就只剩 hidden 了,丢了只能 Rotate 重新生成再改配置发版。
告警规则那边,我用规则名前缀做分级,[P0] 开头的在中转服务里跳过节流、每次触发都推,其余走 30 分钟去重。还有一条容易忘的:给「新错误」那条规则加一个排除条件,把项目里那种「每次访问必抛错」的调试路由排掉,不然爬虫扫到就会一直推。
八、飞书自建应用怎么配,以及那个「配了不生效」的坑
我用的是自建应用而不是群机器人 webhook。群机器人一个 URL 就能发,看起来更省事,但它有两个硬伤:webhook URL 本身就是凭据,泄露了谁都能往群里发;而且它只能发到创建它的那个群,以后想加一个「只收 P0」的群就得再申请一个。自建应用拿到的是 tenant_access_token,发给谁由 receive_id 决定,以后要分群、要私聊到人,都是换一个 id 的事。
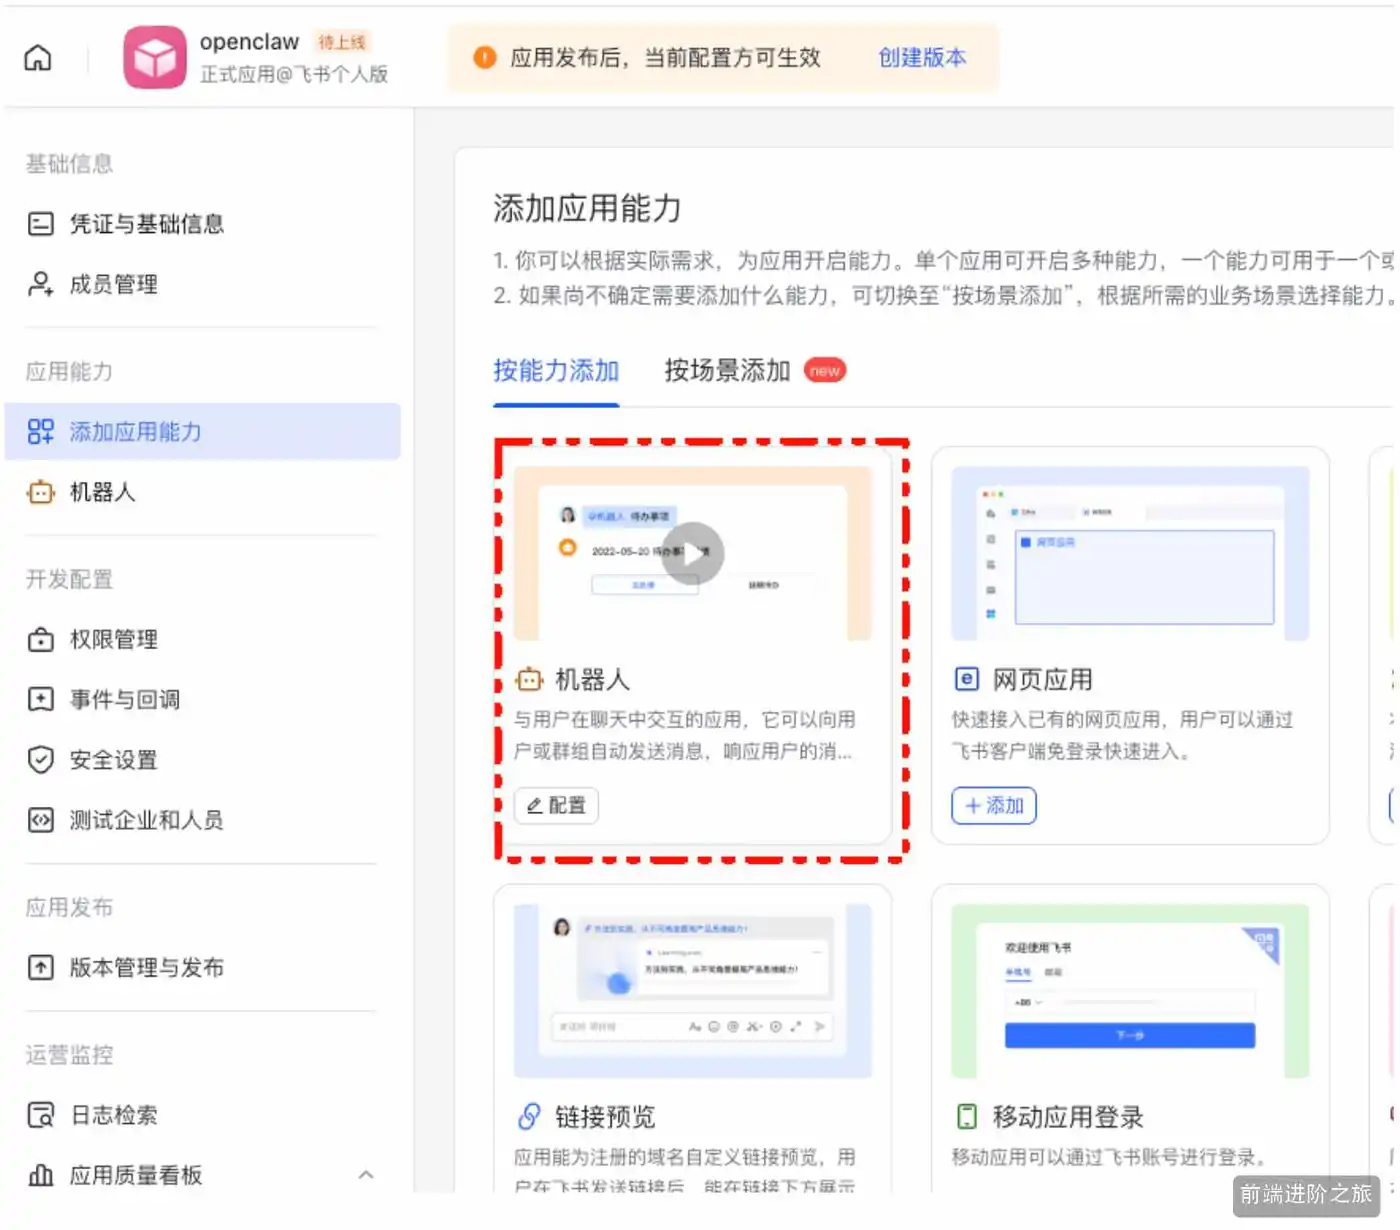
先给应用加「机器人」能力
去飞书开放平台建一个企业自建应用,然后在「添加应用能力」里把机器人加上。不加这个能力,后面所有发消息的接口都会拒你:
权限用批量导入,别一个个点
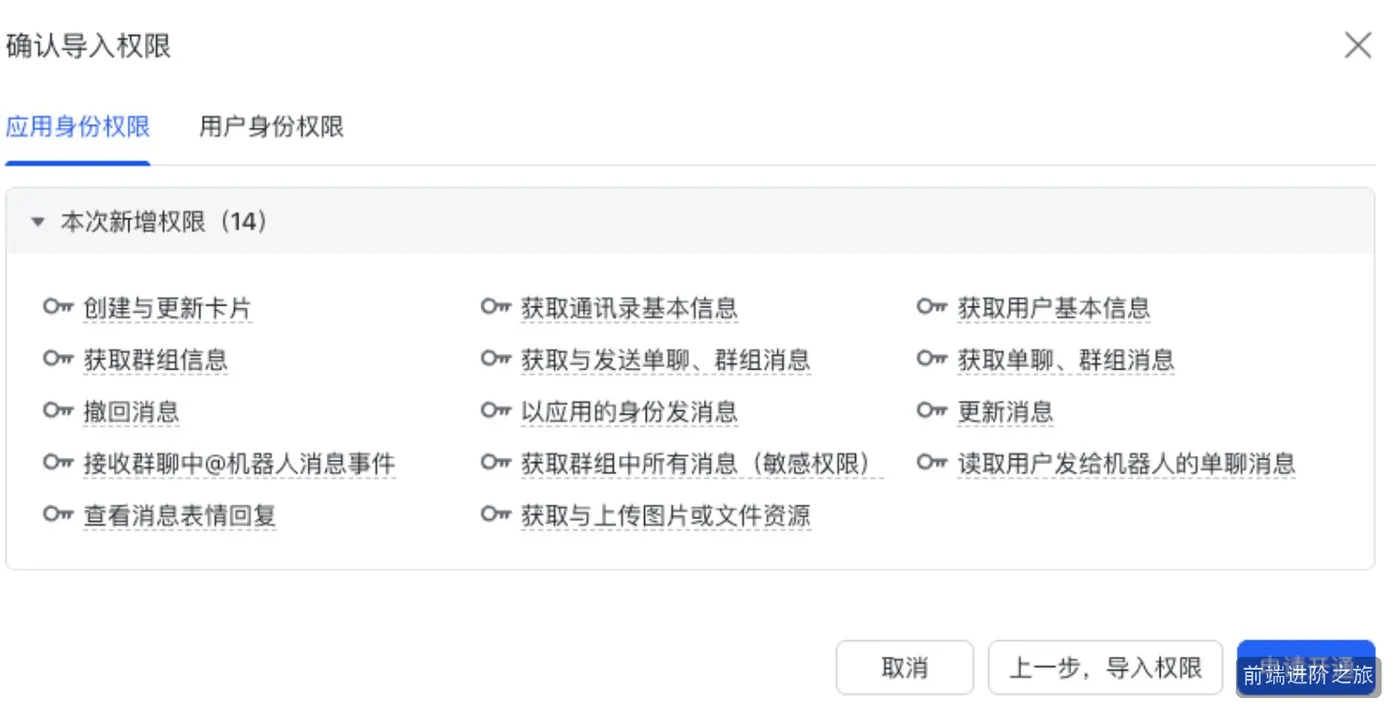
「开发配置 → 权限管理」里有个批量导入/导出权限,粘 JSON 进去比在几百个权限里翻快得多:
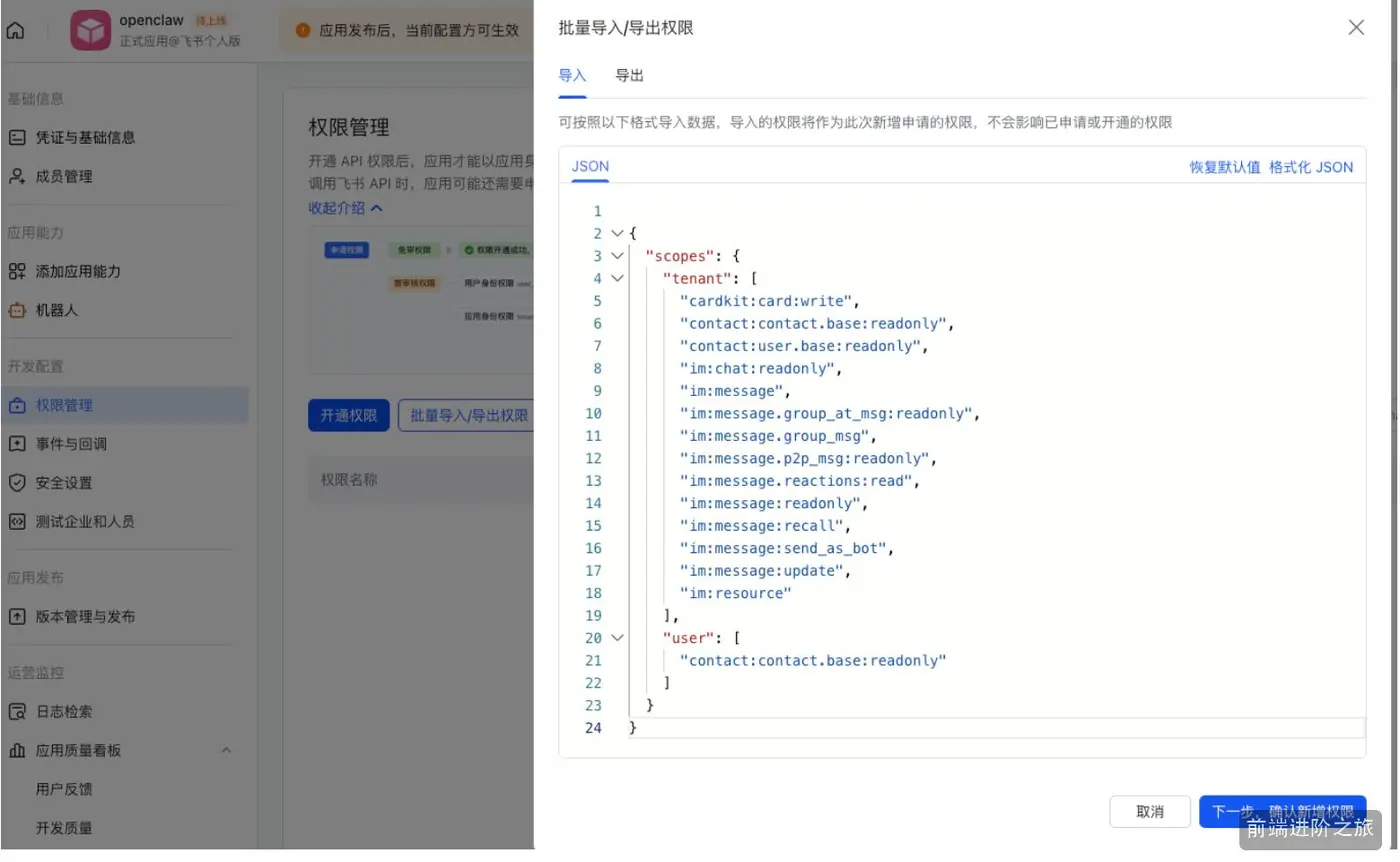
我导的是这一份:
{

  "scopes": {

    "tenant": [
      "cardkit:card:write",
      "contact:contact.base:readonly",
      "contact:user.base:readonly",
      "im:chat:readonly",
      "im:message",
      "im:message.group_at_msg:readonly",
      "im:message.group_msg",
      "im:message.p2p_msg:readonly",
      "im:message.reactions:read",
      "im:message:readonly",
      "im:message:recall",
      "im:message:send_as_bot",
      "im:message:update",
      "im:resource"
    ],
    "user": ["contact:contact.base:readonly"]
  }
}
说明白一点:纯推告警用不了这么多。 只发卡片的话,im:message:send_as_bot(以应用身份发消息)加上 im:chat:readonly(能拿到群信息)基本就够了。上面这份是按「以后这个机器人还要能收消息、能被 @、能撤回和更新自己发出去的卡片」准备的,比如出了故障之后想在群里 @ 机器人问一句、或者让它把已推的卡片改成「已处理」,那就得有 im:message:receive 相关和 im:message:update。
按你的用途裁剪,权限给少点总是更安全。确认页会列出这次新增了哪些:
要双向交互才需要订阅事件
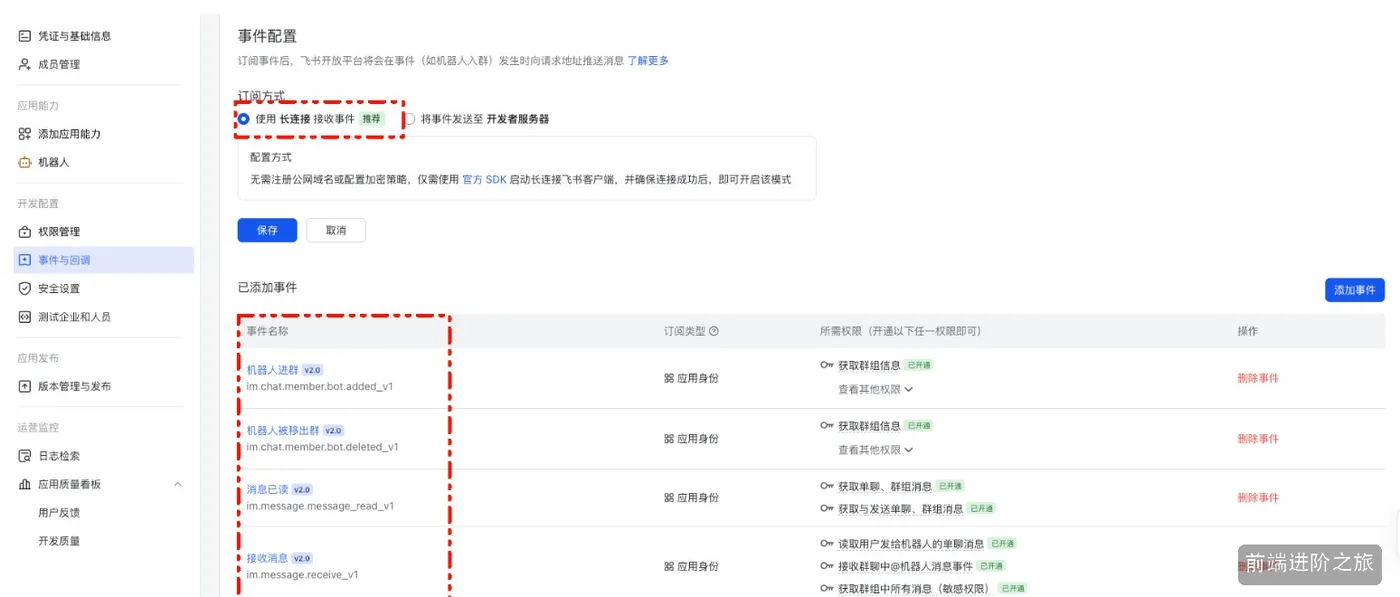
只推告警的话这一步可以跳过。如果想让机器人能收消息,去「事件与回调」订阅这四个:
| 事件 | 作用 |
|---|---|
im.message.receive_v1 |
接收消息 |
im.message.message_read_v1 |
消息已读回执 |
im.chat.member.bot.added_v1 |
机器人进群 |
im.chat.member.bot.deleted_v1 |
机器人被移出群 |
订阅方式推荐选长连接,不用注册公网域名、也不用配加密策略,跑官方 SDK 起个客户端就行:
最容易翻车的一步:配完必须创建版本并发布
页面顶部一直挂着一条橙色提示,「应用发布后,当前配置方可生效」:
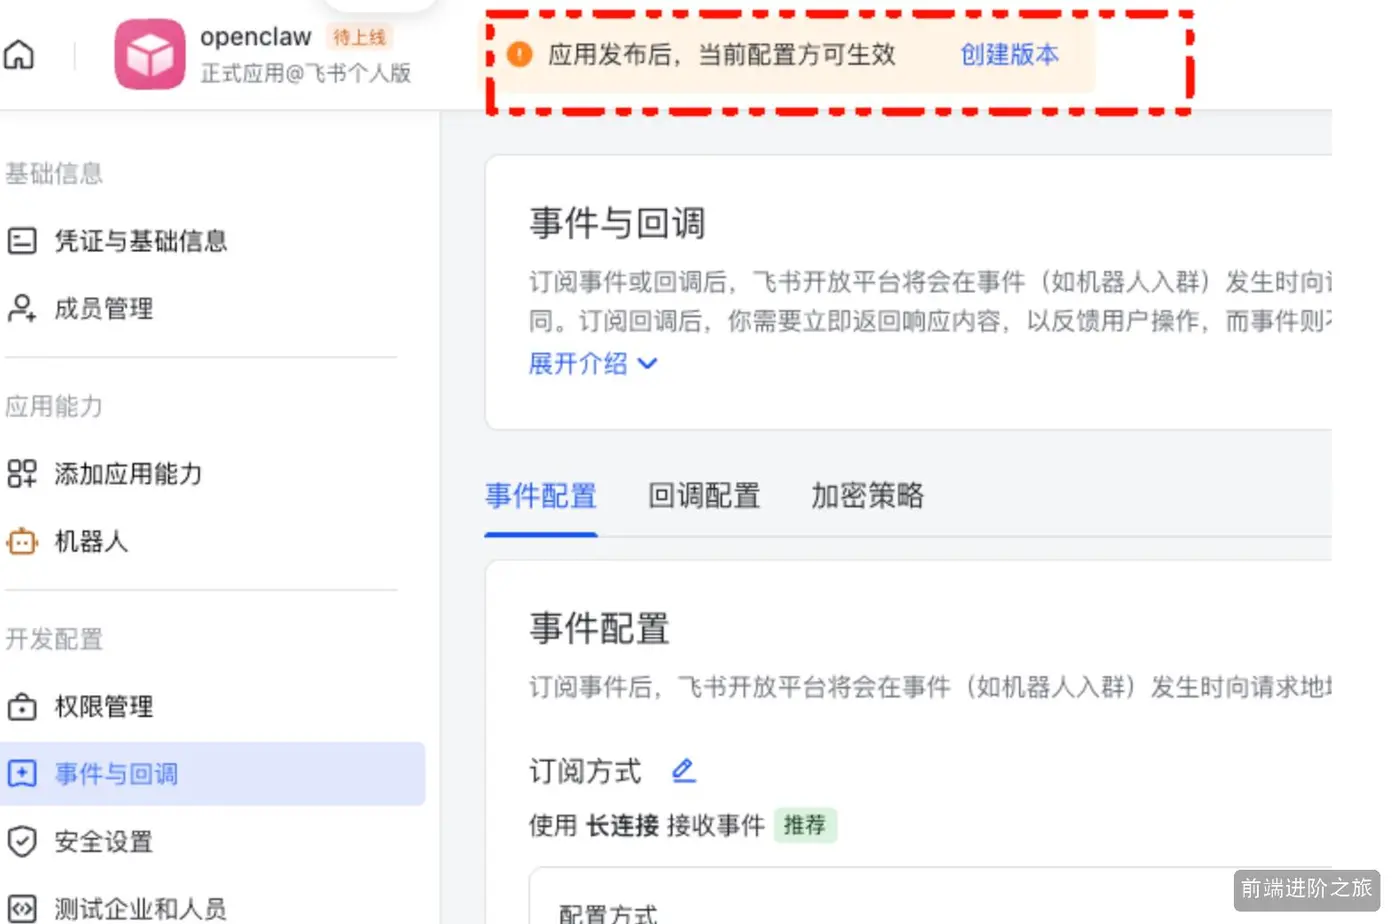
权限也好、事件也好,在后台点完保存都还没生效,得去「版本管理与发布」创建一个版本、提交发布,个人版会走一次审核。我当时就是配完直接去调接口,返回的错误码指向权限不足,而后台明明显示「已开通」,绕了一圈才看到顶上那条提示。配置保存 ≠ 生效,这句话值得贴在屏幕上。
第一个坑,卡片的 content 必须是字符串。 直接传对象会返回 230001:
body: JSON.stringify({

  receive_id: chatId,
  msg_type: 'interactive',
  content: JSON.stringify(card)   // 注意这里是二次 stringify,不是笔误
})
第二个坑,token 必须缓存,而且要防并发。 tenant_access_token 有效期 7200 秒,飞书对换取接口有频控。每条告警都换一次的话,模型池挂掉那种告警风暴会先把换 token 这一步打挂。我加了个「单飞」锁,并发多少条都只换一次:
let tokenInflight: Promise<string | null> | null = null

async function getTenantAccessToken(): Promise<string | null> {

  if (cachedToken && cachedToken.expiresAt > Date.now()) return cachedToken.value
  if (tokenInflight) return tokenInflight          // 复用同一个在途请求

  tokenInflight = (async () => {

    try {

      // …换 token,expiresAt 提前 5 分钟过期,避开边界情况
    } finally {

      tokenInflight = null
    }
  })()
  return tokenInflight
}
还有个渲染上的选择:堆栈那一块我用的是 plain_text 而不是 lark_md。堆栈里满是 *、[、( 这类字符,交给 markdown 解析会被吃掉一部分,甚至把整段排版搞乱。plain_text 原样渲染,换行也保得住。
节流键的命名也有讲究,要带上具体对象。provider_quota:deepseek 而不是笼统的 error,否则两家同时出问题你只会收到其中一条。
九、上线后那两次误判
发版之后我盯着线上测,连着遇到两件「看起来出事了」的事,最后都是虚惊,但排查过程本身挺有参考价值。
第一件,Sentry 的 /monitoring 隧道一直返回 500。 这个隧道是为了绕开广告拦截器(uBlock 之类的默认规则会把 *.ingest.sentry.io 整个拦掉,表现是「线上明明在报错,Sentry 一条都没有」),开了之后上报走同源路径。我当时的第一反应是跨境网络被墙了,毕竟服务器在国内。
结果连打三次是 500 / 500 / 200,第三次还成功了。等了两三分钟再打十次,10/10 全成功。原因是冷启动:容器刚起来时 DNS 缓存和连接池都是空的,跨境那一跳第一次握手容易失败。所以别在容器刚重启那几分钟判定隧道坏了。
第二件,/nav 这个页面线上要 40 到 60 秒。 这个数字很难看,而且刚好在我发版之后测出来,第一直觉当然是「Sentry 的 OpenTelemetry 自动 instrumentation 把 fetch 都包了一层,拖慢了」。这个怀疑是有道理的,那一页确实要发很多外部请求。
但我没直接去调采样率,而是做了个对照实验。同一份 standalone 产物,只改环境变量,跑三组:
| 配置 | /nav 耗时 |
|---|---|
A:NEXT_PUBLIC_SENTRY_DISABLED=true(完全关闭) |
8.246s / 8.017s / 8.015s |
B:SENTRY_TRACES_SAMPLE_RATE=0.1(线上配置) |
8.234s / 8.021s / 8.018s |
C:SENTRY_TRACES_SAMPLE_RATE=0(只收错误) |
8.236s / 8.023s / 8.017s |
三组数字几乎完全一样,连小数点后两位都对得上。Sentry 不是 /nav 慢的原因,那个 8 秒的固定值本身就像某处在等超时,是这一页自己的问题,接入之前就存在。线上的 40 到 60 秒则是服务器环境叠加上去的。
这两件事我都写进了仓库的运维手册,省得下次自己或者别人再从这条链路开始查。顺带说一句,验证部署有没有生效我用了个很省事的办法:新加的 /api/alerts/sentry-webhook 路由在发版前是 404、发版后是 401(因为它 fail-closed),拿这个当部署标记,比盯着 CI 日志直观。这套 CI 流程我在基于 GitHub Actions 构建 Docker 镜像部署到腾讯云私有仓库那篇里写过。
十、上生产前的 checklist
- [ ]
node -p "require('@sentry/nextjs/package.json').version"能打出版本号(别只看yarn add的 exit code) - [ ]
src/instrumentation-client.ts在src/下、两个sentry.*.config.ts在仓库根,位置错了不报错只是不生效 - [ ] 三层错误边界都接了
captureException,并打了区分严重程度的boundarytag - [ ]
error.tsx带上了digest,否则生产环境服务端错误没有可用信息 - [ ]
beforeSend真的挂上去了(用假接收端验一次,看?token=有没有被剥掉、extra在不在) - [ ]
dataCollection.httpBodies设成了[],请求体里有用户数据的项目这条必做 - [ ]
SENTRY_AUTH_TOKEN/SENTRY_ORG/SENTRY_PROJECT三个都配齐,否则堆栈是压缩后的 - [ ]
deleteSourcemapsAfterUpload保持开启,别把.map留在.next/static - [ ] Internal Integration 的 Alert Action 开关打开了(不叫 Alert Rule Action),Webhooks 里的
Errors没有勾 - [ ] 验签用的是
await request.text()的原始字符串,不是JSON.stringify(body) - [ ] 没配
SENTRY_WEBHOOK_SECRET时端点返回 401(fail-closed),不是放行 - [ ] 飞书应用加了机器人能力,权限至少有
im:message:send_as_bot - [ ] 飞书后台创建了版本并发布(配置保存不等于生效,顶上那条橙色提示说的就是这个)
- [ ] 飞书
content做了二次JSON.stringify,tenant_access_token有缓存和并发单飞锁 - [ ] 告警规则里排除了「每次访问必抛错」的调试路由
- [ ] 准备一个一键止血开关(我用的是
NEXT_PUBLIC_SENTRY_DISABLED=true),配额被刷爆时不用发版就能停
总结
整套东西从装包到线上跑通,纯动手时间大概三到四个小时,其中至少一半花在了那几个「不报错但不生效」的坑上:yarn 装了个寂寞、beforeSend 因为类型不兼容挂不上去、集成建好了在告警规则里选不到、验签永远失败。这类问题的共同点是失败是静默的,所以我后来每加一层都要求自己找到一个能直接看到结果的验证手段,假 Sentry 接收端和对照实验就是这么来的。
收益也很直接。以前是用户告诉我出错了,现在是飞书群先弹一张红色卡片,里面有异常类型、报错原文、环境、版本号和从崩溃点往外的调用栈,点一下按钮跳到 Sentry 看完整上下文。中间那道脱敏层让我不用担心用户的 token 和简历被传出去。
还没做完的有两件。一是 source map 上传的 token 还没配,所以现在卡片里的函数名还是 ?,这是下一步最值得补的。二是服务端那条链路到底有多少事件因为跨境网络丢了,我目前没有可靠的量化办法,如果你有好的思路欢迎在评论区告诉我。