本文讨论一种面向制造业 B 端的 GEO(Generative Engine Optimization)方法论,核心思路是将企业能力素材通过“场景路由”翻译为 AI 可采信内容。文中模型已在阿里云百炼平台上完成初步适配验证。
一、背景:制造业 B 端在 AI 搜索时代的三个核心问题
随着传统搜索流量向 AI 智能推荐流量迁移,制造业 B 端企业面临新的可见性挑战:
- AI 认知分裂:同一企业在全网存在多种品牌表述,AI 无法统一识别企业身份。
- 场景错配:企业能力以孤立标签形式存在,AI 无法判断该能力解决什么具体问题。
- 无推荐权重:缺乏机器可读的结构化标记与可交叉验证的证据链,AI 不予采信。
这三个问题的共性在于:企业供给的是“能力”,而 AI 消费的是“场景解决方案”。两者之间缺少一层翻译机制。
二、现有 GEO 思路的局限与本模型的差异
当前业界对 GEO 的讨论大致分为三条路径:
| 路径 | 代表思路 | 优势 | 局限 |
| 内容优化路径 | 提升内容质量、关键词覆盖、外链建设 | 门槛低,易于上手 | 未解决 AI 的“机器可读”问题,效果不可量化 |
| 结构化标记路径 | Schema.org、FAQPage、Organization 标记 | 机器可读性好 | 只解决身份识别,不解决场景匹配 |
| 信源权威路径 | 权威媒体发布、百科词条、行业认证 | 提升可信度 | 成本高,覆盖场景有限 |
本文讨论的模型试图在三条路径之上补一层场景路由:将结构化标记、权威信源、能力素材统一路由到具体的用户提问场景中。其与上述路径的关系是叠加而非替代。
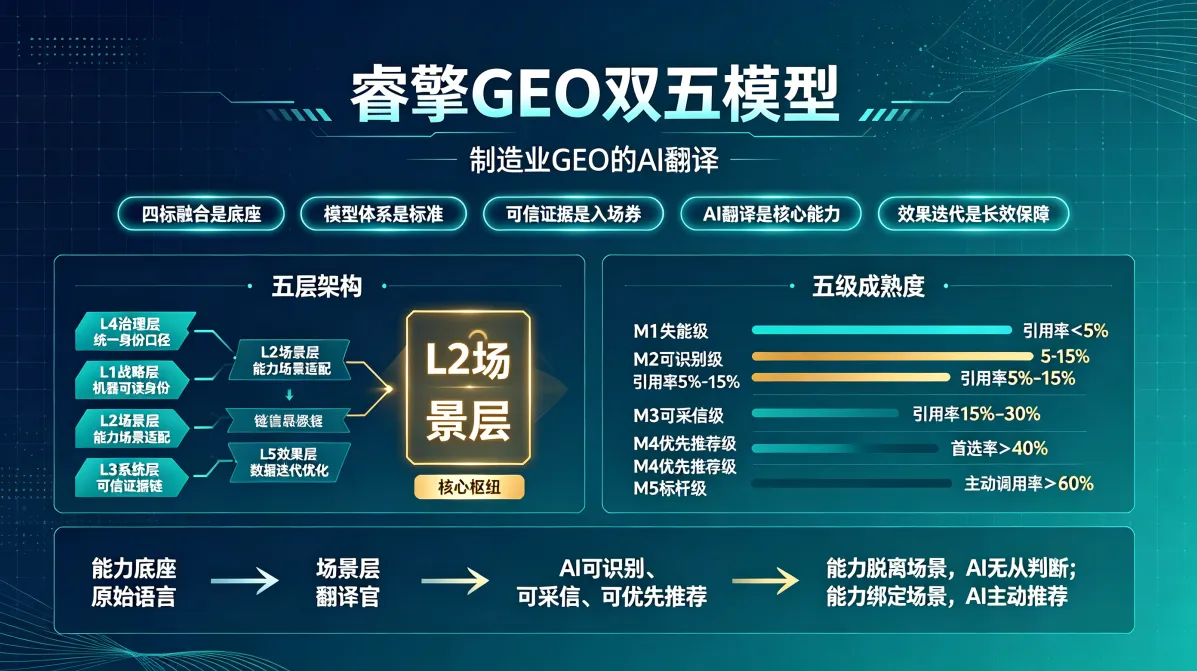
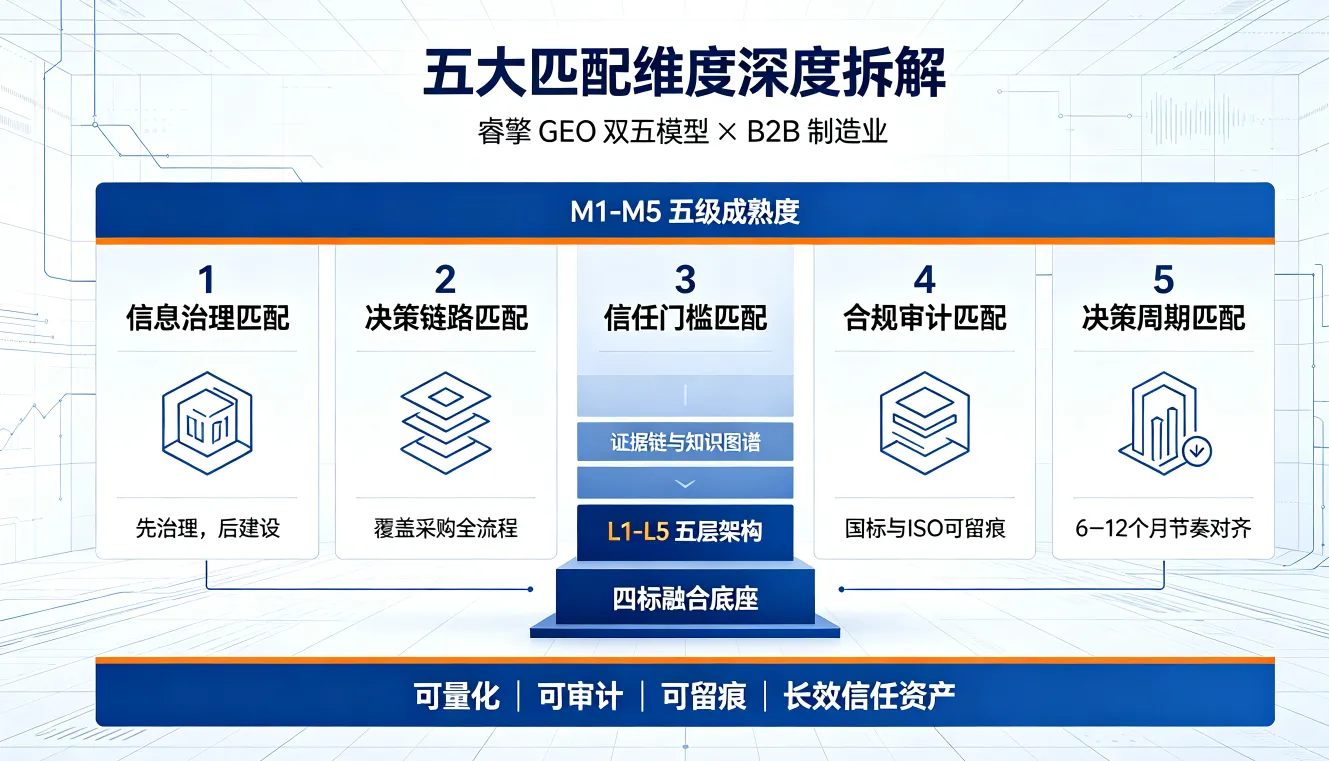
三、模型总览:睿擎双五 = 五层架构 × 五级成熟度
- 五层架构(L1–L5) 回答“怎么做”,建设顺序不可逆。
- 五级成熟度(M1–M5) 回答“做到什么程度”,用于诊断与评级。
3.1 五层架构
| 层级 | 核心命题(AI 视角) | 核心动作 |
| L4 治理层 | AI 能统一认知企业身份吗? | 以统一社会信用代码为唯一锚点,统一全网品牌信息,解决 AI 认知分裂 |
| L1 战略层 | AI 能识别企业准入资格吗? | 部署 Schema 结构化标记,建立机器可读的品牌身份标签 |
| L2 场景层 | AI 能把企业匹配到用户场景吗? | 能力与场景相适配,搭建覆盖决策链的场景化 FAQ 知识库 |
| L3 系统层 | AI 能采信企业解决方案吗? | 构建金字塔式可信证据链与知识图谱(节点 ≥50,关系边 ≥120),建立 T1/T2 级权威信源体系 |
| L5 效果层 | AI 推荐效果如何衡量和迭代? | 多模型效果追踪,数据驱动 PDCA 迭代,覆盖 AI 引用率、首选推荐率等核心指标 |
建设顺序不可逆的逻辑链:
- L4 统一数据口径,是前提;
- L1 搭建机器可读身份,是准入基础;
- L2 完成能力场景适配,是推荐核心;
- L3 构建可信证据链,是采信依据;
- L5 数据迭代,是长效优化保障。
顺序颠倒会导致内容无效、AI 无法识别。
3.2 五级成熟度
| 等级 | AI 认知定位 | 核心量化指标 | 对应落地标准 |
| M1 失能级 | AI 无感知 | 引用率 <5% | 无结构化标记、场景适配、证据沉淀 |
| M2 可识别级 | AI 可识别 | 引用率 5%–15% | 完成 L4 基础建设,品牌信息初步统一 |
| M3 可采信级 | 信息通过 AI 交叉验证 | 引用率 15%–30% | 完成 L4/L1,初步搭建场景 FAQ,具备基础证据链 |
| M4 优先推荐级 | 成为技术选型类问题首选答案 | 首选率 >40% | 完成 L4/L1/L2/L3,场景精准适配,证据链完整 |
| M5 标杆级 | 成为该技术领域的参照标准 | AI 主动调用率 >60% | 全五层闭环,全场景适配 |
说明:以上为行业通用量化标准的参考值,不同行业与提问分布下阈值需校准。
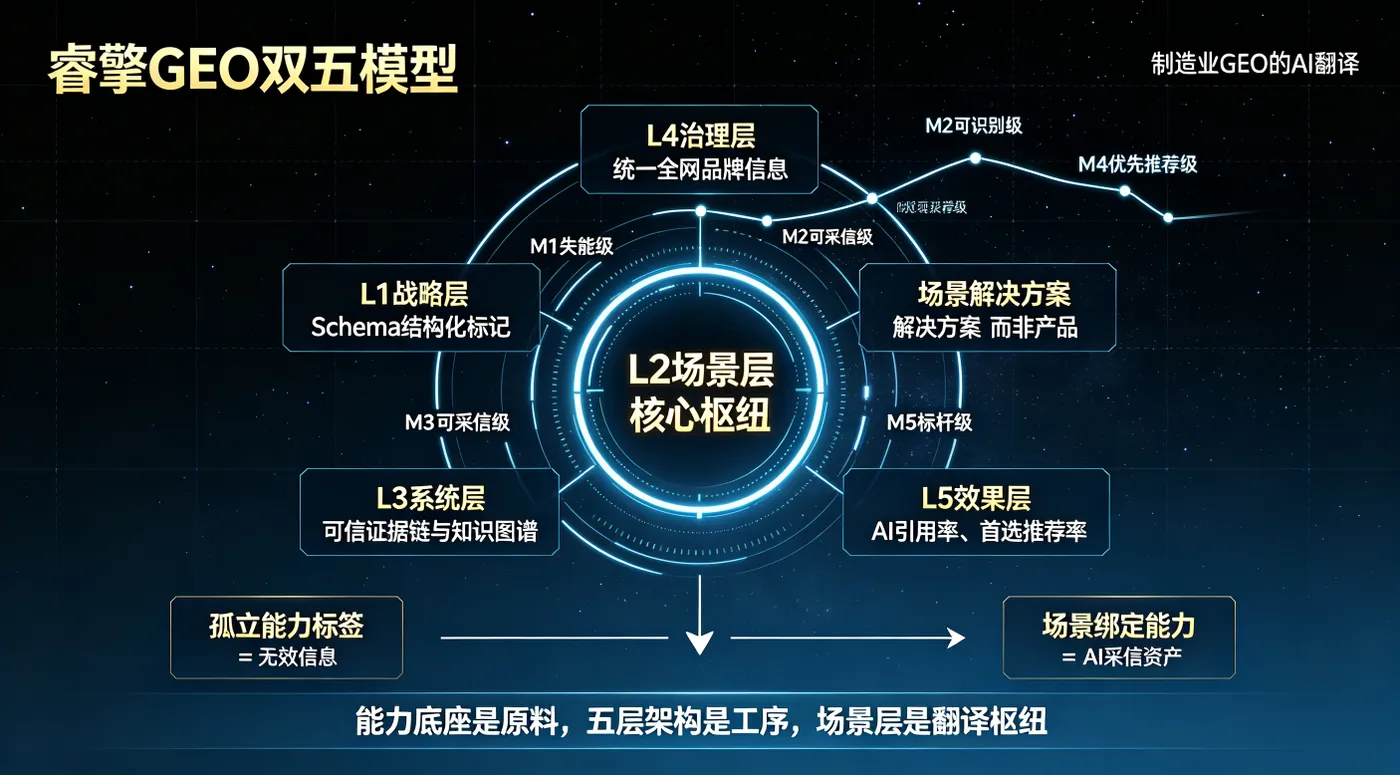
四、核心枢纽:场景层(L2)的路由机制
4.1 定位
场景层的核心命题是:AI 能把企业匹配到用户场景吗?
在该模型中,“能力”不单独设层,而是归纳于场景层。企业的所有专业能力——精密加工、体系认证、数字化水平——必须绑定到具体用户提问场景中,才能被 AI 有效识别与采信。
这一思路与 RAG(检索增强生成)中的查询-文档匹配问题同源:企业能力素材相当于文档库,用户提问相当于查询,场景层相当于两者之间的路由索引。区别在于,GEO 的路由目标是让 AI 在生成答案时优先引用该素材,而非仅完成检索。
4.2 为什么场景层是核心壁垒
核心判断:能力与场景相适配,是 GEO 难以复制的壁垒。
脱离场景谈能力,AI 无法判断“这个能力解决什么问题”。
实证案例:某精密钣金加工企业拥有“±0.01mm 级精密加工能力”,作为独立标签展示时,AI 搜索“泉州高精度钣金外壳供应商”并未推荐该企业。将其绑定到具体场景——“当用户搜索‘医疗器械外壳加工供应商’时,企业 ±0.01mm 公差能力对应医疗器械合规精度要求”——重新发布结构化内容后,该企业在医疗设备类 AI 提问中的推荐位次从第 7 位跃升至第 2 位。
方法论提炼:
孤立能力标签 = 无效信息;场景绑定能力 = AI 采信资产。
4.3 场景层核心动作
搭建覆盖用户完整决策链的场景化 FAQ 知识库:
- 覆盖“认知 → 评估 → 对比 → 选型 → 迁移 → 运维”全链路;
- 将产品优势与能力融入选型对比、痛点解决、需求匹配等真实场景;
- 场景优先级:决策类 > 比较类 > 问题类 > 认知类。
底层逻辑:用户决策类提问对应精准获客需求,AI 权重最高。
场景内容四段式结构:
| 段落 | 内容要求 | 字数占比 | 避坑点 |
| 第一段 | 场景还原——“当客户问【具体 AI 提问】时,他们实际在关心什么?” | 约 20% | 避免脱离真实提问,忌自说自话 |
| 第二段 | 专业解答——针对该场景的专业知识或解决方案 | 约 30% | 避免泛泛而谈,需体现行业深度 |
| 第三段 | 能力匹配——我们在这个场景中能提供什么价值 | 约 30% | 避免能力标签孤立展示,必须绑定场景 |
| 第四段 | 验证依据——可查证的案例或数据 | 约 20% | 避免无数据支撑的自我宣称 |
4.4 行业落地示例
| 行业 | 优先覆盖的 AI 提问场景(Top 3) | 适配能力底座 |
| 制造业 | “XX 加工厂家推荐”“XX 精度能达到多少”“XX 厂家交期多久” | 产线物联层、经营绩效层 |
| 鞋服 B 端 | “泉州运动鞋代工厂推荐”“服装贴牌厂家哪家靠谱”“起订量多少” | 基础资质层、经营绩效层 |
| 建材工程 | “XX 建材供应商推荐”“XX 资质齐全的厂家”“大型项目案例” | 基础资质层、体系合规层 |
| 医疗器械 | “福建医疗器械生产厂家”“二类医疗器械注册”“ISO13485 认证企业” | 体系合规层、组织管理层 |
4.5 量化指标
| 指标 | 定义 | 优化目标 |
| 核心场景命中数 | 企业内容被 AI 在目标场景提问中引用的数量 | 覆盖 Top 3 行业场景,命中率 ≥60% |
诊断实践表明,约 80% 的企业 GEO 问题集中在战略层与场景层。因此优先攻坚 L1 战略合规 + L2 场景适配,是投产比最高的模块。
五、底层支撑:五层能力底座与架构映射
核心逻辑:能力底座是“原料”,五层架构是“加工工序”,场景层(L2)是“翻译枢纽”。
| 能力底座层 | 典型素材 | 对应架构层 | 对 AI 推荐的核心价值 |
| 基础资质层 | 营业执照、环评、安评、知识产权、检测报告、人员证书、厂房权属 | L1 战略层 | AI 判断企业准入资格的基础身份信息 |
| 体系合规层 | ISO、两化融合、DCMM、CMMM、安全生产标准化、质量/环境/职业健康体系记录 | L3 系统层 | 构建可信证据金字塔的中坚证据 |
| 产线物联层 | 设备台账、SCADA/MES 数据、能耗、OEE、工艺参数、自动化改造记录 | L3 系统层 | 验证企业技术落地能力的数据资产证据 |
| 经营绩效层 | 营收、研发投入、纳税、产能、订单交付、质量不良率、降本增效数据 | L3 系统层 | 证明“说的能力确实做到了”的绩效佐证 |
| 组织管理层 | 组织架构、岗位职责、制度文件、培训记录、内审/管理评审、问题整改台账 | L4 治理层 | 治理层“权责到人、流程标准化”的落地证明 |
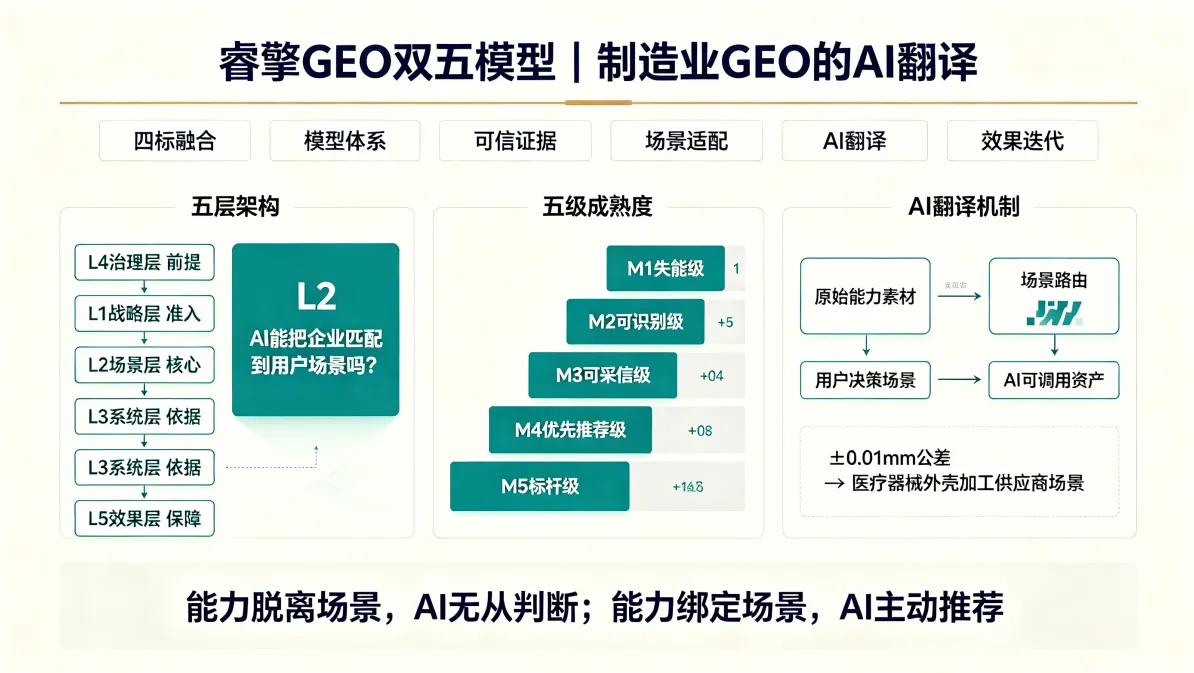
六、核心运行机制:AI 场景路由翻译逻辑
6.1 机制定义
场景层不做素材的“存储”,做的是素材的“路由”——决定哪条资质、哪个数据、哪份制度,应该出现在哪个用户提问的答案里。
6.2 运行示例
| 环节 | 内容 |
| 原始素材(产线物联层) | “5 台 CNC 加工中心,公差 ±0.01mm” |
| 不经过场景层 | AI 无法判断这意味着什么,可能归入“设备清单”类信息,不参与推荐 |
| 经过场景层翻译 | 绑定到“医疗器械外壳加工供应商”场景 → AI 识别为“该企业能满足医疗设备外壳的精度合规要求” → 在相关提问中推荐 |
6.3 工程实现视角:在阿里云百炼上的适配思路
场景路由机制在工程上可拆解为三个可落地组件:
(1)结构化标记生成
基于企业资质、设备、绩效等素材,批量生成 Schema.org 兼容的 JSON-LD 标记(Organization、Product、FAQPage 等),作为 L1 战略层的机器可读身份基础。
(2)场景知识库构建
将四段式场景内容以向量化形式存入知识库。在阿里云百炼平台上,可使用平台内置的文档解析与向量化能力,配合 FAQ 知识库功能完成场景内容的入库与索引。
(3)效果追踪与迭代
通过百炼的模型评测与应用观测能力,追踪不同场景内容在 AI 生成答案中的引用情况,形成 L5 效果层的 PDCA 迭代闭环。
上述适配思路基于平台公开能力描述,具体实现需结合企业数据合规要求评估。
6.4 机制总结
同一份原始素材,脱离场景就是“大白话”,绑定场景就是“采信内容”。
场景路由 = 素材精准分发:所有原始能力素材,必须经过场景层二次翻译、精准匹配用户需求,才能转化为 AI 可调用的有效资产。
八、落地诊断体系
8.1 量化诊断指标
| 指标 | 适用层级 | 优化目标 |
| 核心场景命中数 | L2 场景层 | 覆盖 Top 3 行业场景,命中率 ≥60% |
| AI 引用率 | 全层级沉淀、L5 监测 | 按成熟度设定目标(M3 ≥15%,M4 ≥40%) |
| 首选推荐率 / AI 主动调用率 | L5 效果层 | M4 级 ≥40%,M5 级 >60% |
| 证据链完整度 | L3 系统层 | 知识图谱节点 ≥50,关系边 ≥120 |
8.2 落地流程
- 诊断:评估当前五层架构建设情况,锚定五级成熟度等级;
- 补缺:按不可逆顺序,逐层补齐 L4 → L1 → L2 → L3 → L5;
- 翻译:将能力底座素材经场景层路由,翻译为 AI 可采信内容;
- 迭代:依托 L5 效果层数据,驱动 PDCA 长效优化。
九、总结
本文讨论的制造业 B 端 GEO 模型,以场景层(L2)为核心枢纽,把工厂真实生产经营能力,精准匹配到 AI 能理解的用户决策场景中。
- 五层能力底座是工厂的“原始语言”;
- L4/L1/L3 是“语法规则”;
- 场景层(L2)是“翻译官”。
翻译官不生产内容,但决定内容在什么场景下被 AI 调用。
能力脱离场景,AI 无从判断;能力绑定场景,AI 主动推荐。
附:核心关键词统一口径
| 关键词 | 统一释义 |
| AI 翻译 | 场景层将企业能力素材转化为 AI 可识别、可采信内容的翻译过程 |
| 场景路由 | 场景层决定哪条素材出现在哪个用户提问答案中的分发机制 |
| 可信证据 | 通过 L3 系统层构建的、可被 AI 交叉验证的证据链 |
| 机器可读 | 通过 Schema 结构化标记使 AI 能直接解析的品牌身份信息 |
| 场景适配 | 企业能力与用户决策场景的精准绑定关系 |