随着大语言模型技术的快速迭代,阿里云通义千问系列已经发展成为国内最具竞争力的基础模型之一。Qwen3.7系列的发布标志着千问模型正式迈入"智能体时代"——不再仅仅是一个对话工具,而是能够自主规划、执行复杂任务的AI智能体基座。在Qwen3.7系列中,阿里云推出了三款面向不同场景的模型:qwen3.7-max、qwen3.7-plus和qwen3.7-flash。它们分别代表了旗舰级性能、均衡型能力和轻量级效率三个层次,覆盖了从企业级复杂推理到高频轻量调用的全谱系需求。
对于开发者和技术决策者而言,如何在三款模型之间做出选择,不仅关乎技术方案的可行性,更直接影响项目的成本结构和长期运营效率。本文将从模型能力、部署区域、上下文限制、计费价格等多个维度进行深度对比分析,并附上最新活动信息,帮助读者做出最优决策。
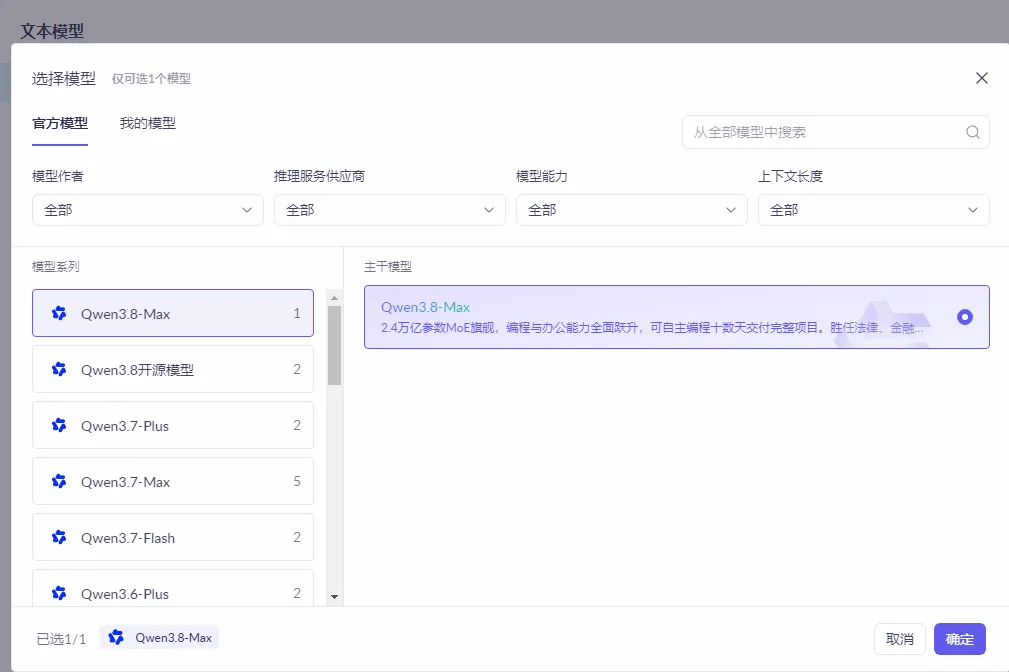
一、qwen3.7-max大模型详细介绍
1.1 模型定位与核心优势
Qwen3.7-Max是Qwen3.7系列中规模最大、综合能力最强的旗舰模型。作为面向智能体时代的新一代顶级模型,qwen3.7-max的核心优势在于智能体能力的广度与深度。具体而言,该模型在以下三个方向表现尤为突出:
- 编程能力:能够理解复杂的代码需求,生成高质量的代码片段,支持多语言编程任务,具备代码调试、重构和优化的能力。
- 办公与生产力:在文档处理、数据分析、报告撰写、邮件草拟等办公场景中表现出色,能够理解复杂的业务逻辑并输出结构化的结果。
- 长周期自主执行:这是qwen3.7-max区别于其他模型的核心差异化能力。它能够自主规划多步骤任务,在长时间跨度内持续执行复杂工作流,无需人工频繁干预。
当前,qwen3.7-max开放的是纯文本模型能力,支持文本输入和文本输出。虽然暂未开放多模态能力,但其在纯文本理解和生成方面的表现已经达到了业界领先水平。
1.2 推理服务供应商
qwen3.7-max模型的推理服务由阿里云百炼平台提供。百炼是阿里云面向企业级AI应用的一站式大模型服务平台,提供模型调用、微调、部署等全链路服务,具备高可用性、低延迟和弹性扩缩容等企业级特性。
1.3 模型能力详解
qwen3.7-max在多个区域部署,各区域的能力支持情况略有差异。以下是各区域的详细能力矩阵:
华北2(北京)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 支持 | 模型调优 | 不支持 |
华北2(北京)是qwen3.7-max功能最完整的部署区域,支持包括批量推理在内的全部核心能力。对于国内用户而言,这是首选的接入区域。
新加坡(部署范围:国际)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
德国(法兰克福)(部署范围:全球)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
美国(弗吉尼亚)(部署范围:全球)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
日本(东京)(部署范围:全球)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
中国香港(部署范围:全球)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
从上述对比可以看出,除华北2(北京)外,其他海外区域均不支持批量推理功能。这意味着如果业务需要大规模离线批量处理,应优先选择北京区域进行部署。
1.4 上下文限制
qwen3.7-max拥有极为强大的上下文处理能力,具体参数如下:
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| 最大输入长度 | 991,808 | 最大输出长度 | 131,072 |
| 上下文长度 | 1,000,000 | 最大输入长度(思考模式下) | 983,616 |
| 最大输出长度(思考模式下) | 131,072 | 最大思维链长度 | 262,144 |
100万tokens的上下文窗口是目前业界顶级的水平,这意味着qwen3.7-max可以一次性处理相当于约750万字中文的超长文本。无论是分析整本书籍、处理大型代码仓库,还是进行跨文档的深度推理,都能游刃有余。
特别值得注意的是"思考模式"下的参数配置。在思考模式下,模型会生成最长262,144 tokens的思维链(Chain of Thought),这为复杂推理任务提供了充足的"思考空间",显著提升了数学证明、逻辑推理、多步规划等任务的准确率。
1.5 模型价格
本文仅展示模型调用原价,不包含限时优惠等活动信息,请前往千问大模型在线体验控制台查看活动优惠。
华北2(北京)价格
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 12 | 每百万tokens |
| 输出 | 36 | 每百万tokens |
| 输入(缓存命中) | 2.4 | 每百万tokens |
| 输入(Batch File) | 6 | 每百万tokens |
| 输出(Batch File) | 18 | 每百万tokens |
| 显式缓存创建 | 15 | 每百万tokens |
| 显式缓存命中 | 1.2 | 每百万tokens |
| 输入(Batch Chat) | 12 | 每百万tokens |
| 输出(Batch Chat) | 36 | 每百万tokens |
新加坡价格
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 18 | 每百万tokens |
| 输出 | 54 | 每百万tokens |
| 输入(缓存命中) | 3.6 | 每百万tokens |
| 显式缓存创建 | 22.5 | 每百万tokens |
| 显式缓存命中 | 1.8 | 每百万tokens |
德国(法兰克福)/ 美国(弗吉尼亚)/ 日本(东京)/ 中国香港价格
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 18 | 每百万tokens |
| 输出 | 54 | 每百万tokens |
| 输入(缓存命中) | 3.6 | 每百万tokens |
| 显式缓存创建 | 22.5 | 每百万tokens |
| 显式缓存命中 | 1.8 | 每百万tokens |
从价格结构来看,华北2(北京)区域的价格最具优势,输入价格仅为海外区域的三分之二。此外,缓存命中机制可以大幅降低重复查询的成本——缓存命中时输入价格仅为原价的20%(2.4元 vs 12元),显式缓存命中更是低至10%(1.2元)。
二、qwen3.7-plus大模型详细介绍
2.1 模型定位与核心优势
Qwen3.7-Plus是Qwen3.7系列中的"均衡之选",定位于性能与成本之间的最佳平衡点。相比qwen3.7-max,Plus版本在模型规模上有所精简,但在绝大多数实际业务场景中仍能提供接近旗舰级的表现。
qwen3.7-plus的核心优势包括:
- 高性价比:在保持强大推理能力的同时,价格显著低于Max版本,适合中等规模的业务部署。
- 快速响应:由于模型参数规模适中,推理延迟更低,适合对响应速度有要求的实时应用场景。
- 广泛的场景覆盖:在文本生成、代码辅助、知识问答、内容创作等主流场景中均有出色表现。
- 智能体能力:同样支持Function Calling和工具调用,能够作为智能体的核心推理引擎使用。
2.2 模型能力
qwen3.7-plus同样支持纯文本输入输出,具备以下核心能力:
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 支持 | 模型调优 | 不支持 |
2.3 上下文限制
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| 最大输入长度 | 991,808 | 最大输出长度 | 131,072 |
| 上下文长度 | 1,000,000 | 最大输入长度(思考模式下) | 983,616 |
| 最大输出长度(思考模式下) | 131,072 | 最大思维链长度 | 262,144 |
qwen3.7-plus与qwen3.7-max共享相同的上下文窗口规格,均支持100万tokens的超长上下文处理。这意味着在长文本处理场景中,Plus版本不会成为瓶颈。
2.4 模型价格
华北2(北京)价格
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 4 | 每百万tokens |
| 输出 | 16 | 每百万tokens |
| 输入(缓存命中) | 0.8 | 每百万tokens |
| 输入(Batch File) | 2 | 每百万tokens |
| 输出(Batch File) | 8 | 每百万tokens |
| 显式缓存创建 | 5 | 每百万tokens |
| 显式缓存命中 | 0.4 | 每百万tokens |
| 输入(Batch Chat) | 4 | 每百万tokens |
| 输出(Batch Chat) | 16 | 每百万tokens |
海外区域价格
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 6 | 每百万tokens |
| 输出 | 24 | 每百万tokens |
| 输入(缓存命中) | 1.2 | 每百万tokens |
| 显式缓存创建 | 7.5 | 每百万tokens |
| 显式缓存命中 | 0.6 | 每百万tokens |
qwen3.7-plus的价格约为qwen3.7-max的三分之一,对于预算敏感但仍需要较强推理能力的场景,是非常理想的选择。
三、qwen3.7-flash大模型详细介绍
3.1 模型定位与核心优势
Qwen3.7-Flash是Qwen3.7系列中的"速度之王",专为高并发、低延迟、大批量的轻量级推理场景设计。Flash版本在保证基本推理质量的前提下,将推理速度和成本优化到了极致。
qwen3.7-flash的核心优势包括:
- 极速推理:模型经过深度优化,单次推理延迟极低,适合实时对话、流式输出等对速度敏感的场景。
- 超低成本:价格远低于Max和Plus版本,适合大规模、高频次的API调用。
- 免费额度:阿里云为Flash版本提供了较为慷慨的免费调用额度,降低了开发者的试用门槛。
- 轻量级智能体:虽然模型规模较小,但仍支持Function Calling等智能体基础能力,适合构建简单的自动化工作流。
3.2 模型能力
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 支持 | 模型调优 | 不支持 |
3.3 上下文限制
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| 最大输入长度 | 991,808 | 最大输出长度 | 131,072 |
| 上下文长度 | 1,000,000 | 最大输入长度(思考模式下) | 983,616 |
| 最大输出长度(思考模式下) | 131,072 | 最大思维链长度 | 262,144 |
令人惊喜的是,qwen3.7-flash同样支持100万tokens的上下文窗口,与Max和Plus版本保持一致。这意味着即使是轻量级模型,也能处理超长文本任务。
3.4 模型价格
华北2(北京)价格
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 1 | 每百万tokens |
| 输出 | 4 | 每百万tokens |
| 输入(缓存命中) | 0.2 | 每百万tokens |
| 输入(Batch File) | 0.5 | 每百万tokens |
| 输出(Batch File) | 2 | 每百万tokens |
| 显式缓存创建 | 1.25 | 每百万tokens |
| 显式缓存命中 | 0.1 | 每百万tokens |
| 输入(Batch Chat) | 1 | 每百万tokens |
| 输出(Batch Chat) | 4 | 每百万tokens |
海外区域价格
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 1.5 | 每百万tokens |
| 输出 | 6 | 每百万tokens |
| 输入(缓存命中) | 0.3 | 每百万tokens |
| 显式缓存创建 | 1.875 | 每百万tokens |
| 显式缓存命中 | 0.15 | 每百万tokens |
qwen3.7-flash的价格仅为Max版本的十二分之一,是三款模型中成本最低的选择。对于需要大量调用但对推理深度要求不极端的场景,Flash版本能够显著降低运营成本。
四、三款模型核心参数对比总览
为了更直观地展示三款模型的差异,以下从多个维度进行横向对比:
4.1 定位与适用场景对比
| 对比维度 | qwen3.7-max | qwen3.7-plus | qwen3.7-flash |
|---|---|---|---|
| 定位 | 旗舰级智能体模型 | 均衡型高性能模型 | 轻量级高速模型 |
| 适用场景 | 复杂推理、长周期任务、代码生成 | 通用业务场景、中等复杂度任务 | 高频调用、实时对话、简单任务 |
| 推理深度 | 极深(支持超长思维链) | 深度推理 | 基础推理 |
| 响应速度 | 较慢(模型大) | 中等 | 极快 |
| 成本 | 最高 | 中等 | 最低 |
4.2 价格对比(华北2北京区域,每百万tokens)
| 计费项 | qwen3.7-max | qwen3.7-plus | qwen3.7-flash |
|---|---|---|---|
| 输入 | 12元 | 4元 | 1元 |
| 输出 | 36元 | 16元 | 4元 |
| 输入(缓存命中) | 2.4元 | 0.8元 | 0.2元 |
| 显式缓存命中 | 1.2元 | 0.4元 | 0.1元 |
从价格梯度来看,三款模型形成了清晰的层次:Max是Plus的3倍,Plus是Flash的4倍,Max是Flash的12倍。这种梯度设计使得用户可以根据实际需求灵活选择。
4.3 上下文能力对比
三款模型在上下文能力上完全一致,均支持:
- 100万tokens总上下文窗口
- 最大输入991,808 tokens
- 最大输出131,072 tokens
- 思考模式下最大思维链262,144 tokens
这意味着在长文本处理能力上,三款模型没有差异,选择时无需考虑上下文限制因素。
五、选择建议:不同场景下的最优方案
5.1 选择qwen3.7-max的场景
- 复杂代码开发:需要模型理解大型代码库、进行多文件修改、架构设计等复杂编程任务。
- 长周期智能体任务:需要AI自主规划并执行多步骤工作流,如自动化研究报告生成、多轮数据分析等。
- 深度推理任务:数学证明、逻辑推理、策略规划等需要深度思考的场景。
- 企业级核心应用:对输出质量要求极高,预算充足的企业级项目。
5.2 选择qwen3.7-plus的场景
- 通用业务场景:客服对话、内容生成、知识问答等中等复杂度任务。
- 成本敏感的生产环境:需要较好性能但预算有限的中型项目。
- 批量处理任务:需要批量推理但又不需要顶级推理深度的场景。
- 智能体中间层:作为多智能体系统中的执行层模型使用。
5.3 选择qwen3.7-flash的场景
- 高频实时对话:在线客服、即时翻译等对延迟极度敏感的场景。
- 大规模数据处理:需要处理海量文本但单条任务相对简单的场景。
- 原型开发与测试:快速验证想法、进行A/B测试等开发阶段。
- 边缘计算场景:对成本极度敏感,需要大量并发调用的应用。
5.4 混合使用策略
在实际生产环境中,很多团队会采用"混合调用"策略:
- 使用qwen3.7-flash处理简单的前置分类和路由任务
- 使用qwen3.7-plus处理中等复杂度的核心业务逻辑
- 仅在遇到高难度任务时才调用qwen3.7-max进行深度推理
这种分层调用策略可以在保证整体服务质量的同时,将综合成本降低60%-80%。
六、缓存机制与成本优化技巧
6.1 上下文缓存
三款模型均支持上下文缓存功能。当多次请求共享相同的前缀内容(如系统提示词、背景文档等)时,缓存命中部分的输入费用仅为原价的20%。
优化建议:将不变的系统提示词和背景信息放在请求的前部,确保每次请求的前缀尽可能一致,以最大化缓存命中率。
6.2 显式缓存
显式缓存允许用户主动创建和管理缓存条目。创建缓存时需要支付额外费用(约为标准输入价格的125%),但后续命中时仅需支付原价的10%。
适用场景:对于需要反复引用同一段长文本(如产品手册、法律条款、技术文档)的应用,显式缓存可以带来显著的成本节约。
6.3 批量推理
Batch推理模式适用于不需要实时响应的离线处理场景。通过批量提交请求,可以享受约50%的价格折扣。
注意:批量推理目前仅在华北2(北京)区域支持,海外区域暂不开放此功能。
七、Qwen3.7系列模型选择参考指南
1、快速定位:三款模型一句话概览
| 模型 | 一句话定位 | 核心关键词 |
|---|---|---|
| qwen3.7-max | 旗舰级智能体模型,追求极致推理深度与复杂任务执行能力 | 最强、最深、最贵 |
| qwen3.7-plus | 均衡型高性能模型,性能与成本的最佳平衡点 | 性价比、通用、稳定 |
| qwen3.7-flash | 轻量级高速模型,极致速度与超低成本 | 最快、最便宜、高并发 |
2、核心参数速查对比
2.1 价格对比(华北2·北京,单位:元/百万tokens)
| 计费项 | qwen3.7-max | qwen3.7-plus | qwen3.7-flash | 倍率关系 |
|---|---|---|---|---|
| 输入 | 12 | 4 | 1 | Max = 12× Flash |
| 输出 | 36 | 16 | 4 | Max = 9× Flash |
| 输入(缓存命中) | 2.4 | 0.8 | 0.2 | — |
| 显式缓存命中 | 1.2 | 0.4 | 0.1 | — |
| 输入(Batch) | 6 | 2 | 0.5 | — |
| 输出(Batch) | 18 | 8 | 2 | — |
快速记忆:Max ≈ Plus × 3 ≈ Flash × 12(输入维度)
2.2 能力对比
| 能力项 | qwen3.7-max | qwen3.7-plus | qwen3.7-flash |
|---|---|---|---|
| 上下文窗口 | 100万 tokens | 100万 tokens | 100万 tokens |
| 最大输出 | 131,072 tokens | 131,072 tokens | 131,072 tokens |
| 思维链长度 | 262,144 tokens | 262,144 tokens | 262,144 tokens |
| Function Calling | ✅ | ✅ | ✅ |
| 结构化输出 | ✅ | ✅ | ✅ |
| 联网搜索 | ✅ | ✅ | ✅ |
| 前缀续写 | ✅ | ✅ | ✅ |
| 上下文缓存 | ✅ | ✅ | ✅ |
| 批量推理(北京) | ✅ | ✅ | ✅ |
| 批量推理(海外) | ❌ | ❌ | ❌ |
| 模型调优 | ❌ | ❌ | ❌ |
2.3 推理性能定性对比
| 维度 | qwen3.7-max | qwen3.7-plus | qwen3.7-flash |
|---|---|---|---|
| 推理深度 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| 响应速度 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 代码能力 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| 长周期任务 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐ |
| 简单问答 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 成本效益 | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
3、场景化选择指南
3.1 选 qwen3.7-max 的场景 ✅
| 场景 | 说明 |
|---|---|
| 复杂代码开发 | 大型代码库理解、多文件重构、架构设计 |
| 深度推理 | 数学证明、逻辑推理、多步策略规划 |
| 长周期智能体 | 自主规划并执行多步骤复杂工作流 |
| 高质量内容生成 | 深度研究报告、专业文档撰写 |
| 企业核心系统 | 对输出质量要求极高、预算充足 |
典型用户画像:大型企业AI团队、AI Agent开发者、对质量有极致要求的产品经理
3.2 选 qwen3.7-plus 的场景 ✅
| 场景 | 说明 |
|---|---|
| 通用业务应用 | 客服对话、内容创作、知识问答 |
| 中等复杂度任务 | 数据分析摘要、文档总结、邮件撰写 |
| 批量处理 | 大规模文本分类、信息抽取 |
| 智能体执行层 | 多Agent系统中的中间执行节点 |
| 成本敏感生产环境 | 需要较好性能但预算有限 |
典型用户画像:中型企业技术团队、SaaS产品开发者、内容平台运营团队
3.3 选 qwen3.7-flash 的场景 ✅
| 场景 | 说明 |
|---|---|
| 高频实时对话 | 在线客服、即时翻译、语音助手 |
| 大规模轻量处理 | 海量文本分类、情感分析、关键词提取 |
| 原型验证 | 快速验证产品想法、A/B测试 |
| 前置路由/分类 | 作为多模型调度系统的"前置判断器" |
| 高并发场景 | 需要同时处理大量请求的系统 |
典型用户画像:初创团队、高频调用场景开发者、成本敏感的独立开发者
4、决策流程图
你的核心需求是什么?
│
├─ 需要深度推理/复杂代码/长周期自主执行?
│   └─ YES → 选择 qwen3.7-max
│
├─ 需要较好的推理能力,但预算有限?
│   └─ YES → 选择 qwen3.7-plus
│
├─ 需要极快响应速度或超低成本?
│   └─ YES → 选择 qwen3.7-flash
│
├─ 不确定?
│   └─ 先用 qwen3.7-flash 做原型验证
│       → 效果不够再升级到 Plus
│       → 仍不够再升级到 Max
│
└─ 多种场景混合?
    └─ 采用"分层调用"策略(见下文)
5、分层调用策略(推荐)
对于生产环境,推荐采用分层调用架构,将不同复杂度的任务路由到不同模型:
用户请求
    │
    ▼
┌─────────────────┐
│  qwen3.7-flash  │  ← 第一层:意图识别、简单问答、路由分类
│  (成本最低)     │
└────────┬────────┘
         │ 判断任务复杂度
         ▼
┌─────────────────┐
│  qwen3.7-plus   │  ← 第二层:中等复杂度任务执行
│  (性价比最优)   │
└────────┬────────┘
         │ 遇到高难度任务
         ▼
┌─────────────────┐
│  qwen3.7-max    │  ← 第三层:深度推理、复杂规划
│  (能力最强)     │
└─────────────────┘
预期收益:综合成本降低 60%~80%,同时保证关键任务的输出质量。
6、常见问题 FAQ
Q1:三款模型的上下文窗口有区别吗?
A:没有区别。三款模型均支持100万tokens上下文窗口、131,072 tokens最大输出、262,144 tokens最大思维链。选择时无需考虑上下文限制。
Q2:Flash模型能胜任智能体任务吗?
A:qwen3.7-flash支持Function Calling和结构化输出,可以胜任简单的智能体任务(如单步工具调用、简单工作流)。但对于需要多步规划、长周期执行的复杂智能体任务,建议使用Max或Plus。
Q3:可以先用Flash测试,再切换到Max吗?
A:完全可以。三款模型的API接口兼容,切换模型只需更改模型名称参数。建议先用Flash验证业务逻辑,确认需要更强推理能力时再升级。
Q4:思考模式(Thinking)会增加多少成本?
A:思考模式下,模型会生成额外的思维链内容(最长262,144 tokens),这部分按输出价格计费。如果任务不需要深度推理,可以考虑关闭思考模式以节省成本。
Q5:海外区域和北京区域的能力有差异吗?
A:主要差异在于批量推理功能——海外区域暂不支持Batch推理。其他核心能力(Function Calling、结构化输出、联网搜索等)各区域一致。
Q6:如何获取最新优惠信息?
A:请前往阿里云百炼控制台查看。平台会不定期推出新用户免费额度、限时折扣、资源包优惠等活动。
7、决策总结
| 你的情况 | 推荐模型 | 理由 |
|---|---|---|
| 预算充足,追求极致效果 | qwen3.7-max | 最强推理,智能体能力最佳 |
| 需要好效果,但关注成本 | qwen3.7-plus | 性能接近Max,价格仅1/3 |
| 高并发、低延迟、大批量 | qwen3.7-flash | 速度最快,成本最低 |
| 刚开始探索,不确定需求 | qwen3.7-flash | 先低成本验证,再按需升级 |
| 生产环境,混合场景 | 分层调用 | Flash路由 + Plus执行 + Max深度推理 |
| 离线批量处理 | 任意 + Batch模式 | 享受约50%折扣(限北京区域) |
八、最新活动与优惠信息
qwen3.7-max、qwen3.7-plus、qwen3.7-flash 这三个模型均提供免费试用额度:
免费额度
- 新用户赠送: 百炼平台新用户开通即享超 1 亿免费 Tokens。
- 模型体验额度: 登录后每个模型免费赠送 100 万 tokens 推理额度(结合历史对话上下文补充)。
- 注意: qwen3.7-max、qwen3.7-plus、qwen3.7-flash各自有独立的额外免费额度,详情可通过百炼平台了解:https://www.aliyun.com/product/bailian
订阅计划与优惠活动
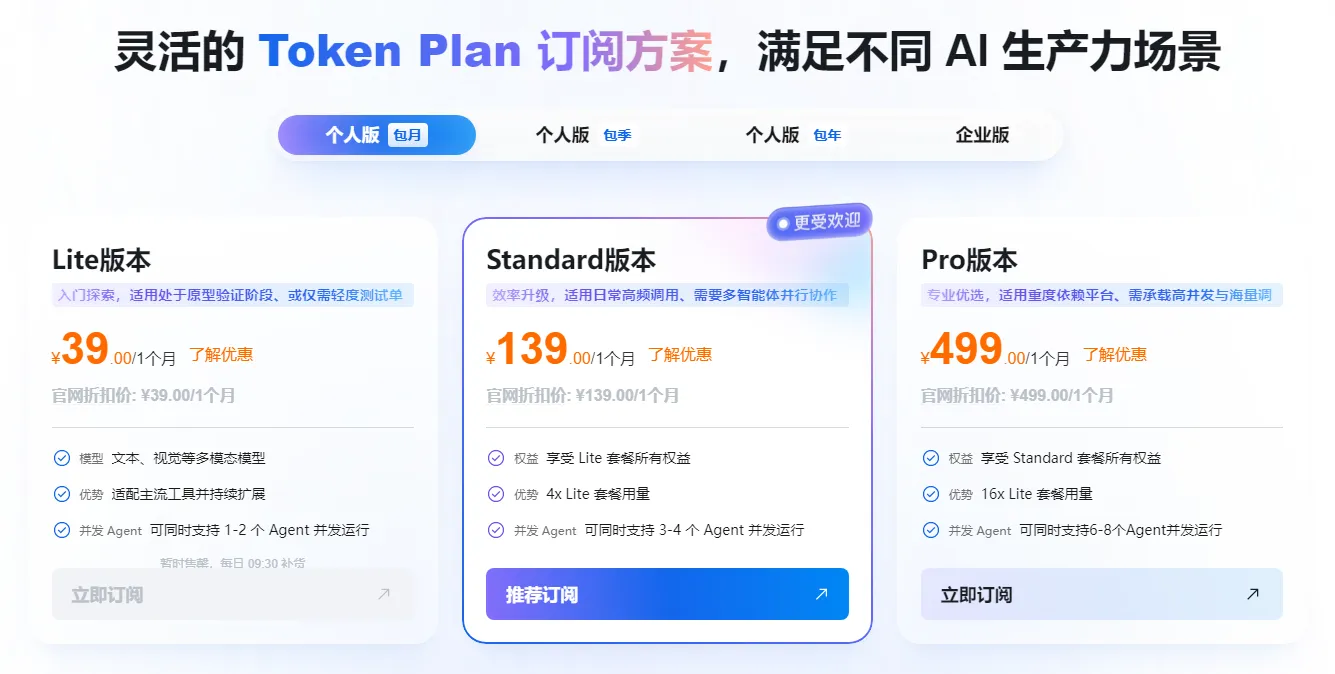
- Token Plan 个人版: 百炼平台提供 Lite(39元/月)、Standard(139元/月)、Pro(499元/月)三档套餐,包含基础额度及夜间调用优惠等权益。活动详情可参考:https://www.aliyun.com/benefit/scene/tokenplan
- 限时折扣: 根据百炼产品页展示,qwen3.7-plus 和 qwen3.7-flash 的部分计费项存在限时折扣(如输入/输出 8 折、Batch Chat 5 折等),qwen3.7-max 的 Batch Chat 计费项也展示有限时 5 折优惠。具体折扣适用范围、有效期及最新活动价格,活动详情可参考:https://www.aliyun.com/benefit/client/nightplan
九、总结
Qwen3.7系列的三款模型——qwen3.7-max、qwen3.7-plus、qwen3.7-flash——构成了一个完整的产品矩阵,覆盖了从顶级推理到轻量调用的全谱系需求。它们共享相同的100万tokens上下文窗口,在基础能力上保持一致,差异主要体现在推理深度、响应速度和价格三个维度。
对于技术决策者而言,选择的关键在于明确自身业务的核心需求:如果追求极致的推理质量和智能体能力,qwen3.7-max是不二之选;如果需要在性能和成本之间找到平衡,qwen3.7-plus是最优解;如果面临高并发、低延迟、大批量的挑战,qwen3.7-flash则是最经济高效的方案。
随着大模型技术的持续演进,我们有理由期待Qwen3.7系列在后续版本中带来更多惊喜——无论是多模态能力的开放、更高效的推理架构,还是更丰富的智能体工具生态。在这个AI驱动的新时代,选对模型,就是选对了通往未来的路。