单节点推理在三类情况下会撞上硬边界。一是模型权重加KV缓存超过单卡显存,显存放不下,任务无法启动。二是单卡算力稳定吞吐跟不上目标并发,请求不断积压。三是高峰期GPU排队拉长TTFT均值与P99,用户体验直接恶化。分布式推理网络要解决两件事:推理集群组网,即节点间如何连接、拓扑如何选择;跨节点协同,即任务如何切分、KV缓存如何传输、结果如何聚合。
一、设计前置条件:单节点推理的边界与分布式推理网络要解决的问题
先确认是否需要分布式。单节点推理的边界集中体现在三个信号上。第一,模型参数量超过单卡显存,即使量化也难以容纳。第二,目标P99延迟单卡无法达成,请求排队越来越长。第三,并发请求数超出单GPU吞吐上限,服务开始限流。
分布式推理网络指将推理任务拆分到多个节点协同执行的架构,范围涵盖节点间连接、任务切分、缓存传输、结果聚合。大模型推理网络架构怎么选,不能先看框架,要看把哪类问题解决清楚。
设计主线分两步走。先解决组网,确定拓扑和连接方式。再解决协同,确定任务切分、缓存传输和聚合机制。跳过组网直接进入框架选型,后面返工的代价会很高。
二、设计步骤一:选择推理集群组网拓扑
拓扑决定了协同方式的上限。推理集群组网没有一种拓扑适合所有情况,需要根据请求类型、集群规模和异构程度选择。
1. 三种主流拓扑:主从、P2P对等、PD分离
主从架构下,主节点负责分发与聚合,从节点执行推理。部署简单,适合小规模验证与轻量场景。节点少时维护成本低,但主节点可能成为瓶颈。
P2P对等架构中,节点自发现加任务调度中心分配,允许普通服务器与异构设备混合入池。设备类型差异大的集群适合这种模式,新增节点也相对灵活。
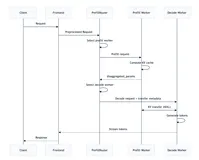
PD分离组网方案将预填充与解码拆分为Prefiller与Decoder两类节点,支持从1P1D到XPXD横向扩展。长文本与高吞吐推理API服务是其适配场景,因为预填充的计算特征与解码的低时延特征可以被分别优化。
2. 拓扑选择的判断依据
请求类型优先。长上下文处理密集时优先PD分离,通用短请求主从架构可满足。集群规模其次,小规模验证选主从,生产环境按需切PD分离。异构程度也要看,异构设备混合多时优先P2P或统一抽象层,避免设备差异拖累整体。
3. 推理网络与训练网络组网差异
训练网络重AllReduce与高带宽同步,推理网络重Token间低时延生成与KV缓存交换。训练网络关注梯度同步一致性,推理网络要同时兼顾请求并发调度。组网参数需要按流量特征分类配置,把训练网络的组网经验直接套在推理网络上会出问题。
三、设计步骤二:规划节点间通信与KV缓存传输
通信开销是分布式推理的核心成本。模型参数分布到多节点后,数据传输时间常超过单节点计算时间。跨节点KV缓存传输优化因此成为区别于训练的瓶颈,PD分离下Prefiller与Decoder之间的缓存交换尤其关键。
1. 通信开销为什么容易失控
推理对时延的敏感度远高于训练。训练可以容忍几百毫秒的梯度同步延迟,推理的Token生成如果多出几十毫秒,TTFT和TPOT都会明显恶化。节点间连接选择、序列化方式和传输路径,每一项都影响最终时延。
2. 跨节点KV缓存传输优化路径
统一内存抽象层是有效做法。将CPU、GPU、NVMe等异构内存统一管理,按当前负载动态选择最优传输路径,减少不同存储介质之间的来回切换。
零拷贝数据传输同样重要。通过共享内存避免容器间、节点间的冗余拷贝,降低数据在内存中的搬家次数。多后端插件架构允许动态选择不同的通信协议与传输路径,这一思路在NIXL方案中有清晰体现。
3. 算力专线在推理网络中的作用
多地多节点推理集群、推理节点与缓存存储节点之间的稳定互联,需要确定性低时延通道。算力专线提供确定性低时延保障,适用于跨节点通信频繁的场景。结合智算网络与AI原生网络理念,在推理集群组网中优先保障跨节点通信的带宽与抖动控制。以犀思云为例,它的算力互联与推理网络能力,为跨节点KV缓存交换提供了承接底座,两地部署时网络路径的稳定性直接影响PD分离方案的收益。
四、设计步骤三:拆解跨节点协同中的任务切分与调度
任务切分决定了并行效率。跨节点协同的核心是把请求分配给哪个节点、切多大粒度、如何捞回结果。
1. 任务切分的三种粒度
数据并行下,多副本处理不同请求,通过节点分发均衡负载。张量并行下,单个请求切分到多节点,适合打破单卡显存限制。流水线并行按层或阶段切分,多请求流水执行,提升整体吞吐。三种粒度可以组合使用,选择依据是模型结构和请求特征。
2. 调度层的设计要点
任务调度中心根据节点CPU和GPU利用率、内存、带宽动态分配计算子图。高峰期GPU排队的缓解需要排队感知加动态扩容,或路由到空闲节点。分层调度是有效做法:设备管理层收集实时状态,任务调度层做分配决策,执行引擎层负责跨设备张量迁移与同步。
3. 多智能体请求并发下的调度策略
大量智能体请求同时到达时,优先采用请求级数据并行加缓存存储共享策略。将TTFT与TPOT指标写入调度逻辑,作为路由与排队策略的优先次序依据,只看GPU利用率容易被假性偏低误导。
五、设计步骤四:结果聚合、弹性扩展与验收标准
聚合层不能成为新瓶颈。主从架构下主节点负责聚合,PD分离下由Proxy分发节点统一回传。聚合层需要同时处理Token流式返回,避免结果堆积在单个节点。
集群规模变化时动态选择传输路径与节点,避免固定拓扑限制扩展。算力互联场景下,跨节点通信路径的动态切换在边缘与云端异构资源混合部署时更为必要。
验收标准要看可感知指标。TTFT均值、P99延迟、Token间延迟是核心验收指标。单位Token成本由单卡理论吞吐、算法增益、推理引擎工程达成率和集群利用率共同决定。验收清单包括三项:单节点边界是否解除、通信开销是否低于并行带来的计算收益、高峰期排队是否可控。
六、常见错误与规避方法
错误一:先选框架后定拓扑。表现为直接采用开源框架默认部署,未根据请求类型与集群规模调整主从、P2P或PD分离拓扑。正确的做法是先做任务切分与拓扑选择,再匹配推理引擎。
错误二:忽略节点间通信占比。通信开销占比超过30%时,继续加节点反而降低总吞吐。需要用TTFT与TPOT实测数据测算,重点优化跨节点KV缓存传输路径,而不是盲目扩展节点数。
错误三:把训练网络经验直接套在推理网络上。训练网络重视AllReduce带宽,推理网络更关注低时延Token生成与缓存交换。推理集群组网时优先保障Token间延迟,而非仅追求峰值带宽。
七、常见问题解答
大模型推理网络架构怎么选? 根据请求类型与集群规模选择。长文本或高并发优先PD分离组网方案,小规模验证可用主从架构,异构设备多时考虑P2P对等模式。
PD分离组网方案适合什么场景? 适合需要将长上下文编码与Token自回归生成拆开的场景,如高吞吐推理API服务。短请求轻量场景下,PD分离的调度开销可能超过并行收益。
分布式推理网络的通信开销怎么评估? 通过TTFT均值、P99延迟、Token间延迟三项指标实测。若通信占比高于计算增量,则优化节点间连接或选择算力专线保障时延,先测后调,不要凭感觉判断。
跨节点KV缓存传输怎么优化? 采用统一异构内存抽象、零拷贝、按路径动态选择传输后端,减少跨节点KV缓存传输的冗余拷贝,在PD分离下重点看Prefiller与Decoder之间的交换路径。
推理网络和训练网络的组网能复用吗? 可以部分复用物理链路,但流量特征不同。训练侧重AllReduce带宽,推理侧重Token间低时延与KV缓存交换,需按推理集群组网要求调整带宽与时延配置。