专注于 Infra 层的 AI Agent 技能平台——龙蜥社区 SkillHub 已收到数百个技能,当前陆续上线中。我们每周也会收到一些技能的最佳实践分享,本期给大家推荐的是来自王阳科贡献的 AnolisOS-SysDiag Skill 实践文章,他拥有十年移动端研发经验,现在做研究 FDE,之前主导过 60 万 DAU 应用的稳定性治理,OOM、Crash 这类线上事故排查没少干,日常活跃在上海 GDG、HDG 等技术社区。这次给龙蜥 SkillHub 提交 AnolisOS-SysDiag,就是把踩过的排查经验切成一个能被 AI Agent 直接调用的 Skill,帮助大家少走弯路。
以下是他的实战经验分享:
从一条告警短信说起
说出来大家可能不信——做这个 Skill 的念头,是在凌晨两点被一条告警短信炸出来的。
当服务器 CPU 飙到 95%,群里开始刷屏。我迷迷糊糊打开电脑,连 VPN,依次敲 top、 iostat、 vmstat,切了七八个终端窗口,花了近四十分钟才定位到问题:定时任务里的一个脚本写满了磁盘,IO Wait 导致 CPU 空转。
问题本身不复杂。但整个过程让人疲累——同样的排查套路,我可能重复了几百次了。每一步都是机械劳动,真正需要动脑子的「关联分析」只占了最后五分钟。当时我就想:如果有个工具能帮我跑命令、读输出、把 CPU、IO、内存的数据串起来分析,我只做最终判断,效率会高很多。
恰逢龙蜥社区联合 AMD 举办了「Skill 创造营」征集活动,我一看方向是操作系统运维,这不就是我最想做的事吗,于是就有了 AnolisOS-SysDiag。
为什么 Infra 层的 Agent 还是一片荒地
这两年 AI Agent 在应用层已经十分成熟,写代码、查数据库、做 PPT 的 Skill 遍地开花。但到了操作系统这一层,Agent 的能力明显断层。
你让它「帮我查下这台机器为什么这么卡」,它基本只能尴尬地说「建议你运行 top 命令查看 CPU 使用情况」。就这?我要它干嘛?
说白了,真正的令人头疼就是以下三个方面:
1、排查依赖人工堆叠。CPU 高了看 top,内存不够看free,磁盘慢了看 iostat,网络有问题看 ss。十几个命令轮番执行,其输出格式各异,需要靠经验在脑中拼接碎片信息、推测根因。说实话,没个三五年经验真干不了这活。
凌晨三点被叫起来查问题是什么体验?懂的都懂。MTTR 动辄半小时起步,这还是你经验够丰富的情况下。
2、定位到问题后缺乏修复指引。就算你定位到问题,是 page cache 占用过高,也不清楚vm.vfs_cache_pressure 该设为 200 还是 500,也不了解当前 Anolis OS 版本是否存在已知兼容性问题。
这些答案散落在/etc/sysctl.conf、/proc/sys/、内核文档、社区帖子里,没有一个地方能直接告诉你「就改这个参数,改成这个值,改完记得检查这个」。而 Anolis OS 的内核做了不少定制——Group Identity 调度、SLO 调度器、cgroup v2 增强——通用的 Linux 调优建议在龙蜥上不一定是最优解,甚至可能产生反效果。
3、也是最让我不甘心的:这活干久了,人会变笨。不是开玩笑。你想想,一个高级运维工程师,每天花最多时间在干嘛?敲 vmstat、敲 iostat、敲 netstat——这些操作,说句不好听的,一个脚本就能搞定。
真正值钱的是什么?是设计高可用的架构,是提前做容量规划,是在问题还没发生的时候就把它掐死在摇篮里。可惜,这些时间全被无穷无尽的「人肉排查」吃掉了。
这个 Skill 到底能干什么
一句话版本:你告诉它「帮我诊断这台机器」,它帮你跑完所有该跑的命令,帮你分析完所有该分析的数据,然后甩给你一份报告——根因是什么、怎么修,一次性说清楚。
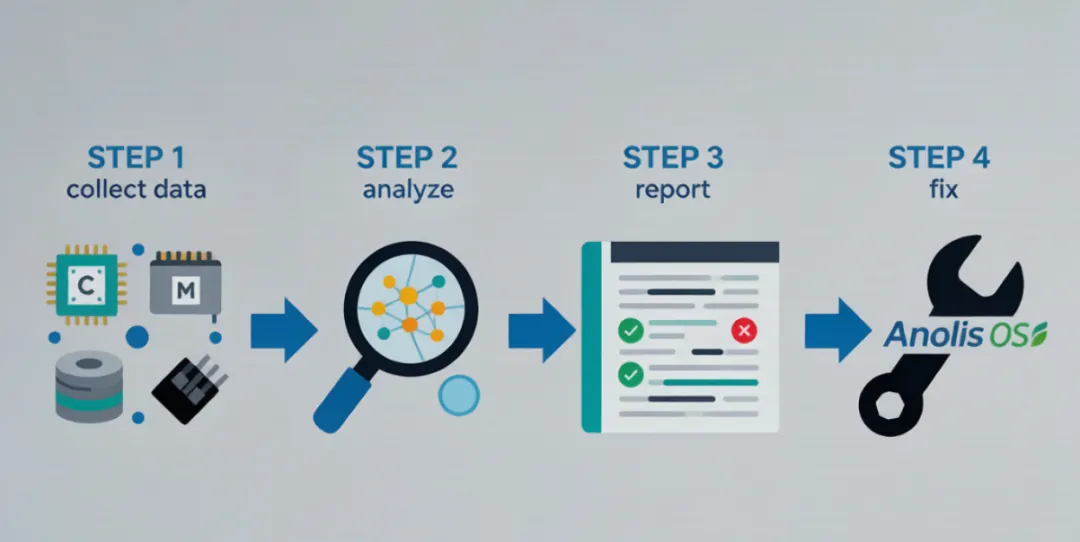
展开说大概是以下这四个能力:
一键采集,四大维度全覆盖
CPU、内存、磁盘 IO、网络——运维诊断的「四大件」,一次全采完。你不用记命令、不用管参数、不用开七八个终端窗口。
| 维度 | 它能帮你查什么 | 它能帮你看出什么 |
| CPU | 使用率、负载、上下文切换、软中断、运行队列 | 谁在吃 CPU、调度有没有延迟、软中断是不是在搞事 |
| 内存 | 使用量、缓存、Swap、OOM 记录、页错误 | 有没有内存泄漏、缓存是不是反客为主了、Swap 是不是在疯狂抖动 |
| 磁盘 IO | IOPS、吞吐、延迟、队列深度、利用率 | 哪块盘最忙、是什么 IO 模式、延迟有没有异常 |
| 网络 | 带宽、连接数、重传率、丢包、延迟 | TCP 有没有拥塞、连接是否异常、网卡中断是不是不均衡 |
自动关联分析,不只是堆数据
这是我最花心思的部分。
市面上很多监控工具能采集数据,但它们做的只是「采集+ 展示」。CPU 高了就告诉你 CPU 高了,磁盘慢了就告诉你磁盘慢了——这叫 symptom,不叫 diagnosis。
真正有用的是关联分析。比如说:CPU 的 iowait 很高 + 磁盘 await 也高 + 内存的 page cache 占比异常 = 不是CPU 的问题,是内存回收太频繁导致的 IO 抖动。这种跨维度的推导,以前是工程师脑子里的事,现在Skill 帮你做了。
Anolis OS 专属调优——不是通用 Linux 方案
这是跟其他诊断工具最大的区别。
Skill 内置了 Anolis OS 特有的内核知识,检测到运行环境是龙蜥之后,会自动走专属的调优路径。比如:
Group Identity:龙蜥内核的任务分组调度,能按业务优先级动态分配 CPU——Skill 会告诉你该不该开、怎么配。
SLO 调度器:面向服务质量目标的调度策略,不是一刀切的 CFS。
sysAK 工具链:龙蜥自研的诊断工具集,覆盖内核日志分析、异常事件追踪。
不是给你一个「建议调大 vm.swappiness」这种放之四海而皆准的话,而是告诉你具体的参数名、推荐值、在哪个配置文件里改、改完怎么验证。
跟主流 Agent 客户端全兼容
支持 Claude Code、Cursor、Gemini CLI、Windsurf、OpenCode 等主流 Agent 客户端。Skill 的 tools 部分可以暴露成 MCP Server,不挑框架、不造新轮子。
真实可用的场景
场景一:线上突然变慢,3 分钟出结论
以前是这样:
告警响了 → 登录服务器 → top 看一眼 → vmstat 看一眼→ iostat 看一眼 → ss 看一眼 → 皱着眉头想一会→ 不行再跑一遍 → 终于猜出个大概 → 开干差不多半小时过去了。复制
现在是:
告警响了 → 对 Agent 说「诊断这台机器」→ 3 分钟后收到报告。复制
报告长这样:
✅ CPU:正常⚠️ 内存:page cache 占 78%,可用内存不足 5%,发生了 3 次内存回收事件⚠️ 磁盘 IO:await 平均 45ms,明显偏高✅ 网络:正常📌 根因:文件系统缓存过量占用内存,频繁触发内存回收, 间接导致磁盘 IO 延迟升高🔧 建议操作: 1. sysctl -w vm.vfs_cache_pressure=200 2. sysctl -w vm.min_free_kbytes=524288 3. 重启相关服务后监控 10 分钟确认恢复复制
说实话,看到这种级别的输出,你还需要自己去翻文档吗?
场景二:新人也能当「半个老师傅」
我带过不少新人,最头疼的就是教排查。不是他们不聪明,是这玩意太吃经验——你很难用一句话说清楚「为什么 CPU 高要看 iostat,为什么 await 高了你该去看内存的 page cache」。
有了这个 Skill,新人说一句话就能拿到诊断结果,老工程师也能从重复性排查里抽出身来做更有价值的事。说白了就是知识平权——好的排查经验不应该跟着人走,应该跟着工具走。
场景三:7×24 自动守护
配合 SysOM Agent (是 SysOM 的智能助手)的纳管能力,可以做成一个完整的自动化闭环:
SysOM 检测到异常 → Agent 自动触发诊断 → 报告推到钉钉群复制
群里收到的不是「CPU 使用率 95%」这种废话,而是「dd 进程写满 /data/logs,建议 kill 后调整日志轮转策略」。
不是推告警,是推根因+ 修复方案。 人只需要在最后一步做决策——这才是自动化该有的样子。
做 Skill 的过程和一些踩过的坑
第一步:想清楚到底要解决什么问题?
写代码之前,我先问了自己四个问题:
- 解决什么? 四大资源的一键诊断,不是万能工具箱。
- 给谁用? Anolis OS 的运维、SRE、系统管理员。
- 和已有工具差在哪? 不是再造一个 top,是让 Agent 替你跑、替你读、替你分析。
- 龙蜥特色在哪? 内核级专属调优,不是泛泛的 Linux 建议。
这个阶段最难的其实是「做减法」。一开始我想把进程诊断、cgroup 分析、eBPF 追踪全塞进去。后来想明白了——一个 Skill 就做好一件事。贪多嚼不烂,用户也会懵。
第二步:写 SKILL.md,把经验「翻译」成 Agent 能懂的话
写 Skill 这件事,最核心的其实不是技术,是表达——你怎么把一个资深工程师脑子里的排查经验,变成 Agent 能一步步执行的指令。
三个建议:
- description 要写到一眼就能知道什么时候该用它。我反复改了七八版,最后定下来:「当用户报告CPU/内存/磁盘/网络性能异常时使用此技能,自动采集指标、定位瓶颈、输出 Anolis OS 调优建议」。
- 工作流要结构化,别让 Agent 自由发挥。每一步该跑什么命令、怎么解读输出、出什么格式——写得越清楚,Agent 执行越稳定。
- context 才是真值钱的。命令列表谁都能搜到,但「某个内核参数在 Anolis OS 23 上的已知问题」「某类 IO 调度器在 NVMe 盘上的兼容性数据」——这些才是你的独家价值
第三步:规范提交。
走的是龙蜥代码仓 PR 的方式,fork 了 anolis-skills 仓库,把 SKILL.md 放进去,提 PR。社区的 AI 审核会自动检查格式和规范,所以只要你的 SKILL.md 没问题,审核基本秒过。
踩过的几个坑,帮你省点时间
- 别贪大求全:一个 Skill 做好一件事。我最初想做成「系统诊断全家桶」,后来拆成了四个独立的 Skill,每个都更聚焦、更好维护
- 解读逻辑必须写进去:只告诉 Agent 跑 iostat -x 1 5 是不够的。必须写明「await > 10ms 说明 IO 延迟偏高,%util > 80% 说明磁盘接近饱和」——这才是把经验编码进去的关键一步。
- 要说清楚边界:你的 Skill 能做什么、不能做什么,在 SKILL.md 里写明确。让 Agent 知道什么时候该说「这个不在我的范围内」。
后续规划
短期打算做三件事:
- 接 eBPF,做无侵入的内核级诊断——不用装 Agent 也能看到内核里发生的事
- 加历史对比——不止看现在快照,还能对比昨天同一时刻的数据,判断是突发还是趋势
- 批量诊断——一键扫整个集群,不用一台一台登
再往后,我希望这个 Skill 能和其他社区 Skill 联动。比如诊断出「某个进程内存泄漏」,自动推荐内存分析 Skill 来深入排查——诊断 → 分析 → 修复,一条线打通。
当然,最期待的还是它能入选 Agentic OS 的预装池——每一台龙蜥服务器出厂时就自带一个「AI 运维助手」。我觉得这才是操作系统该进化的方向。
写在最后
如果你也是一个天天跟服务器打交道的人,你一定懂我在说什么。
敲了十年命令行的运维老兵,脑子里攒了无数排查经验——哪些参数该调、哪些坑不能踩、哪种 IO 模式在什么场景下会出问题。但这些东西,目前只能靠「人教人」来传承。
Skill 给了这些经验一个全新的出口。不再是写到 Wiki 里等别人来翻,而是切成一个个能直接被 Agent 加载、调用、执行的「技能包」。
运维的价值不在于你能多快地敲出 vmstat 1 10,而在于你能设计出什么样的系统、做出什么样的判断。
如果你也有独家的排查心得、踩坑笔记,不妨试试把它写成一个Skill 提交到 SkillHub。一篇好文章、一个好 Skill——这些东西的影响,远比你想象的大。
相关链接:
AnolisOS-SysDiagskill 链接,欢迎使用:
https://skillhub.openanolis.cn/skill/anolisos-sysdiag
Skillhub 官网链接:https://skillhub.openanolis.cn
相关文章推荐:「龙蜥 Skill 精选推荐」:一句话搞定 PG 集群部署和管理
龙蜥社区 Skill 征集活动—— 「Skill 创造营」上线以来响应热烈。截至目前,龙蜥 SkillHub 已收到覆盖安全、系统运维、AI 推理、数据库等多个领域,一个面向 Infra 的 AI 技能生态正在加速成型。「Skill 创造营」持续征集中,诚挚欢迎每一位开发者提交你的 Skill 与最佳实践。如果你有感兴趣的方向或者关于 SkillHub 的问题,欢迎通过下方链接反馈给我们。SkillHub 用户需求收集链接: https://alidocs.dingtalk.com/notable/share/form/v014jKqm0b74KdjLnw1_f22ghuX_M7AJs3D
—— 完 ——