
2026 年再做一个 AI 论文产品,听起来已经不算什么新鲜事。
ChatGPT 能写摘要,Claude 能读长文档,各种面向科研的 AI 工具也已经覆盖了文献检索、论文润色、引用管理和写作。只要把实验结果和要求丢进聊天框,几分钟后,一段语法正确、结构完整,甚至颇有“论文腔”的文字就能生成出来。
如果衡量标准只是“AI 能不能写论文”,这个问题似乎早就解决了。
但真正写过论文的人,可能会遇到一个有些荒诞的场景:左边开着 Overleaf,右边开着 AI,中间是实验结果、Excel、PDF 和几十篇参考文献。你从论文里复制一段给 AI,告诉它“只改这一段”;AI 改完以后,再复制回 LaTeX。接着发现一个实验数字被它顺手改了,于是再次告诉它“83.7% 是实验结果,不要修改”;下一轮,数字保住了,原来的引用却没了。最后,你开始在 Prompt 里反复强调:“不要改其他地方”“保留原引用”“输出 LaTeX”“只修改第三段”。
AI 确实已经参与了科研写作,只不过人变成了几个工具之间最忙的那个接口。
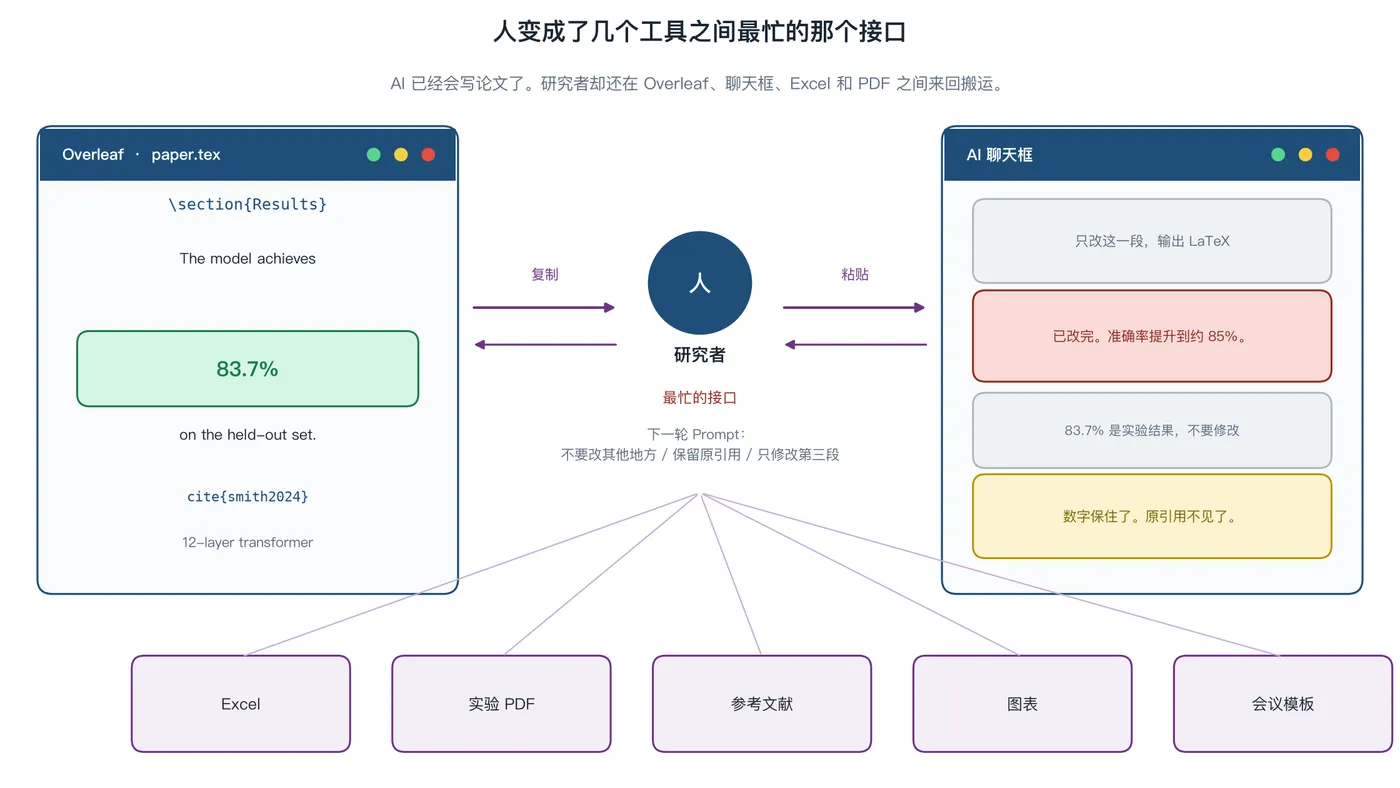
图注:示意。左边是正在写的论文,右边是聊天框,中间是研究者本人。Excel、PDF、参考文献和会议模板并不在模型的上下文里,只能靠人来回搬运。建议题图可用本图(约 16:9)。
Textira 就是在这样的背景下出现的。它没有把自己定义成另一个“帮你生成论文”的聊天机器人,而是试图回答一个更麻烦的问题:既然 AI 已经会写论文了,为什么研究者还在自己搬运上下文?
AI 写论文最难的,已经不是“写”
把一组实验结果变成一段 Results,对今天的大模型来说并不困难。真正困难的是,当这组实验结果进入一篇已经写了 12 页、有 40 篇参考文献、17 个实验数字和若干图表的论文之后,AI 还能不能准确知道哪些东西可以改,哪些不能改。
这也是“生成一篇论文”和“完成一篇论文”之间最容易被忽略的差别。
一篇真实论文并不是一次生成出来的。实验可能今天做完一组,下周再补一组;Introduction 已经修改了五遍,Results 里的一个指标却刚刚更新;审稿人要求增加消融实验,新的结果出来以后,正文、表格、摘要甚至结论中的数字都可能需要同步。投稿目标从一个会议换到另一个会议,页数、模板、参考文献格式和文章叙事也可能随之改变。
在这个过程中,写作只是最后呈现出来的结果。真正不断变化的是论文背后的“状态”。
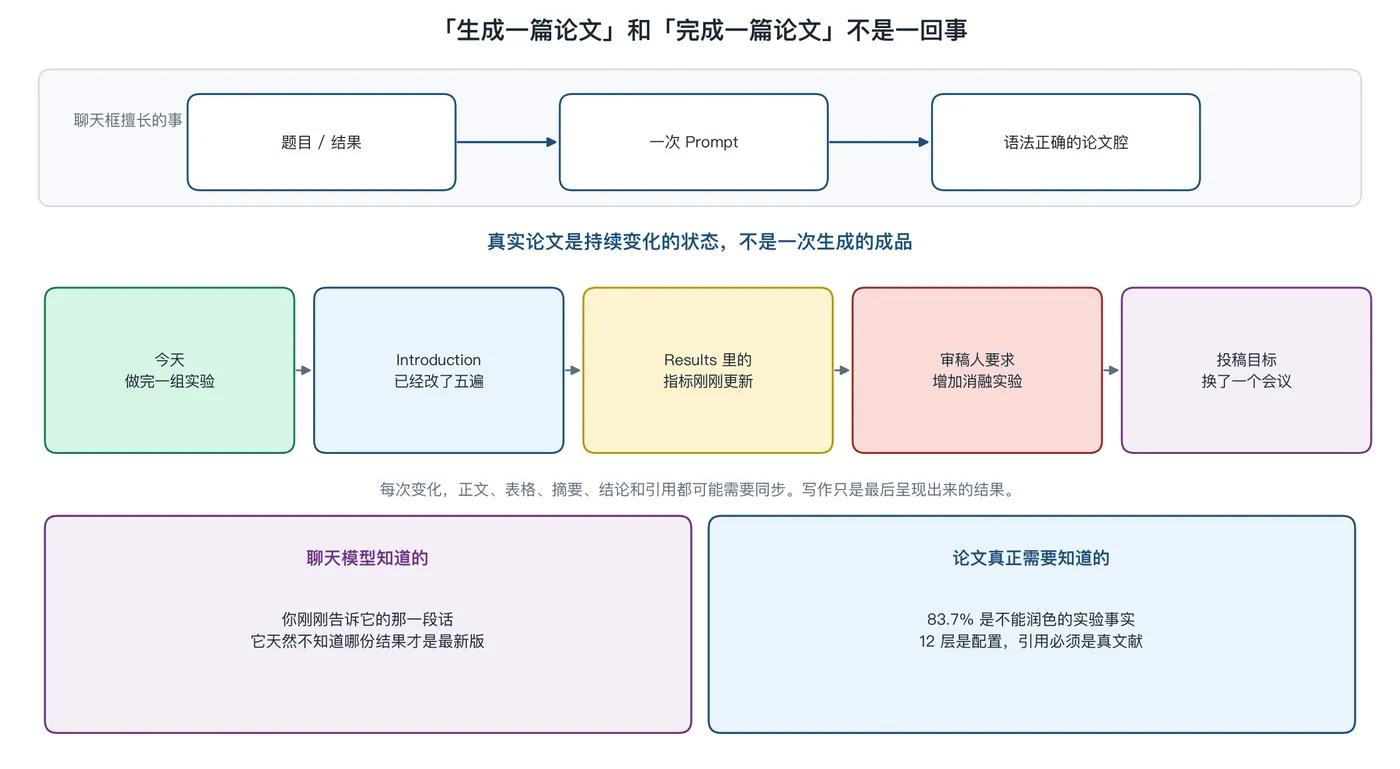
图注:聊天框擅长一次生成。真实论文是持续变化的状态:实验、章节、数字、审稿意见和投稿目标都会改,而且往往不同步。模型知道你刚刚告诉它的话,却不知道哪一份结果才是最新版。
这恰恰是聊天框不擅长处理的东西。聊天模型知道你刚刚告诉了它什么,却天然不知道电脑里哪份实验结果才是最新版本,也不知道论文中的 83.7% 是一个经过实验得到、不能随意润色的事实,还是作者随手写下、可以重新表达的文字。对于普通写作来说,把一句话改得更顺可能意味着质量提升;对于科研写作来说,多改一个数字,就可能意味着整篇论文不再可信。
所以 Textira 做的第一件事情,不是让 AI 一次写得更多,而是让 AI 进入论文真正所在的环境。
研究者可以从已有的实验、论文和参考材料继续工作,而不是每一次都从一个空白聊天框重新解释背景。论文写到一半,可以让 AI 接着完成;实验发生变化,可以围绕新的结果修改已有章节;LaTeX 出现问题,可以直接定位并修复,而不是把一大段源码复制给另一个模型,再祈祷它不要碰其他地方。
这个区别听起来很小,却改变了 AI 在科研写作里的角色:它不再只是回答问题,而是开始对一篇持续变化的论文进行操作。
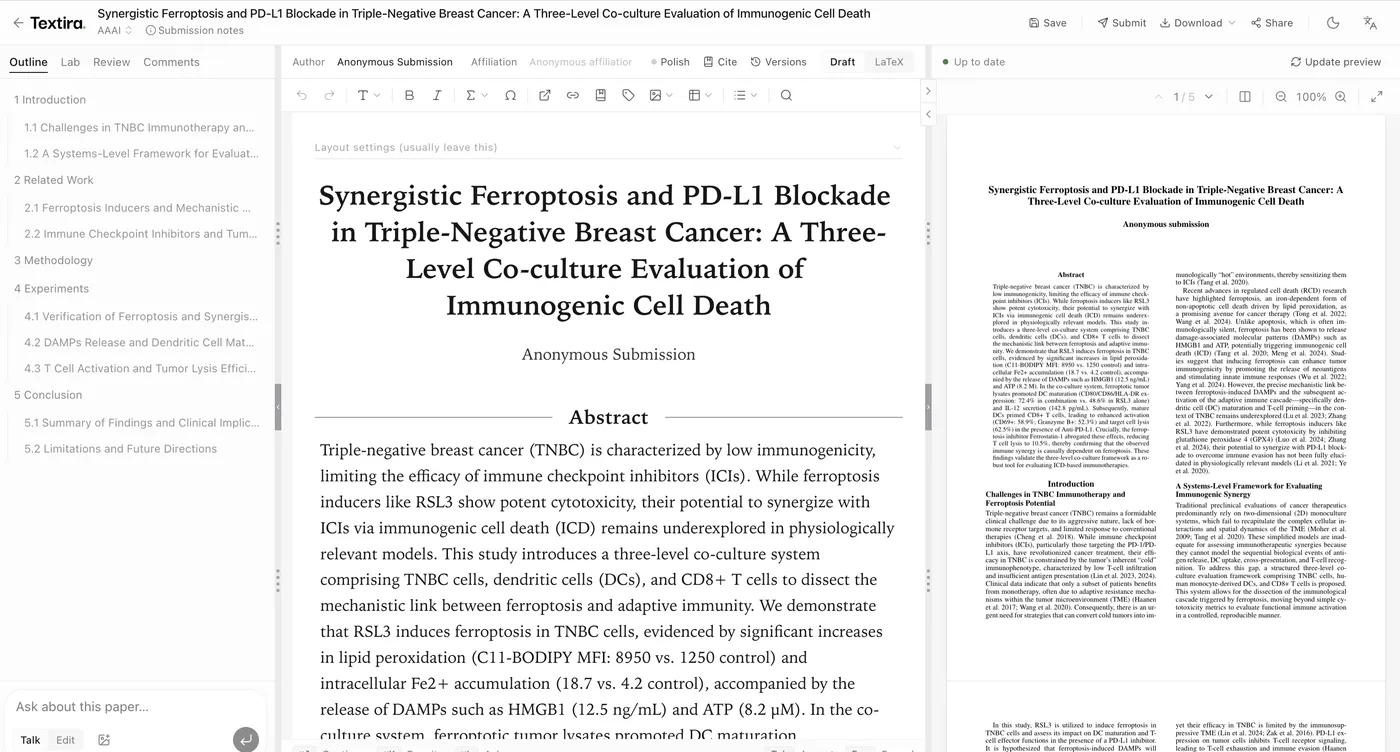
图注:Textira 论文工作台。左侧大纲,中间正文,右侧是按目标期刊排版后的 PDF。AI 改的是这篇正在写的论文,而不是聊天记录里的一段文字。
我们故意给 AI 一篇“写到一半”的论文
为了验证这种区别,一个有意思的测试并不是让几个 AI 比赛“从零写一篇论文”,而是反过来:不给它们一张白纸。
我们准备一篇已经进行到中途的论文,里面保留真实的实验结果、引用、LaTeX 结构和已经完成的章节,再加入新的实验材料,然后要求 AI 在现有论文上继续工作。
这时候,任务一下变得麻烦起来。
假设原文写着某个模型为 12 层,这是实验配置,不应该因为语言润色而变成 10 层或 16 层;某个实验结果是 83.7%,修改周围文字时这个数字必须继续是 83.7%;正文引用了一篇真实存在的论文,AI 不能为了让 Related Work 看起来更丰满而临时“补”一篇不存在的文献。更重要的是,如果任务只是修改第 4.2 节,Introduction、Method 和其他实验结果理论上都不应该发生变化。
于是评价标准也发生了变化。我们不再只看“AI 写得好不好”,而开始检查另一些问题:它改了多少不应该修改的内容?已有实验数字是否保持一致?引用有没有发生变化?修改完成以后 LaTeX 是否仍然能够编译?如果一个任务失败,能不能回到修改之前的版本?
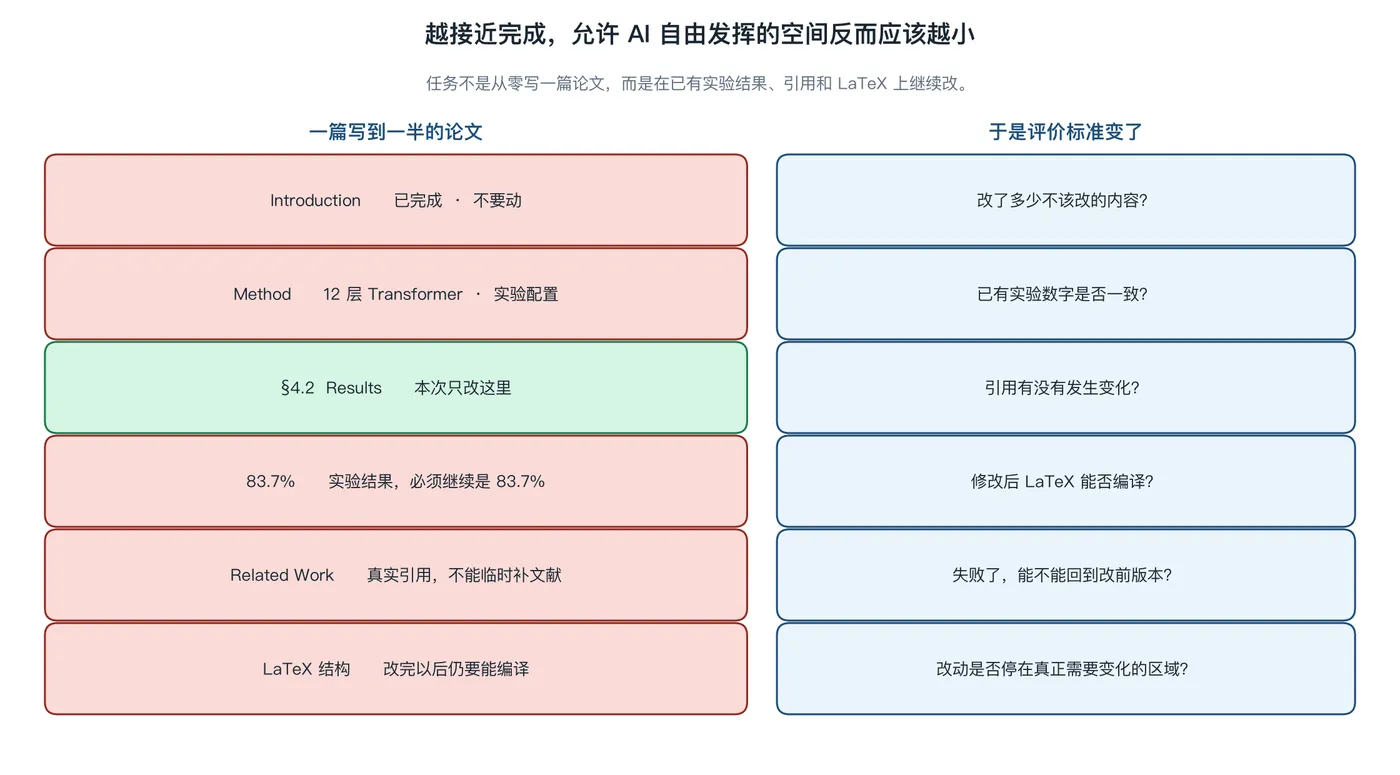
图注:一篇越接近完成的论文,允许自由发挥的空间应该越小。即使任务是改 Results,实验配置、已确认的数字、真实引用和其他章节也不该被顺手改掉。
在普通的 AI 写作产品里,这些指标甚至很少被讨论。因为对于生成任务来说,“重新写一遍”往往是解决问题最简单的方法。但科研论文恰好相反:一篇论文越接近完成,允许 AI 自由发挥的空间反而应该越小。
AI 最重要的能力,开始从“能生成什么”变成“知道什么不能动”。
这也是 Textira 产品逻辑里一个很重要的变化。面对局部修改,它更希望把 AI 的行为限制在真正需要发生变化的区域,而不是为了修复一句话重新生成一整个章节。修改完成以后,还需要检查论文是否依然能够正常编译,以及关键事实和引用有没有在修改过程中被破坏。
这听起来不像一个特别炫目的 AI Demo,却可能比“30 秒生成一篇论文”更接近研究者每天真正面对的问题。
为什么 Textira 要从“投哪里”开始
Textira 还做了另一个有些反直觉的选择:在论文还没有写完的时候,就让研究者考虑准备投哪里。
传统流程往往相反。先做实验、写论文,文章差不多完成以后再讨论目标期刊或会议,最后按照投稿要求换模板、删页数、调整引用和格式。但真正经历过投稿的人会发现,“投哪里”并不是最后选择一个模板那么简单。
不同 venue 对论文长度、结构、研究问题和表达方式的要求并不一样。同一组实验结果,如果面向机器学习会议、软件工程会议或者医学期刊,作者需要解释的问题、强调的贡献乃至组织证据的方式都可能不同。如果到了文章写完以后才考虑这些约束,就意味着大量返工。
所以 Textira 首页没有把“Ask AI anything”放在最重要的位置,而是给出了另一句话:
Pick the venue. Tonight, open a draft—not a chat.
先选择你准备去的地方,然后开始一篇论文,而不是开始一次聊天。
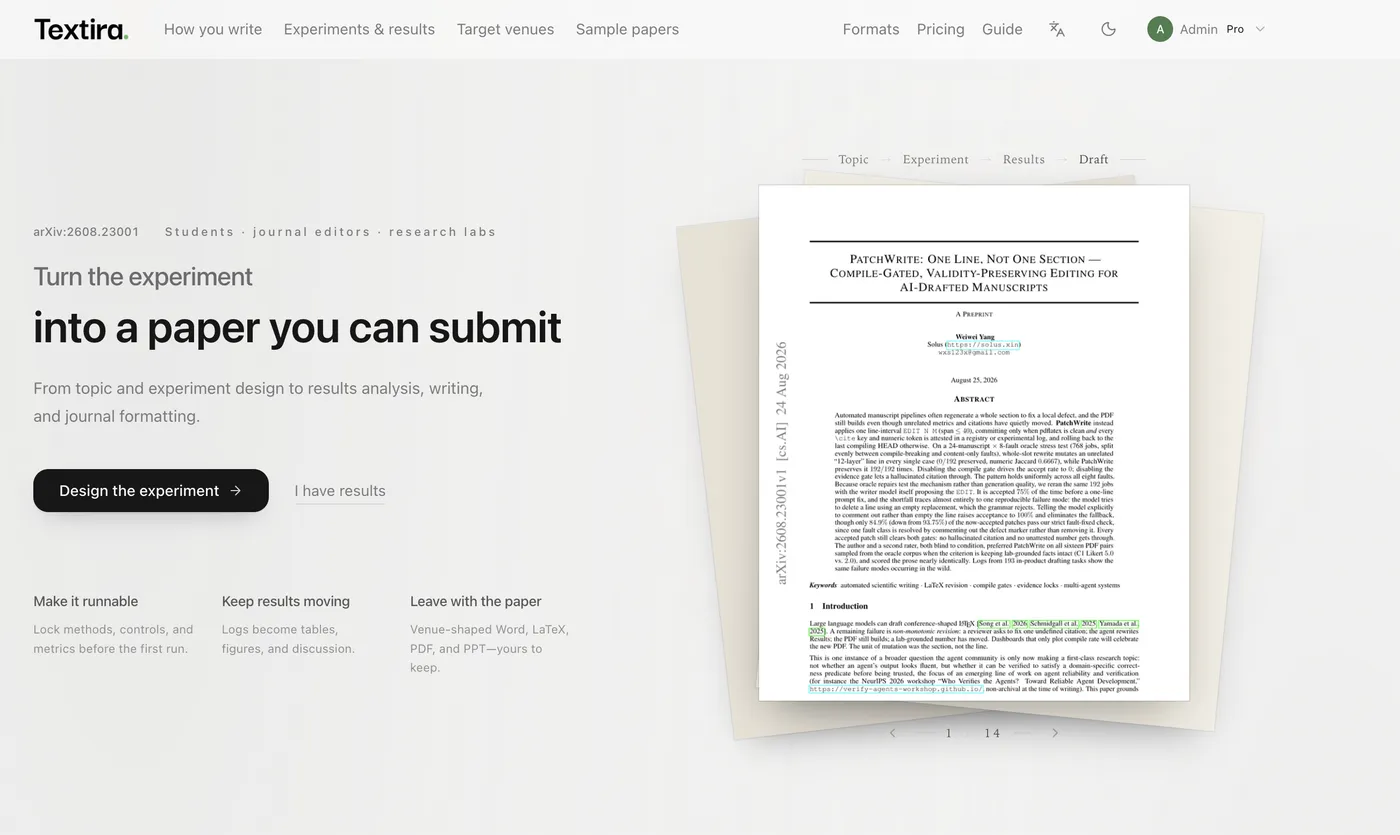
图注:Textira 中文首页对应的表述是「选好刊,今晚就有能改的初稿」。打开的是一篇能继续改的稿,不是一个空白聊天框。
这句话实际上也暴露了 Textira 对科研 AI 的判断:未来科研产品真正需要争夺的,可能并不是那个聊天框。
聊天框可能只是 AI 的过渡形态
过去几年,我们已经习惯了一种非常固定的 AI 产品形态:打开一个输入框,告诉模型自己想做什么,然后等待它回答。
这种方式非常适合第一次向 AI 展示能力。写代码、做 PPT、分析数据、写论文,都可以被包装成一句 Prompt 和一次令人惊讶的输出。但当 AI 真正进入专业工作以后,聊天框的局限也开始变得明显,因为用户必须不断告诉 AI:我是谁、我正在做什么、文件在哪里、上一轮发生了什么,以及这一次到底不要碰什么。
程序员已经开始经历类似的变化。早期大家把代码复制进 ChatGPT,现在越来越多 AI Coding 产品直接进入代码库,理解文件、依赖、Git diff 和运行结果。开发者不再需要每次向模型解释“这是我的项目”。
科研可能也会经历同样的过程。
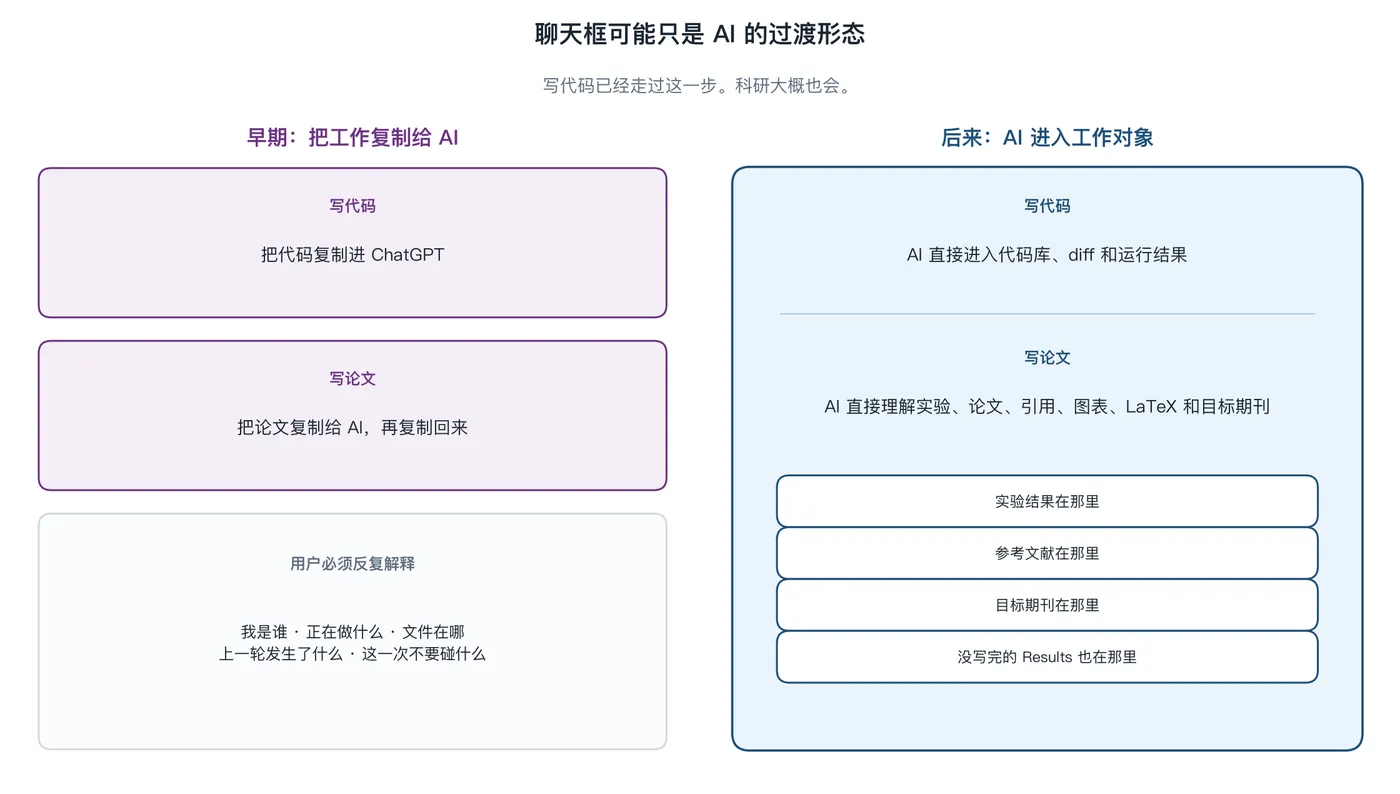
图注:左边是把工作复制给模型;右边是模型进入工作对象。代码已经走过这一步。论文、实验、引用、LaTeX 和目标期刊,也应当不必每次重新解释。
今天研究者仍然习惯把论文复制给 AI,再把 AI 的回答复制回来。但如果 AI 能够直接理解实验、论文、引用、图表、LaTeX 和目标期刊,那么“复制给 AI”这一步本身就会显得越来越奇怪。
Textira 想赌的就是这个变化。
它不是赌下一代模型能不能把论文写得更像人——这件事情几乎一定会发生,而且很可能由更大的基础模型公司完成。它真正赌的是,当模型能力变得足够便宜以后,科研 AI 的竞争会从“谁更会生成文字”,转向“谁更理解一篇论文是怎么完成的”。
到那时候,研究者早上打开电脑,可能不会再先打开一个聊天框,然后输入:
“我们继续昨天的论文。”
AI 应该已经知道昨天停在哪里。
实验结果在那里,参考文献在那里,目标期刊在那里,昨晚没有写完的 Results 也在那里。研究者需要做的,只是继续研究。
AI 已经会写论文了。
Textira 想解决的是,怎么把论文真正写完。


