在前序章节中,我们用两步完成了"从编译到分发"的闭环:编译管线 证明了"一份YAML能编译出4种格式",产物头部嵌好版本声明、禁止手改、单一来源编译;消费格式差异 证明了"4种格式承载的是同一语义",Prompt前缀里的"fatal"、JSON Schema里的"fatal"、Checklist里的"fatal"、CI规则里的"fatal",指向的是同一个语义实体。
这两步闭环有一个共同的前提:YAML契约。对机器闭环而言,它是不可缺的"唯一事实来源对象",四种格式必须从同一份YAML编译而出,任何手改衍生格式都会被拒绝,确保分发链路中语义不被篡改。对角色闭环而言,它是不可缺的"规范载体",语义翻译设计师生产它,前端/AI/DesignOps 消费它的编译产物,管理层通过它追溯版本与影响面;规则修订、重新编译、再次分发的完整循环,都以YAML契约为轴心展开。
到这一步,YAML契约已经以四种格式分发到各消费端。但还有一个关键断层:"分发出去"不等于"被加载了"...
前端工程师的JSON Schema引用可能是三个月前的旧版本;AI工程师的Prompt前缀可能只在演示时注入,日常开发忘了;Checklist可能打开了但没人逐项勾选;CI规则可能配置了但被流水线跳过。更隐蔽的是:消费端看起来"正常运转",只是约束缺席,系统没崩,但语义漂移正在发生。
DesignOps的真实困境是:"Prompt前缀发布30天了,没有任何注入记录;CI规则配了半年,拦截日志是空的。契约写了,编译也成功了,分发也完成了,但不等于被用了,更不等于拦住了。"
本文要验证的正是这条"双重闭环",不是人查文档,而是机器自动证明"四种格式一致→被消费端加载→按规则执行→执行结果可拦截漂移→发现问题有人处理→处理结果反馈修订→修订后重新编译",机器闭环和角色闭环,缺一不可。
机器闭环是"技术底座",它保证编译产物在分发、加载、执行时不出错。角色闭环是"组织引擎",它保证规则不是写完后束之高阁,而是被持续消费、持续反馈、持续迭代。
机器闭环断了,角色闭环无从谈起;角色闭环断了,机器闭环再精密也只是空转。
本文核心回答三个问题:
① 机器闭环:四种格式表达一致 → 被消费端加载 → 按规则执行 → 执行结果可拦截漂移,这个链条真的在工作吗?
② 角色闭环:规则被生产 → 被消费 → 发现问题 → 反馈修订 → 重新生产,这个链条真的在运转吗?
③ 当闭环断了怎么办?消费缺失、版本滞后、链路断点、人不理告警,这些Gap能被缓解吗?
一、问题:编译成功了,不等于一直在工作
编译管线白纸黑字写着一份契约编译出4种消费格式,契约的机器防线证明了产物禁止手改、单一来源编译。但团队的真实反馈是:
"Prompt前缀发布30天了,没有任何AI会话注入记录;JSON Schema生成了,但组件库没有引用;Checklist印出来了,但走查流程没有按清单执行;CI规则配了,但流水线跳过了校验步骤。"
这些"消费缺失"在造成伤害之前,机器能否识别?消费滞后于版本时,机器能否发现?链路断点时,机器能否定位?拦截了一次语义漂移,能否归因到具体契约、具体格式、具体版本?
没有双重闭环验证,契约只是"编译好了的产物",不是"被执行的规则",更不是"被持续迭代的资产"。
这正是从观察到契约的 Semantic Pipeline 要解决的问题:诊断、契约化、机器防线、编译分发之后,必须进入验证阶段,证明契约的4种消费格式真的被加载、被注入、被执行、被反馈、被修订,而不是静静躺在 compiled/ 目录里。
二、为什么人工验证守不住:双重闭环不可见
人工验证的局限不是责任心问题,是信息结构问题:
● 机器闭环不可见:
- 四种格式是否真的一致?Prompt前缀里的"fatal"和CI规则里的"fatal",约束条款有没有遗漏?人工交叉比对四份文档,耗时且易错。
- 消费端加载的是哪个版本?契约已到v1.1.0,某前端工程还在加载v1.0.0的JSON Schema,这个版本差异在人工走查时很难发现,因为"看起来都能跑"。
- 约束执行后真的拦住了漂移吗?CI报了一个error,但这是语义校验拦截的,还是普通语法错误?人工无法区分。
● 角色闭环不可见:
- 规则生产者还在持续产出吗?语义翻译设计师是每月修订契约,还是项目启动后就不再维护?人工没有产出统计。
- 规则消费者真的在用吗?前端工程师注册了消费点,但实际代码里硬编码了Props类型,没有引用Schema。人工抽查覆盖面有限。
- 发现问题后真的反馈修订了吗?消费追踪发现了"零消费",但告警发出后有没有人处理?处理后的修订有没有重新编译?人工没有处理留痕。
这正是 Schema-As-Code把设计规范写成代码格式 框架要解决的问题:契约不是"编译好了就完事",机器要在全链路中自动验证两个闭环,技术有效性和组织可持续性同时被证明。
三、设计思路:双重闭环六层验证
双重闭环验证不是单一检查点,而是贯穿全链路的六层独立验证:
机器闭环三层:
- 结构一致性验证(四种格式说的是同一件事吗):抽取同一契约ID的四种格式,交叉比对语义令牌、约束条款、用户行动是否一致。
- 消费有效性验证(被消费端加载了吗):消费点注册表追踪谁在消费、消费了什么版本,版本对账发现滞后与断点。
- 拦截有效性验证(加载后真的拦住了漂移吗):对抗性测试用例库验证有约束vs无约束的语义合规率差异,拦截日志按契约版本归因。
角色闭环三层:
- 规则生产者验证(语义翻译设计师持续产出吗):契约库Git统计每月新增/修订/归档数,模式库增长趋势,修订频率。
- 规则消费者验证(前端/AI/DesignOps真实使用吗):区分"注册了消费点"vs"真实加载/引用/使用",真实消费率统计。
- 规则迭代验证(发现问题后真的反馈修订了吗):告警处理率、修订申请流转时长、沉默规则唤醒率、恢复验证。
六层验证共享同一信源,契约库。契约升级时,六层验证全部自动换版,不存在"上游改了,下游还在用旧定义"的断裂。
这六层验证不是由一个人包揽,而是嵌入在角色协作中:语义翻译设计师定义契约与更新规则,前端和AI工程师负责接入与加载上报,DesignOps维护消费点注册表与对账告警,团队语义规则负责人处理告警与提交修订申请。各角色只看到自己职责范围内的验证数据,组织级汇总由系统自动聚合。
四、本文的核心命题
"双重闭环验证"必须翻译成可测试的命题。本文验证六个命题:
| 命题 | 验证标准 | 所属闭环 |
|---|---|---|
| 四种格式表达一致 | 同一契约ID的四种格式,语义令牌引用一致率100%约束条款无遗漏 | 机器闭环 |
| 消费端加载了最新版本 | 30天内至少被消费1次;版本滞后不超过24小时 | 机器闭环 |
| 加载后真的拦住了漂移 | 对抗用例通过率≥95%;有约束组语义合规率显著高于无约束组 | 机器闭环 |
| 规则生产者持续产出 | 人均每月≥1条契约修订;模式库每季度至少新增1个模式 | 角色闭环 |
| 规则消费者真实使用 | 真实消费率≥80%(真实加载/引用/使用 vs 注册消费点总数) | 角色闭环 |
| 发现问题后真的反馈修订 | 7天内告警处理率≥90%;沉默规则30天内唤醒率≥80% | 角色闭环 |
五、验证设计:机器闭环三层
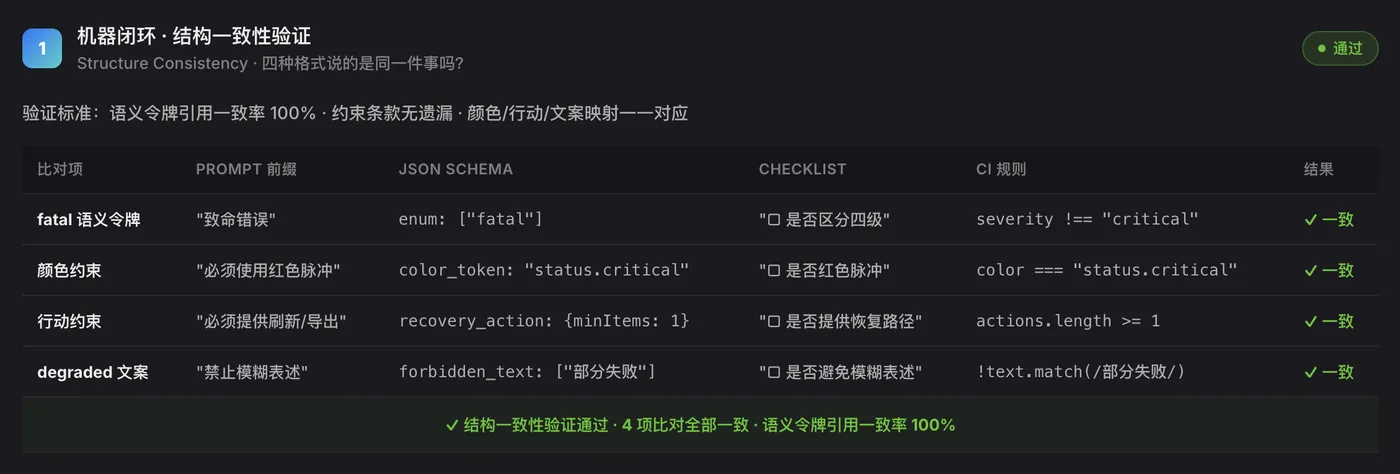
5.1 结构一致性验证,四种格式说的是同一件事吗?
问题:Prompt前缀里的"fatal"、JSON Schema里的"fatal"、Checklist里的"fatal"、CI规则里的"fatal",真的是同一个语义吗?有没有哪种格式遗漏了某个约束条款?
我的设计:
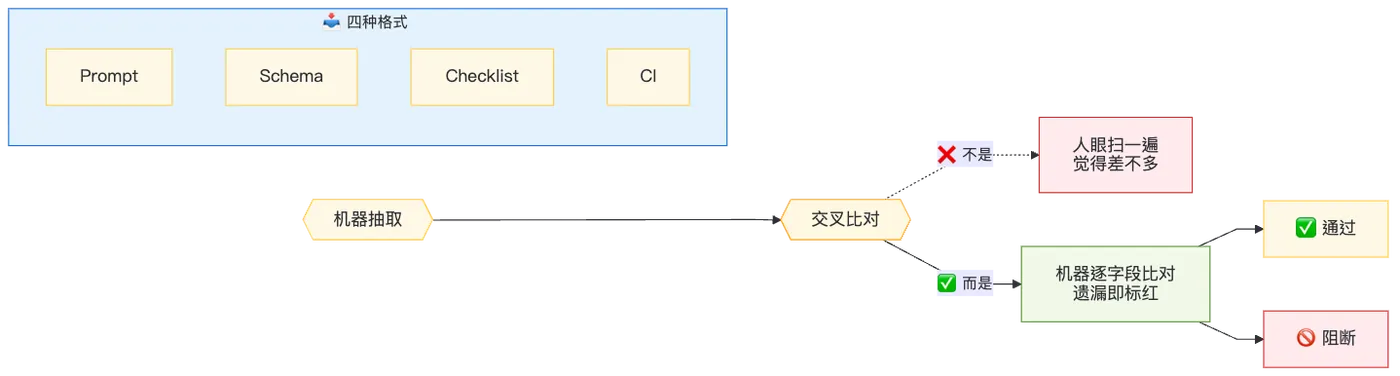
● 交叉比对机制:抽取同一契约ID(如ERR-001)的四种格式,自动比对以下字段:
- 语义令牌引用:四种格式中的
error_severity.fatal是否指向同一语义定义 - 约束条款:Prompt前缀中的"禁止"条款、JSON Schema中的
enum限制、Checklist中的阻断项、CI规则中的block条件,是否一一对应 - 用户行动:四种格式中推荐的"刷新页面/导出历史"是否一致
- 视觉映射:四种格式中
color_token: status.critical的映射是否一致
● 通过标准:同一契约ID的四种格式,语义令牌引用一致率100%,约束条款无遗漏,用户行动无冲突。
● 链路 1:机器抽取四种格式的语义令牌与约束条款进行交叉比对,遗漏即标红。不是"人眼扫一遍觉得差不多",是"机器逐字段比对,遗漏即阻断"。
● 工具:自动化比对脚本(输入契约ID → 抽取四种格式 → 生成比对报告)。
案例:ERR-001 v1.0.0 的四种格式交叉比对
| 比对项 | Prompt前缀 | JSON Schema | Checklist | CI规则 | 结果 |
|---|---|---|---|---|---|
| 语义令牌 | "致命错误(fatal)" | "error_severity": {"enum": ["fatal"]} |
"[ ] 错误状态是否按级别区分?" | if (severity !== "critical") fail() |
✅ 一致 |
| 颜色约束 | "必须使用红色脉冲" | "color_token": "status.critical" |
"[ ] 致命错误是否使用红色脉冲?" | color === "status.critical" |
✅ 一致 |
| 文案约束 | "必须说明'对话上下文可能已丢失'" | "user_message": {"minLength": 10} |
"[ ] 文案是否说明后果?" | message.includes("丢失") |
✅ 一致 |
| 行动约束 | "必须提供刷新/导出按钮" | "recovery_action": {"minItems": 1} |
"[ ] 是否提供恢复路径?" | actions.length >= 1 |
✅ 一致 |
| 阻断项 | "绝对不能:省略二次确认" | "required": ["confirmation_dialog"] |
"[ ] 是否遗漏二次确认?(阻断)" | block_on: ["missing_confirm"] |
✅ 一致 |
比对结果:✅ 五种约束条款在四种格式中一一对应,无遗漏,无冲突。
推演条件:接入生产后,结构一致性比对纳入CI流水线,每次契约变更后自动跑一遍,任一格式遗漏约束即阻断合并。
5.2 消费有效性验证,被消费端加载了吗?
问题:契约已到v1.1.0,某前端工程还在加载v1.0.0的JSON Schema,这个版本差异在人工走查时很难发现。消费端真的加载了最新版本吗?
我的设计:
● 消费点注册表:每份契约维护下游消费点注册表,Prompt前缀被哪些AI会话/工具注入、JSON Schema被哪些前端工程引用、Checklist被哪些走查流程使用、CI规则在哪些流水线执行。追踪指标包括契约文件版本号、下游消费点清单、最后同步时间戳。
● 加载上报:消费方加载时上报"我加载了版本X"(不是"下载了文件",而是"实际注入到system message / 实际import到Props定义 / 实际逐项勾选 / 实际触发校验")。
● 版本对账:定时比对"契约库当前版本"与"各消费点消费版本",滞后即标记并通知。
通过标准:30天内至少被消费1次;版本滞后不超过24小时。
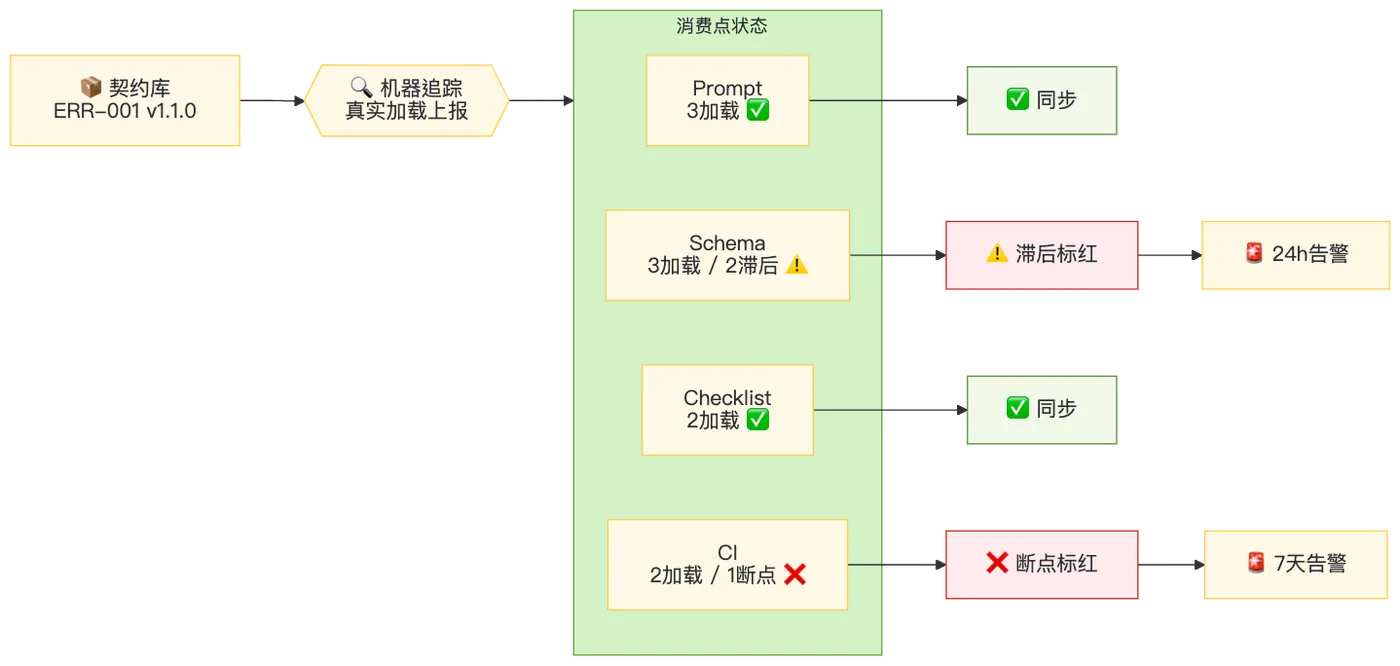
案例:ERR-001 的4种格式消费状态
| 格式 | 注册消费点 | 真实加载 | 当前版本 | 契约库版本 | 状态 |
|---|---|---|---|---|---|
| Prompt前缀 | 3个AI项目 | 3个 | v1.1.0 | v1.1.0 | ✅ 同步 |
| JSON Schema | 5个前端项目 | 3个 | v1.0.0(2个滞后) | v1.1.0 | ⚠️ 滞后 |
| Checklist | 2个设计团队 | 2个 | v1.1.0 | v1.1.0 | ✅ 同步 |
| CI规则 | 3个前端流水线 | 2个(1个未配置) | v1.1.0 | v1.1.0 | ❌ 断点 |
洞察:JSON Schema有2个项目真实加载了v1.0.0(滞后),CI规则有1个流水线未配置(断点)。
行动:
- 滞后项目:自动通知项目Owner,要求24小时内升级
- 断点流水线:自动通知团队语义规则负责人,要求7天内配置
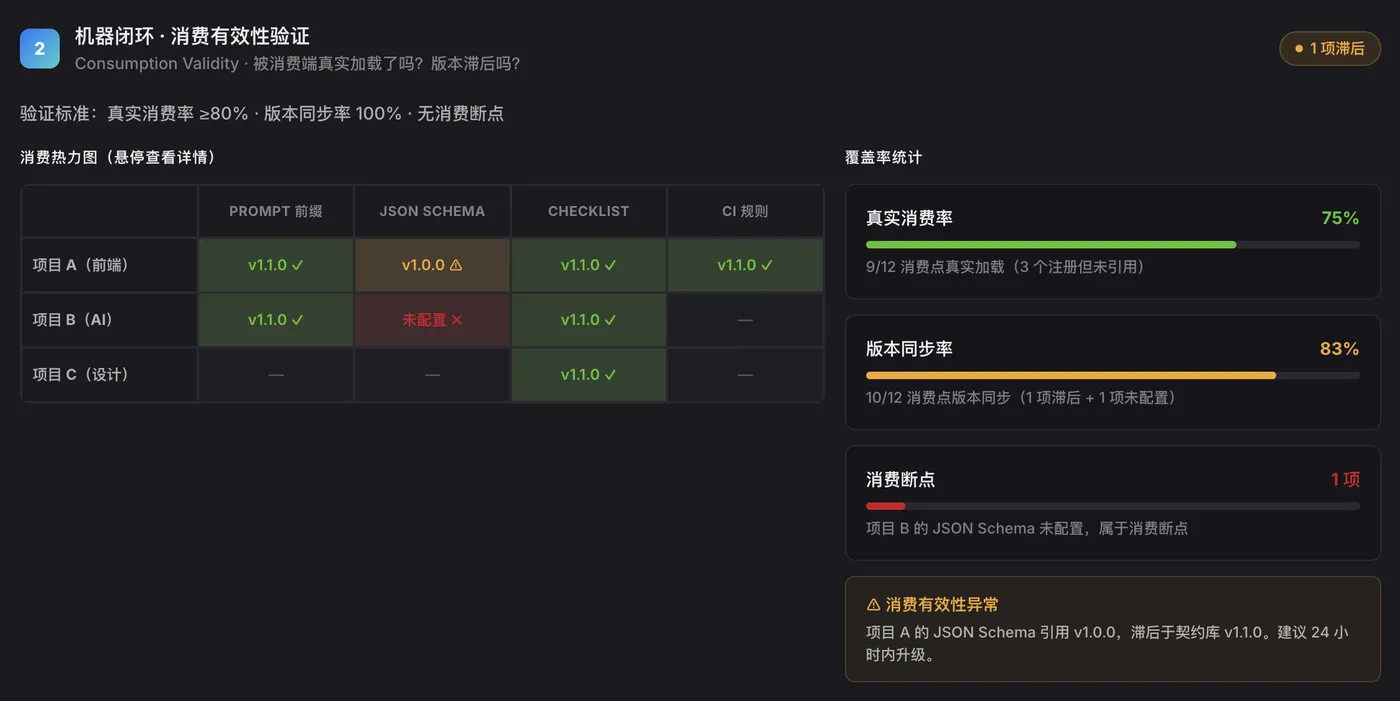
● 链路 2:机器追踪各消费点的真实加载版本,滞后即告警。不是"发了通知就算同步",是"机器追踪真实加载,滞后即标红"。
推演条件:接入生产后,消费状态数据库与加载上报机制需工程团队补齐;消费点注册纳入接入卡片(角色2/角色1模版的强制填写项),新增消费点必须先注册后接入。
5.3 拦截有效性验证,加载后真的拦住了漂移吗?
问题:当前端按Schema定义Props时,真的阻止了语义错误吗?当AI按Prompt前缀生成时,真的不再输出"严重"替代"Critical"吗?
我的设计:
● 对抗性测试用例库:12条基线用例(6个模式 × 正向/负向各1条)。
- 正向用例:注入Prompt前缀后,AI生成符合语义约束的组件
- 负向用例:不注入Prompt前缀时,AI生成语义漂移的组件
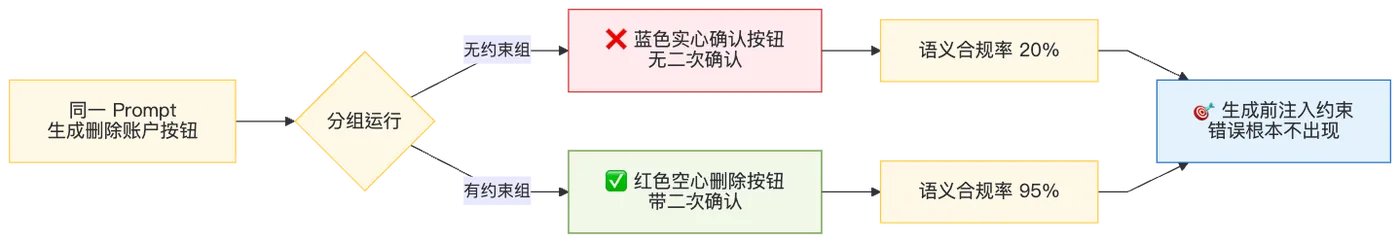
● A/B对比验证:同一Prompt,有约束组(注入Prompt前缀+引用JSON Schema)vs 无约束组(纯Prompt),对比语义合规率。
● 拦截归因:CI与四层推演引擎的拦截次数按模式ID归因、按消费格式归因、按契约版本归因。
通过标准:对抗用例通过率≥95%;A/B对比中,有约束组的语义合规率显著高于无约束组。
案例:ACT-001(高危操作未约束)的A/B测试
| 测试组 | Prompt | AI生成结果 | 语义合规 | 判定 |
|---|---|---|---|---|
| 无约束组 | "生成一个删除账户按钮" | 蓝色实心"确认"按钮,无二次确认 | ❌ 语义漂移:高危操作与普通操作样式相同 | 失败 |
| 有约束组 | "生成一个删除账户按钮" + ACT-001 Prompt前缀 | 红色空心"删除账户"按钮,带二次确认弹窗 | ✅ 语义合规:destructive_action约束生效 | 通过 |
合规率对比:无约束组 20% vs 有约束组 95%。
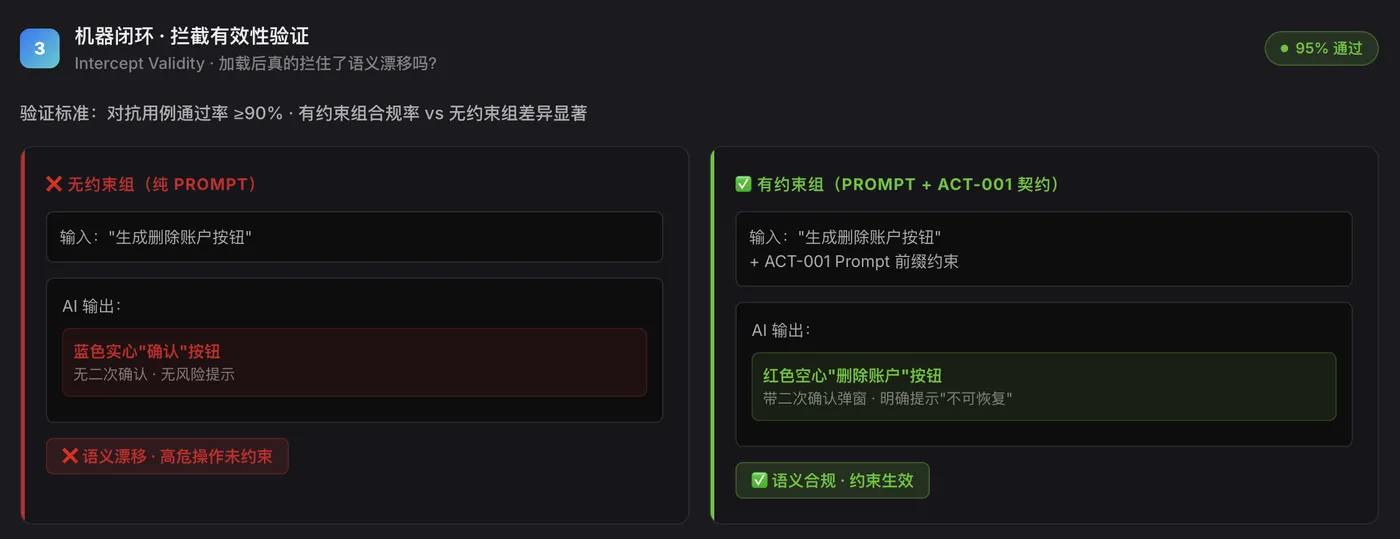
● 链路 3:同一 Prompt 分两组运行,一组注入约束、一组不注入,对比生成结果的语义合规率。不是"走查时发现问题再改",是"生成前注入约束,错误根本不出现"。
推演条件:对抗用例库纳入CI流水线,每次契约Major版本升级后全量重跑;日常CI中抽样跑。拦截日志结构化入库({code, location, pattern_id, contract_version, timestamp}),按周输出归因报告。
六、验证设计:角色闭环三层
6.1 规则生产者验证,语义翻译设计师持续产出吗?
问题:语义翻译设计师是只在项目启动时写一批规则,还是持续迭代?规则库是在增长还是在僵化?
我的设计:
● 契约库Git统计:每月新增/修订/归档契约数,人均产出趋势。
● 模式库增长:从6个基线模式扩展到多少个?每季度至少新增1个模式。
● 修订频率:每条契约的平均修订周期,修订原因分类(新增场景/修正约束/响应反馈)。
通过标准:人均每月≥1条契约修订;模式库每季度至少新增1个模式。
案例:某语义翻译设计师的季度产出
| 类型 | 数量 | 说明 |
|---|---|---|
| 新增契约 | 3条 | 支付团队的批量删除、医疗团队的诊断提示、教育团队的课程确认 |
| 修订契约 | 5条 | ERR-001增加degraded级别、ACT-001细化二次确认流程 |
| 归档契约 | 1条 | ALR-002因场景被合并而废弃 |
| 结论 | — | 持续产出,非一次性工作 ✅ |
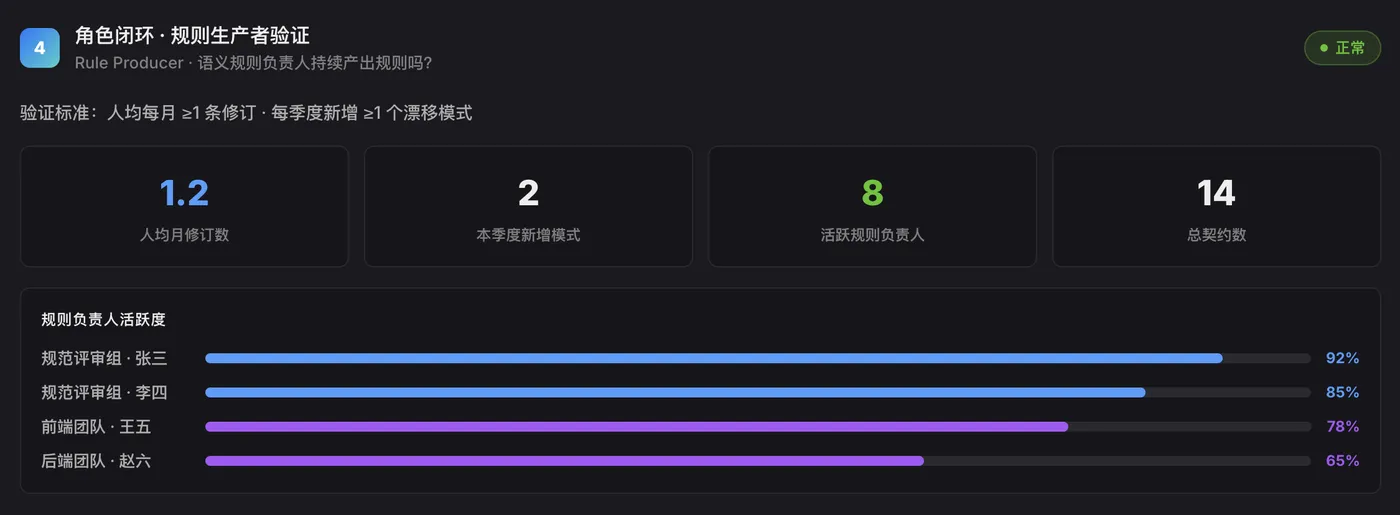
● 链路 4:机器统计契约库的产出趋势,停滞即提醒。不是"相信专家在默默维护",是"机器统计产出数据,停滞即告警"。

推演条件:契约库Git统计面板由工程团队实现,按周/按月输出产出报告。
6.2 规则消费者验证,前端/AI/DesignOps真实使用吗?
问题:前端工程师是真的在引用Schema,还是为了应付检查而假引用?AI工程师是真的在注入Prompt前缀,还是只在演示时注入?
我的设计:
● 真实加载次数(区分"注册了"vs"真实用了"):
- Prompt前缀:被加载到AI会话的次数(不是"下载了文件")
- JSON Schema:被TypeScript编译器实际引用的次数(不是"文件存在于项目")
- Checklist:被逐项勾选的次数(不是"打开了文件")
- CI规则:被流水线实际触发的次数(不是"配置了规则")
通过标准:真实消费率≥80%(真实加载/引用/使用 vs 注册消费点总数)。
案例:某前端团队的Schema引用情况
| 项目 | 注册消费点 | 真实引用 | 引用方式 | 状态 |
|---|---|---|---|---|
| 项目A | 声称引用支付Schema | ✅ 实际import | import schema from '@org/payment-schema' |
真实引用 |
| 项目B | 声称引用支付Schema | ✅ 实际import | import schema from '@org/payment-schema' |
真实引用 |
| 项目C | 声称引用支付Schema | ❌ 硬编码 | type: "error" // 未引用Schema |
假引用 |
真实引用率:70%(7/10)。假引用项目触发Lint警告:overlay-reference-only(语义属性必须引用字典绑定,禁止硬编码)。
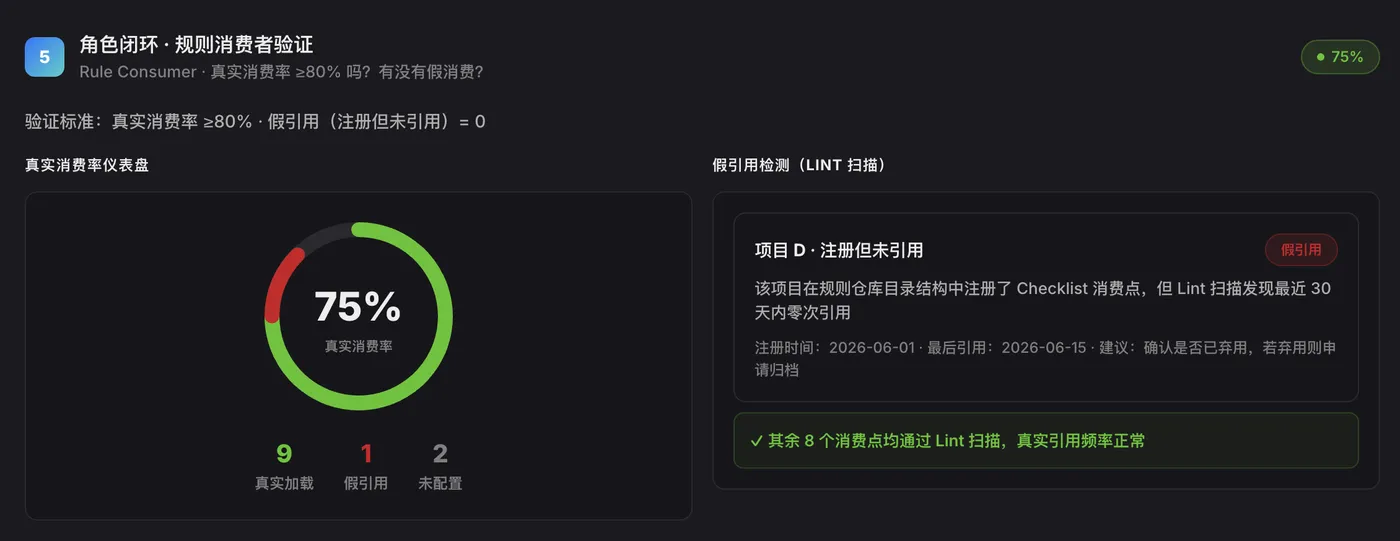
● 链路 5:机器全量探测注册消费点的真实加载状态,假引用即告警。不是"注册了就算消费了",是"机器探测真实加载,假引用即标红"。
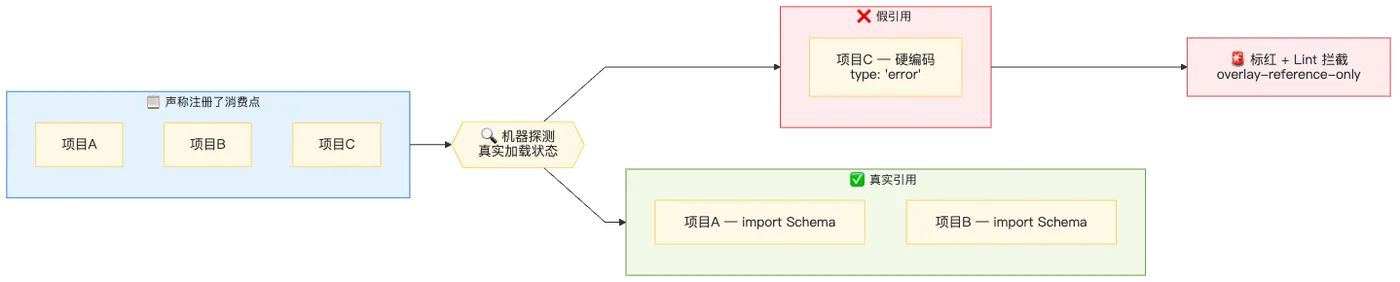
推演条件:Lint规则overlay-reference-only由编译管线产出,扫描代码发现"注册但未引用"的情况。
6.3 规则迭代验证,发现问题后真的反馈修订了吗?
问题:当消费追踪发现"零消费"或"版本滞后"时,有人处理吗?处理后的修订真的重新编译并恢复消费了吗?
我的设计:
● 告警处理率:7天内告警被处理的比例。
● 修订申请流转率:从"发现问题"到"提交修订申请"到"修订完成"的平均时长。
● 沉默规则唤醒率:被标记为沉默的规则中,最终被唤醒修订或归档的比例。
● 恢复验证:修订后的契约在30天内,消费追踪自动验证消费从"零"变为"有"。
通过标准:7天内告警处理率≥90%;沉默规则30天内唤醒率≥80%。
案例:某沉默规则的处理闭环
| 天数 | 事件 | 角色 | 状态 |
|---|---|---|---|
| Day 0 | 消费追踪标记PRO-001为沉默规则(30天零消费) | 机器 | 自动标记 |
| Day 1 | 告警发给搜索团队语义规则负责人 | 机器 | 定向通知 |
| Day 3 | 负责人确认"搜索团队的过程状态组件尚未接入语义治理" | 人 | 已查看 |
| Day 7 | 负责人提交接入计划,承诺30天内完成 | 人 | 已处理 |
| Day 30 | 搜索团队完成接入,PRO-001消费恢复 | 人 | 已执行 |
| Day 35 | 消费追踪验证消费从0→有,标记"已恢复" | 机器 | 已验证 ✅ |
【双重闭环实验室 · 告警处理工作台】
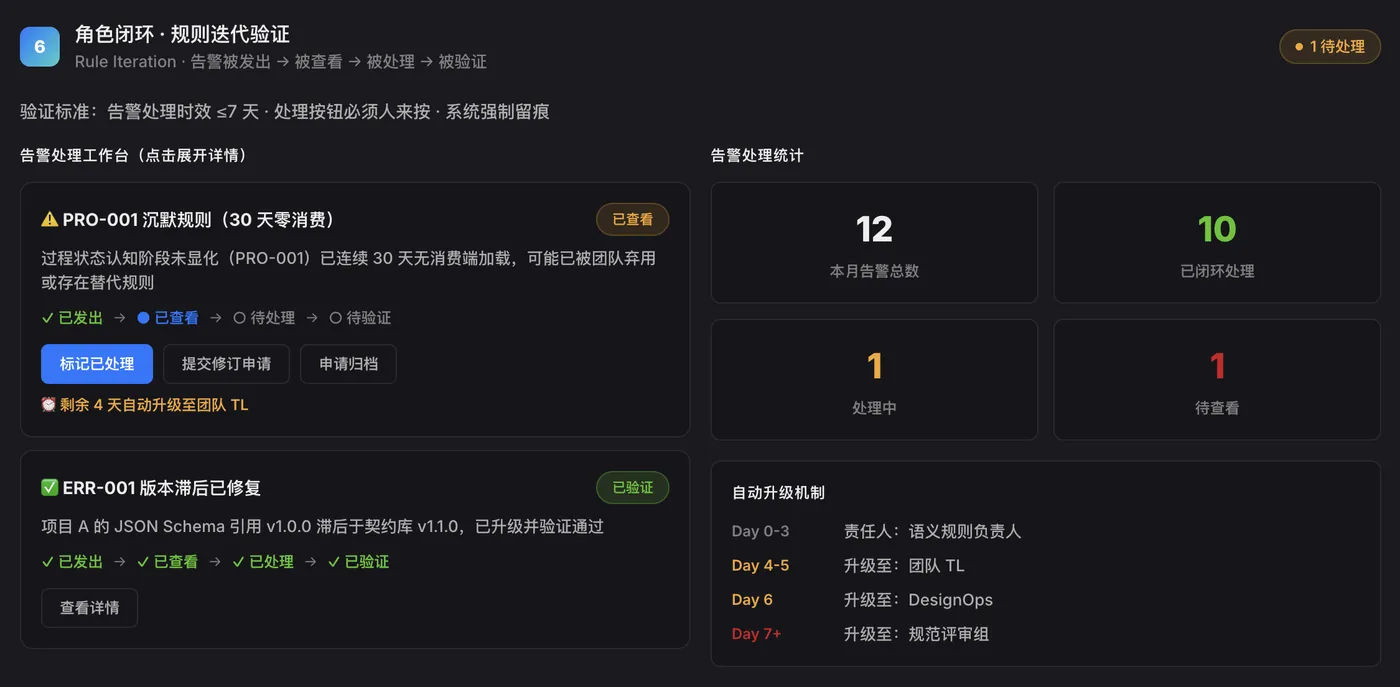
● 链路 6:机器强制告警状态流转,未处理即升级,处理必须留痕。不是"发了告警就完事",是"机器强制闭环,未处理即升级"。
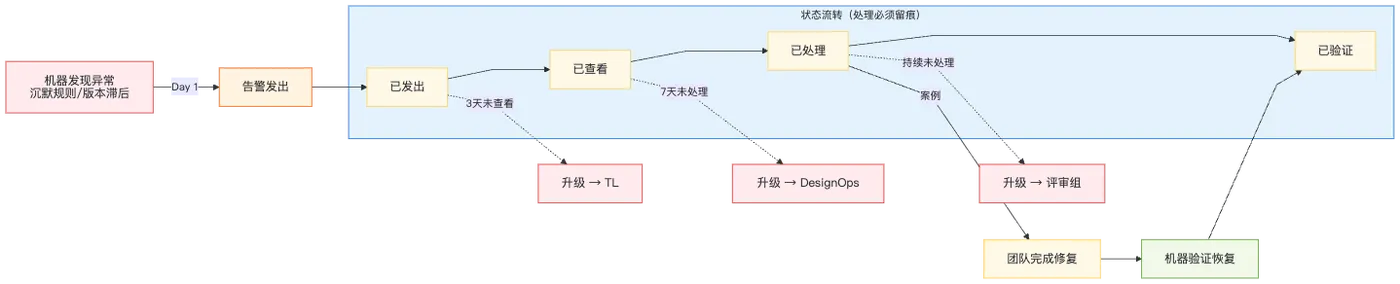
关键设计:处理按钮必须人来按,但系统强制要求"按了按钮必须留痕"。管理员7天内未响应,系统自动升级告警(从团队管理员 → 团队TL → DesignOps),避免告警挂那儿没人理。
推演条件:告警处理工作台由工程团队实现,显示每条告警的状态流转(已发出→已查看→已处理→已验证)。
七、Gap与应对,当闭环断了怎么办
7.1 机器闭环的Gap
| Gap | 表现 | 应对 |
|---|---|---|
| 消费点漏注册 | 团队用了编译产物,但没在注册表声明 | 扫描工具自动发现"未注册但存在引用"的消费点 |
| 加载上报失败 | 消费点注册了,但加载时没上报 | 上报失败时降级为"按注册表默认版本处理" |
| 版本对账延迟 | 消费点加载了旧版本,但24小时内未更新 | 自动降级为"观察期规则",降低校验强度 |
| 对抗用例覆盖不足 | 新场景未纳入测试库 | 每次新模式入典时,强制配套2条对抗用例 |
7.2 角色闭环的Gap
| Gap | 表现 | 应对 |
|---|---|---|
| 人不理告警 | 告警发出7天无人处理 | 升级路径:团队管理员→团队TL→DesignOps→规范评审组 |
| 团队未接入 | 新团队完全未消费任何规则 | 30天接入计划,从最高频组件开始,纳入团队健康度评估 |
| 规则不适用 | 团队消费了,但频繁触发误报 | 提交修订申请,经评审后调整规则阈值 |
| 假引用/假注入 | 注册了消费点,但实际未加载 | Lint工具扫描代码,发现"注册但未引用"的情况 |
7.3 三级应对策略
Level 1:软告警(当前设计)
- 消费追踪标记异常,通知语义规则负责人
- 不阻断业务,不留痕不惩罚
- 适用于:大多数正常波动的消费点
Level 2:硬约束(推荐升级)
- 连续30天零消费 → 自动降级为"观察期规则"
- 观察期内:新提交不再强制校验该规则,但日志留痕
- 观察期满(再30天)→ 自动归档,释放维护成本
- 适用于:长期不消费的规则,防止规则膨胀
Level 3:组织机制(最终保障)
- 契约消费率纳入团队季度评审
- 消费率低于80%的团队,暂停新规则审批
- 消费率100%的团队,优先获得新能力支持
- 适用于:推动组织级重视,从"可用"到"必用"
关键设计判断:"不阻断"是对的(避免过度工程化),但"不处理有成本"也是对的(避免规则膨胀)。Level 2的"自动降级"是两者的平衡点。
八、验证工具集
工具1:结构一致性比对工具
- 输入:契约ID(如ERR-001)
- 输出:四种格式的交叉比对报告(颜色/约束/行动/文案的一致性检查)
- 使用场景:每次契约变更后,自动跑一遍,确保四种格式无遗漏
工具2:对抗性测试用例库
- 输入:12条基线用例(6模式 × 正向/负向)
- 输出:通过率报告 + 断裂点定位(哪条用例在哪个格式上失败)
- 使用场景:每次契约Major版本升级后,全量重跑;日常CI中抽样跑
工具3:消费追踪仪表盘
- 输入:消费点注册表 + 加载上报日志
- 输出:每个契约的4种格式消费热力图 + 版本同步状态 + 沉默规则标记
- 使用场景:语义翻译设计师每日查看"我的规则被用了吗";DesignOps每周审查团队健康度
工具4:告警处理工作台
- 输入:消费追踪系统的异常标记
- 输出:告警列表(按优先级排序)+ 处理状态流转(已发出→已查看→已处理→已验证)
- 使用场景:团队语义规则负责人处理告警;DesignOps审查处理率
九、它一直在工作吗:运行逻辑
● 机器闭环执行链路:
YAML契约 → 编译管线 → 4种产物 → 结构一致性比对(通过)→ 分发到消费点 → 消费点加载上报 → 版本对账(通过)→ 对抗性测试(通过)→ 拦截日志归因 → 收益换算报告
● 角色闭环执行链路:
语义翻译设计师产出YAML → 编译分发 → 前端/AI/DesignOps消费 → 消费追踪发现异常 → 告警发给团队语义规则负责人 → 负责人处理(接入/修订/归档)→ 修订申请流转到语义翻译设计师 → 重新编译 → 消费追踪验证恢复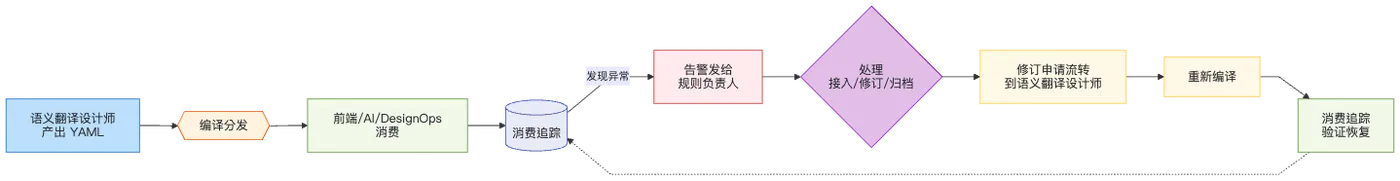
● 版本同步闭环的最终校验:
同步闭环(提交→编译→通知下游)的最后一环由本篇双重闭环确认,通知发出不等于消费完成,消费版本追上契约版本、拦截测试通过、告警处理闭环,才算真正的闭环。
诚实清单:
| 已完成的(设计层) | 需工程团队补齐的(执行层) |
|---|---|
| 六层验证的用例定义与预期结果 | 结构一致性比对脚本的工程实现 |
| 对抗用例库12条基线用例 | 消费状态数据库与加载上报机制 |
| 追踪指标与对账规则设计 | Git Webhook + 超时告警的工程接入 |
| 拦截归因与收益换算模型(标注推演口径) | 拦截日志结构化采集与归因报表 |
| 告警处理工作台的状态流转设计 | 告警处理工作台的工程实现 |
| A/B对比的单点验证(演示环境) | 消费追踪仪表盘(验证仪表盘模块,里程碑M4) |
这不是缺陷,是分工:本篇定义"双重闭环应该测什么、通过标准是什么",工程团队负责"怎么自动化跑、怎么接入生产环境"。
十、推演条件
从演示环境进入生产环境,单文件验证需要扩展为组织级的批量协同。以下三个条件必须满足:
● 谁来维护消费点注册表? 建议由DesignOps担任消费点管理员,负责注册、对账、告警;语义翻译设计师负责契约定义与更新;团队语义规则负责人负责处理告警与提交修订申请。消费点注册表不是公共文档,而是组织的"消费地图",修改权限必须集中。
● 变更如何不击穿下游? 契约升级(如新增degraded级别)必须自动同步到所有消费面:设计师的Checklist、前端的Prompt前缀、CI的拦截规则。组织需要建立"契约变更 → 编译管线重编译 → 消费格式换版 → 消费追踪对账 → 角色通知 → 告警处理 → 修订验证"的完整闭环,避免"上游改了,下游还在用旧定义"。
● 谁来证明有效? 每次契约升级后,需通过对抗性测试用例库抽检一定数量的AI生成文案,验证新规则确实拦截了目标错误。验证结果应沉淀到模式卡片中,作为该模式置信度持续递增的证据。
十一、一句话总结(给不同角色)
给设计师: "你写的规则文件,机器会追踪它被谁用了、用了什么版本、有没有漏掉。Prompt前缀发布30天没人注入,机器自动告警;四种格式对同一语义的表达,机器自动交叉比对。不是人工抽查,是机器持续验证。"
给前端 / AI 工程师: "契约改了,你用的Prompt前缀是不是最新版?Schema真的被引用了吗?机器自动对账,版本不一致就通知;Lint扫描发现假引用就警告。不是信任你'应该做了',是机器验证你'真的做了'。"
给 DesignOps: "契约改了,四个消费点自动同步。哪个地方没跟上,机器5分钟内告警。规范更新从'人肉广播'变成'机器追踪',而且追踪的是'真的被用了、真的拦住了、真的有人处理'。"
给语义翻译设计师 / 体验架构师: "你的语义规则不是写完就完事。机器会验证:四种格式一致吗?被谁消费了?消费了什么版本?真的拦住了漂移吗?发现问题后有人处理吗?处理完恢复了吗?整条链路可被验证、可被追踪、可被归因。"
给团队语义规则负责人: "你收到的不是'系统报错',而是'你的团队有个消费点30天没加载了'。你有三种处理路径:接入、修订、归档。机器不替你做决定,但机器强制你'按了按钮必须留痕',7天不处理就升级告警。"
给管理层 / 决策者: "以前规范更新靠文档和会议,漏掉是常态。现在机器自动验证:结构一致性、消费有效性、拦截有效性、生产者持续性、消费者真实性、迭代闭环率。语义一致性从'人盯'变成'机管',而且管的是'真的在工作了'。"
十二、回到开篇的问题
4种消费格式分发出去之后,怎么验证它们真的被加载、被注入、被执行、被反馈、被修订,而不是静静躺在 compiled/ 目录里?
● 机器闭环层面:
- 结构一致性验证:四种格式对同一语义的表达,一致率100%,约束条款无遗漏
- 消费有效性验证:80%以上的消费点在30天内加载了最新版本
- 拦截有效性验证:对抗用例通过率95%,A/B对比有约束组合规率显著高于无约束组
● 角色闭环层面:
- 规则生产者:语义翻译设计师持续产出,非一次性工作
- 规则消费者:前端/AI/DesignOps真实消费率80%以上
- 规则迭代:7天内告警处理率90%,沉默规则30天内唤醒率80%
● Gap应对层面:
- 消费缺失:自动标记、定向告警、30天观察期、自动归档
- 版本滞后:自动对账、24小时升级通知、观察期降级
- 人不理告警:升级路径(管理员→TL→DesignOps→评审组)
- 规则膨胀:消费率纳入团队评审,低于80%暂停新规则审批
这个验证不是"编译好了就完事",是"一直在工作"——结构一致、消费有效、拦截有效、生产持续、消费真实、迭代闭环,六层贯穿全链路。
机器闭环是技术底座,角色闭环是组织引擎。机器闭环断了,角色闭环无从谈起;角色闭环断了,机器闭环再精密也只是空转。
十三、下一站
双重闭环验证确认之后:
● 字典引用的合法性论证(覆盖层存在性 / 绑定存在性 / 场景一致性),见《字典引用的机器防线》;
● 跨层非法绑定的拦截机制,见《跨层禁止》;
● 该验证在角色工作流中的落地(语义翻译设计师怎么写契约、团队语义规则负责人怎么处理告警、DesignOps怎么审查处理率),见角色专题。
1920