为什么都说要做自动化测试,落地却这么难!(附自动化测试的四种死法)

简介: 本文剖析自动化测试落地难的四大死因(人力分散、时机错配、维护崩溃、期望错位),指出症结在于忽视长期“养车成本”。2026年AI大幅降低搭建与维护成本,让账能算清、债可偿还。破局关键:精准算账、接口优先、责任到人、AI前置生成脚本。

我相信,绝大多数测试团队都被领导要求过搞自动化测试。

现在这几乎成了标配。年初规划要提,季度汇报要提,招聘 JD 里也得写上一条。一个测试团队要是说自己在纯手工,都不好意思往外讲。

但你会发现一个挺扎心的现象。

讲自动化的团队遍地都是,真正落了地、还跑出效果的,少得可怜。

为什么落地这么难?

行业里聊自动化,十篇文章八篇在教你怎么搭框架,剩下两篇在晒覆盖率截图。很少有人愿意承认那个朴素的事实。

大部分公司的自动化,不是没做过,是做了,然后死了。

今天就来聊一聊,它到底是怎么死的。以及,2026 年了,还能不能抢救一下。

一、自动化测试的四种死法

第一种,死于人力

最常见的一种死法。公司一边要求搞自动化,一边又不愿意给自动化配专人。

理由特别朴素,怕活干完了,人就闲了。于是让测试团队你分一点我分一点,轮着做,美其名曰人人参与。

听着挺公平,对吧。

但兼职做自动化,等于所有人负责,等于没人负责。忙起来的那个迭代,脚本永远第一个被牺牲。做着做着,就没人愿意维护了,慢慢就荒废了。

第二种,死于时机

版本迭代一直在跑,脚本什么时候写?

迭代做到一半就动手?需求还没定稳,功能中途还在改,你这边的脚本刚写好,那边一改版,跟着返工,等于在流沙上打地基。

那就等需求稳定了再写。可等需求稳定、功能也改完,恰恰是冲上线最紧的时候。人还是那几个人,一边是压着点要交的手工测试,一边是排队要写的自动化脚本,一个人掰不成两半。

版本要保上线,自动化就只能让路。写脚本的优先级,就这样一降再降。

降着降着,就没了。

第三种,死于维护

需求一变,脚本跟着改。环境一抖,误报一片。

脚本挂了你去排查,查完发现大概率要改的还是测试脚本,而不是程序代码。改脚本的速度,跟不上需求变的速度,用例库就从资产慢慢变成了负债。

第四种,死于期望错位

很多老板指望自动化去发现新 bug。

你想想看,等脚本跑完那功夫,手工早测完了。

自动化的真正价值是回归,是那些这次没动过的老功能,每次发版前帮你重新看一遍,防止它们悄悄坏掉。

指望自动化抓新 bug,等于让守门员冲去踢前锋。球门丢了,还怪他进攻不力。

二、这笔账,以前确实算不过来

四种死法摆在一起,背后其实是同一类根源。

自动化这件事,特别像买车。
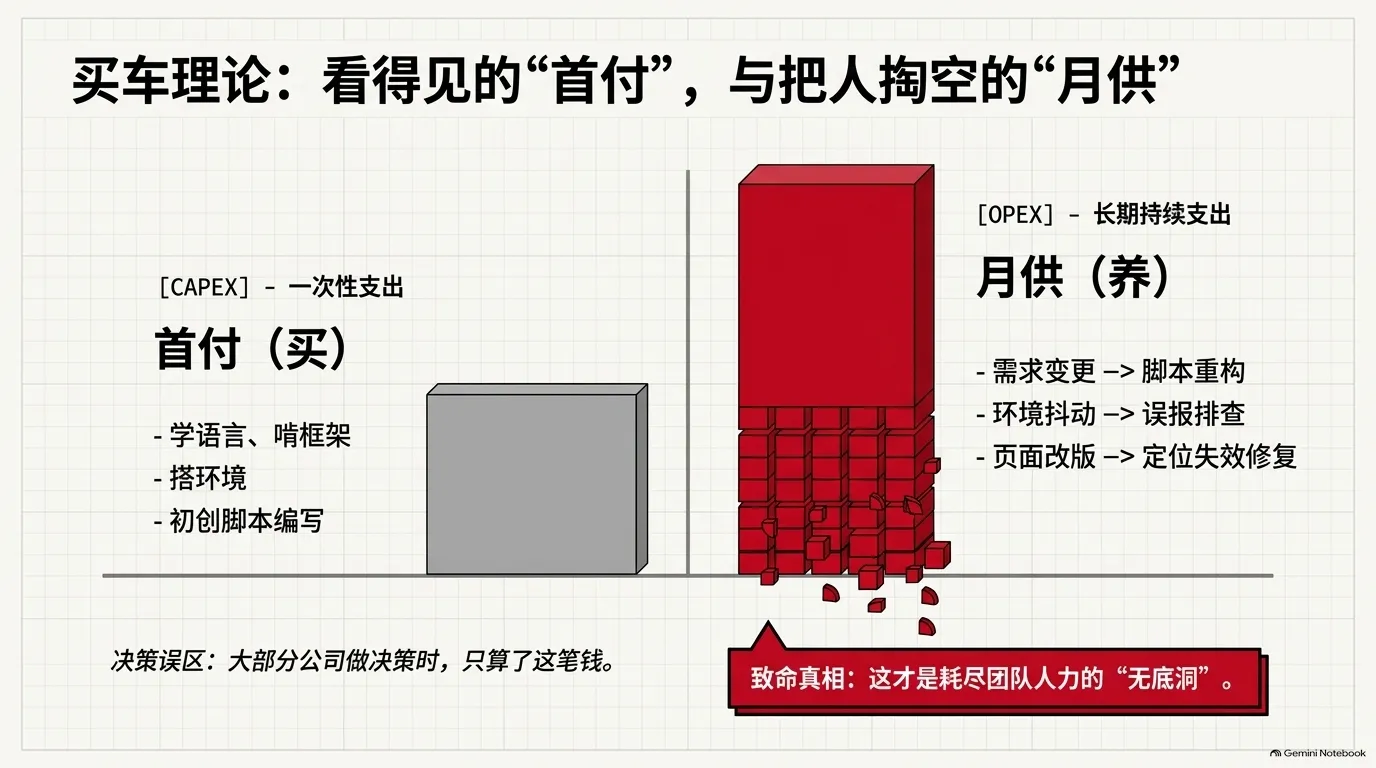
买车的钱你看得见,首付加落地,一次付清。但真正把人掏空的,是后面的油钱、保养、保险、年检,月月都在流。

自动化一样,要花两笔钱。

买,是一次性的。学语言,啃框架,搭环境,再把脚本一条条写出来,这是首付。

养,是长期的。需求变了要改脚本,环境抖了要治误报,页面改版要修定位,这是月供。

大部分公司做决策的时候,只算了首付,没算月供。

而产出呢,是回归保障。省的是人力回归的钱,防的是老功能悄悄坏掉的风险。

投入是确定的,收益是缓慢的。在一家按月看结果的公司里,这笔账以前真的算不过来。这也怪不到谁头上,这种人力投入,小公司确实很难玩起来。

但 2026 年了,账本变了。AI 把两笔钱同时打了折。
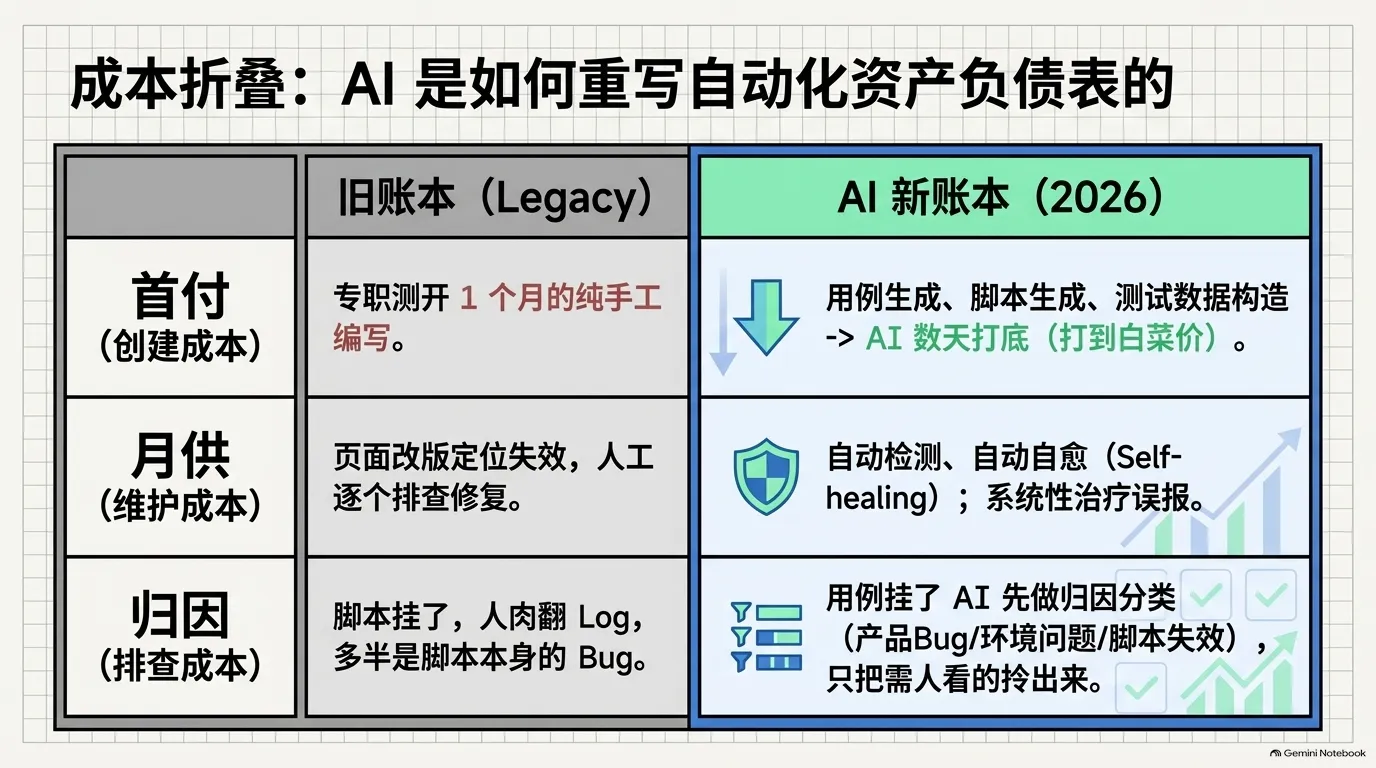
首付,打到白菜价了。用例生成、脚本生成、测试数据构造,以前一个专职测开干一个月的活,现在 AI 几天打底。

月供,也有人分摊了。页面改版定位失效,AI 能自动检测、自动自愈。用例挂了,AI 先做归因分类,是产品 bug、环境问题还是用例本身失效,把真正需要人看的拎出来。误报这个老大难,第一次有了系统性的治法。

以前自动化最大的死因是维护。这个死因,现在有药了。

但有一块成本,AI 一分没降,验证和拍板。产出的东西越自动,「谁能对结果负责」就越值钱。这块,永远是人来扛。

三、破局的四个建议

账能算过来了,不等于躺着就能成。给你四个建议。

一,先算账,再动手

哪些流程值得自动化,频率、价值、稳定性,拉张表打个分再决定。别被覆盖率绑架,十条稳定的核心回归,胜过一百条每天飘红的尸体。

二,接口先行,UI 只走主干

接口变化最小,维护最轻,生命力最长。UI 只覆盖登录、下单这类主流程,细枝末节的检查点,等人有余力再补。这个优先级在 AI 时代依然成立。

三,责任到人,哪怕只出半个人

兼职轮着来,等于没人负责。自动化是资产,资产必须有主人。谁新增,谁维护,失败多久内必须处理,白纸黑字定下来。

四,把「上线后补脚本」的时机死结解开

以前不敢同步做,是因为同步做太贵,需求一动脚本跟着返工,人力扛不住。

现在首付打到白菜价了。需求评审完,让 AI 出脚本初稿,需求稳定后人工校准一遍就能入库。拖了行业十几年的时机死结,第一次有了正解。

写在最后

最后说句实在的。

自动化测试从来不难在技术,它难在一笔长期主义的账,要在一个按月看结果的生意里算平。

AI 没有让自动化变简单,它让自动化的账单,终于算得过来了。

剩下的,就看你想不想算了。

目录
相关文章
|
29天前
|
XML 人工智能 JSON
阿里开源:skill-up,一款Agent Skill 评测工具!
阿里开源的 skill-up 是首个专为 Agent Skill 设计的评测与演进工具,将软件测试方法论完整迁移:支持多引擎运行、声明式 YAML 用例、规则/脚本/LLM 三类断言,并内置自动修复与回归闭环。本地可跑,CI 可集成,让 Skill 质量可度量、可保障。
545 1
阿里开源:skill-up,一款Agent Skill 评测工具!
|
9天前
|
人工智能 算法 测试技术
2026互联网大厂秋招AI Coding笔试全攻略!
本文详解大厂秋招新兴的AI Coding笔试:不考手写代码,而考需求理解、任务拆解、Prompt设计、AI协作与工程交付能力。通过六步实战法(分析→分轮实现→精准调试→自造测试→逐条验收→AI自审)及高频避坑指南,助你从“AI使用者”升级为“AI项目经理”。
236 1
2026互联网大厂秋招AI Coding笔试全攻略!
|
16天前
|
人工智能 监控 JavaScript
最近火爆出圈的,FDE 到底是个什么岗位?
FDE(前沿部署工程师)是AI时代新型复合岗:驻客户现场,贯通技术与业务,主导大模型在真实场景的端到端落地。需兼具AI应用开发、工程化交付与业务沟通三大能力,非单纯“调API”或售前角色。高薪热门,但重实战、重结果。
1101 2
最近火爆出圈的,FDE 到底是个什么岗位?
|
12天前
|
人工智能 前端开发 测试技术
AI越来越强了,为什么测试人反而越来越累!(为打工人发声)
本文揭示AI时代测试工程师“越忙越累”的真相:研发、产品等岗位因AI大幅提效,而测试却成瓶颈——AI擅长“迎合”,测试重在“挑刺”;产能翻倍导致被测物激增,验证环节却难以规模化。文章呼吁理性设定AI提效目标,尊重测试在质量兜底中的不可替代价值。
164 0
|
26天前
|
人工智能 测试技术
公司从零开始推自动化测试,如何落地?
本文深度剖析团队自动化转型的底层逻辑:指出失败主因常是目标错位与管理缺位,而非技术本身。强调“三分技术、七分管理”,主张先对齐业务目标、小步试点、建立闭环与规范,并结合AI提效——但须严控生成质量与维护闭环。核心是将自动化打造成可持续演进的测试资产。
175 0
公司从零开始推自动化测试,如何落地?
|
2月前
|
人工智能 JavaScript 安全
一个测试负责人的崩溃:该做的都做了,线上还是炸了
本文犀利指出:高覆盖率≠高质量测试。3000条用例、95%覆盖率仍漏掉严重线上Bug,根源在于“测得多”而非“测得准”。倡导风险驱动测试——聚焦高概率、高后果路径,紧盯真实故障、高频改动、系统集成点,并用变异测试验证有效性。AI Agent场景下,精准评测更关乎生存。
104 1
一个测试负责人的崩溃:该做的都做了,线上还是炸了
|
2天前
|
人工智能 算法 Java
突发!字节内部大调整,QA直接转研发了?
字节等大厂正推动QA转研发,合并测试与研发序列,抬高准入门槛:要求懂代码、架构、AI提效及质量体系建设。手工测试岗位收缩,全栈测开成新刚需,转型窗口期仅剩一两年。
145 0
|
2月前
|
人工智能 文字识别 JavaScript
AI 测试提效 | 脚本能跑但总挂?分享我的 ui-testscript-enhancer + Skill UI 自动化健壮性增强方案
本文介绍`ui-testscript-enhancer`技能:自动为AI生成的UI测试脚本注入六大健壮性能力——智能等待、弹窗处理、iframe/Shadow DOM穿透、异常重试、失败截图录屏及验证码识别(集成ddddocr),5分钟将“能跑”的脚本升级为CI-ready的“跑得稳”生产级脚本。
306 2
AI 测试提效 | 脚本能跑但总挂?分享我的 ui-testscript-enhancer + Skill UI 自动化健壮性增强方案
|
3月前
|
人工智能 自然语言处理 测试技术
从 LLM 评测到 AI Agent 评测,我的一些思考!
本文深入剖析AI评测体系的演进与陷阱,指出当前主流评测方法在Agent场景下的根本性失效:静态数据集、单次测试、只看输出等范式无法应对Agent的动态性、不确定性与系统性。文章提出四大关键转变——从“说了什么”到“做了什么”、从数据集到交互环境、从单点分数到概率分布、从评模型到评完整系统,并倡导构建多维、场景化、闭环的科学评测体系
318 1
从 LLM 评测到 AI Agent 评测,我的一些思考!
|
2月前
|
人工智能 监控 安全
Agent质量怎么评?
本文深度剖析AI Agent上线翻车困局:90%+评测分≠真实可用。指出传统测试失效根源——Agent具多步性、工具调用、自主性与随机性四大特性。提出“评产出不评路径”核心原则,并对比AgentBench、SWE-Bench等基准与DeepEval、LangSmith等框架适用场景,强调需构建离线评测、红队测试、在线监控三层质量保障体系,助力团队从Demo走向可靠落地。
188 0
Agent质量怎么评?

热门文章

最新文章