大家好,我是晚安code。
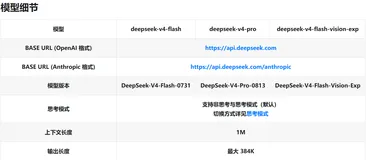
9 月 8 日 DeepSeek 官方交流群里突然甩出一条内测通知:DeepSeek V4.1 Flash 内测的中间版本开放试用,新架构、原生多模态、更快更强,而且——不用申请,改个模型名就能调。这类事我向来跑得比谁都快,结果一细看模型名,乐了:expires-on-0910,官方把过期时间直接写进了名字里。
所以这篇我尽量写快点,趁它还在。下面手把手把接入流程、计费坑和多模态注意点一次说清。
一、先说清楚:这次内测放了什么
先给个背景定位,别把它当成一次「正式发布」。V4.1 Flash 内测是 DeepSeek 在 2026 年 9 月 8 日于官方交流群放出的一个中间版本测试,类似把训练途中的某个 checkpoint 丢进真实 API 环境里试跑。
官方口径的核心卖点就四个字:新架构、原生多模态、能力更强、速度更快、成本更低。截至我写稿时,官网、API 文档和 Change Log 里都还没有它的正式记录,也就是说这是一次真正的「先上车后补票」式公测,不是限量邀请制。
顺带说下这个「原生多模态」,值得单独定义一下:
原生多模态(Native Multimodal):模型本身就能同时理解文本和图片输入,而不是靠外挂一个视觉模型拼出来的。可以理解成「这个模型天生就会看图」,跟之前独立的 Vision 实验版是两条路。
二、接入方法:base_url 不变,只改一个模型名
接入的难点从来不在配置,而在你知道该把名字换成什么。只要你有 DeepSeek 账号和 API key,老接口不用动,模型名换成下面这个:
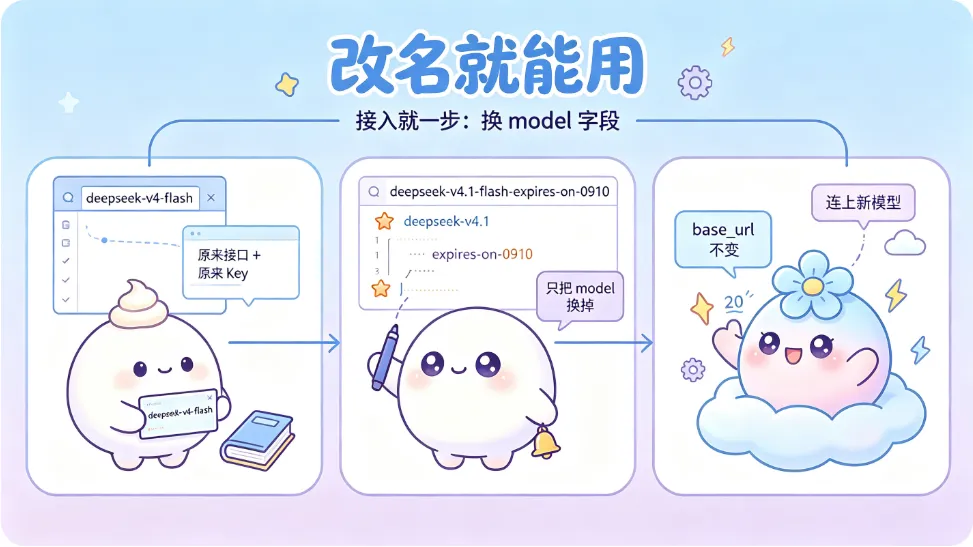
deepseek-v4.1-flash-expires-on-0910
官方强调 base_url 不变(https://api.deepseek.com),API key 用原来的就行。Python 里长这样:
from openai import OpenAI

client = OpenAI(
    api_key="sk-你的key",          # 原来的 key,不用重新申请
    base_url="https://api.deepseek.com",
)

resp = client.chat.completions.create(
    model="deepseek-v4.1-flash-expires-on-0910",
    messages=[{
   "role": "user", "content": "你是哪个版本的模型?"}],
)
print(resp.choices[0].message.content)
curl 同理,把 model 字段换成上面的名字即可。跑通之后建议先让它自报家门,确认真的连到了新模型。
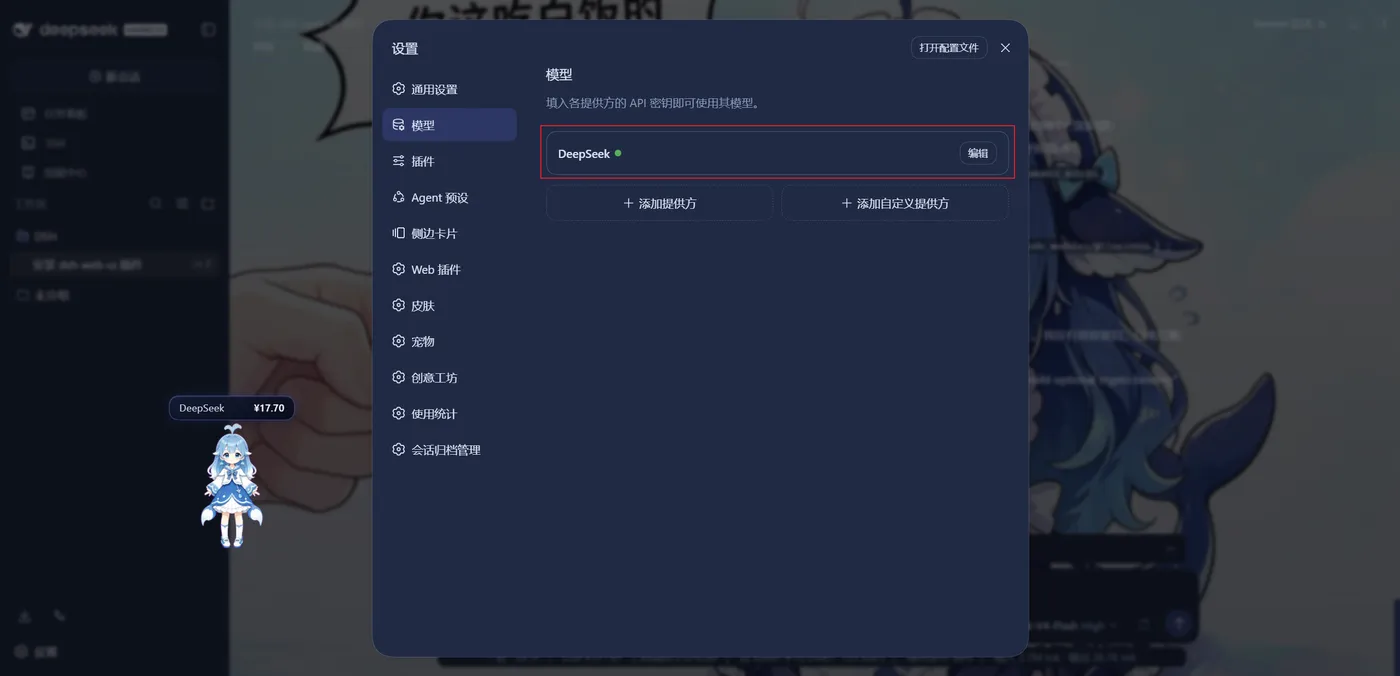
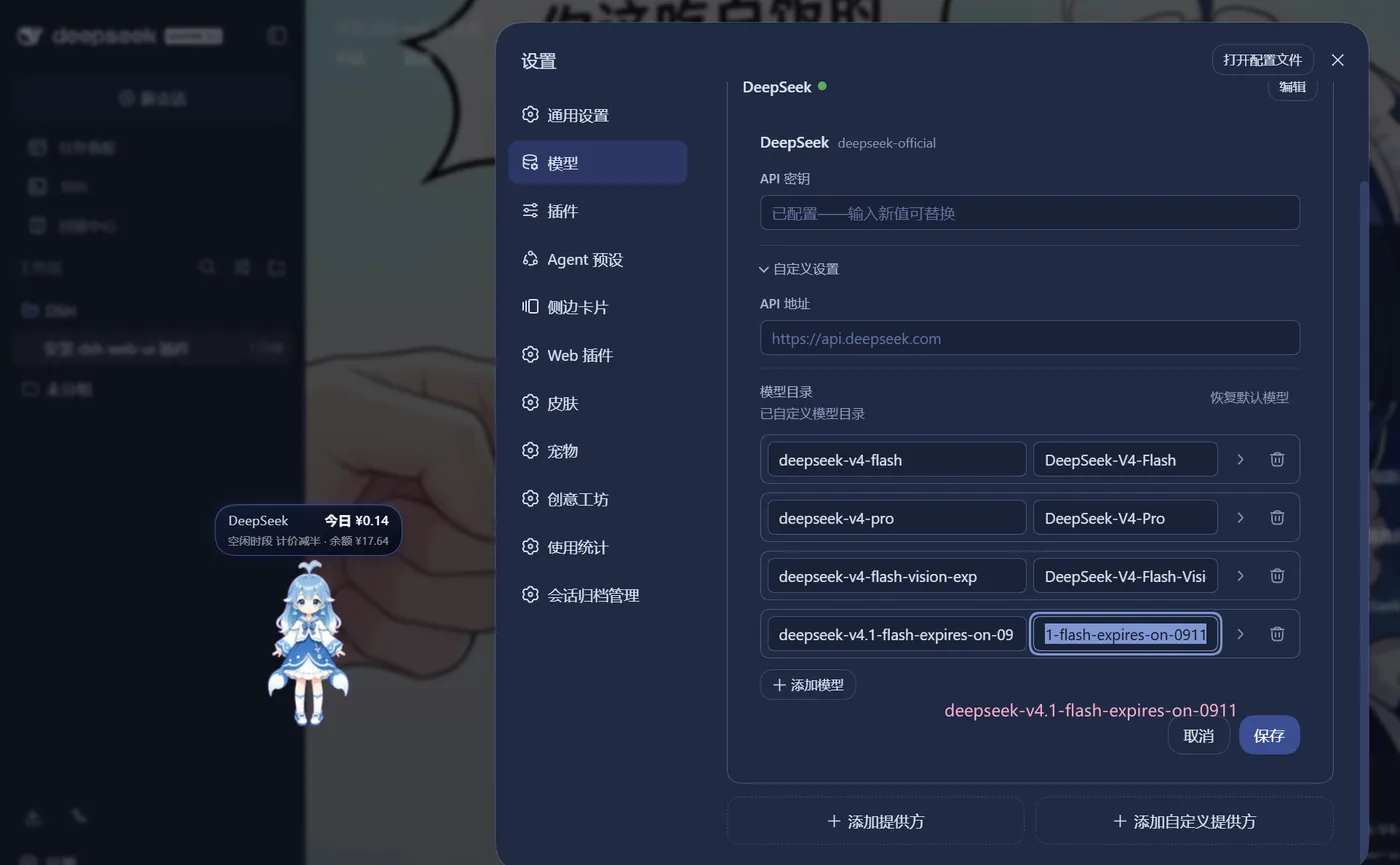
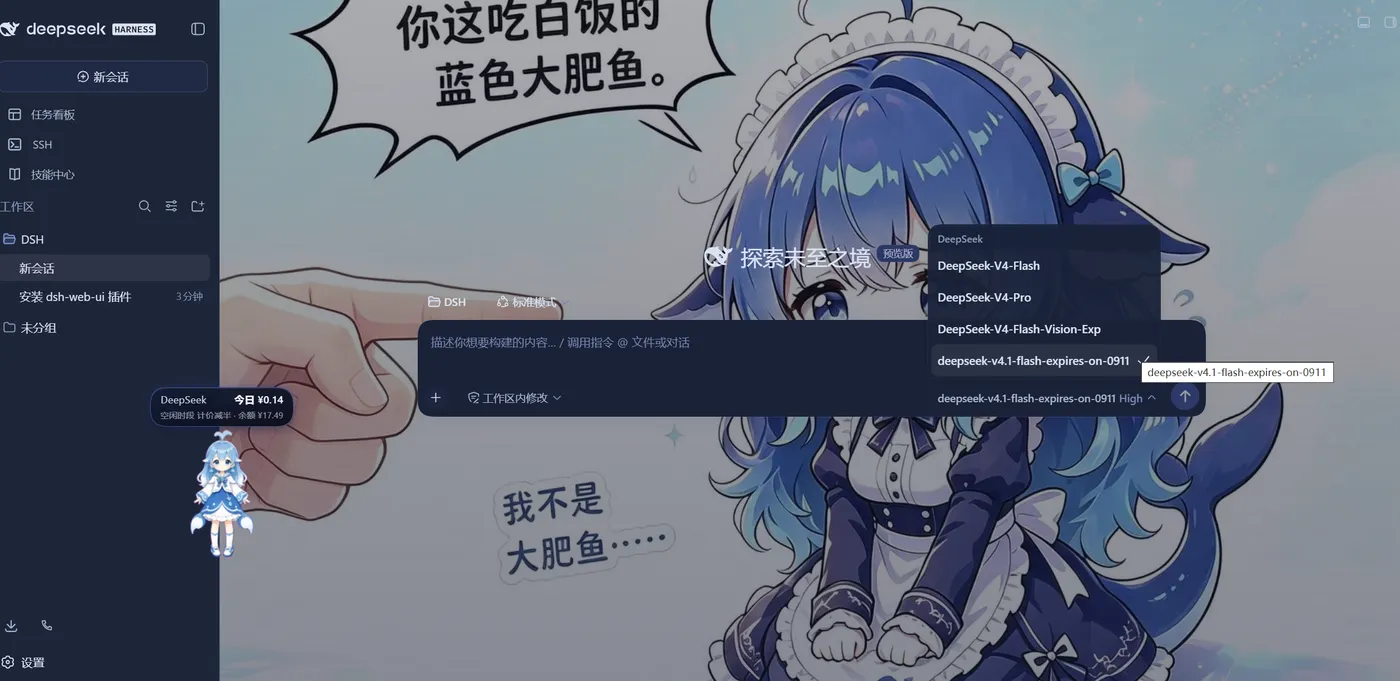
可能有人会问:内测要不要申请,会不会抽中才放行?
按目前多家报道的口径,这次没有单独的白名单流程,有账号有 key 就能换名调用。但官方没有出正式文档,真遇到报错还是以群里公告为准,别照我这篇去质疑客服(笑)。
三、原生多模态:要识图,先检查你的客户端
多模态是这次最大的看点,也是最容易翻车的地方。模型层面原生支持图片输入,但你手里那款客户端不一定默认开了图片开关——有开发者反馈在部分工具里调用时被提示「该模型不支持图片」,其实只是工具的开关没勾上。
所以想喂图,分两步走:
- 确认你用的工具支持图片输入(命令行 SDK 一般要把图片以 data URI 或图片 URL 传进 content)。
- 在有「图片/多模态」开关的客户端里手动勾上,再重新试一次。
四、计费与限流:价格和 v4-flash 一样,先算清账再上手
计费这块最容易想当然。官方口径是:内测期间计费与 deepseek-v4-flash 完全相同,并不是「内测就白嫖」。按 DeepSeek 现行 Flash 定价,空闲时段每百万 token:
| 计费项 | 空闲时段价格 |
|---|---|
| 输入(缓存命中) | 0.05 元 |
| 输入(缓存未命中) | 1.5 元 |
| 输出 | 4.5 元 |
高峰时段(北京时间周一至周五 9:00–12:00、14:00–18:00)翻倍。另外单账号限流 20 路并发,大批量任务的排队一下能看出来。
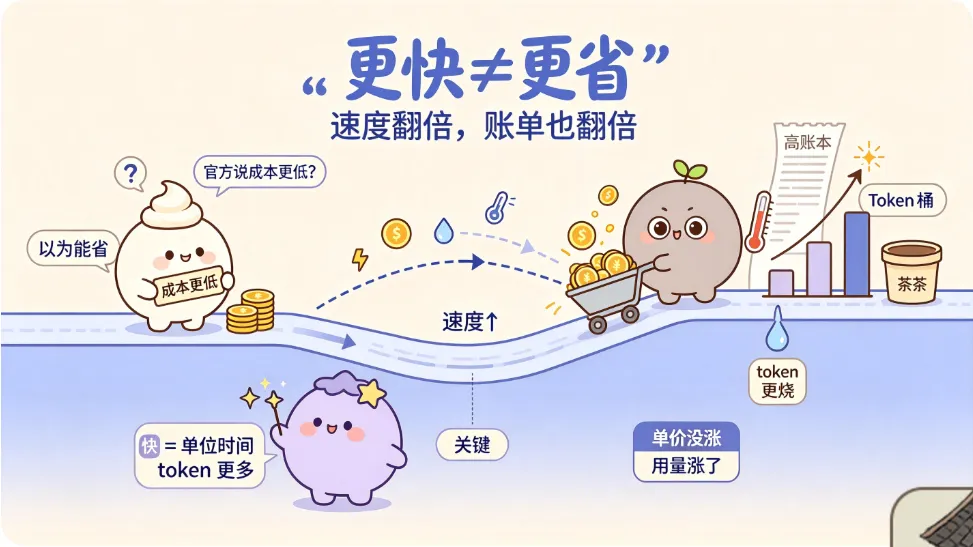
更要命的是「成本更低」不等于「花得更少」。速度上来后,同样的时间 token 消耗反而更夸张,已有开发者晒出"5 分钟烧掉 10 块"(转引自网络报道,未经官方证实)——真不是官方在抬价,是你请求太快,账走得也快。
五、它 9/10 就下线,想试趁早
模型名里写死过期时间,等于官方替你倒计时。expires-on-0910 基本可以理解为 9 月 10 日这个测试端点就到期下线,留给大家体验的窗口只有这一两天。

我的建议很简单:今天就想好一个真实任务丢进去跑,别留到周末再试。 顺便注意一下,DeepSeek 的 Flash 系列正式价会在 9 月 10 日中午下调(我另一篇整理过),价格和到期撞在同一天,账别算岔。
说到底,这次内测最值得学的反而不是模型本身,而是 DeepSeek 的打法:用近乎零门槛的公测,把真实流量当压测场。至于 V4.1 Flash 能不能像问卷里问的那样「全面替换 V4 Pro」——问卷都摆出来了,答案等正式版给吧
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:DeepSeek V4.1 Flash 内测这次赶上了吗,跑起来第一感受是快还是「烧钱」?