EMR Serverless Daft 算子市场免费公测|10分钟极速实战(附视频教程)

简介: Daft 算子市场公测来了!开箱即用的 AI 算子,覆盖 视频 / 图片 / 文本 / 音频 四大场景,搭配 Qwen3.7 大模型,零成本跑通 AI 数据处理全流程。以训练一个能理解厨房操作的智能机器人为例,我们通常需要采集数千小时由人类佩戴摄像头拍摄的操作视频。然而,当这些视频被解码后,往往会膨胀为数亿张图像帧。更棘手的是,原始数据中充斥着静止画面、模糊镜头和无效空帧等海量“噪音”。如何从这些冗余信息中高效提取出高质量训练样本,已成为多模态技术发展的核心瓶颈。本次实战将带您深入这一典型场景,借助 Daft 算子市场,一步步拆解并跑通从视频抽帧、数据清洗到高质量样本提取的完整链路。

多模态数据处理,从写第一行代码开始。

Daft 算子市场公测来了!开箱即用的 AI 算子,覆盖 视频 / 图片 / 文本 / 音频 四大场景,搭配 Qwen3.7 大模型,零成本跑通 AI 数据处理全流程。

以训练一个能理解厨房操作的智能机器人为例,我们通常需要采集数千小时由人类佩戴摄像头拍摄的操作视频。然而,当这些视频被解码后,往往会膨胀为数亿张图像帧。更棘手的是,原始数据中充斥着静止画面、模糊镜头和无效空帧等海量“噪音”。如何从这些冗余信息中高效提取出高质量训练样本,已成为多模态技术发展的核心瓶颈。

本次实战将带您深入这一典型场景,借助 Daft 算子市场,一步步拆解并跑通从视频抽帧、数据清洗到高质量样本提取的完整链路。


🚀 10 分钟完成 demo,超简单

场景介绍:

该 Demo 面向多模态数据处理场景,将对第一视角视频进行分布式抽帧与去黑边处理,并调用 Qwen3.7-plus 多模态大模型精准识别每帧的手部交互动作,并在 Notebook 中直观呈现图文对应的动作分析结果。

视频讲解:

点击查看视频

前提条件:

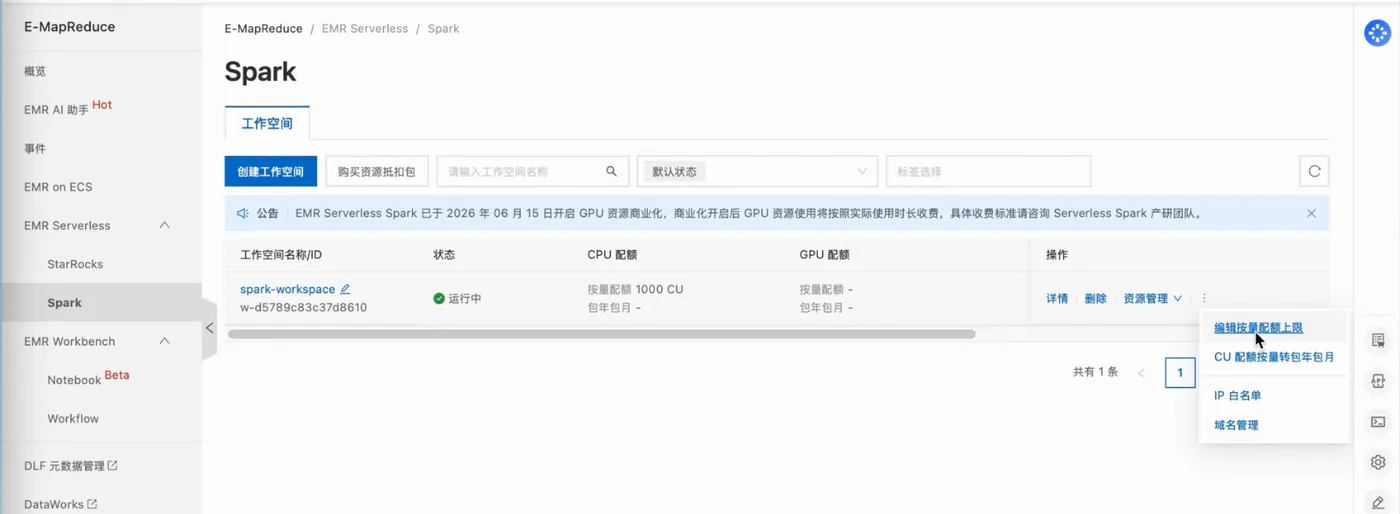
  1. 阿里云账号,开通创建 EMR Serverless Spark Workspace 和 OSS Bucket
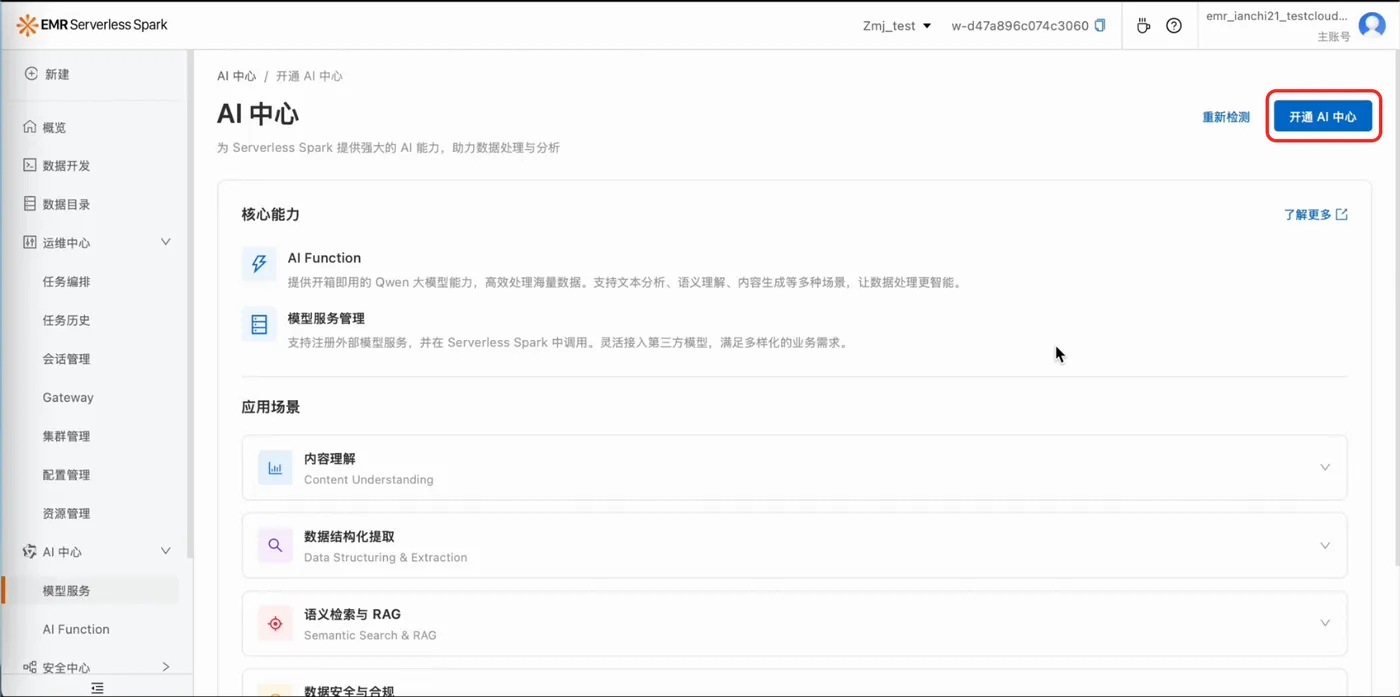
  2. 已开通 EMR Serverless Spark AI 中心。
    请进入 Serverless Spark 的工作空间 - AI中心,点击 "开通 AI 中心"
  3. Spark 工作空间按量配额上限>20 CU


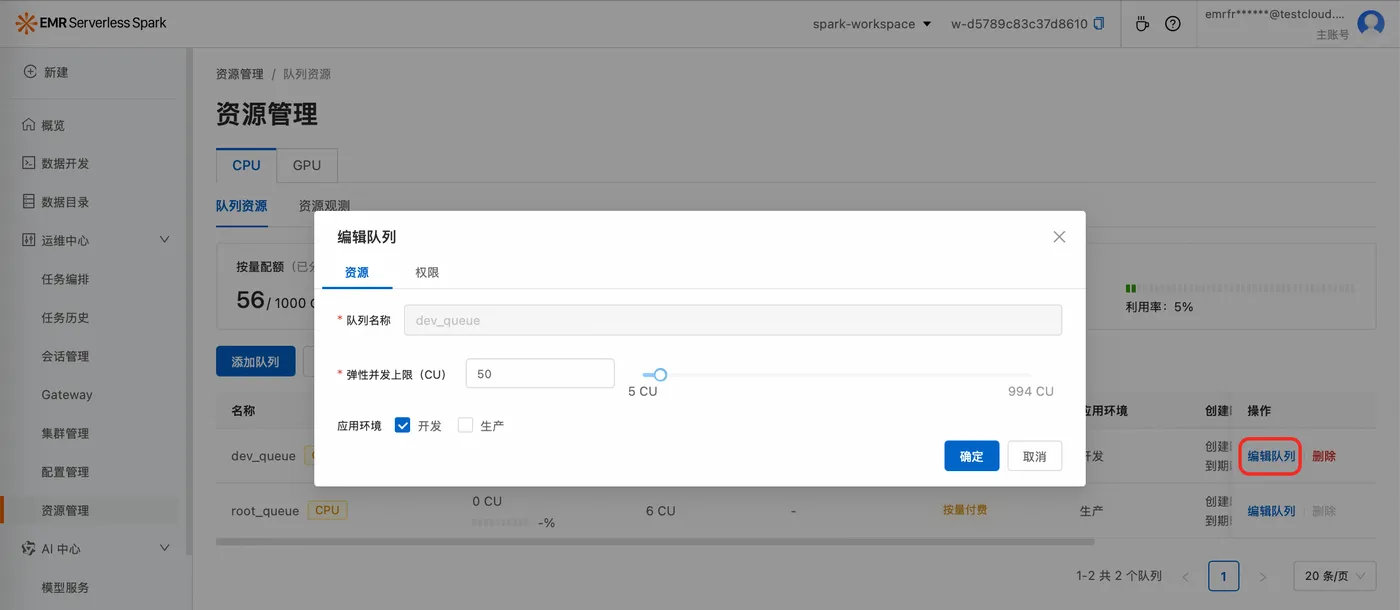
  4. Spark 工作空间队列弹性并发上限>20 CU

操作步骤:

👉 参考原文下载本 demo 中涉及的文件:https://help.aliyun.com/zh/emr/emr-serverless-spark/getting-started/multimodal-data-processing-quick-start?spm=a2c4g.11186623.help-menu-28066.d_1_11.5be758cbIV9DRR

Step 1 · 下载 daft_demo.ipynb 文件,并导入您的 Spark workspace 中

Step 2 · 下载要处理的视频到本地,并上传到您的 OSS Bucket

注意:请确保您的 spark workspace 与 OSS Bucket 属于同一个 region

Step 3 · 替换 daft_demo.ipynb 代码中的路径变量

# 抽帧之后的图片会放到该目录,<请替换为您的 oss 输入视频,以及输出目录>
INPUT_VIDEO = "oss://apsara-demo/dataset/P01_101_part012_299.40s_310.00s.mp4"
OUTPUT_DIR = "oss://apsara-demo/dataset/daft-output/"

Step 4 · 在 Spark Workspace 中,创建 Notebook Session,并运行 daft_demo notebook
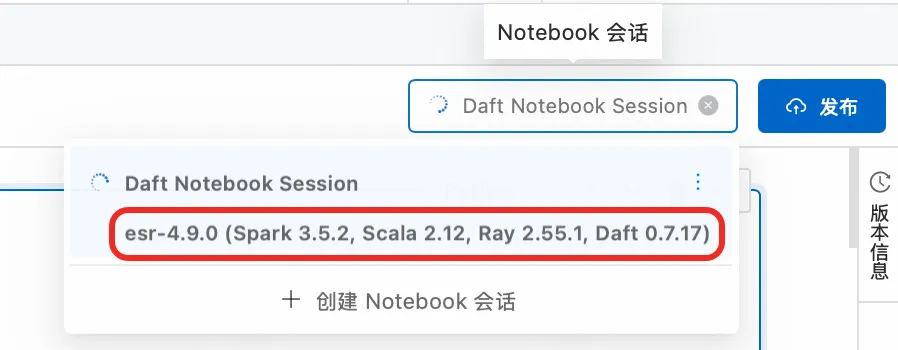
注:选择 esr 版本为为 esr-4.9.0 (Spark 3.5.2, Scala 2.12, Ray 2.55.1, Daft 0.7.17)

运行效果图:
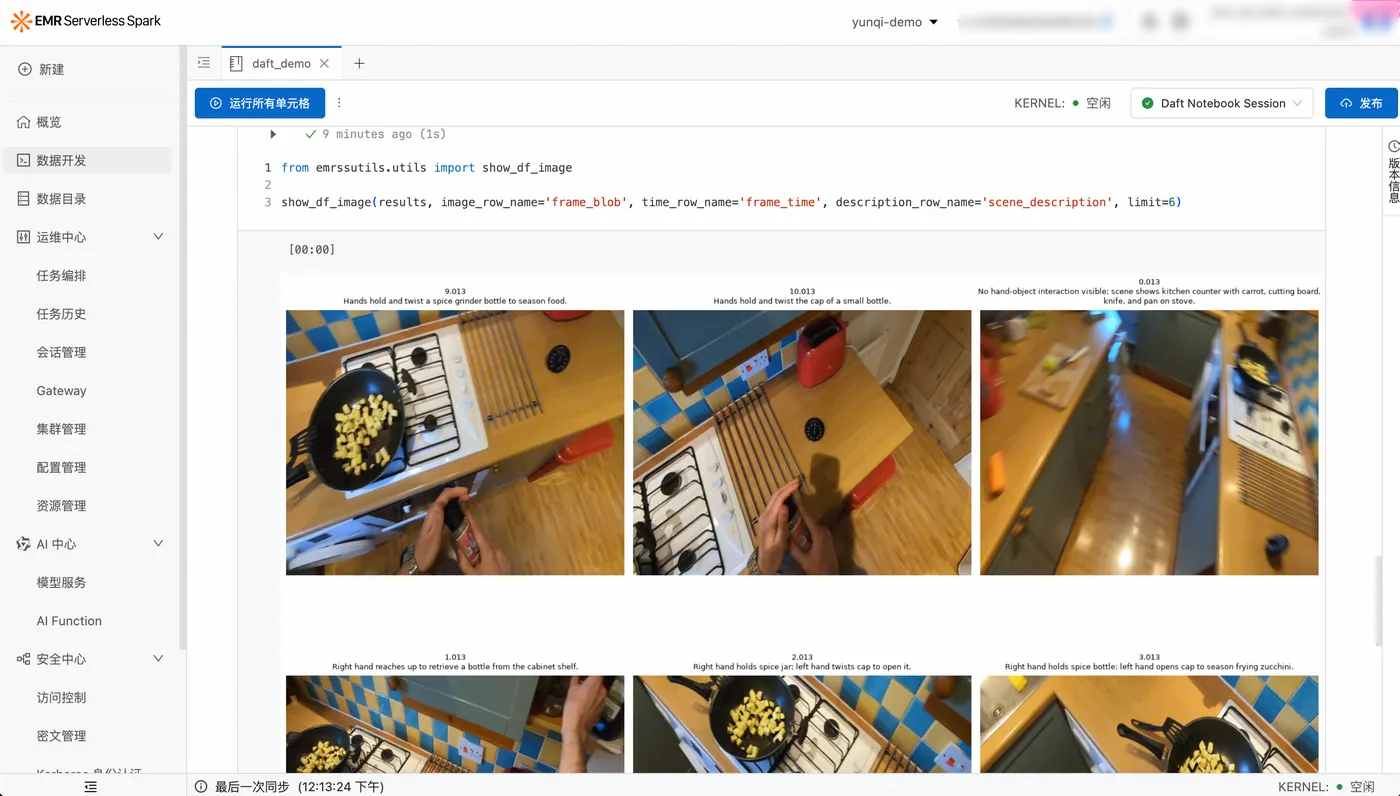
算子市场免费公测窗口

2026 年 8 月 31 日 — 9 月 30 日

公测期间算子调用 Qwen3.7 模型 免费,无其他额外 token 费用!免费模型如下:

  1. qwen3.8-max
  2. qwen3.7-max
  3. deepseek-v4-pro
  4. glm-5.2
  5. qwen3.7-plus (本次活动默认使用模型)
  6. tongyi-embedding-vision-plus-2026-03-06
  7. qwen3.7-text-embedding
  8. qwen-audio-3.0-tts-plus
  9. qwen-audio-3.0-tts-flash
  10. qwen3.7-flash
  11. qwen-audio-3.0-asr-flash

⚠️ 公测须知

公测期间 SparkSQL AI Function、Daft Local、Daft on Ray 运行环境中的算子及 Qwen3.7 模型调用均免费。公测结束后按实际使用量计费,具体标准会在结束前公布,不用担心突然扣费。

公测期间不保障 SLA,但服务不降级,放心用就好。请遵守阿里云数据安全规范,不要上传敏感数据哦。


🔥 立即参与

👉 登录 EMR Serverless Spark 控制台,进入 Spark Workspace,开始你的第一个算子任务吧!

如体验过程中有任何问题,欢迎加入 EMR Serverless Spark 钉群进行交流!


相关文章
|
2月前
|
SQL 人工智能 缓存
阿里云 EMR Serverless StarRocks(Stella 2.2.0)发布:多模态处理与分析闭环,内表与湖表统一检索
Stella 2.2 面向 AI 时代的数据基础设施,打通“多模态数据处理—向量化与理解—多路检索—分析消费”的完整闭环。无论数据沉淀在 Paimon 湖表,还是 StarRocks 存算分离内表,都可以在统一 SQL 入口下组合结构化分析、全文检索、向量检索与 AI Function,服务智能驾驶、具身智能、内容与商品理解、企业知识库和 RAG 等场景。
518 2
|
2月前
|
人工智能 分布式计算 大数据
活动报名 | Agentic Lakehouse Meetup · 北京站,从开源技术创新到多模态数据智能化
8月14日,阿里云在北京举办“Agentic Lakehouse”技术活动,聚焦开源大数据生态如何支撑AI Agent全生命周期。
409 2
活动报名 | Agentic Lakehouse Meetup · 北京站,从开源技术创新到多模态数据智能化
|
2月前
|
人工智能
Qwen3.8抢先体验!正式版即将发布并开源!
千问Qwen3.8即将开源,参数达2.4T,进化速度以“天”计,实力媲美Fable 5。预览版Qwen3.8-Max已上线阿里Token Plan等平台,限时优惠:日间Credits低至1折,夜间更优,个人/团队版月付仅35元起!
4905 154
|
8月前
|
分布式计算 Serverless 测试技术
有奖实践:EMR Serverless StarRocks × Serverless Spark x DLF 共探 TPC 极致性能
免费试用 EMR Serverless StarRocks 与 EMR Serverless Spark,体验“实时分析冠军”与“批处理之神”的极致性能表现!
有奖实践:EMR Serverless StarRocks × Serverless Spark x DLF 共探 TPC 极致性能
|
2月前
|
人工智能 分布式计算 Serverless
阿里云 EMR Serverless Spark 全托管 Ray 再进化:加速构建全模态数据处理新基建
阿里云 EMR Serverless Spark + Ray 双引擎构建全模态数据处理的新基建,通过极致内核优化和统一数据、算力底座,彻底打通了大数据工程与 AI 模型训练的割裂。结合 RayData、Daft、Data-Juicer 等多模态引擎,以及 CPFS、OSS 等高性能存储生态,阿里云正在为全球的 AI 开发者提供一套最具竞争力的数据新基建。
519 0
阿里云 EMR Serverless Spark 全托管 Ray 再进化:加速构建全模态数据处理新基建
|
2月前
|
分布式计算 运维 自然语言处理
EMR Serverless Spark PB级文本语义去重4倍加速的技术方案解读
针对大模型语料清洗中文本去重面临的性能瓶颈,某企业迁移至阿里云emr serverless spark后实现突破。新方案通过minhash-lsh内置函数将算法下沉引擎层,减少40%代码量;结合fusion engine向量化加速与shuffle优化,消除python udf跨进程开销并解决数据倾斜问题。实测去重性能提升4倍,任务耗时从天级降至小时级,且实现零shuffle失败与免运维。该实践验证了serverless架构在pb级数据预处理中的高效性与稳定性,显著加速模型迭代并降低计算成本。
322 0
|
2月前
|
人工智能 分布式计算 Serverless
EMR Serverless Daft 如何简化多模态数据处理:视频抽帧、清洗、标注全流程与具身智能实践
阿里云 EMR Serverless Spark 引入 Ray 分布式计算框架与 Daft 高性能数据引擎,为用户提供了一套开箱即用、免运维且极致高效的多模态数据处理基础设施。
|
7月前
|
存储 分布式计算 数据建模
淘宝闪购基于阿里云 EMR Serverless Spark&Paimon的湖仓实践:超大规模下的特征生产&多维分析双提效
本文介绍阿里云 Serverless Spark + Paimon 在淘宝闪购大数据湖仓场景的应用。
|
2月前
|
SQL 人工智能 Serverless
从数据湖到多模态湖仓-基于阿里云 EMR Serverless StarRocks 与 DLF Paimon 构建AI时代的统一分析检索架构
阿里云 EMR Serverless StarRocks 在统一数据、一致语义和系统级优化之上,构建了面向 AI Data、AI Agent 和多模态应用的下一代湖仓架构。
从数据湖到多模态湖仓-基于阿里云 EMR Serverless StarRocks 与 DLF Paimon 构建AI时代的统一分析检索架构
|
2月前
|
存储 大数据 Serverless
分链路差异化设计的DSP准实时数仓|钛动科技基于阿里云实时计算 Flink 版 + DLF Paimon + EMR Serverless StarRocks 的实践
钛动科技针对DSP广告业务9.6PB数据规模及多场景SLA差异,将原StarRocks All-in-One架构重构为三条差异化链路:NRR链路利用DLF Paimon存储低频数据,降低60%成本;BT链路依托EMR Serverless StarRocks主键表,实现2分钟新鲜度及P99<5ms在线点查;CT链路负责数据归并。通过解耦实时点查与BI物化视图,该方案在保障故障隔离的同时,兼顾了低成本、高性能与高稳定性,实现了阿里云大数据产品栈的高效协同。
266 0

热门文章

最新文章