Qwen3.8-Max 发布解读:2.4万亿总参数、激活950亿,百万上下文与价格拆解

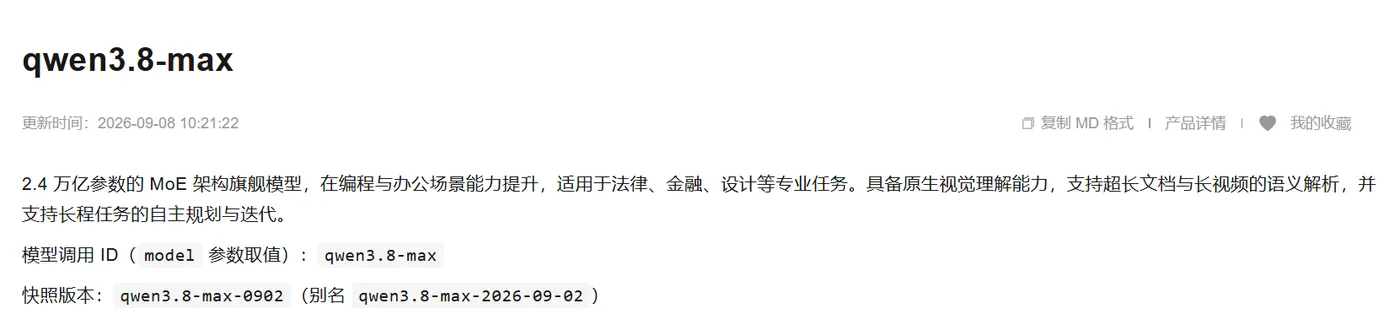
简介: Qwen3.8-Max 于 2026 年 8 月发布:2.4 万亿总参数 MoE、激活约 950 亿,最大支持 100 万上下文,价格与开源计划一并拆解。

大家好,我晚安code。

最近评论区老有人问:国产开源大模型里,到底哪个值得盯?我的答案是 Qwen3.8-Max——不是因为它刷了多少榜,而是阿里这次把「2.4 万亿总参数 + 百万上下文 + 首次开源 Max 级权重」三张牌一起甩了出来。这篇文章把它的规格、价格、开源进度一次讲清楚。

一、先对齐发布时间:8 月初官方发布

先说事实,别被各路自媒体绕晕:阿里巴巴于 2026 年 8 月 3 日官宣 Qwen3.8-Max,8 月 2 日起已在阿里云百炼等多个区域陆续上线(官方文档注明 8 月 2 日已替代 Preview 版本)。它是通义千问系列迄今参数规模最大、能力最强的旗舰模型。

为什么它值得单独写一篇?因为这是千问史上第一次把 Max 级权重拿出来开源——此前开源的都是 27B 之类的小号,Max 只走 API。这次连家底都亮出来了。

二、规格怎么读:2.4T 总参数,激活只有 950 亿

很多人一看「2.4 万亿参数」就以为要 4TB 显存才能跑,其实不是一回事。Qwen3.8-Max 是稀疏混合专家(MoE,Mixture of Experts)架构:总参数 2.4 万亿不假,但推理时只激活约 950 亿参数。你可以理解为「一个几百人的专家团,每次只按题目叫最对口的几个人上场」。

规格项 Qwen3.8-Max
架构 稀疏 MoE + 混合注意力(标准注意力 + 线性注意力)
总参数 约 2.4 万亿(2.4T)
激活参数 约 950 亿(推理时)
上下文窗口 最大 100 万 token
最大输出 13.1 万 token
输入模态 文本、图像、视频(2 秒~2 小时)
输出模态 目前仅文本

上下文这块国内玩家普遍 128K 起步,Qwen3.8-Max 把窗口直接推到 100 万 token,什么概念?大概能装下一整部中等篇幅的小说、几十份长文档,或者一口气喂进两小时的视频内容再让它总结。对长文档处理、法律金融这类专业场景是实打实的红利。

三、能力亮点:16 天自主编程 + 超长内容理解

规格只是参数,我更关心它干起活来什么样。官方披露的几个点比较有信息量:

  • 长周期自主编程:内部测试里它自主完成了一个长达 16 天的真实软件工程项目,产出的「oh-my-cli」自进化智能体框架已开源。16 天连续推进一个项目,考验的不是单次写码能力,而是任务拆解、状态管理和跨天记忆——这正是智能体时代最缺的能力。
  • 超长内容入口:能吞下超百页文档、整部电视剧、100 小时直播,转成可交互的知识库再问答。结合 100 万上下文窗口看,这条链路是通的。
  • 视觉到世界的转换:官方给了不少应用侧案例,从 UI 截图重建前端、2D 户型图出 3D 效果图,到法律文书审查、金融研究都有覆盖。
四、价格:国内输入 12 元/百万 token,主打便宜大碗

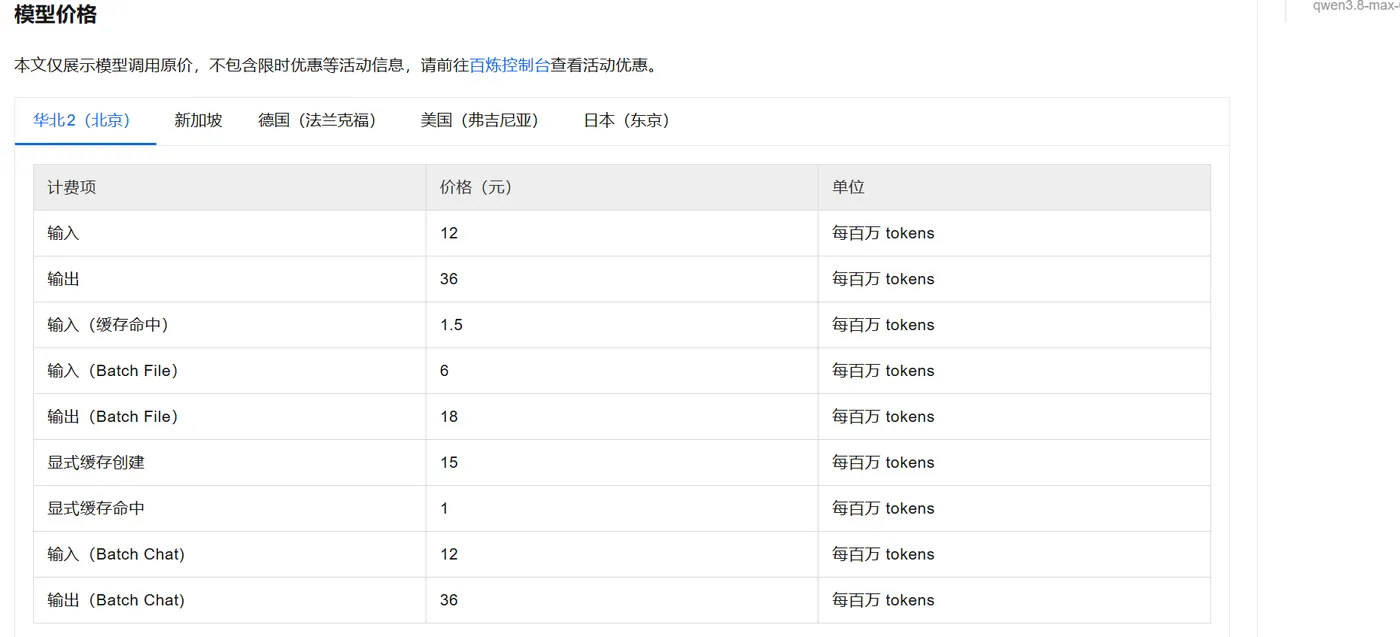
到账环节。Qwen3.8-Max 的国内定价走的是「便宜大碗」路线,输入 12 元/百万 token,跟同体量旗舰比很有竞争力。

计费项 国内价(元/百万 token) 备注
输入 12 华北2 北京等区域
输出 36 —
缓存命中输入 1.5 命中缓存时
海外参考 约 $2 输入 / $6 输出 阿里云国际站口径

要提醒一句:真实成本看你怎么用。百万上下文的输入如果每次都全量喂,再便宜的单价也会叠起来;好在它支持上下文缓存,命中后输入单价能降到 1.5 元/百万 token,长对话、反复读同一批文档的场景一定要开缓存。

五、开源进度:Max 权重首次开源,许可条款要看清

最大变数是许可协议。 按官方计划,Max 级权重与 Qwen3.8-27B 已在 8 月中旬陆续上架开源平台。要注意两点:

  • 「首次开源 Max 级权重」是实打实的里程碑,说明阿里愿意把最强的家底开放出来让人自部署、微调。
  • 但部分报道指出,Max 权重可能不再沿用此前宽松的 Apache 2.0,而是换成了自定义许可,对商用有额外约定。这块官方细则和最终协议我建议以 Hugging Face / ModelScope 仓库页面的 License 声明为准——动笔时细节仍待官方进一步明确。

对绝大多数开发者,我反而更建议关注同批的 Qwen3.8-27B:稠密小模型、能跑本地,性能又不差,才是大多数人真正用得上的那个。2.4T 的全量权重,你本地大概率是喂不下的。
六、我的点评:别被 2.4T 吓到,也别被 2.4T 忽悠

说点个人判断:Qwen3.8-Max 对能用上 100 万上下文的专业场景是真香,但普通个人开发者没必要盯着 2.4T 这个数字。它真正撬动的,是「国产旗舰也愿意开源、也卷价格」这个信号——这比任何单点参数都重要。

可能有人会问:Qwen3.8-Max 现在能用吗?在哪调?

能。API 已上线阿里云百炼平台(model 参数 qwen3.8-max),国内主要区域可直连,支持 Function Calling、上下文缓存、批量推理;新用户在北京区域有 100 万 token 免费试用额度。开源权重自 8 月中旬起在 Hugging Face / ModelScope 陆续提供。

(以上规格与国内价格为阿里官方 2026 年 8 月口径;开源许可细节以 Hugging Face / ModelScope 仓库页 License 为准,海外价以阿里云国际站为准。)

我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:Qwen3.8-Max 的 2.4 万亿权重你打算自部署,还是更看好 27B 本地小模型?
目录
相关文章
|
1月前
|
缓存 人工智能 自然语言处理
阿里云Qwen3.8-Max最全介绍:模型能力、适用场景、使用教程与最新活动参考
本文介绍了阿里云通义千问旗舰基座Qwen3.8-Max,这款2.4万亿参数的MoE架构模型拥有百万级上下文窗口、原生多模态能力,在编程与智能体场景表现突出。文章覆盖五大地域部署差异、分地域Token计费标准、最新0902快照版本特性,同时提供两种接入教程,搭配新用户免费额度、夜间5折等最新活动,帮助开发者快速上手这款第一梯队大模型。
|
1月前
|
存储 人工智能 自然语言处理
Qwen3.8-Flash 上线千问AI平台:全新架构,迈向极致性价比
Qwen3.8-Flash 现已上线千问AI平台,默认提供 100 万 token 上下文并内置官方工具,每 token 仅激活 6B 参数,适合高并发应用、工具驱动的工作流以及编程与协同办公助手。
1020 1
|
1月前
|
缓存 人工智能 自然语言处理
阿里云qwen3.8-flash最全介绍:模型能力、适用场景、使用教程与最新活动参考
本文介绍了通义千问Qwen3.8-Flash这款兼顾性能与速度的多模态大模型,它拥有百万级上下文窗口,原生支持图文视频多模态输入,在长文档处理、编程辅助、高并发应用场景表现突出。文章覆盖五大地域部署差异、最新下调后的Token计费标准、两种接入方式与限流规则,叠加新用户免费额度、夜间4折等活动,是企业与开发者平衡效果与成本的高性价比选型。
|
2月前
|
缓存 人工智能 数据挖掘
阿里云qwen3.8-max模型详解:模型能力、价格、上下文限制及使用注意事项参考
本文全面解析阿里云的Qwen3.8-Max旗舰大模型,这款采用2.4万亿参数MoE架构的通义千问系列最强模型,定位为智能体时代全能旗舰,在全球5个核心区域同步部署。它具备百万级超长上下文窗口,支持文本、图像、2小时内长视频的原生多模态输入,可独立完成跨天级软件工程交付、法律金融等专业领域生产级任务,同时实现数千轮交互下的长程任务自主规划与闭环迭代。文章同步梳理了不同区域的功能支持差异、梯度定价策略与API调用要点,明确了其适配复杂智能体应用的核心优势,新用户登录百炼平台即可领取百万Tokens免费试用额度。
阿里云qwen3.8-max模型详解:模型能力、价格、上下文限制及使用注意事项参考
|
1月前
|
人工智能 算法 安全
Qwen3.8抢先体验!正式版即将发布并开源!
Qwen3.8是阿里通义实验室发布的开源大模型,实现架构重构(动态MoE+Sparse-Tiled Attention)、推理升级(CoT++自我验证闭环)、原生多模态(UMT统一嵌入)及全栈开源,推动AI向高能效、强自主、全模态演进。(239字)
1033 2
|
1月前
|
缓存 JSON API
阿里云千问Qwen3.8‑Max深度解析:核心能力、订阅计费规则、API接入配置与生产落地完整教程
Qwen3.8‑Max作为千问系列新一代MoE架构旗舰基座,总参数量达到2.4万亿,激活参数950亿,是面向复杂专业任务、长周期智能体、工程级代码开发、多模态深度解析的高阶大模型,原生支持文本、图像、视频多模态输入,最大上下文窗口达到百万Token,最大输出Token支持131072,内置深度思考推理链路,在编程、科研、法律金融专业分析、长视频文档解析、自主Agent任务等场景能力表现突出。很多开发者在项目前期直接接入该旗舰模型,却对模型能力边界、多种计费模式、订阅套餐权益、API参数配置、上下文缓存优化缺乏完整认知,出现成本失控、接口报错、长文本信息丢失、深度思考模式额外消耗大量Token等
2082 5
|
1月前
|
缓存 API 开发工具
DeepSeek V4.1 Flash API 接入指南:价格说明与调用方法全解析
本文详解直连 DeepSeek V4.1 Flash(`deepseek-flash`)的完整接入流程:从平台选型(官方API/第三方网关)、费用估算(分缓存/非缓存输入与输出计价)、Key与模型匹配,到Python/curl首次调用验证。内容基于2026年9月11日官方文档核查,含实操代码与避坑提示。
|
1月前
|
缓存 人工智能 API
阿里云qwen3.8-max大模型介绍:模型能力、模型价格、免费额度与最新活动
本文是面向开发者的Qwen3.8-Max选型与接入参考指南,覆盖这款2.4万亿参数MoE旗舰模型的核心能力、全场景适配范围、阶梯计费规则、剩余25%的百万级免费额度、百万级上下文与高TPM限流参数,配套OpenAI兼容模式的Python调用示例,同步梳理当前Token Plan订阅、夜间5折等专属优惠,帮助开发者快速完成模型选型与落地接入。
|
1月前
|
缓存 自然语言处理 API
阿里云Qwen3.8‑Max、Qwen3.7‑Max、Qwen3.7‑Plus、Qwen3.7‑Flash、Qwen3.8‑Flash功能区别解析,企业项目选型完整指南
随着大模型智能体落地场景持续拓宽,越来越多开发者会面对多款同系列模型选型难题。阿里云百炼平台上架的Qwen3.8‑Max、Qwen3.7‑Max、Qwen3.7‑Plus、Qwen3.7‑Flash、Qwen3.8‑Flash五款模型,覆盖从复杂深度推理、长周期智能体、多模态GUI操控到高吞吐低成本业务场景,不同模型在架构、上下文窗口、模态支持、代码能力、工具调用稳定性、计费成本上存在明显差异。很多开发者在项目前期直接选用高规格旗舰模型,带来不必要的高额推理成本;也有部分场景误用轻量模型,造成复杂任务推理失败、工具调用错乱、长文档解析丢失关键信息等问题。本文将从底层架构、核心能力、适用业务场景
876 1

热门文章

最新文章