问题描述
在一个典型Function App处理业务链路中,数据通过 Azure Functions(Node.js) 代码写入 Redis:
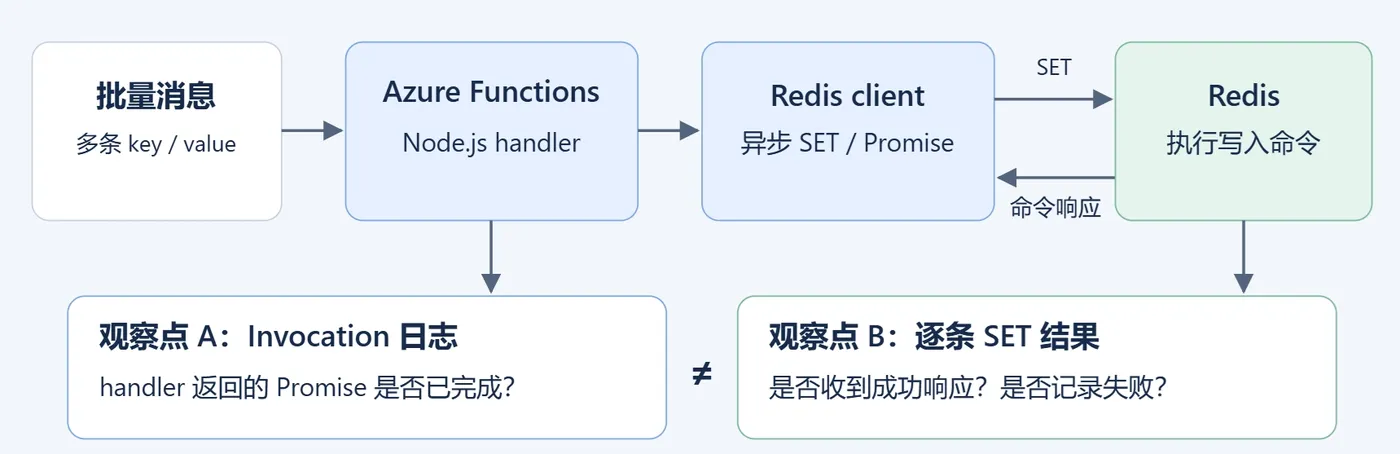
Azure Functions 中批量写 Redis 时,看到 Invocation 已完成,不代表每个 Redis SET 都完成了。
如果代码用 callback 调用 client.set(),随后立即执行 client.quit() 或直接返回,Function Runtime 可能认为本次执行已经结束,但 Redis 写入还在事件循环里排队。
现象很容易误导人:
- Function 调用日志显示已经执行完成
- Redis 服务本身没有明显异常
- Function 实例的 CPU 和内存也正常,但 Redis 中仍然偶发缺少部分 key。
更奇怪的是,这个问题不是每次都出现,单条或少量数据时几乎看不出来,一到 50、100、200 条这种批量写入场景,缺失概率就明显上升。
如果遇见这样的情况:
第一反应不是先怀疑 Redis,而是先看 Function 代码有没有真正等待异步写入完成。
因为 Azure Functions 判断一次 Invocation 是否结束,依赖的是你的 handler 是否返回、抛错或完成 Promise。
如果 Redis 写入还没被纳入这个 Promise 链,Runtime 就没有理由继续等它。
典型写法如下:
for (const item of messages) {
    client.set(item.key, item.value, function (err) {
        if (err) {
            console.log(err);
        }
    });
}
client.quit();
这段代码看起来做了四件事:
- 遍历数据
- 写 Redis
- 处理错误
- 关闭连接
但真正的问题也藏在这里:client.set() 是异步调用,callback 还没执行完,外层循环已经继续向后跑。client.quit() 又可能在 Redis 命令真正完成前关闭连接。最终你看到的是 Function 成功结束,但 Redis 里只写进去一部分数据。
问题解答
1. Function 已结束,不代表 Redis 写入已完成
在 Node.js 里,调用 client.set() 并不等于 Redis 已经完成写入。
它更像是把一个 I/O 操作交给事件循环处理,然后 JavaScript 主流程继续执行下一行。
如果外层 handler 没有 await 这些 I/O 操作,Azure Functions Runtime 只能看到“主函数已经走完了”,看不到“后台还有 Redis callback 没回来”。
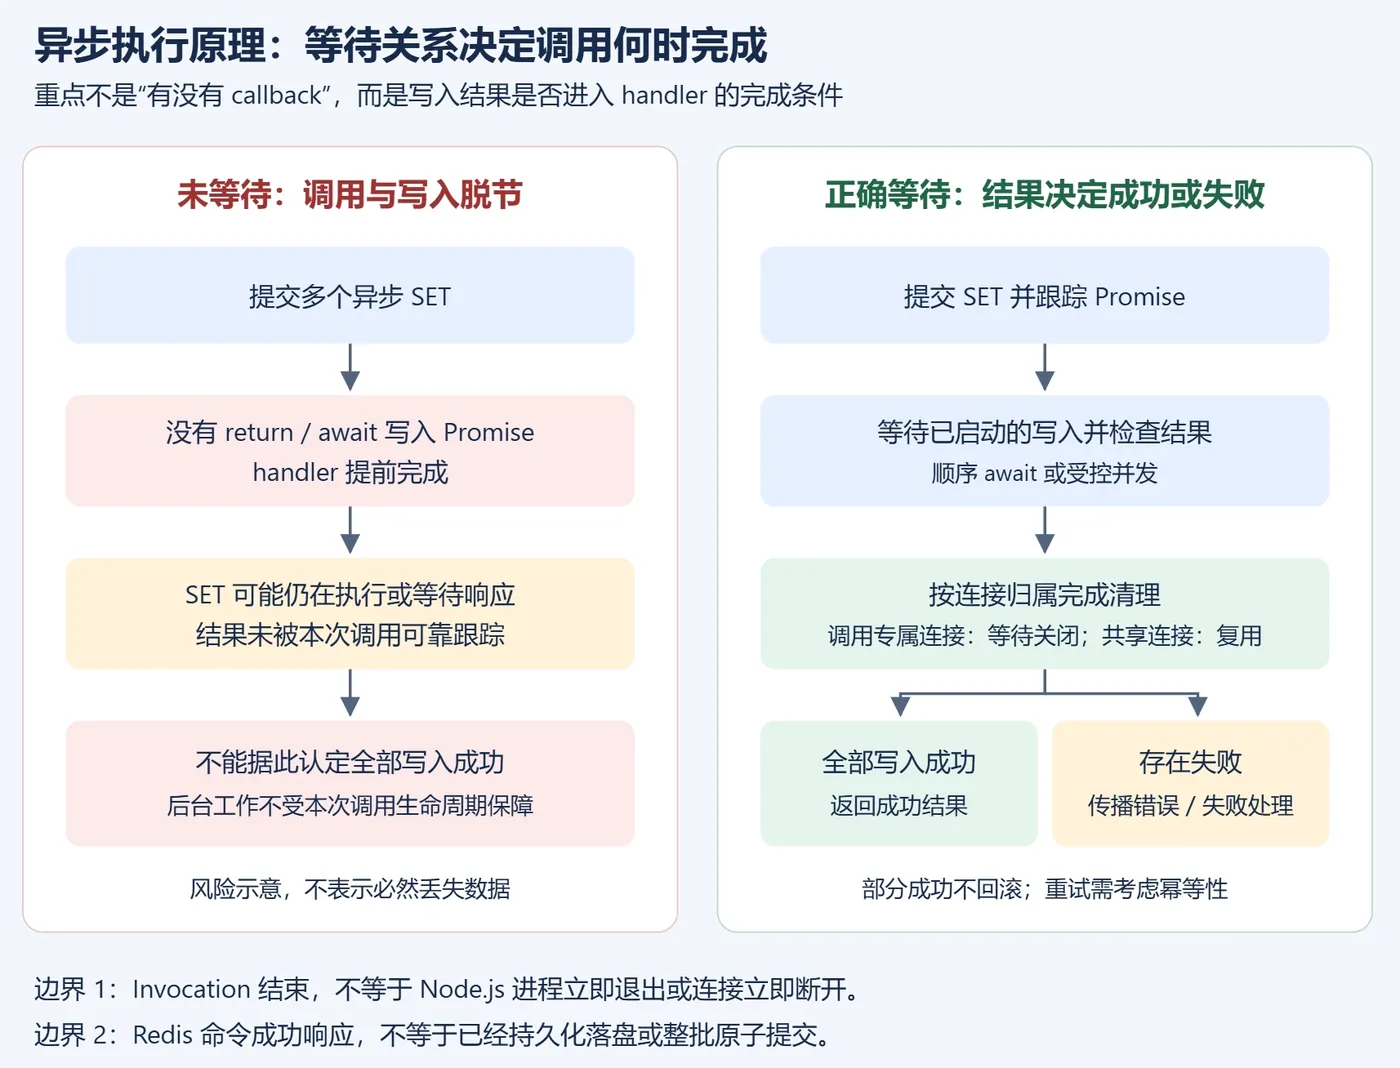
这里需要区分两个概念:
- Invocation 结束不代表进程或连接立即终止
- quit() 的优雅关闭也不能直接等同于强制断连丢弃命令
图中强调的是写入结果是否被本次调用等待和检查,而不是“调用一返回就必然丢数据”。
批量场景更容易暴露这个问题,是因为异步请求数量突然变多。单条写入时,即使代码不严谨,也可能因为 Redis 响应很快而“看起来没问题”;
但当一次 Invocation 内提交几十到几百个 SET,连接关闭、事件循环调度、网络延迟和 Redis 响应时间之间只要出现一点错位,就会表现为“不是全部失败,而是随机少一部分”。
2. Azure Functions 官方为什么建议使用 async/await
Azure Functions Node.js 官方文档建议使用 async 和 await,而不是 callback 或单纯的 .then() 链式写法。它主要解决两类问题:
第一,异步回调中的异常如果没有被正确捕获,可能变成未捕获异常并影响 Node.js worker;
第二,没有被正确等待的异步调用,可能导致日志缺失、响应内容为空、外部写入未完成等不可预期行为。
把这个原则放到 Redis 场景里,就是一句话:Function 返回之前,必须让 Redis 写入的 Promise 全部 settle。 不要把 client.set() 当成同步调用,也不要在写入还没完成时执行 client.quit()。
如果你使用的是新版 node-redis,client.set() 本身返回 Promise,就应该直接 await。
最小正确写法如下:
const { createClient } = require('redis');
module.exports = async function (context, req) {
    const messages = Array.isArray(req.body) ? req.body : [];
    const client = createClient({
        url: process.env.REDIS_URL
    });
    client.on('error', (err) => context.error('Redis Client Error', err));
    try {
        await client.connect();
        for (const item of messages) {
            await client.set(item.key, JSON.stringify(item));
        }
        context.log(`Redis write completed. count=${messages.length}`);
        context.res = {
            status: 200,
            body: { written: messages.length }
        };
    } finally {
        await client.quit();
    }
};
这段代码的生命周期非常清楚:connect 被等待,所有 set 被等待,quit 也被等待。
只要其中任何一步抛错,Function Invocation 会失败,日志也更容易和本次执行关联起来。
它不会制造“Function 成功但数据悄悄少写”的假象。
参考资料
Azure Functions Node.js developer reference : https://learn.microsoft.com/en-us/azure/azure-functions/functions-reference-node?tabs=javascript%2Cwindows%2Cazure-cli&pivots=nodejs-model-v4
当在复杂的环境中面临问题,格物之道需:浊而静之徐清,安以动之徐生。 云中,恰是如此!