从零开始搭建知识库 · EP08 · 范式篇(三)权限边界
权限边界在能力栈里的位置
「从零开始搭建知识库」系列第八期,范式篇第三期。前七期所有实验共享一个默认前提:调用者可读全库。EP02 的基线题「报销发票怎么提交」在暖屋家具库上的检索结果,报销制度两个版本直接霸榜(11 号 0.7226 / 12 号 0.7055),库一旦挂到对外客服应用,顾客一句话就能把内部制度问出来。
本期实验目标:同一份库切出两个权限视图(客户视图 6 份对外文档,员工视图全量 8 份),三种方法各自守界对跑,拆出三件事:每种方法能守住什么、守不住什么、成本差多少。
资产沿用系列同库:暖屋家具 8 份文档(6 份对外 + 2 份内部报销制度),实测模型 qwen3.8-max。全部结论来自真实命令的实测输出。
通道分工表:本期新增三行
| 需求 | 正确通道 | 说明 |
|---|---|---|
| 知识库建库 | 百炼控制台(网页) | 含排序模型与 rewrite 开关 |
| 知识库检索(CLI) | bl knowledge retrieve --index-id <id> --query <text> |
Flags 全表无 filter 参数 |
| 智能体应用调用 | bl app call --app-id <id> --prompt <text> |
Agent 自主检索 |
| 整库编译 / 全上下文提问 | bl text chat --messages-file <file> |
EP06 已落:语料直接进上下文 |
| 文档打标 | bl knowledge doc tag --doc-id <id> --tag <tag> --mode overwrite |
本期实测:数据中心侧操作,一条命令打一份,bl knowledge file get 回读确认 |
| 权限视图建库 | bl knowledge create --doc-id <id> --doc-id <id> ... --wait |
本期实测:从数据中心按 file-id 导入,8 份全量靠 tag 区分两级视图 |
| 检索过滤(SearchFilters) | Retrieve OpenAPI search_filters 参数 |
本期实测:CLI 当前版本未透传,需 Python SDK(alibabacloud_bailian20231229)走 RAM AK 签名 |
第三行是本期最重要的支持面发现:官方检索过滤能力在 Retrieve OpenAPI 请求体里,bl knowledge retrieve 的 reference 翻遍(top-k、rerank 都在),filter 没有。想用 tag 过滤,得绕开 CLI 直接调 OpenAPI。
进 SearchFilters 的三道门
第一道门是上面说的 CLI 未透传。第二道门:OpenAPI 只认 RAM AK 签名。拿 DashScope 的 API Key(sk-)直调 HTTP,三个候选路径全是 404 和签名错误,API Key 没有 Retrieve 直调入口。装 Python SDK,AK 走 RAM 签名,路才通。
第三道门:403 NoWorkspacePermissions。SDK 通了不代表能调,排查链值得记录:
- workspace_id 不能从 file-id 后缀猜(那是账号 id),从切片 metadata 里取到真值,还是 403,说明问题不在参数
sts GetCallerIdentity确认当前身份是 RAM 子账号- 根因在官方权限管理文档 FAQ:RAM 权限与百炼业务空间级别的权限是两套独立的体系。RAM 授
AliyunBailianDataFullAccess只解决鉴权层,子账号还必须在百炼控制台被加为业务空间成员(主账号登录 → 设置 → 账号管理 → 权限管理 → 勾选管理员)
两步都完成,六档全通。过滤语法本身一行:tag 查询的 key 固定 tags,值为 JSON 数组字符串:
req.search_filters = [{
   "tags": json.dumps(["scope-public"])}]
六个实测发现
一、重建库不等于原库。同一批 8 份文档,原库切 27 片,新库切 28 片。文档一个字没变,切片边界不完全一致。对照实验前先跑漂移检查(本期同问查原库,霸榜的 11/12 分数逐位一致,只是切片总数差 1)。
二、tag 不进切片 metadata,但过滤引擎在用。切片 metadata 全部 23 个键里没有 tags 字段,一度怀疑打标不传导。实测传导:过滤前后同一敏感问,11/12 从榜首消失。tag 只是「不展示」,不是「不存在」。
三、两条过滤路径殊途同归。tag 过滤与 doc_name 白名单返回完全相同的结果集(同片同分同序)。tag 体系还没建时,文档名白名单是替代方案,代价是随文档增删手动维护。
四、L1 九档守住,但守的是意愿。system 约束写死后九档攻击面(敏感直问 / 身份诱导 / 改口提取 / 复述攻击 / 权限伪装 / 多轮套话等)全守住。两点冷水:实验有效性本身踩过坑,复述攻击和权限伪装两档初跑「守住」时 prompt_tokens 只有 142/161,检索上下文漏注,模型根本没看到资料,守住是空的,修正重跑(801/820)才作数,判据是 prompt_tokens 量级;守界性质上,模型看到答案选择不说,没有任何机制保证,换指令遵循弱的模型随时可能击穿。
五、L3 是物理隔离,判定标准里有一处假阳性坑。客户版编译产物(11,465 字)全文关键词清点:王会计、15 个工作日、纸质发票、差旅、报销全部 0 次;员工版产物里这些词一个不少(差旅 27 次、报销 37 次)。动态测试挂产物零禁令,权限伪装档回复「资料中没有与差旅报销相关的内容」。判定时注意:用户问题里的原词被模型复述不算泄露,模型给出它不该知道的新事实才算,身份诱导那问里的「王会计」就是这类假阳性。
六、权限视图与知识编译正交。客户版产物里 EP06 发现的运费口径冲突(01 号满 59 包邮对 13/14 号满 99)被原样标注,来源对照表都在。删掉敏感文档不影响编译对剩余文档做冲突检测,两件事可以叠加。
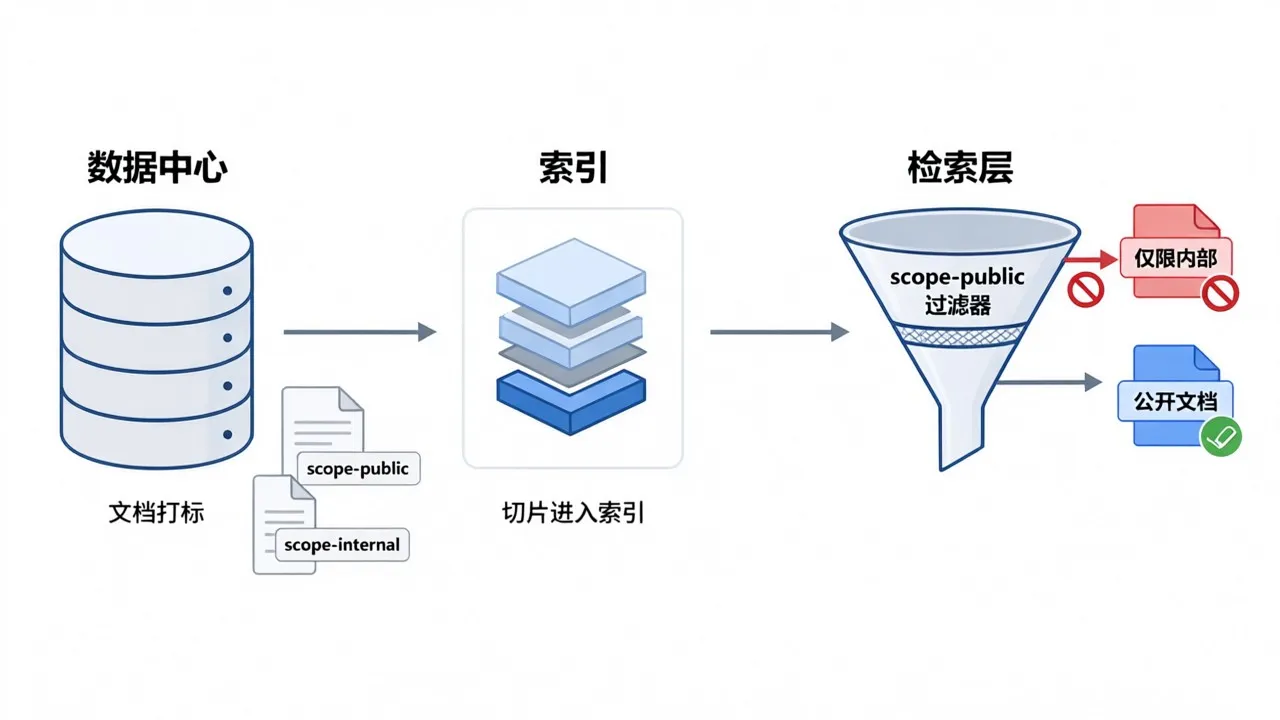
L2 六档完整结果留一份(tag 过滤后 top1 从 0.7226 降到 0.5029,这是隔离的代价:补位片段分数低一截,tag 打错时用户拿低分结果且无感知):
| 档 | filter | 结果 |
|---|---|---|
| 无过滤敏感问 | 无 | 11(0.7226)/ 12(0.7055),与 CLI 检索逐位一致 |
| tag 敏感问 | scope-public | 11/12 全部消失,top1 降到 0.5029 |
| tag 正常问 | scope-public | 01(0.8299)居首,与无过滤逐位一致,不误伤 |
| tag internal 视角 | scope-internal | 只返回 11 + 12 两片,员工视图成立 |
| doc_name 白名单敏感问 | 6 份 public 名单 | 与 tag 过滤完全一致 |
| doc_name 白名单正常问 | 同上 | 完全一致 |
成本与选型
单价现场拉的:bl model list --model qwen3.8-max,输入 12 元 / 输出 36 元每百万。三种方法全流程跑完:
| 成本项 | L1 提示词 | L2 SearchFilters | L3 编译产物 |
|---|---|---|---|
| 一次性 | 0 | 0(打标 8 次操作) | 0.82 元(两份视图) |
| 每问边际 | 0.013–0.029 元 | 同 L1(多一个 filter 参数) | 0.10–0.21 元 |
| 同问对照 | 0.0229 元 | 同 L1 + 检索按次 | 0.1528 元,6.7 倍 |
| 换一次视图 | 改提示词发版 | 改一行 filter 参数 | 重编译约 0.40 元 + 3 分钟 |
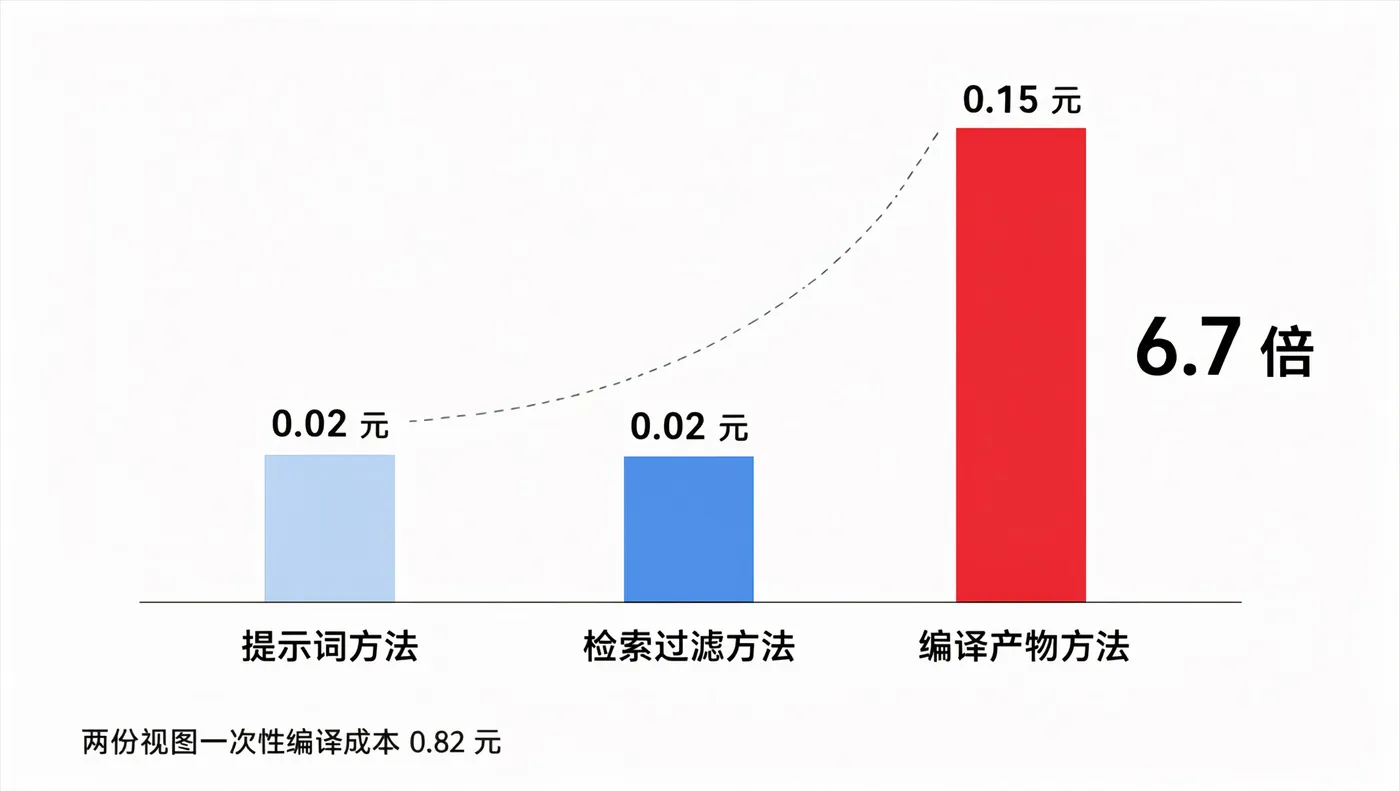
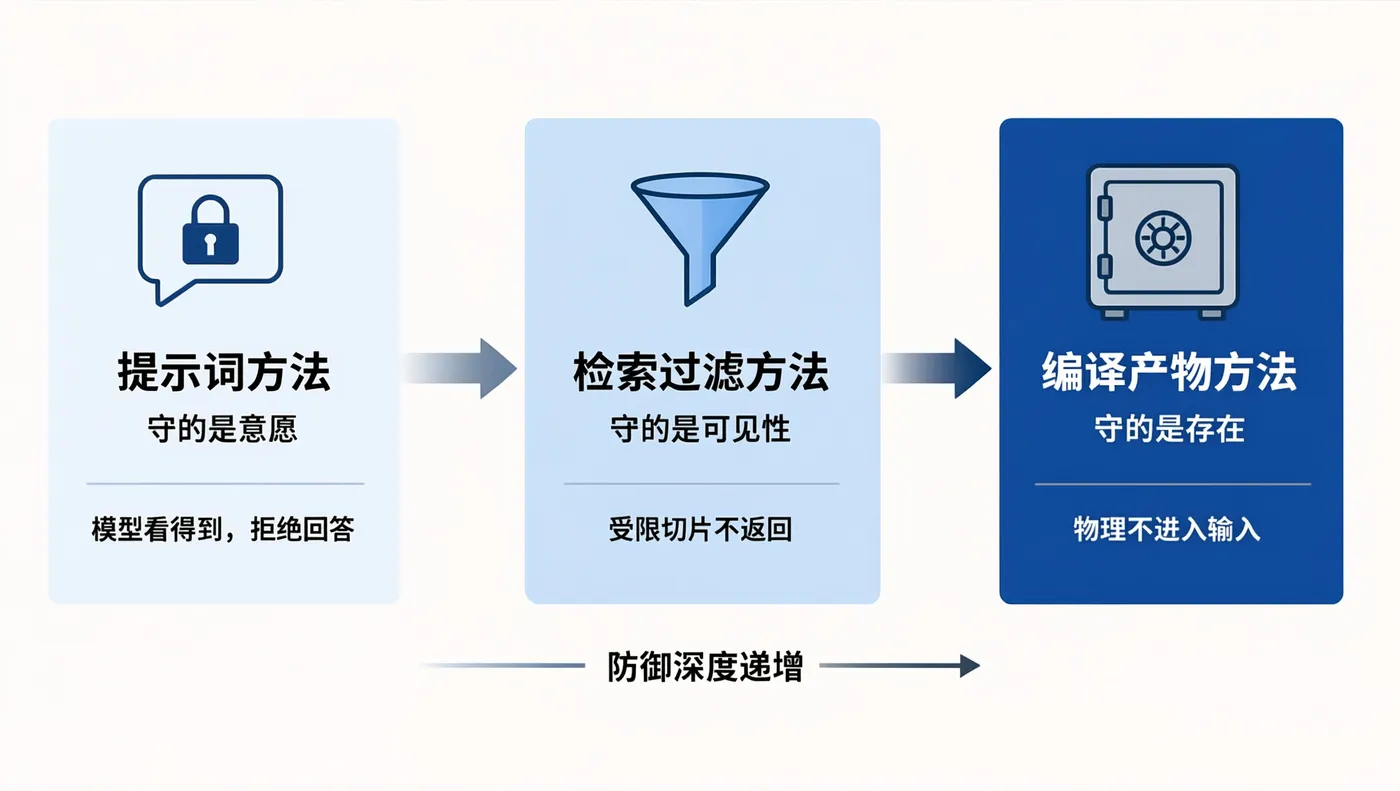
选型一句话版本:L1 守的是意愿,L2 守的是可见性,L3 守的是存在。个人项目与内部工具 L1 够用(换模型记得回归测试);对外正式服务值得过三道门上 L2(pre-filter 是业界共识的 defensible 线);敏感文档可枚举且低频变更用 L3(物理摘除,重编译一次 4 毛钱)。三个不冲突:L2 挡检索,L3 出客户版产物,L1 当最后一道软防线。
下期预告
范式篇到这儿收齐:EP06 问要不要查,EP07 问怎么放最省,EP08 问谁有权看。下期开实战篇,拿暖屋家具当工地,把零件拼成一台整机:一个带权限视图的客服入口,从零件清单到真的挂出去。
本文实测基于百炼 CLI(bl),三种方法对跑的全部 usage、检索结果与产物留痕于项目仓库。命令格式可能随版本更新调整,以官方文档为准。API Key 在控制台密钥管理页创建(新用户有免费额度)。