
一、场景还原:典型的数据异常事件链
先还原一个真实场景,让分析有锚点:
周一早 9:15,运营负责人打开大屏,发现昨日 GMV 同比下降 40%。他截图发到钉钉群:"这个数不对吧?昨天大促怎么可能跌这么多?"数据开发看到消息后问:"哪个指标?哪个口径?跟哪个数比的?"运营说:"就是大屏上那个 GMV 啊,昨天肯定不止这个数。"开发停下手头的其他工作,开始排查:先查上游表有没有产出 → 再查 ETL 任务有没有报错 → 再查 SQL 逻辑最近有没有改过 → 再查是不是口径理解不一致……3 小时后,结论出来了:上游某业务系统凌晨做了发版,订单表中一个字段改了数据口径。
其中 2 小时的打断成本就是 AI 可以压缩的空间。
二、AI 处理能力和流程
核心能力
- 业务自助 · 研发减负:AI 助理前置完成问题预判与责任人定位,业务方无需再追问"数据谁产出、问题找谁";研发接手时已有初步定位,处理更高效。
- 语义驱动映射:结合 Context Graph(知识库),将模糊问题逐层拆解「问题 → 指标 → 字段 → 表」,实现从问题描述到数据资产的自动定位。
- 多维诊断:任务状态 · 数据质量(含口径校验) · 代码变更 · 表血缘——多个排查维度并行/串行执行。
- 沉淀经验:典型问题回流沉淀为可复用经验,相似问题高效匹配;经验库同时作为流程优化的决策参考。
处理流程
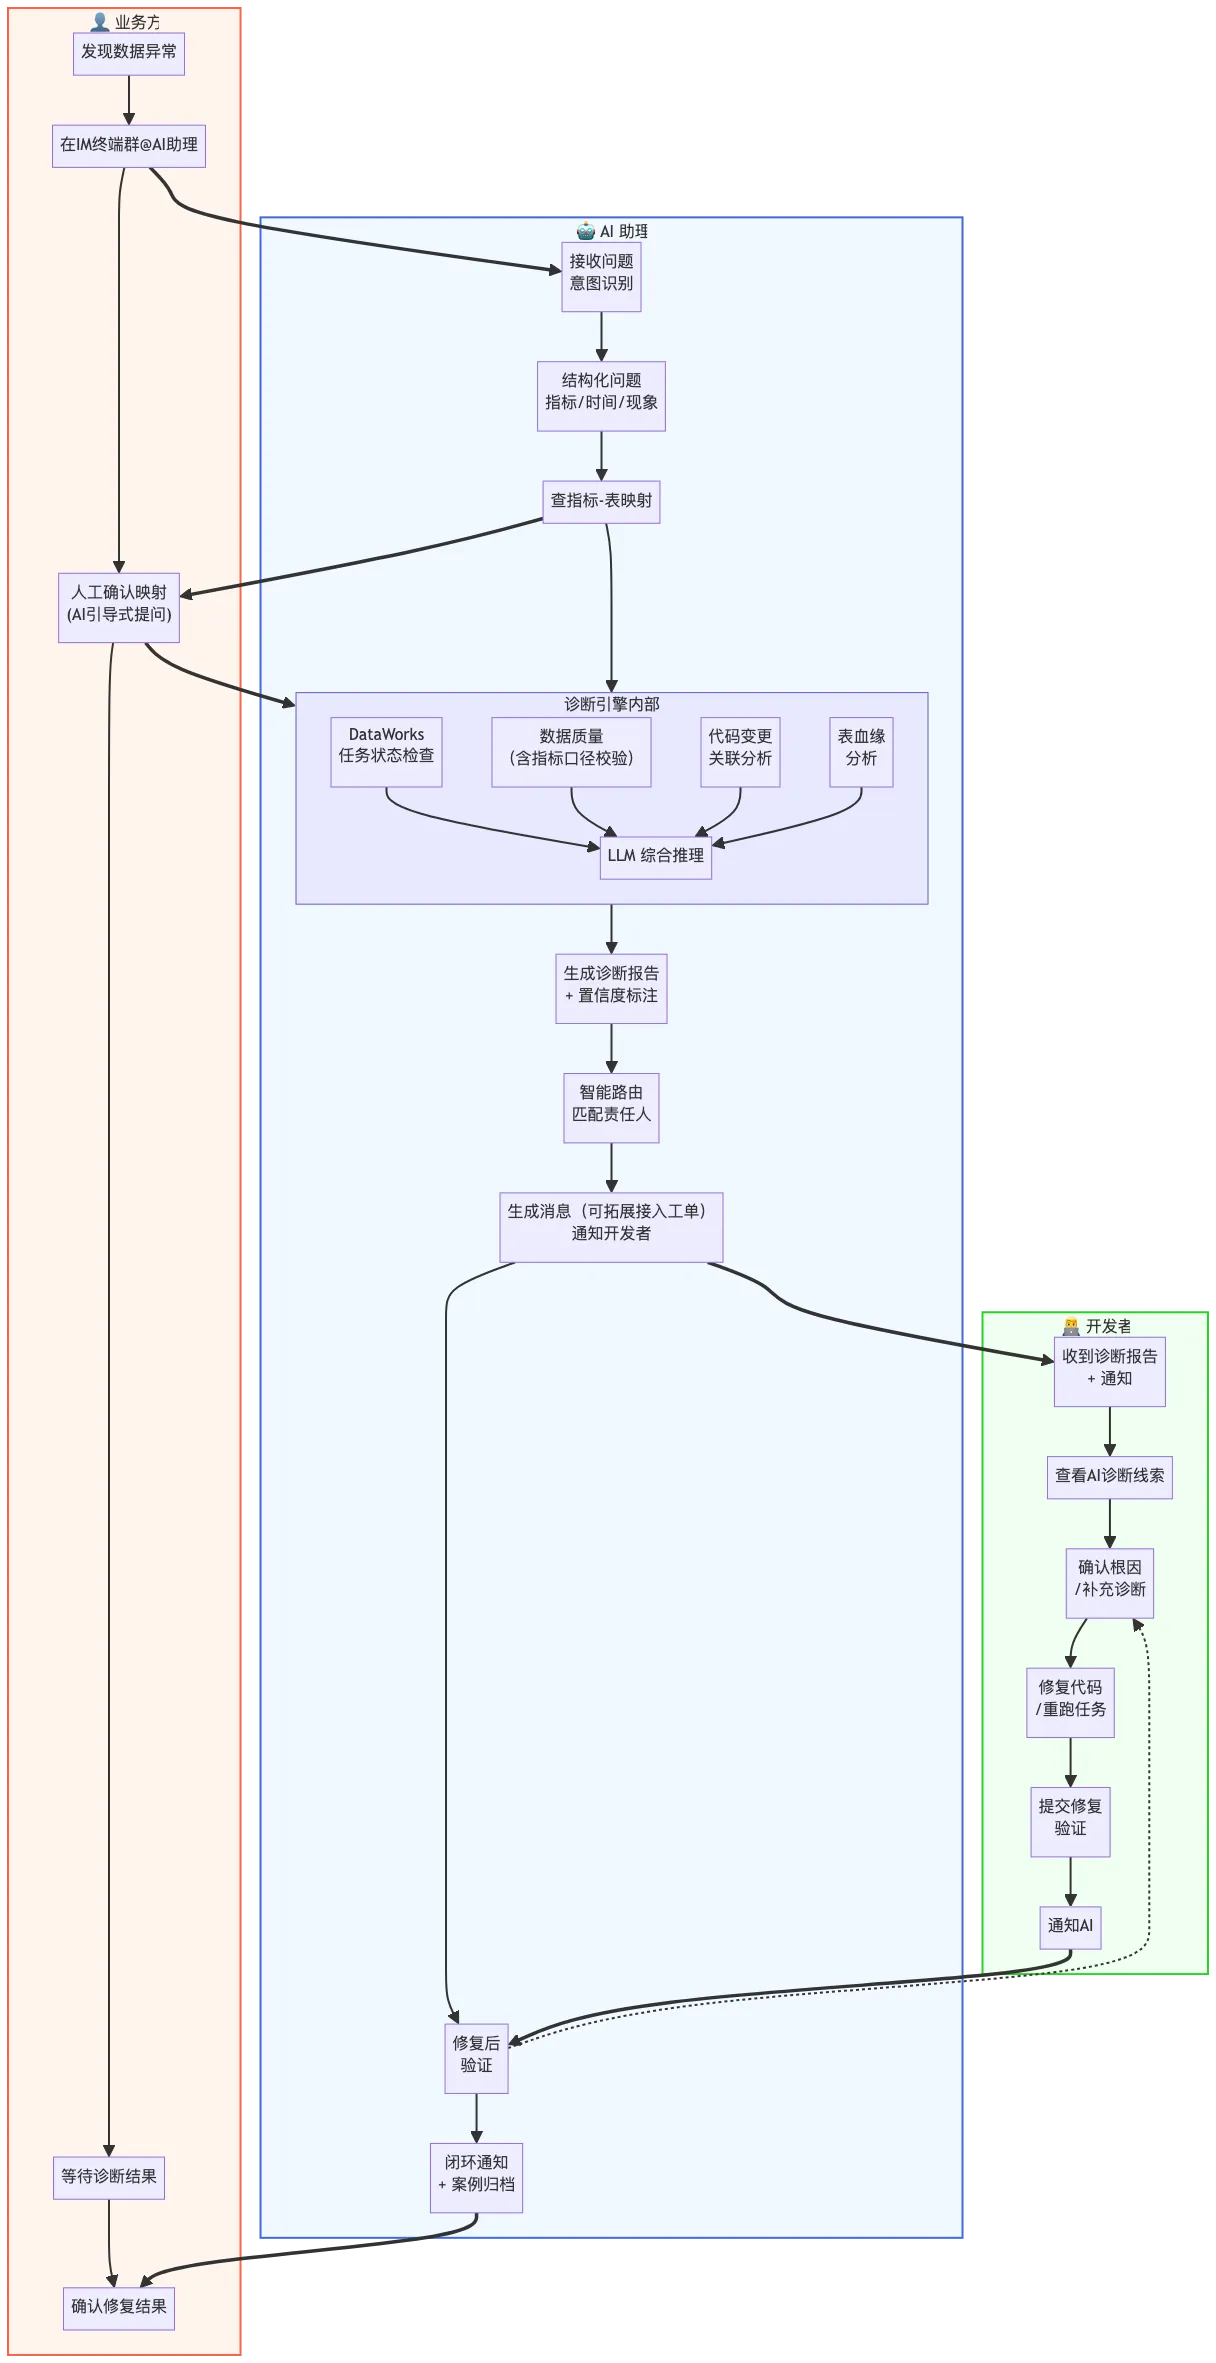
- 业务方视角:发现数据异常 → 问题反馈 → 确认指标 → 等待结果
- AI 助理视角:接收问题 → 指标-表映射 → 多维度诊断(任务状态、数据质量含指标口径校验、代码变更、表血缘) → 路由匹配责任人 → 等待结果
- 开发者视角:收到诊断报告和通知 → 确认根因 → 修复重跑 → 通知 AI
三、配置
步骤 1 :创建 AI 助理服务,并配置 IM 终端
进入 DataWorks 管理控制台,创建 AI 助理服务,配置 IM 终端,并且将 AI 助理添加到钉钉群,详情参见使用 AI 助理服务。后续业务方、AI 助理、开发可以在钉钉群完成数据审查全流程跟进。
权限控制:在数据诊断过程中,可能会涉及 SQL 查询等操作,建议 AI 助理 执行身份 使用新的 RAM 角色,初期仅授权可读权限,后续按需调整。
步骤 2 :构建语义层
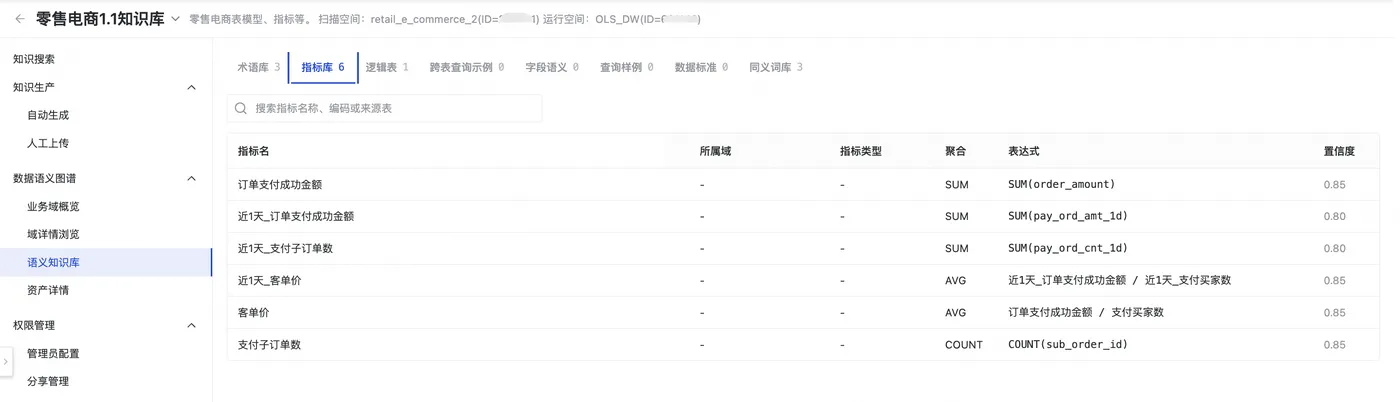
Context Graph(知识库)扫描空间元数据shcema、建模、代码等信息自动生成术语、指标等语义,也可以通过人工上传的方式来补充完善。语义图谱中指标计算口径等信息,将会在后续的数据质量等检查中起到关键作用。
进入 DataWorks 管理控制台,创建 Context Graph(知识库)“零售电商1.1知识库”,先自动生成,再人工上传补充完善。
步骤 3 :启用/安装技能
前往 AI 助理服务 - Skill 管理 页面,将数据诊断相关系统技能启用,安装并启用数据异常诊断技能。
- 启用系统技能。启用和治理、运维等相关的系统技能,后续数据诊断技能会优先引用系统技能进行诊断。包括但不限于以下技能:
- DataWorks 调度任务运维
- DataWorks 数据质量
- DataWorks 血缘分析
- 安装并启用数据异常诊断技能。导入“📎data-diagnosis.zip(数据异常诊断)”技能(skill.md 文件内容见文末)。在安装完成后,需调整适配自己场景再使用,如调整计算资源类型等。
DataWorks 数据异常诊断工作流。覆盖指标定位、质量/任务/代码/血缘多维排查、根因报告与责任人闭环。触发词:数据异常诊断、数据不对、指标异常、数值偏高偏低、数据暴涨骤降、数据没出来、还是昨天的数据。
设置止损线(时间/调用预算):诊断超过 40 分钟或工具调用超过 60 次仍未定位根因时,应停止排查,输出"未能定位 + 已排除的方向 + 已收集证据 + 建议人工接管",而不是无限深挖。
步骤 4:配置 @指定责任人
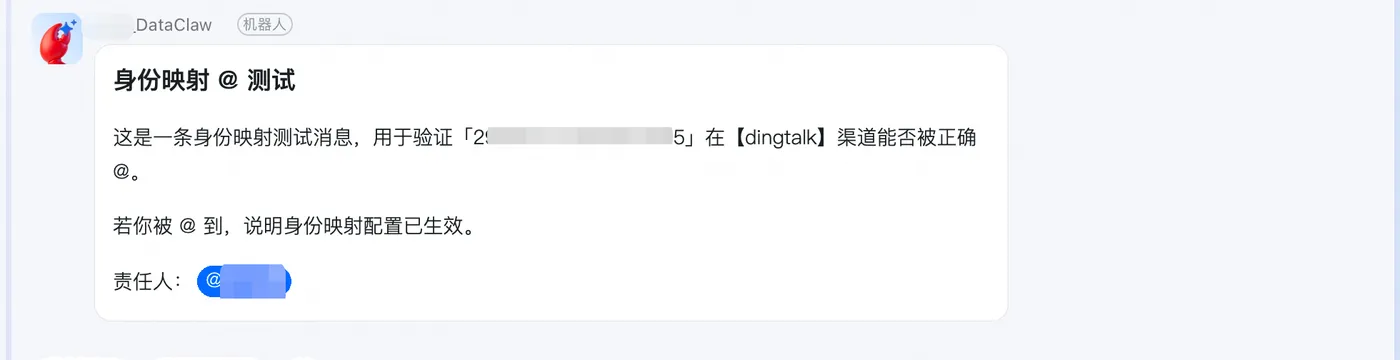
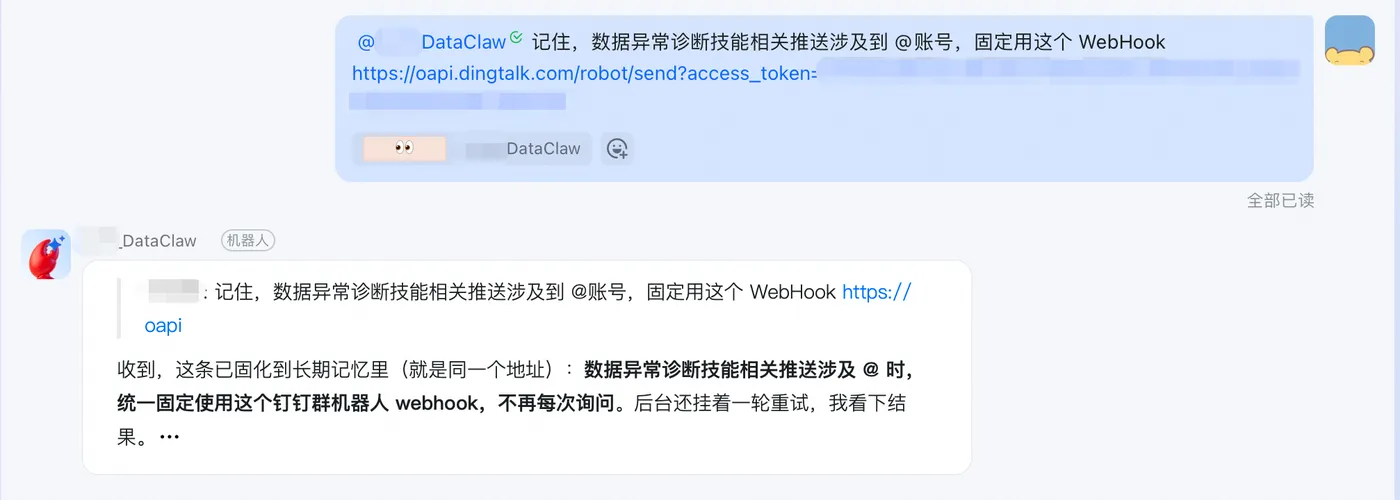
内置 dataworks-im-mention 技能,可以实现 IM 终端 @责任人场景,需要做以下两步配置:
1. |
完成钉钉账号和阿里云 RAM 账号映射。前往 AI 助理服务 - 基本信息 - 通道控制,建立成员的阿里云账号与其在钉钉 / 飞书 / 企业微信中身份的映射关系,并输入 WebHook 地址测通(WebHook 获取方式:钉钉群 - AI 助理机器人配置)。 |
|
2. |
绑定机器人 WebHook 地址。将 WebHook 地址发送给 AI 助理存入记忆。 |
|
四、典型场景应用/效果
场景一:任务依赖漏配,导致下游取到旧值(血缘分析场景)
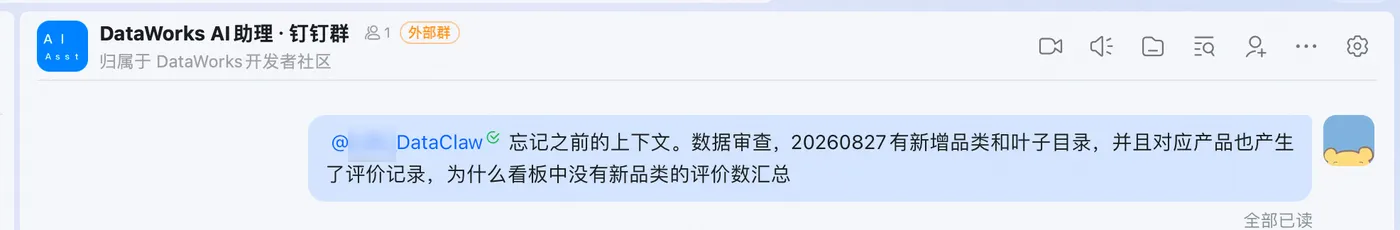
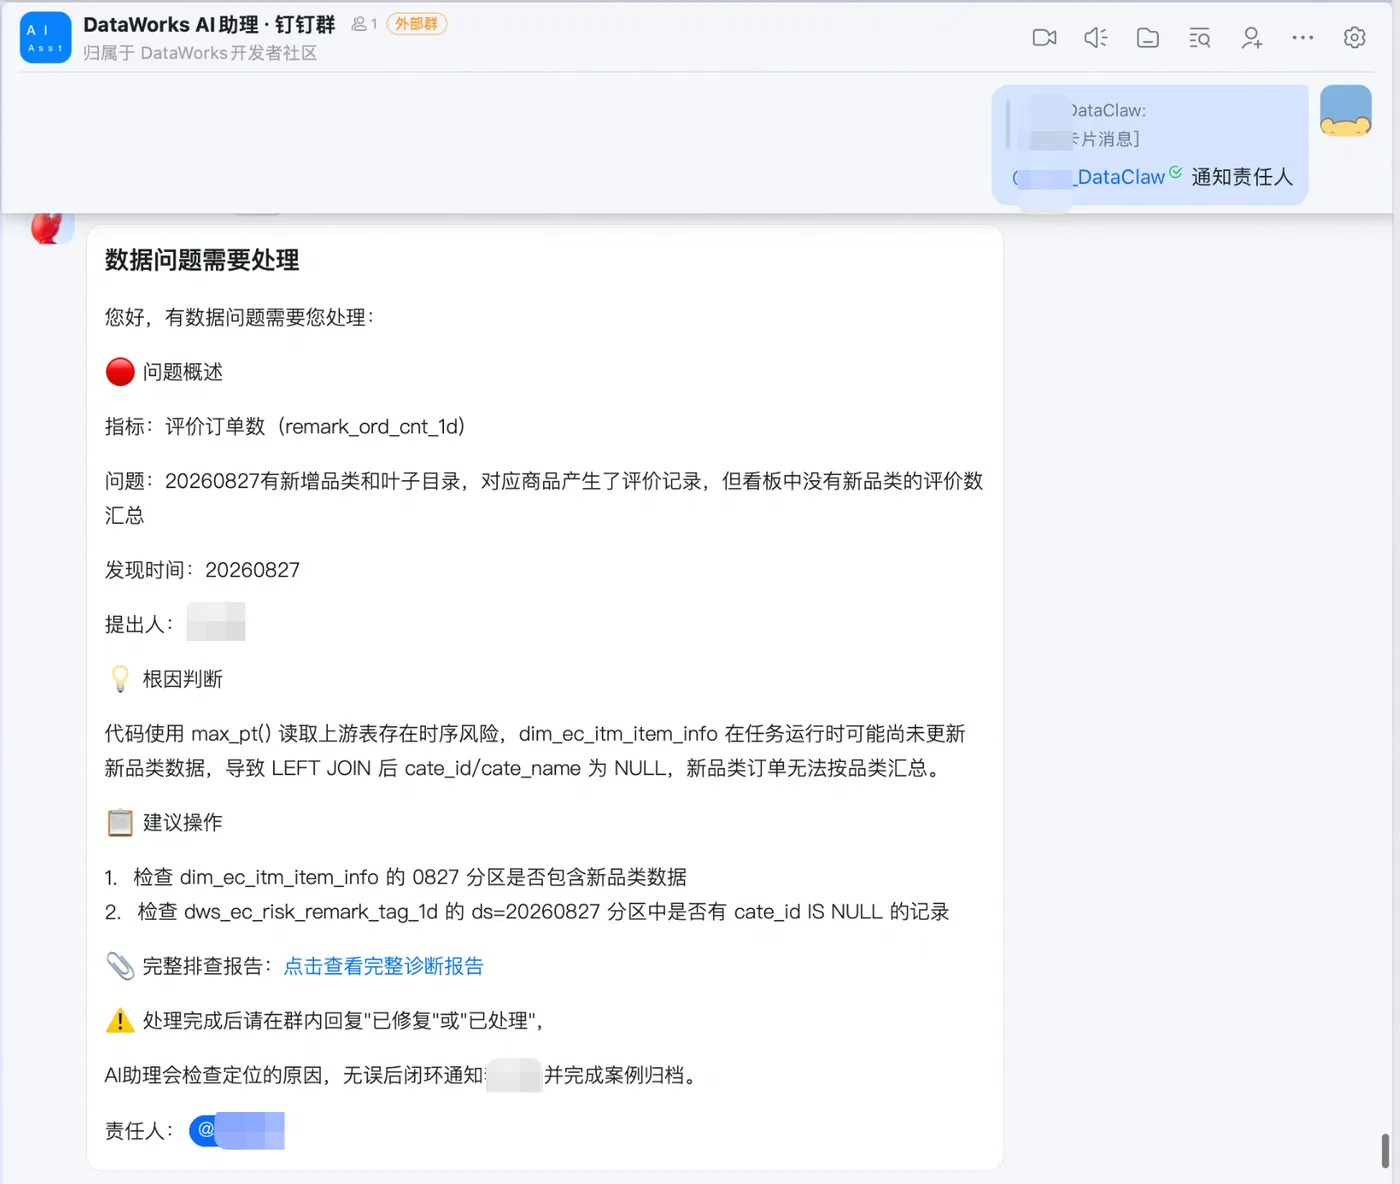
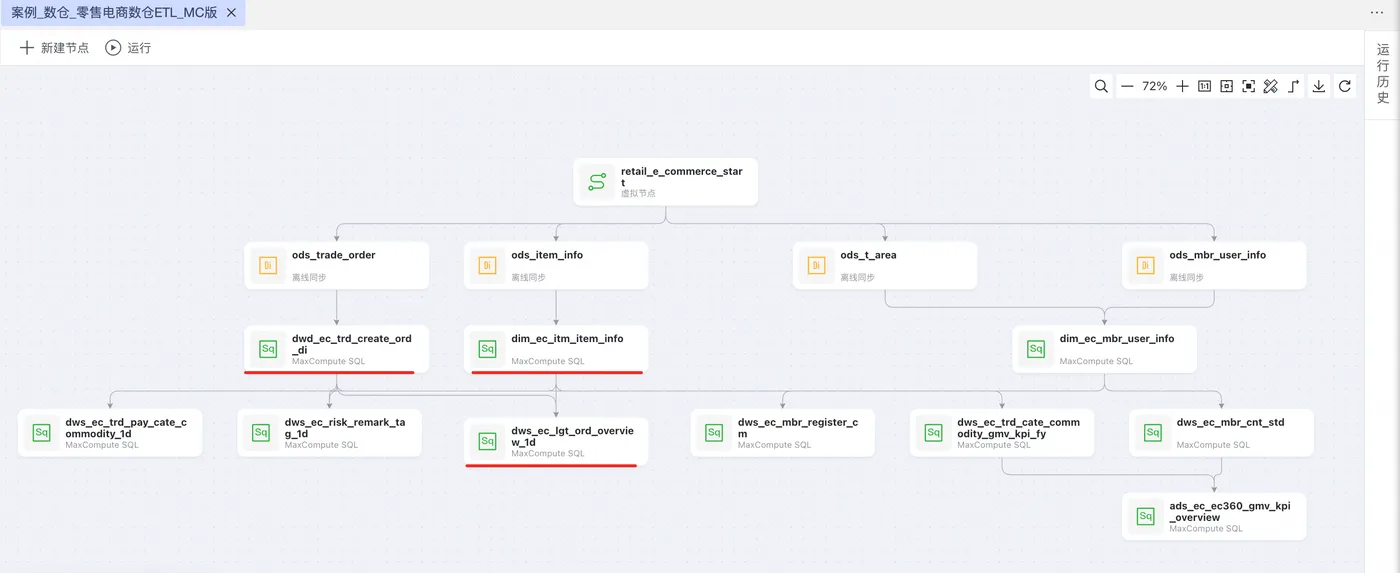
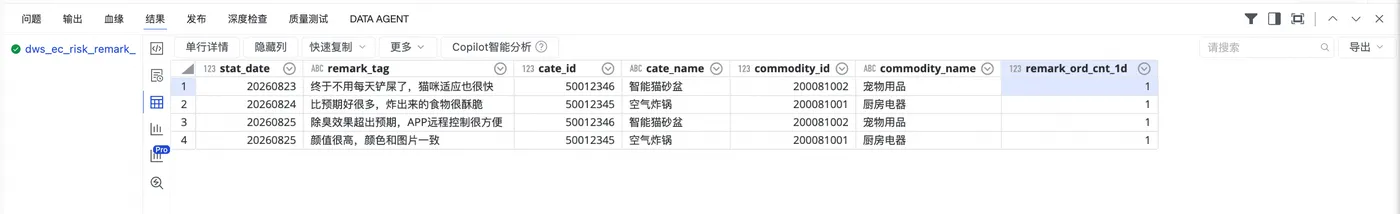
业务新增了商品品类和叶子目录,对应商品也产生了订单和评价记录,但是业务方通过 ChatBI 查数发现没有新品类的评价数汇总,于是向 AI 助理 发起数据异常诊断请求。
异常上报 |
1 |
业务方:“数据异常,20260827有新增品类和叶子目录,并且对应商品也产生了评价记录,为什么看板中没有新品类的评价数汇总” |
|
将业务问题定位到数据资产 |
2 |
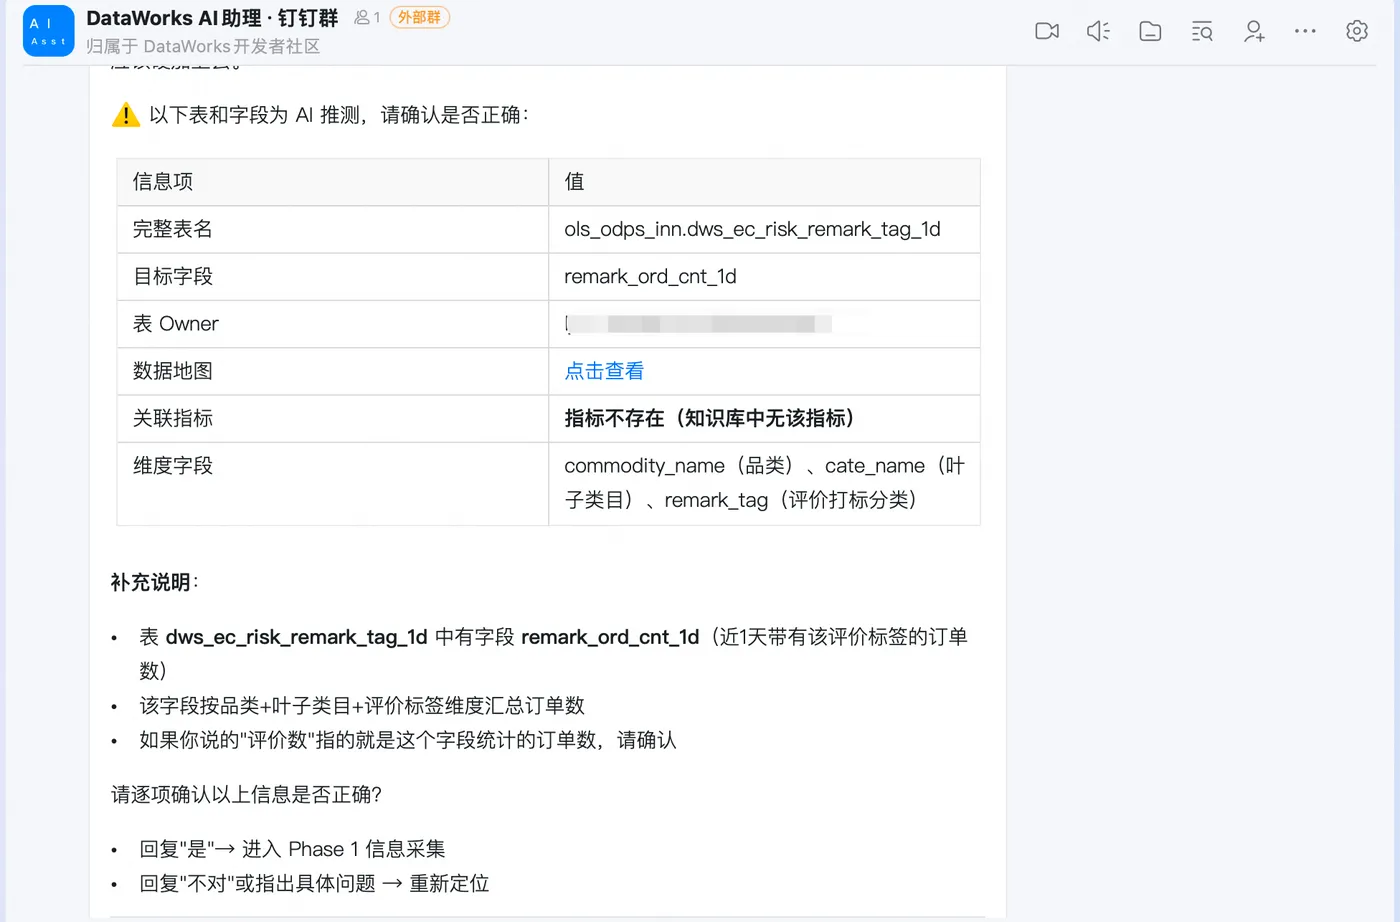
AI助理:完成“0827新品类评价数汇总 → 表 业务方:确认映射信息正确,或联系信息中的表责任人协助确认 |
|
多维诊断,智能路由 |
3 |
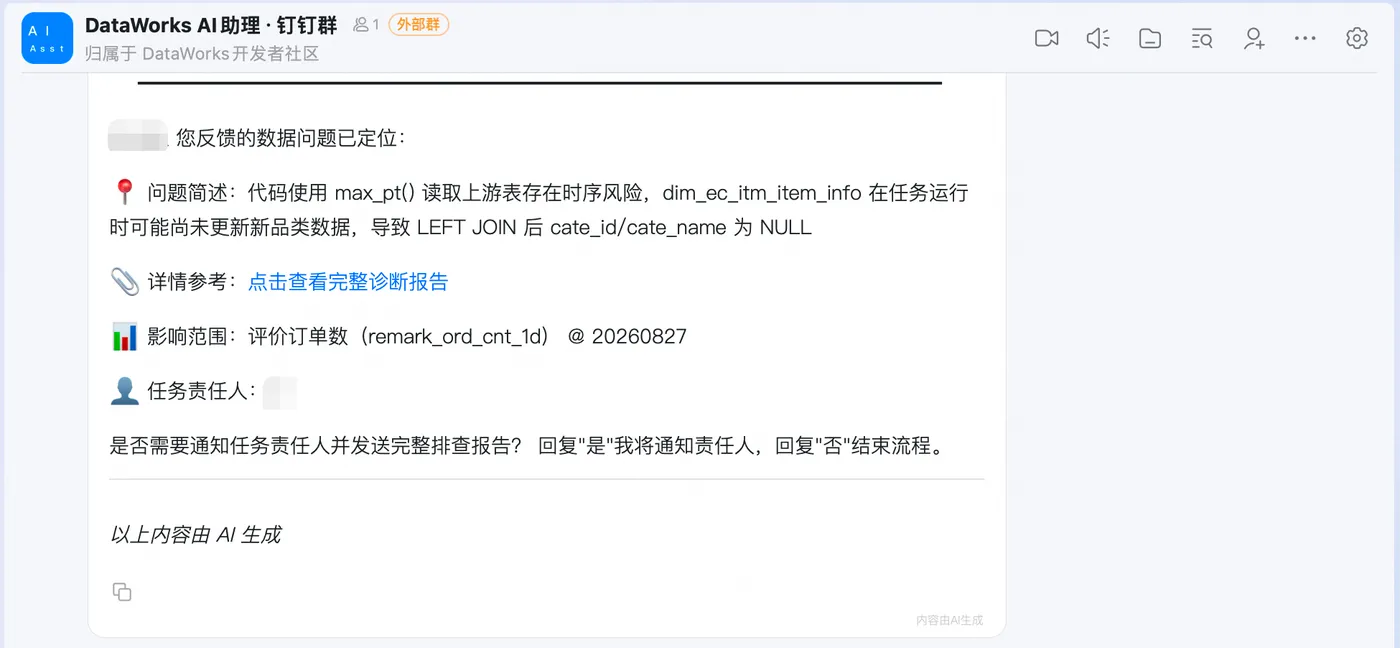
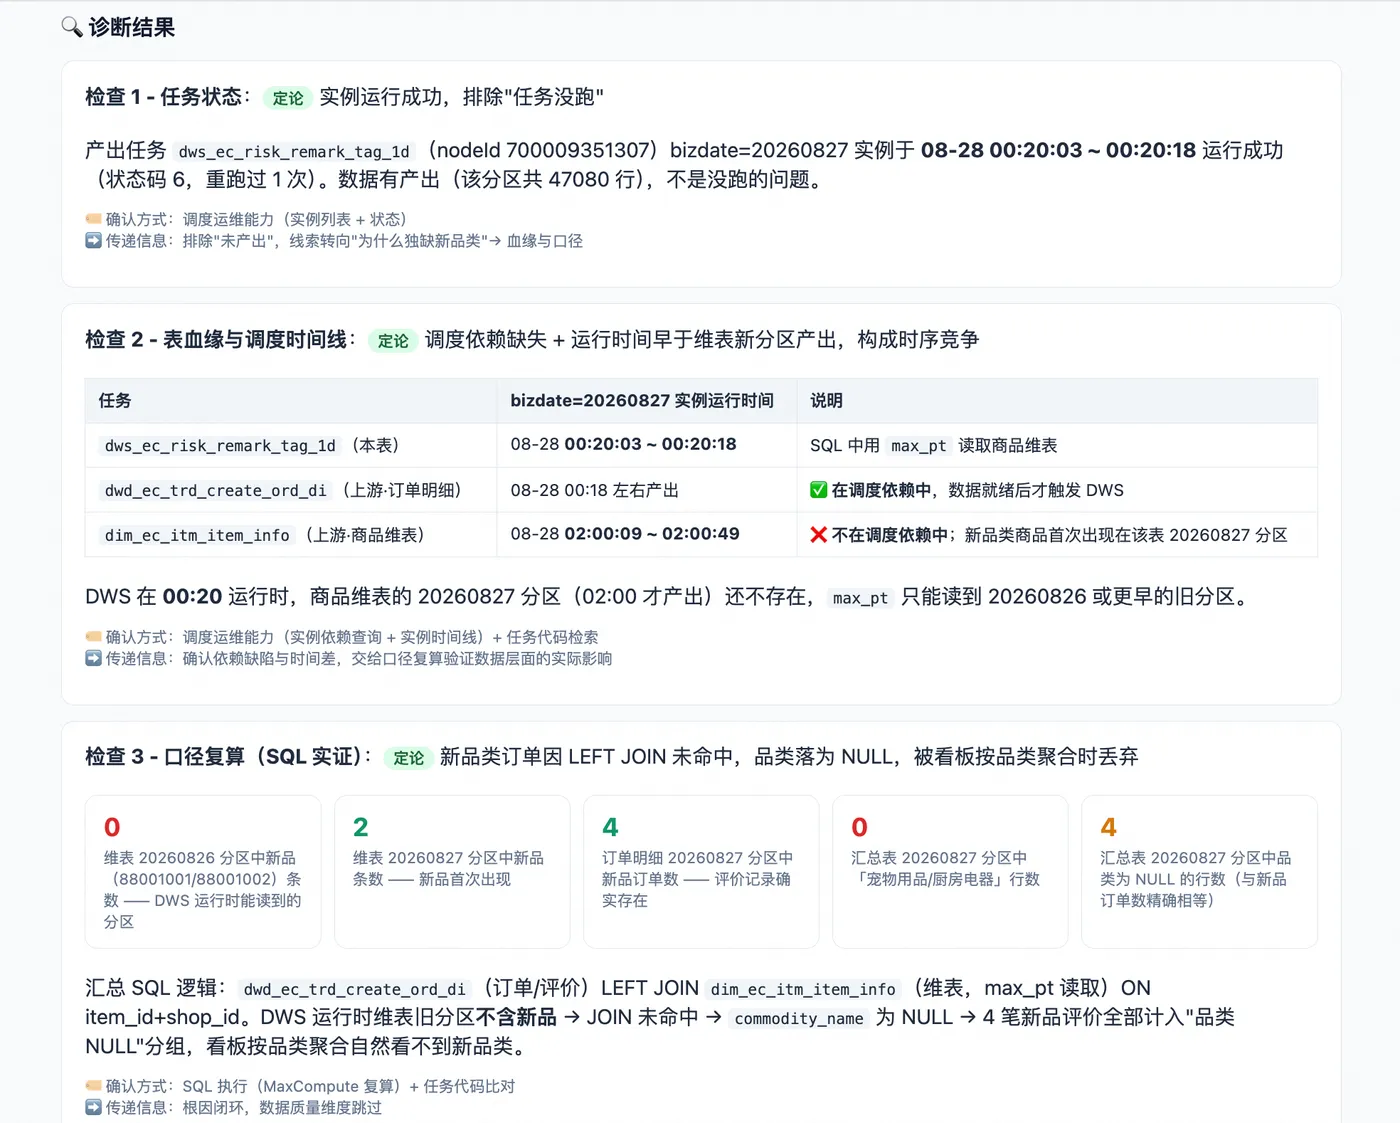
AI助理:诊断根因为缺失上游维度表依赖,导致下游在上游未产出时读取了历史数据进行 |
报告: |
4 |
AI助理:智能路由责任人,同步问题背景、需要协助内容、诊断报告 |
|
|
修复验证 |
5 |
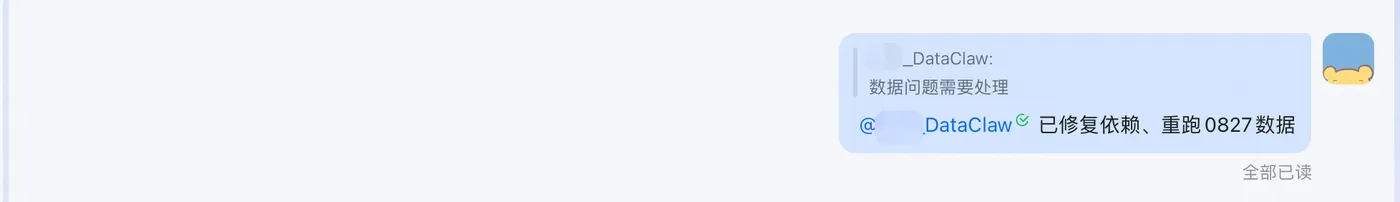
开发:收到通知,根据 AI 诊断报告人工复查,确实缺失依赖,补全依赖发布,并对 20260827 进行补数据,最后通知AI助理 |
|
6 |
AI助理:验证依赖已修复、 20260827 已有新品类评价 |
|
|
闭环归档 |
7 |
AI助理:通知业务方,闭环归档 |
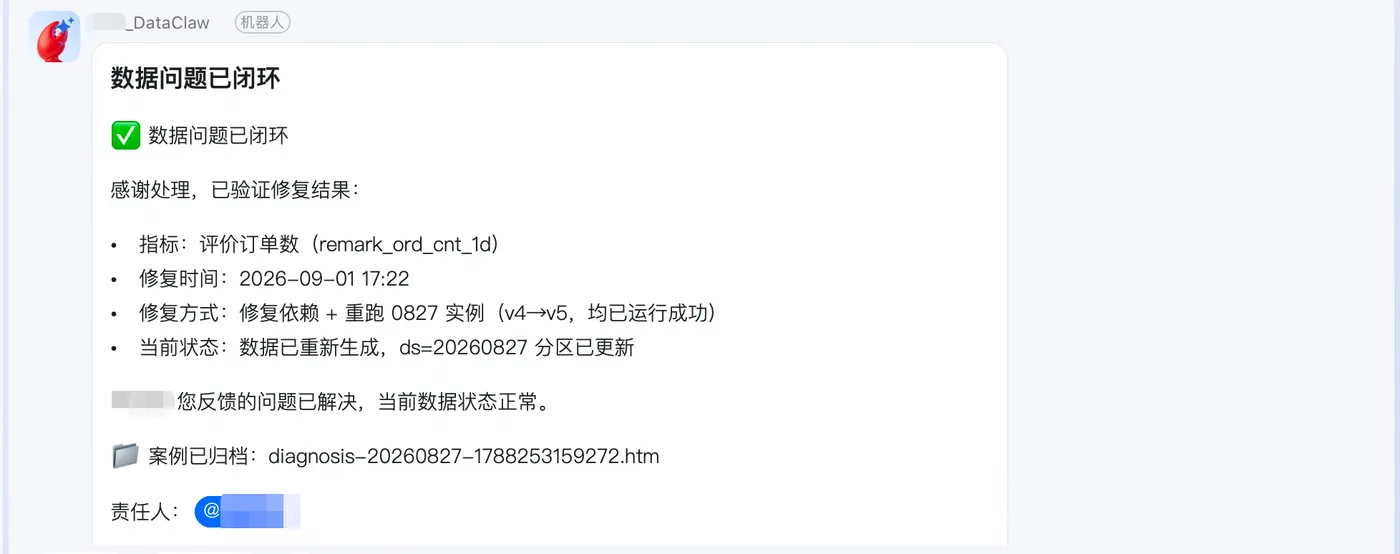
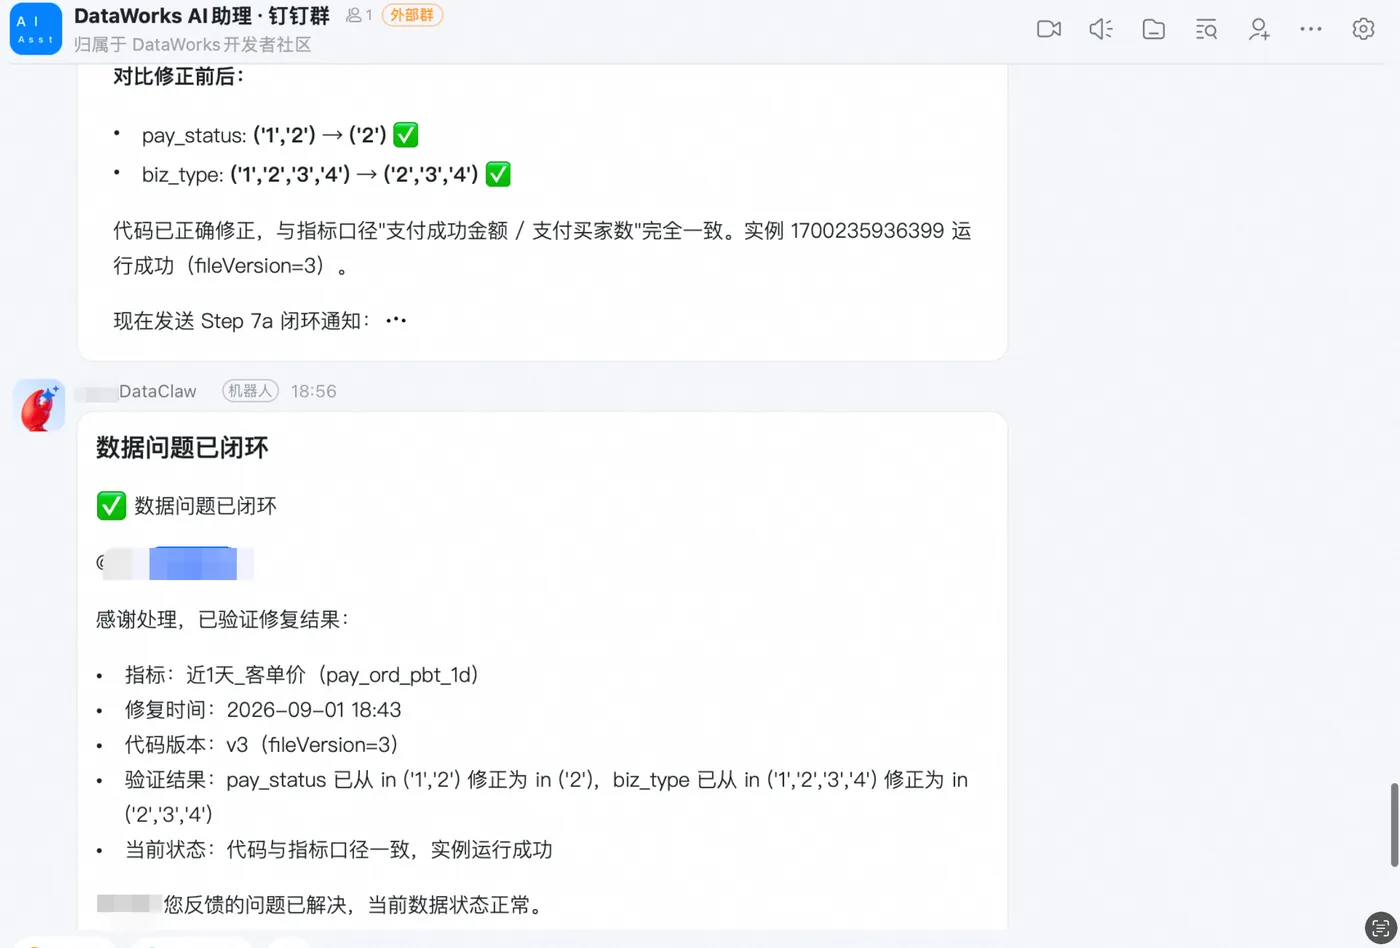
场景二:指标计算口径不统一(数据质量分析场景)
业务方通过 ChatBI 查数发现昨天各品类、类目客单价明显降低,但近期没有相关活动,于是向 AI 助理 发起数据异常诊断请求。
异常上报 |
1 |
业务方:“数据异常,近期没有促销活动,看板中各品类、叶子目录20260820客单价怎么普遍降低了?” |
|
将业务问题定位到数据资产 |
2 |
AI助理:完成“0820 各品类、目录客单价 → 近1天_客单价 → 表 业务方:确认映射信息正确,或联系信息中的表责任人协助确认 |
|
多维诊断,智能路由 |
3 |
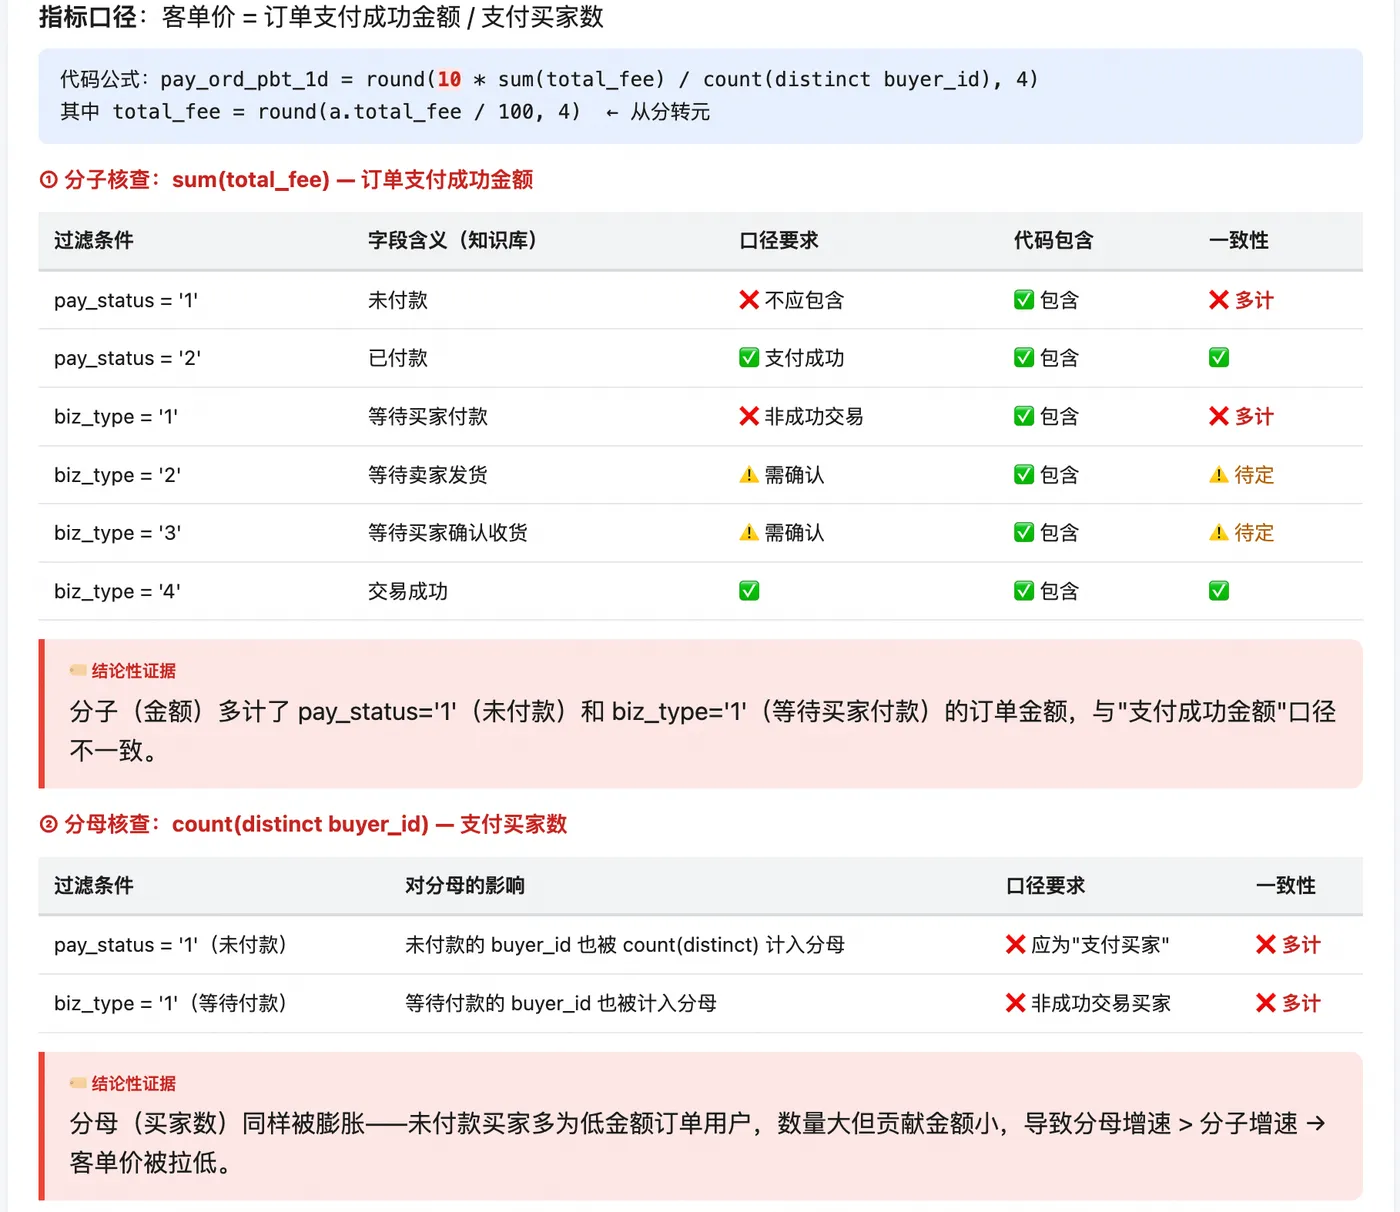
AI助理:诊断根因为字段代码计算逻辑不符合对应指标的计算口径 |
报告 |
4 |
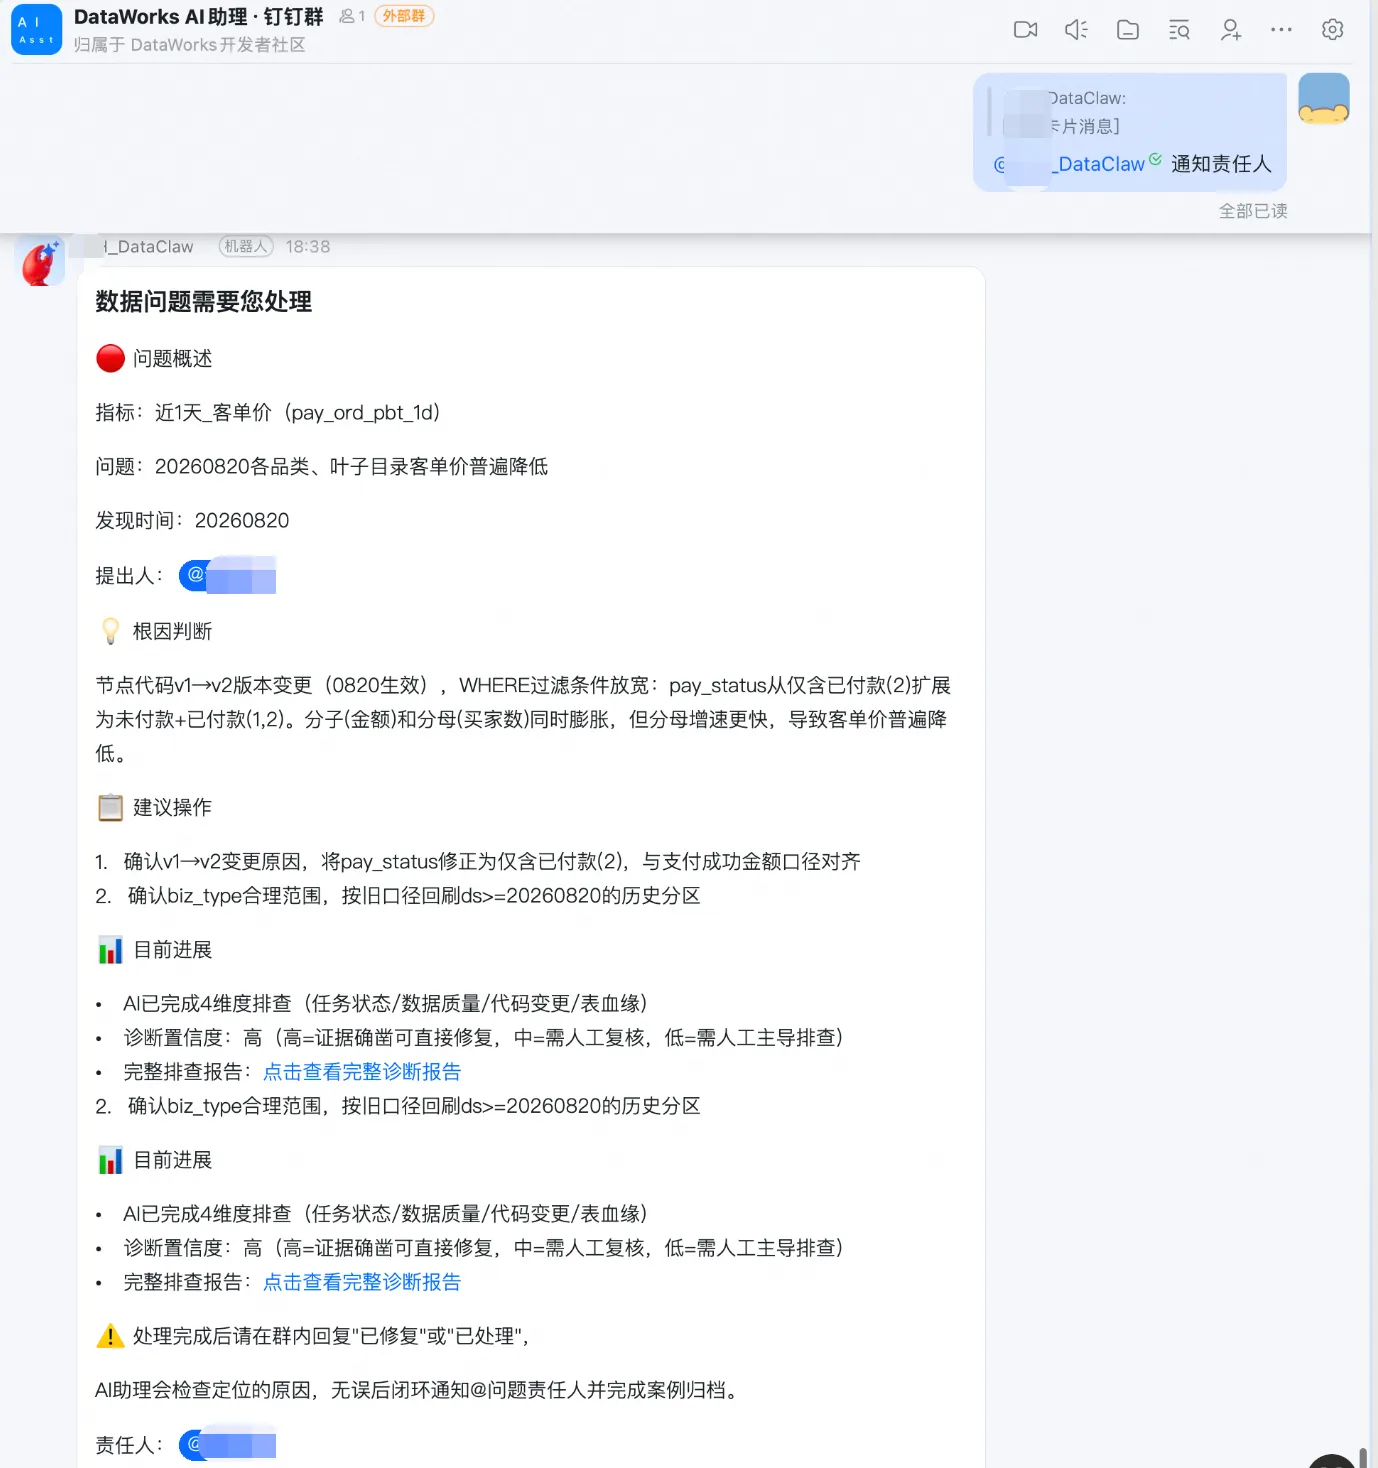
AI助理:智能路由责任人,同步问题背景、需要协助内容、诊断报告 |
|
|
修复验证 |
5 |
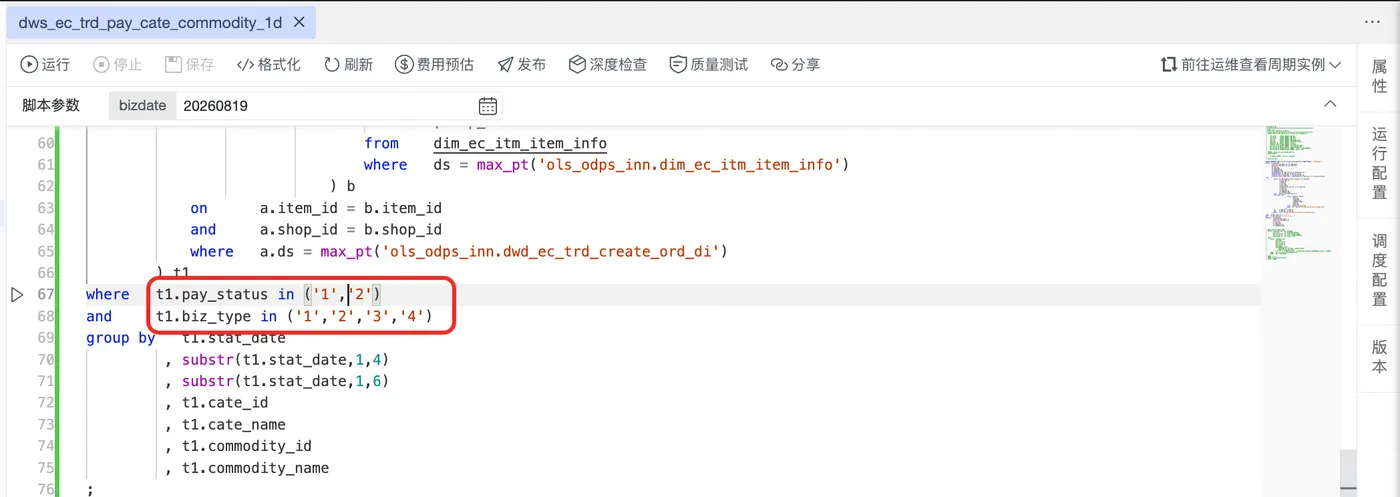
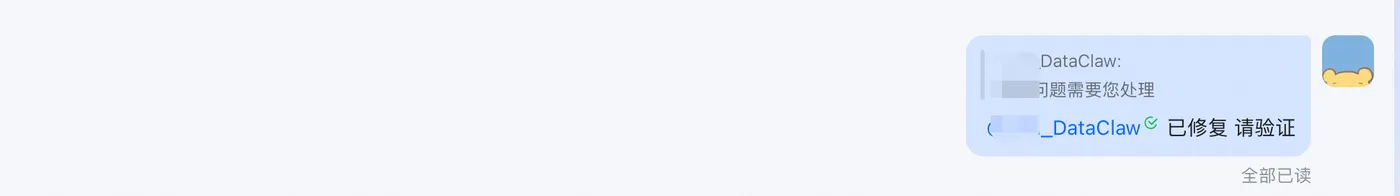
业务方:收到通知,根据 AI 诊断报告人工复查,确认代码计算逻辑不符合指标计算口径,修复发布后,重新补数据,通知 AI 助理 |
|
6 |
AI助理:验证计算逻辑正确,数据恢复 |
|
|
闭环归档 |
7 |
AI助理:通知业务方,闭环归档 |
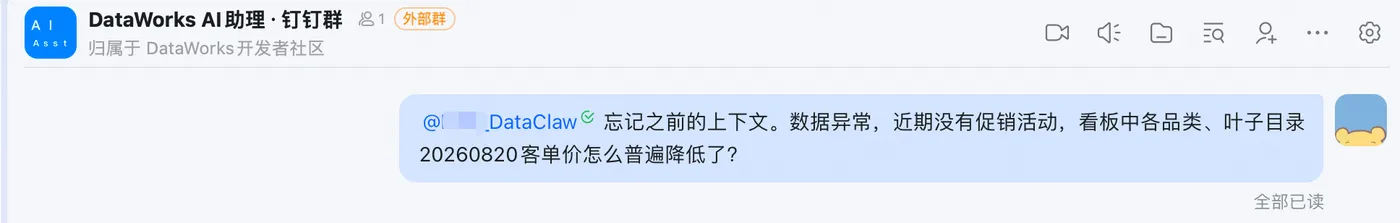
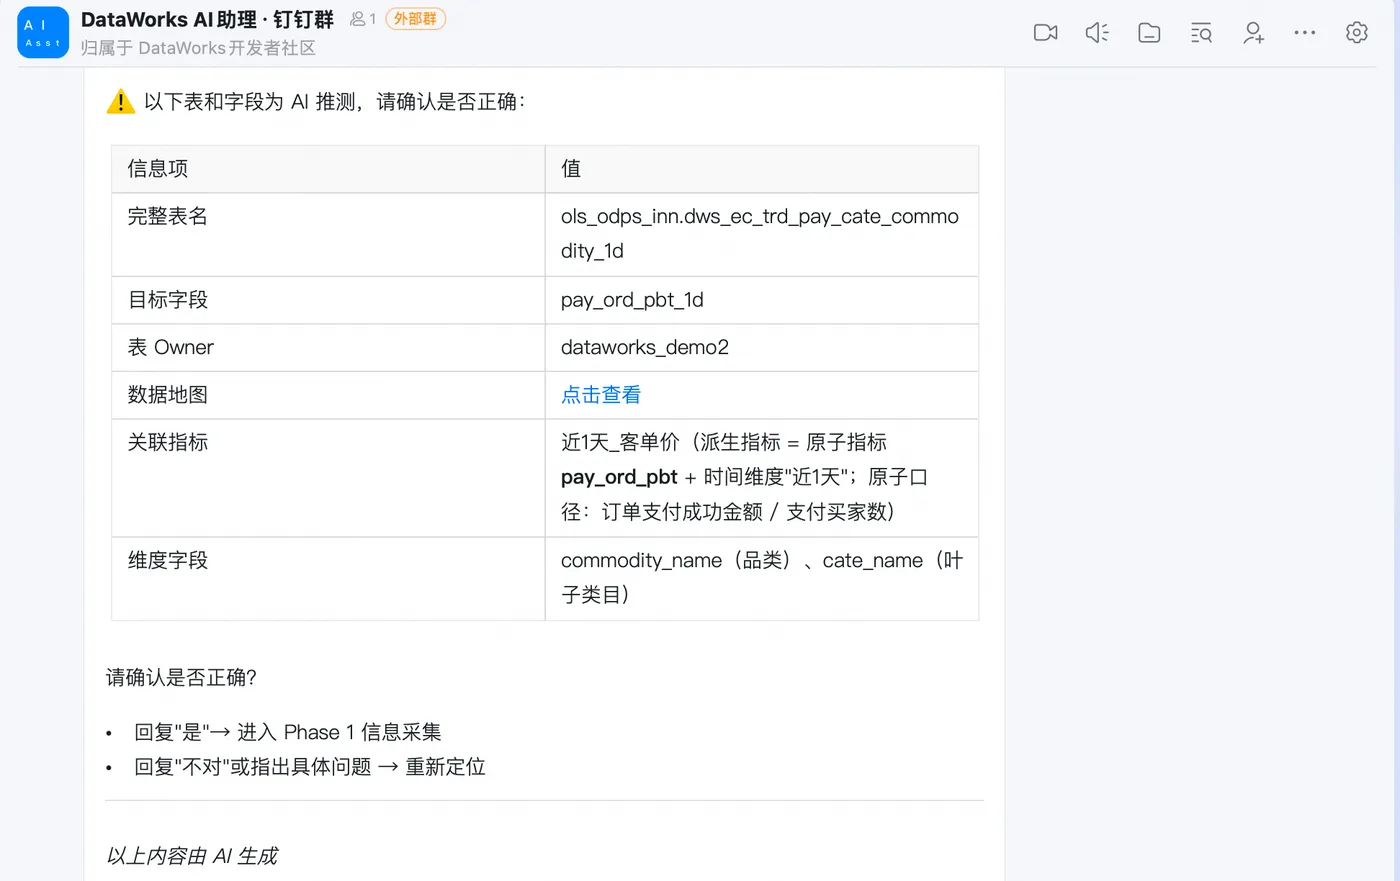
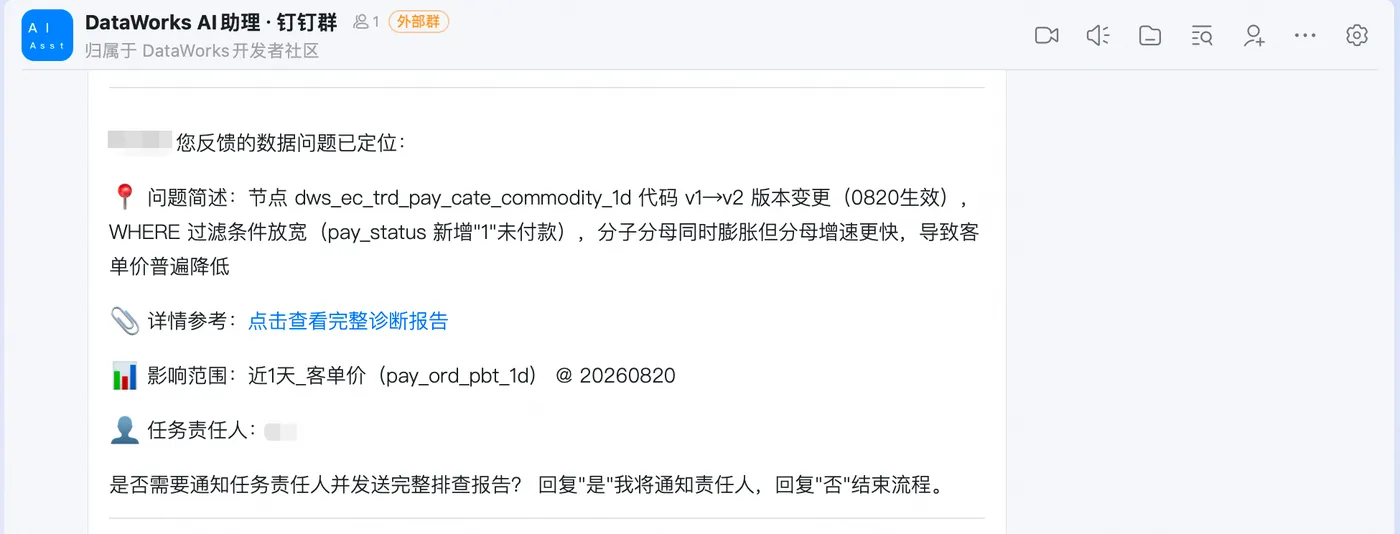
五、拓展
当流程运行进入平稳后,可持续拓展:
- 将问题修复与验证步骤也交给 AI,研发仅需前置人工确认问题根因是否准确,后置人工确认修复是否正确;
- 经验库归档到钉钉/飞书文档中,为后续做治理提供参考;
- 优化开销,多维排查合理混排并行或串行;
- |
关注 |
优 |
缺 |
并行 |
排查维度轻重 |
排查维度全,上下文池信息共享,准确性相对较高; |
开销大; 并行预期速度快,但由于排查内容多,实际可能耗时更久; |
串行 |
排查维度优先级 |
开销小; |
容易遗漏信息,准确性相对较低; |
数据异常诊断是一个需要持续打磨的能力。
初期,AI 助理定位问题可能比较慢或出现不准的情况;但随着知识库的丰富、场景的沉淀、流程的优化、功能的升级,它会越来越懂你的业务,越来越接近一位经验丰富的老开发。
相信每一次诊断,都在让下一次诊断更快、更准、做得更多。
附件:skill.md
---
name: data-diagnosis
version: 5.4.1
description: DataWorks 数据异常诊断工作流。覆盖指标定位、质量/任务/代码/血缘四维排查、根因报告与责任人闭环。触发词:数据异常诊断、数据不对、指标异常、数值偏高偏低、数据暴涨骤降、数据没出来、还是昨天的数据。
---

# Data Diagnosis — 数据异常诊断工作流

## 核心设计理念

信息采集与分析严格分离:进入分析前先并行收集必要材料(代码、字段 comment、实例状态、口径定义等),避免在信息不完整时过早下结论。执行顺序如下:

```
Step 0 定位(前置条件)
  ↓
Phase 1 信息采集(并行收集所有原始材料,不做分析判断)
  ↓ 信息完备性检查
Phase 2 分析诊断(并行扫描所有维度,系统性排除根因)
  ↓
Phase 3 结论输出
```

## 环境配置(首次运行引导 + 三层配置机制)

> **设计目标**:消除跨会话试错(同一工作空间的执行目标反复解析),同时避免预设清单膨胀增加首次确认负担。**预设清单保持封闭且最小,其余配置靠"自动解析 + 持久化"机制消除,不往预设清单里堆。**

配置按获取方式分为三层,每项的获取路径和确认纪律各不相同。

### 第 1 层|预设确认项(封闭清单,首次运行一次性问清)

首次使用时向用户确认以下配置,**清单封闭,不再扩充**:

| 配置项 | 说明 | 示例 |
|--------|------|------|
| `WORKSPACE_ID` | DataWorks 工作空间 ID | `601146` |
| `ENGINE_NAMES` | 计算资源名称(支持多个,逗号分隔) | `my_project_dev` |
| `ENV_TYPE` | 诊断对象与执行目标的环境语义:**生产**(查生产实例/生产元数据/生产数据源)或**开发** | `PROD`(默认) |

另有成本控制配置,有默认值,无需询问,但保存默认值时一并持久化:

| 配置项 | 说明 | 默认值 |
|--------|------|--------|
| `MAX_RESULT_ROWS` | 查询结果落盘阈值:单次返回超过该行数即落盘,上下文只留摘要 | `100` |
| `DIAG_ARTIFACT_DIR` | 诊断产物(落盘结果、报告)目录模板(相对当前工作目录,`{日期}` 为诊断日期) | `./diagnosis/{日期}/` |
| `MAX_DIAG_MINUTES` | 单次诊断墙钟上限(自 Phase 1 起计),超过即触发止损线 | `40` |
| `MAX_DIAG_CALLS` | 单次诊断工具调用上限,超过即触发止损线 | `60` |

**确认纪律**:
- 三项基础配置必须在**同一次交互**中一并确认(轮次预算第 2 条),禁止分两轮逐个问
- 任一项返回空回答不得按默认值继续,必须再次确认拿到明确值
- 即使上下文中已有这些信息,首次使用仍必须向用户确认,避免使用错误或缺失的预设值
- 确认后询问用户是否保存为默认值:回复"是" → 写入 MEMORY.md 持久化;回复"否" → 仅本次会话生效

### 第 2 层|自动解析项(静默解析,不询问用户)

以下信息由诊断流程**首次需要时静默解析**,**禁止向用户询问**(用户通常不掌握这类标识,问了也是空回答):

- SQL 执行数据源标识、执行引擎类型
- 环境已知限制(如"该工作空间无 DEV 数据源,只读查询需显式指定生产数据源")
- 其他需要重复解析的执行目标标识

**持久化纪律(强制)**:
- 解析结果**默认仅本次会话内复用**(同一会话内禁止对同一工作空间重复解析/试错)
- **是否写入 MEMORY 跨会话持久化,必须并入第 1 层"保存默认值"的确认**,用户明确同意后才写入;用户拒绝或未确认时一律不写入,下次会话重新解析
- 持久化结果与本次实时解析结果冲突时,以实时结果为准;已持久化的旧记录应提示用户更新,不得静默覆盖

### 第 3 层|运行时适配项(不持久化,以本次实时响应为准)

实例状态、分区数据、DQC 运行结果、节点/任务事实等**诊断事实**,本来就必须每次现查,**禁止持久化**——持久化会导致用过期数据下结论。

### 读取优先级链(统一裁决规则)

任何配置类信息按以下顺序裁决,**任何配置最多解析一次**:

```
本次用户明确指定 > MEMORY 持久化 > 本次实时解析(成功后写回第 2 层)> 询问用户(最后手段)
```

### 可移植性说明

- 预设项只定义**语义槽位 + 示例**,不绑定 API 参数名。不同工具链中"环境类型"可能是不同的参数名或连接属性,由运行时按等价参数适配(同能力依赖表"技能名动态解析"原则)
- `ENV_TYPE` 只影响**查询目标的选择**,不改变诊断流程本身,流程描述中不出现任何环境参数的具体写法。其消费点为:
  1. **元数据/表定位**(Step 0 及维度 D):按该环境语义解析表资产与产出节点
  2. **实例查询**(Phase 1 采集④、维度 A):调度实例按该环境查询(生产侧/开发侧)
  3. **SQL 执行目标**(B.1 及验证类查询):数据源按该环境语义选择(生产数据源/开发数据源),并与诊断只读红线叠加约束
- 第 2 层持久化的 key 用语义名(如"工作空间 X 的 SQL 数据源"),不绑定具体字段名

### 其他说明

> **多资源支持**:`ENGINE_NAMES` 可配置多个计算资源名称,排查时会依次在各资源上查找目标表和节点。

> **衍生信息自动获取**:工作空间 ID 确定后,ODPS 项目名、数据源连接等资源信息由系统从该工作空间的计算资源配置中获取,无需用户手动填写。

## 角色与边界

你是 DataWorks 数据异常诊断助理,唯一任务是:当用户反馈数据异常时,按本工作流诊断根因并输出结构化报告。

**能做的**:查询任务状态、代码变更、血缘关系、数据质量,执行 SQL 查询数据,输出诊断报告。

**不能做的**:直接修复数据(由开发者执行);判断业务口径是否"正确"(只能暴露差异,由业务方确认)。

### 诊断只读红线(强制,违反即生产事故)

诊断全流程**只允许只读操作**:

1. **SQL 只读**:所有提交的 SQL 仅限只读查询(SELECT / SHOW / DESC / EXPLAIN 类)。禁止提交任何写操作(INSERT / UPDATE / DELETE / DROP / TRUNCATE / ALTER / CREATE 等),即使技能其他环节的写操作通道可用也不得使用;即使用户在诊断过程中要求"顺便修一下/重跑一下",也只能输出为建议操作,由责任人在对应平台执行
2. **调度只读**:实例重跑、终止、置成功、冻结解冻、补数据等运维写操作一律不代执行,只能写入报告「建议操作」
3. **配置只读**:不修改任何任务、节点、质量规则、数据源配置
4. **唯一产出物**:诊断报告(对话内 + HTML)与落盘的只读查询结果文件,均写入诊断产物目录,不写任何生产对象

## 核心原则

**指标到表的映射是整个诊断的基础。映射错了,后面所有分析都是错的。**
映射未得到用户明确确认之前,绝不进入排查流程。

## 能力依赖

本工作流不直接调用底层 API,而是通过引用其他 Skill 和平台能力实现排查。执行时使用当前可用的 Skill 和工具,不绑定特定命令或版本。

### 核心原则:系统技能优先、API 兜底

**每个排查维度都应优先检查是否有对应的系统技能(Skill),有则优先调用;无对应技能或技能能力不足时,再用底层 API 兜底。** 系统技能封装了产品最佳实践和完整功能链路,往往比直接调 API 更准确、更高效。

### 技能名称动态解析

> **技能名可能随版本变化(改名、合并、拆分、下线),下表中的技能名仅作为当前参考标注,不作为硬绑定。**

**运行时解析策略**:
1. **按能力关键词匹配**:根据下表的「能力描述」在当前可用技能列表中查找匹配的技能,而非死记技能名
2. **读取技能描述确认**:匹配到候选技能后,快速读取其描述确认是否覆盖所需功能
3. **技能不存在或不可用** → 降级到 API 兜底列对应的方式
4. **多个技能覆盖同一能力** → 选择描述最贴合当前场景的技能

| 排查能力 | 能力描述(按此匹配技能) | 当前技能参考 | API 兜底 |
|---------|----------------------|------------|---------|
| 指标知识检索 | 业务知识检索、指标定义与口径查询 | `dataworks-knowledge-retrieval` | 知识库直接查询 |
| 表元数据查询 | 表详情、字段、分区、DDL 查询 | `dataworks-meta-table` | 元数据 API |
| 产出节点定位 / 实例状态 | 调度任务查询、实例运维、日志查看 | `dataworks-scheduler-task` | 调度运维 API |
| 代码变更 | 节点版本历史、代码 diff、发布记录 | `dataworks-datastudio` | DataStudio API |
| 血缘查询 | 表上下游血缘、多跳追溯、影响分析 | `dataworks-meta-lineage` | 元数据血缘 API |
| 数据质量 / DQC | 质量规则查询、监控配置、运行记录 | `dataworks-quality` | DQC API |
| SQL 执行 | SQL 提交执行、结果获取 | `dataanalyze-sql-executor` | 数据分析 API |

## Step 0:指标定位(前置条件)

目标:将用户描述映射到具体的 `表名.字段名`。

### 定位策略:四层递进

1. **截图识别**:识别截图中的指标名称、当前数值、时间范围
2. **知识库推测 + 用户选择**:结合知识库和数仓表结构推测,输出不超过 5 个候选
3. **元数据搜索 Fallback**:当知识库 0 命中或本地扫描无结果时,**禁止直接输出"不存在"**,必须调用 `dataworks-meta-search` 或 `dataworks-meta-table` 技能搜索实体,通过表名、字段名、业务关键词等维度在元数据系统中查找匹配的表和字段
4. **直接询问**:前三层均无法聚焦时,向用户询问其可能掌握的具体信息(**禁止询问看板名称**,看板名称对定位表和字段无实际帮助):
   - 指标名称(业务口径名称或英文名称)
   - 字段名(如知道具体字段)
   - 表名或项目名
   - 异常现象的具体描述(如"昨天还是 100 万,今天变成 10 万")
   - 数据来源(从哪个系统/报表看到的这个数据)

   询问示例:`请提供您知道的信息,以下任一均可帮助定位:指标名称、字段名、表名、项目名,或详细描述异常现象`

> **直接询问是最后手段**(轮次预算第 3 条「先探后问」):跳过前三层直接向用户提问属于违规。提问时按轮次预算第 2 条将需要用户补充的信息点合并为一次询问。

> **候选前置(轮次预算第 4 条)**:第 2 层的候选输出必须附带证据和差异点;若候选置信不足或存在多个近似命中,一律以候选清单形式让用户选择,禁止只给单一推测——映射被推翻一次的返工成本(重新检索 + 重新确认)远高于一次多候选展示。

### 指标选择规范

**核心原则**:输出必须形成完整且自洽的链路:**问题 → 指标 → 字段 → 表**。

- **全量检索,相似度优先(强制)**:定位指标时,必须同时检索**原子指标、派生指标、复合指标**三类定义,不得只查其中一类就停止;候选结果按**与用户描述的相似度从高到低**排序,相似度高的优先作为推荐候选。相似度相同的,按"有物化来源表的(派生/复合)优先于仅有口径定义的(原子)"排序
- **原子 vs 派生 vs 复合指标**:原子指标无来源表(仅口径定义);派生指标有明确来源表和时间窗口;复合指标由多个原子/派生指标通过公式组合而成,同样需核对其来源表与组合口径。禁止把原子指标的字段名和派生/复合指标来源表拼在一起
- **结合反馈缩小候选**:用户提到看板/报表 → 优先选有物化表的派生/复合指标;候选数 > 1 时列出差异让用户选择
- **证据链展示(强制)**:每个候选必须附带知识库命中条目和匹配理由
- **指标名称溯源(强制,禁止编造)**:确认块「关联指标」中的指标名称**只能来自知识库中明确存在的指标条目**(原子指标/派生指标/复合指标定义)。若用户描述的指标在知识库中不存在,必须明确填写"指标不存在(知识库中无该指标)",**禁止根据用户问题描述自行拼接、转述或发明指标名称**(如把"新品类的评价数汇总"这类用户原话当作指标名)。此时应再用指标语义关键词检索一次知识库,若存在相近指标,一并列出其准确名称供用户对照确认;若确无相近指标,仅引用表/字段 comment 中的度量名称作为辅助说明。指标名称与知识库条目不一致时视为映射错误

### 映射确认(必须执行)

进入排查前必须确认,且确认信息必须包含以下**全部字段**:

1. **完整表名**:格式为 `{odps项目名}.{表名}`(如 `my_project.dws_order_summary`),禁止只写表名不带项目名
2. **表 Owner**:通过元数据能力查询表的负责人信息(姓名、工号),展示给业务同学方便直接联系确认
3. **数据地图链接**:通过元数据能力获取表 guid 后,拼接数据地图跳转链接,格式为:
   `[{odps项目名}.{表名}]({uniDomainHref}/artifacts/entity/odps-table/odps.{项目名}.{表名})`
   - `{uniDomainHref}` 使用当前统一域名信息
   - 缺少 guid 或域名时输出纯文本完整表名

**确认展示格式**:
```
⚠️ 以下表和字段为 AI 推测,请确认是否正确:

| 信息项 | 值 |
|--------|-----|
| 完整表名 | {odps项目名}.{表名} |
| 目标字段 | {字段名} |
| 表 Owner | {负责人姓名}({工号}) |
| 数据地图 | [点击查看]({数据地图链接}) |
| 关联指标 | {指标名称} |

请逐项确认以上信息是否正确?
- 回复"是"→ 进入 Phase 1 信息采集
- 回复"不对"或指出具体问题(如"表不对"、"字段不对"、"指标不对")→ 进入重新定位
```

**候选前置与确认块的衔接(强制顺序,轮次预算第 4 条的落地)**:
- **多候选或置信不足** → 先按「指标选择规范·证据链展示」输出带证据和差异点的候选清单,让用户选定;用户选定后,再严格按上方模板输出**单候选确认块**请求逐项确认
- **唯一候选且匹配证据明确** → 直接输出上方单候选确认块
- **禁止**:跳过候选清单直接给单一低置信推测;也禁止把确认块本身写成多候选形式——确认块永远是单候选,多候选消歧发生在确认块之前。此衔接同时满足「候选前置」与「确认块必须干净、严格复刻模板」两条要求

**执行约束**:
- **项目名是最高优先级校验项**:ODPS 项目名必须通过元数据能力实际查询获得,禁止从知识库推测、从工作空间名猜测、或从上下文推断。同名表在不同项目下是完全不同的资产,项目名错误会导致后续排查方向完全跑偏
- **没有完整项目名,禁止输出确认**:如果 ODPS 项目名尚未通过元数据能力确认,即使表名和指标名已匹配,也禁止向用户输出确认信息。此时必须继续查询元数据直到确认项目名,否则会让业务方误以为映射正确,导致整个诊断流程在错误的表上执行
- 完整表名(含项目名)、Owner、数据地图链接三项缺一不可,缺失任一项时必须先通过元数据能力补齐
- 每个候选表都必须附带以上完整信息,方便业务同学对比选择
- 用户确认后才进入 Phase 1

**用户反馈"不对"时的重新定位策略**:

映射确认包含三项核心信息(完整表名、字段名、对应指标),任一项错误都会导致后续排查跑偏。收到"不对"反馈时,按以下策略处理:

| 用户反馈 | 处理动作 |
|---------|---------|
| 明确指出"表不对" | 仅重新定位表,保留已确认的指标和字段 |
| 明确指出"字段不对" | 仅重新定位字段,保留已确认的表和指标 |
| 明确指出"指标不对" | 仅重新定位指标,保留已确认的表和字段 |
| 指出多项不对 | 仅重新定位被指出的项 |
| 只说"不对",未指出具体哪项 | **全部重新核实**(表名、字段、指标三项全部重新定位) |
| 给出了正确的值(如"字段应该是 xxx") | 直接采用用户给出的值,补充元数据验证后重新展示确认 |

**项目名确认流程**:
1. 通过知识库/语义匹配获得候选表名后,**必须调用 `dataworks-meta-table` 或 `dataworks-meta-search`** 查询该表的实际所属项目
2. 如果元数据返回多个同名表(不同项目下),列出所有候选的项目名差异,让用户选择
3. 只有项目名经过元数据确认后,才允许将完整表名展示给用户确认

---

## Phase 1:信息采集(并行收集,不做分析)

> **核心原则:在信息不完整时下结论,比不排查更危险。**

### 目标

进入 Phase 2 分析之前,**并行收集所有必要的原始材料**。Phase 1 **只做收集,不做分析判断**。

### 执行原则

1. **并行发起**:采集项之间互不依赖的,**必须并行发起**;执行并发遵循轮次预算第 1 条「批内并行、批间串行」(有依赖关系的采集项如"先拿 nodeId 再查实例"允许拆为批次,批内其余项仍并行)
2. **原样保留**:采集到的材料原样保留,不在此阶段做分析
3. **容忍缺失**:某个采集项失败或不可获取时,标注为"不可获取"并继续其他采集项

### 必采集清单

> **输出约定列是上下文预算的落地**:采集时只保留「输出约定」列要求的内容,接口返回的其余字段一律不进入上下文(落地方式见 Phase 2「上下文预算执行规范」,对 Phase 1 同样适用)。

| 采集项 | 采集方法 | 输出 | 输出约定(只保留这些,其余不进入上下文) |
|--------|---------|------|--------------------------------|
| ① 指标口径定义 | 知识库检索 | 计算公式、过滤条件、聚合方式、数据单位 | 全量保留(核心证据,体量小) |
| ② 产出节点代码 | 调度运维 `task code` | 运行态完整 SQL | 全量保留(核心证据) |
| ③ 节点基础信息 | 调度运维 `task list/detail` | nodeId、负责人、创建时间、调度周期、上游依赖列表 | 投影:仅 nodeId、负责人、创建/发布时间、调度周期、上游依赖;不保留资源组、告警规则等无关属性 |
| ④ 异常日期实例状态 | 调度运维 `taskInstance list` | 运行状态、重跑次数、运行时间 | 投影:仅状态、时间线、重跑次数、运行时长;不保留完整实例 JSON |
| ⑤ 上游表结构识别 | 元数据 `table get` + `column list` | **分区特征分类**(时间切片型 vs 全量快照型)、分区策略、关键字段 comment | 投影:仅字段名 + comment(+ 分区键),不要类型、位置等无关属性;分区列表只取最新 20 个 + 行数 |
| ⑥ 代码中过滤字段 comment | 元数据 `column list --name-keyword` | 代码中所有 WHERE/IN 条件涉及的字段枚举定义 | 全量保留(通常体量小,且逐值核对必需) |
| ⑦ DQC 规则状态 | 数据质量技能 | 是否已配置规则、最近运行结果 | 投影:仅有无规则、规则数、最近一次运行状态;不返回规则明细全文 |

### 数据分区特征分类(采集项 ⑤ 的核心输出)

上游表按分区数据特征分类,**决定了后续强信号判断的解读方式**:

| 分区特征 | 识别方法 | 对后续分析的影响 |
|--------|---------|--------------|
| **时间切片型** | 各分区数据不同,分区代表时间切片 | 分区数据变化有意义,动态分区函数变化可能导致数据断层 |
| **全量快照型** | 各分区数据相同或高度重叠 | 分区数据相同是正常的,动态分区函数变化不会造成差异 |

> 识别方法:对上游表执行 `SELECT ds, COUNT(*) FROM table WHERE ds IN (近3天) GROUP BY ds`,对比各分区行数。

### 信息采集完成标志

所有必采集项要么已获取材料,要么标注为"不可获取"。此时进入 Phase 2。

---

## Phase 2:分析诊断

> Phase 2 基于 Phase 1 采集的完整材料,执行系统性排除。
> 不再按优先级串行执行维度,而是并行扫描所有可能根因类别,快速判定后深挖待定项。

### 排查维度矩阵(核心)

> 4 个维度是排查的执行主体,每个维度包含排查信号、检查项、输出要求、常见异常模式。
> **所有维度并行扫描(第一轮快速扫描),不按优先级串行执行。**

#### 全局执行原则(强制执行)

1. **强信号即转向(需前置校验)**:排查过程中出现明确信号时,立即转向深挖该信号,**未完成项一律跳过**。但**强信号判断前必须先执行「强信号前置校验」**,排除假性信号。不要按清单机械跑完所有检查项。
2. **低成本 + 高命中优先**:所有维度内的检查项按「先快后慢、先易后难」重排。只读接口(秒级)> 单条聚合 SQL > 代码/变更对比 > 定向深挖 SQL。
3. **不做无用工**:每条 SQL 和检查都必须有明确的验证假设。与当前场景无关的检查项直接跳过(如"数值偏低"场景不需要跑 JOIN 唯一性验证)。
4. **按需合并 SQL**:互不依赖且单条耗时短的核对 SQL 可合并为一条提交(UNION ALL 或多语句),减少等待轮次。但如果某条 SQL 本身耗时长(如全表扫描、大 JOIN),应单独提交,避免一条慢 SQL 拖住整批。合并与否根据实际 SQL 复杂度和数据量判断,不强制合并。
5. **严格边界**:按指令目标排查,不要自行拓展排查范围。已定位根因后立即停止,不继续执行剩余维度。
6. **证据分级(强制区分)**:排查中获取的所有信息必须区分为「结论性证据」和「排查性线索」,混淆两者会导致结论不可靠。详见下方「证据分级规则」。
7. **跨维度联查**:四个维度不是独立执行的孤岛,发现线索后必须主动联合其他维度交叉验证。详见下方「跨维度联查规则」。
8. **指标必查口径**:涉及指标异常时,必须获取指标的计算口径定义,并核实代码产出逻辑是否与口径一致。口径不一致可直接作为结论性证据。详见下方「指标口径核查」。
9. **上下文预算(强制)**:一切数据获取默认**最小投影**——只取当前判断所需字段、能聚合就先聚合后取数。单次返回超过 `MAX_RESULT_ROWS` 行或明显超长时,必须**落盘**到 `DIAG_ARTIFACT_DIR`,上下文中只保留「文件路径 + 总行数 + 关键摘要」,需要细节时再按路径定向读取。禁止把大段原始结果粘贴进排查过程或最终报告。各能力的输出控制方式见下方「上下文预算执行规范」。
10. **轮次预算(强制)**:每一轮对话都要重新携带全部上下文,每次用户交互都会中断排查流并产生等待。因此:互不依赖的调用必须**同批发起**;同一阶段需要用户确认/判断的所有事项必须**合并为一次交互**;平台可自查的事实类信息必须**先探后问**;需要用户确认的输出用**带证据的候选清单**前置,不用单一猜测。落地方式见下方「轮次预算执行规范」。
11. **全局止损线(强制)**:诊断必须设置墙钟与调用量上限——单次诊断自 Phase 1 起超过 `MAX_DIAG_MINUTES`(默认 40 分钟)或工具调用超过 `MAX_DIAG_CALLS`(默认 60 次)仍未定位根因时,**立即停止深挖**,输出「未能定位」报告:已排除的方向、已收集的结论性证据、剩余未验证的假设及验证方法、建议人工接管。报告输出后按**附录模板 7(未能定位通知)**通知问题提出人,再执行案例归档(`diagnosis.rootCause` 记为"未能定位")。禁止为"再试一个方向"突破上限——未收敛本身就是需要上报的信号,继续投入的边际收益低于成本。

#### 轮次预算执行规范(第 10 条原则的落地方式)

> **可移植性要求**:本节只规定行为要求,不绑定任何具体交互机制或命令参数;并发上限、交互形式按当前运行环境能力适配。

1. **批内并行、批间串行**:结果互不依赖的只读调用必须同一批发起,等上一批返回后再发下一批。并发量遵循当前环境限制;环境未明确限制时,普通并行不超过 5 个,大文件/全表类重操作收紧到 2~3 个
2. **合并确认**:同一阶段所有需用户确认/判断的事项,合并为一次交互逐项列出,禁止拆成多轮逐个问(如环境配置的多项参数、多个候选表的选择、确认与后续流程的决策)。不同阶段的确认(如 Step 0 映射确认与 Phase 2 深挖方向)不强制合并,避免一次交互承载过多无关信息
3. **先探后问**:平台可自查的事实类信息——表名、项目名、字段、分区、实例状态、节点代码、DQC 状态、数据源——必须先通过能力依赖表对应的能力自查;查不到或存在多个候选时才向用户提问。只向用户询问平台查不到的**业务判断**(口径取舍、看板口径、促销/活动背景等)。跳过自查直接问用户属于违规
4. **候选前置**:向用户确认的结论(指标映射、候选表、根因方向等)若命中不唯一或置信不足,必须输出带证据和差异点的候选清单供选择,降低推翻重来概率。仅当命中唯一且匹配证据明确时才允许单一候选。候选清单同样受上下文预算约束(只列判断所需字段)
5. **失败不盲试**:调用失败时先阅读错误信息中给出的恢复指引再修正重试;对不熟悉的命令/参数先用该能力自带的自省方式(帮助、参数签名、schema 等等价能力)确认一次再调用,不靠试错。每次失败调用都是一轮全额开销,盲试是轮次预算的主要浪费源

#### 上下文预算执行规范(第 9 条原则的落地方式)

> **可移植性要求**:本节只规定能力要求和阈值,不绑定任何具体命令名或参数名。不同工具链的输出控制参数命名不同,按等价能力匹配。

1. **投影查询**:被调用能力支持字段投影、行数限制、格式化输出等等价参数时,优先使用;列表类查询先取首页判断量级,再决定是否翻页
2. **大结果落盘**:被调用能力支持"结果写入文件"的等价参数时,直接落盘到 `DIAG_ARTIFACT_DIR`;不支持落盘参数但返回已超长时,将原始输出转存到本地文件后再裁剪
3. **子代理兜底**:被调用能力既不支持投影也不支持落盘、且结果庞大时,把该输出的解析委托给子代理(subagent),上下文只接收结论摘要——任何情况下都不得让原始大结果滞留上下文
4. **落盘即引用**:落盘后的文件在报告和排查记录中只以「路径 + 行数 + 摘要」引用,不复述内容;报告归档时把落盘文件路径写入 `artifacts`
5. **SQL 与查询预算**:诊断用 SQL 一律写成**聚合查询**(GROUP BY + SUM/COUNT/AVG,按分区/维度汇总),禁止拉明细行进上下文;必须带 `LIMIT`(默认不超过 `MAX_RESULT_ROWS`)。仅以下场景允许明细,且上限 100 行:过滤条件枚举值抽样核验、异常分区定点抽样、血缘断点验证。验证类回放/对比 SQL 若预计结果较大,同样先聚合再取数

#### 强信号前置校验规则(强制执行)

B.1 量化异常可能产生"看起来像强信号"的假性信号。**在基于强信号跳转到其他维度之前,必须先验证信号的真实性**:结合 Phase 1 已采集的材料(分区特征、上游状态、口径定义等),确认该信号不是由正常的数据特征(如快照型分区数据天然相同)或上游自身变化所导致。

> **核心原则**:强信号只是"值得深挖的方向提示",不是结论。在跳转前必须验证信号的真实性。

#### 证据分级规则

排查过程中获取的信息分为两级,**结论性证据可用于下结论,排查性线索仅用于辅助判断和缩小范围**:

| 证据级别 | 定义 | 示例 | 能否下结论 |
|---------|------|------|-----------|
| **结论性证据** | 平台/系统产生的客观记录,或**口径定义与代码逻辑的确定性比对结果** | DQC 规则失败记录、任务实例失败日志、代码变更记录(有明确 diff)、元数据中的表 Owner/项目名、调度配置变更时间线、**口径要求 N 种枚举值但代码过滤了 M 种(M≠N)**、元数据字段 comment 与代码枚举值不一致 | ✅ 可以 |
| **排查性线索** | AI 主动探查得到的推测性信息,需要进一步验证 | 主动执行的统计 SQL 结果(如行数波动率、空值率)、口径比对发现的可能差异、上游表行数变化 | ❌ 仅辅助判断 |

**使用规则**:
- 报告中「根因判断」和「置信度」必须基于至少一条结论性证据
- 仅有排查性线索时,置信度不得标注为"高",应标注"中"或"低"并注明"需进一步确认"
- 排查性线索的价值是**缩小假设范围**和**指引后续排查方向**,不是直接定论
- 每个检查项输出时必须标注其证据级别:`🏷️ 证据级别:结论性 / 排查性`

#### 跨维度联查规则

四个维度不是独立执行的,发现线索后必须主动联合其他维度交叉验证:

**【强制规则】数据质量维度发现异常后,必须联查至少一个其他维度确认根因**

数据质量维度(B)的职责是**确认异常存在**(数据确实有问题、问题表现是什么),但**不是定位异常原因**。任何数据质量维度的发现都必须联查任务状态(A)、代码变更(C)或表血缘(D)至少一个维度,确认"为什么会出问题"后才能下结论。

| 数据质量发现 | 必须联查的维度(至少一个) | 联查目的 |
|------------|------------------------|---------|
| 口径核查发现枚举值多计/少计 | 代码变更(C)或任务状态(A) | 确认是什么时候引入的、谁引入的、是否近期变更导致 |
| 口径核查发现计算公式不一致 | 代码变更(C)或任务状态(A) | 确认公式错误是历史遗留还是近期变更、是否补数据覆盖了旧分区 |
| B.1 量化发现数据量突变 | 任务状态(A)或表血缘(D) | 确认是重跑/补数据导致、还是上游数据源变化 |
| B.1 量化发现空值率飙升 | 表血缘(D)或任务状态(A) | 确认是上游字段映射变更、还是分区写错 |
| B.2 定向深挖发现过滤条件变化 | 代码变更(C) | 确认 WHERE 条件何时被修改、修改人是谁 |

> **禁止行为**:数据质量维度发现异常后直接定性为"结论性证据"并输出根因。必须先联查其他维度确认根因链条。

**其他联查场景**:

| 当前维度发现 | 应联查的维度 | 联查目的 |
|------------|------------|---------|
| 任务状态发现实例失败但数据仍有产出 | 表血缘(维度 D) | 检查是否有其他任务也在写同一张表,用血缘链路**排除或确认** |
| 代码变更发现近期有 WHERE/JOIN/过滤条件修改 | 数据质量(维度 B) | 追加一条简单 SQL 量化数据影响幅度(如变更前后行数对比) |
| 血缘维度发现上游数据断流 | 任务状态(维度 A) | 检查上游任务是否失败/冻结,用实例状态**确认断流原因** |
| 任意维度定位到根因 | 表血缘(维度 D) | 评估影响面:下游多少表/指标受影响 |

**联查执行原则**:
- 联查是**定向验证**,不是重新排查:只查与当前假设直接相关的信息
- 联查结果如果**证实**了假设 → 升级为结论性证据,可下结论
- 联查结果如果**否定**了假设 → 回到原维度重新排查,该线索降级
- 报告中展示联查过程:`联查:{维度 A 实例记录} 证实 {维度 B 发现的代码逻辑问题}`

#### 指标口径核查(涉及指标时必执行 — 最高优先级)

当排查场景涉及指标(数值偏高/偏低等),**必须执行口径核查**。口径核查是数据质量维度的核心,**优先级高于所有其他检查项**。

> **核心教训**:口径核查不能停留在"WHERE 条件是否与口径一致"这种笼统比对。必须深入到每个过滤字段的枚举语义,逐值核对。"看起来差不多"不等于一致。

##### 口径核查六步法(严格按顺序执行,不得跳步)

**第一步:获取指标口径定义**
- 从知识库获取指标的完整定义,包括:计算公式、过滤条件、聚合方式、度量列、数据单位
- 注意区分**原子指标**、**派生指标**和**复合指标**的口径差异,明确当前排查目标对应哪个口径

**第二步:获取产出代码**
- 获取目标节点的实际 SQL 代码(运行态,非开发态)

**第三步:过滤条件枚举值校验(最关键,必执行)**

这是口径核查中最容易遗漏、也是命中率最高的检查项。**禁止仅看 WHERE 条件的字段名是否与口径提到的概念匹配,必须深入到每个枚举值的业务语义**。

执行步骤:
1. **扫描代码中所有过滤条件**:找出所有 IN(...)、=、BETWEEN 等硬编码的过滤值
2. **查询每个过滤字段的 comment/枚举定义**:通过元数据能力(`dwmeta table column list --name-keyword "<字段名>"`)获取字段的完整 comment
3. **逐一比对**:将代码中包含的每个枚举值与口径定义中要求的业务含义逐一对照
   - 口径要求 N 种但代码过滤了 M 种 → **M > N 为多计**,**M < N 为少计**
   - **必须以字段 comment 为准**,不能凭字段名猜测枚举值含义
4. **输出比对表**(格式):

```
| 枚举值 | 字段含义(来自 comment) | 口径是否要求 | 代码是否包含 | 一致性 |
|--------|----------------------|------------|------------|-------|
| {值1}  | {comment中的含义}     | {是/否}    | {是/否}    | {✅/❌} |
```

> **禁止省略此步骤**。即使 WHERE 条件看起来合理,也必须查 comment 确认每个枚举值的实际含义。

**第四步:聚合函数与计算公式校验**
- 分子分母是否与口径一致(SUM/COUNT/AVG/DISTINCT,分子分母是否改反)
- 特别注意原子指标和派生指标的公式差异,确认代码实际用了哪个公式
- 检查是否存在隐含的计算错误(如不同的去重字段导致的差异)

**第五步:单位换算校验**
- 口径定义的单位与代码实际计算是否一致
- 检查缩放系数:单位转换后是否又乘了额外系数
- 逐层追踪单位转换链:原始字段单位 → 子查询转换 → 外层聚合,确保最终结果单位与口径一致

**第六步:JOIN 逻辑校验**
- JOIN 类型是否正确(LEFT/INNER/FULL)
- JOIN 条件是否完整(是否遗漏条件导致笛卡尔积)
- JOIN 后是否影响聚合粒度(如一对多 JOIN 导致行数膨胀)

##### 口径比对结果定性

- 任一步骤发现口径与代码**不一致** → **结论性证据**,可直接定论"代码产出逻辑与指标口径不一致"
- 六步全部通过 → 排除口径问题,转向其他维度排查

##### 联查代码变更

口径不一致时,立即联查维度 C(代码变更),确认是何时、由谁引入的变更。若历史节点已删除或变更不可追溯,标注为"不可验证"并停止在该方向继续投入排查轮次。

##### 口径核查时机(强制前置)

- **"数值偏高/偏低"场景** → 与 B.1 量化异常**并行执行**,不依赖 B.1 结果。口径核查未完成前,禁止基于 B.1 的"强信号"跳转到其他维度
- **其他场景** → 当 B.1 强信号指向口径问题时立即执行

> **核心原则**:口径核查是独立于数据量化的一级检查项,不依赖 B.1 结果,也不应被 B.1 的"强信号"跳过。即使 B.1 发现了明显的数据突变,也必须先完成口径核查再下结论——因为数据突变本身可能就是口径不一致的表现。

#### 维度 A:任务状态

**排查信号**:数据没出来、还是昨天的数据、数据少了、数据多了(可能重跑追加)

**检查项**:
1. 通过元数据能力查找产出目标表的实际节点(禁止用知识库中同名任务替代)
2. 异常日期实例状态:是否被调度触发、运行状态(成功/失败/超时/被终止/等待)
3. 失败 → 提取错误日志;等待 → 检查原因(上游未就绪/资源排队/基线超时)
4. 是否被冻结/暂停/跳过;调度时间或周期是否变更
5. 产出时间是否超 SLA
6. 重跑/重试情况:是否重复执行、分区是追加写入还是覆盖、是否并发写入冲突
7. 补数据/重跑是否使用了新版本代码(对比发布时间与实例运行时间)

**输出要求**:实例 ID、状态、运行时间线、产出数据量、资源组、重跑次数、冻结状态

**常见异常模式**:
- 实例失败/未调度/资源不足 → 数据完全没产出(最高概率原因)
- 上游未产出导致下游等待 → 沿血缘向上追溯
- 被误冻结 → 恢复后重跑
- 任务重跑 + 追加写入 → 数据量暴涨
- 补数据重跑覆盖正常分区 → 检查使用的代码版本是否一致

#### 维度 B:数据质量(含指标口径校验)

**排查信号**:数值偏高/偏低、数据量少/多

> **执行约束**:本维度严格按"先快后慢、强信号即转向"执行。出现明确信号后立即停止剩余检查项,转向深挖。不要按清单机械跑完所有 SQL。

**B.0 DQC 规则前置检查**(秒级,只读接口):
1. 通过 `dataworks-quality` 技能查询目标表是否已配置 DQC 规则
2. 已有 DQC → 查最近运行记录:DQC 通过 → 降低嫌疑,简化后续;DQC 失败/告警 → 直接定位到具体规则项,**跳过 B.1**
3. 无 DQC 或覆盖不足 → 进入 B.1

**B.1 量化异常**(一条聚合 SQL,合并提交):

将以下互不依赖的核对合并为一条 SQL 提交,不要逐条执行:
- 近 7 天各分区行数(量化哪天开始异常、幅度多少)
- 核心指标字段 SUM/COUNT(验证偏离方向和程度)
- 各分区最新日期分布(时效检查,判断是"还是昨天的数据"还是"数值变化")

**强信号判断**(B.1 结果出来后立刻判断,但必须先执行「强信号前置校验」):

> ⚠️ 以下信号在跳转前必须先排除假性场景(详见「强信号前置校验规则」)。未通过前置校验的信号不得作为跳转依据。

- 连续多天数据完全相同 + 某天突变 → **先校验上游表的分区特征**(Phase 1 已采集表类型)。时间切片型 → 口径断层信号,跳转 B.3;全量快照型 → 动态分区函数不会造成差异,**不跳转**,回到口径核查
- 行数骤降/骤增 > 30% → **先确认变化来自上游还是本节点**。上游变化 → 沿血缘追溯;本节点变化 → 跳转 B.3
- 空值率 100% → 数据写错分区/表,跳转 B.2 分区检查
- 无明显异常 → 继续 B.2
- **无论是否出现强信号,口径核查必须执行**(详见「指标口径核查」的时机要求)

**B.2 定向深挖**(仅验证当前已有假设,不做无差别扫描):

根据 B.1 信号选择对应检查项,**不要全部执行**:

| B.1 信号 | 执行检查项 | 跳过的检查项 |
|---------|-----------|------------|
| 行数突变 | 上游表行数变化、分区一致性 | 主键唯一性、枚举分布、JOIN 验证 |
| 空值率飙升 | 分区是否缺失/写错、上游字段映射 | 值域检查、枚举分布 |
| 数值偏移(固定倍数) | 单位换算、聚合函数(分子分母) | 分区一致性、主键唯一性 |
| 数值偏移(非固定) | WHERE 条件变更、过滤范围变化 | 分区一致性、枚举分布 |
| 数据量暴涨 | 主键重复率、JOIN 条件(仅当有 JOIN 时) | 枚举分布、时效检查 |
| 无异常但用户说不对 | 口径比对(B.3) | 跳过所有统计检查 |

**禁止执行的检查项**(除非有明确假设支撑):
- JOIN 唯一性验证(仅当怀疑 JOIN 放大且无其他证据时才执行)
- 维表组合对比
- 过滤条件逐项分解
- 与当前场景信号无关的任何 SQL

**B.3 代码与调度变更时间线对齐**:
1. 获取目标节点近 7 天代码变更历史
2. 将变更时间与 B.1 量化出的异常起始时间对齐:变更在异常之前才可能影响
3. 代码 diff 只关注与当前假设相关的变更(如行数突变 → 只看 WHERE/JOIN/过滤条件变更)
4. 检查分区/时效逻辑是否被修改(`${bizdate}` 硬编码、偏移改动)

**输出要求**:异常起始日期、偏离幅度、根因假设及支撑证据、口径差异对比(如有)

**常见异常模式**:
- 连续多天数据完全相同 + 某天突变 → 分区读取逻辑变更 / 口径断层
- 产出行数突增 → JOIN 放大 / 过滤条件放宽 / 主键重复
- 行数骤降 → 过滤条件收紧 / 上游断流
- 空值率飙升或 100% → 上游字段映射变更 / 数据写错分区或表
- 各分区行数完全一致 → 分区过滤缺失或硬编码分区参数
- 指标值按固定倍数偏移 → 单位换算错误(分↔元)
- LEFT JOIN 变成 INNER JOIN → 数据量大幅减少

#### 维度 C:代码变更

**排查信号**:之前正常今天突然异常、数值偏高/偏低、各类数据量异常

**检查项**:
1. 查询近 7 天代码变更历史(变更时间、变更人、变更类型)
2. 判断变更时间是否与异常时间吻合(变更在实例运行之前才可能影响本次产出)
3. 代码 diff 重点关注(按场景侧重不同):
   - 产出逻辑:写入目标表/分区是否变更、是否误加恒假条件(如 `WHERE 1=0`)
   - 过滤条件:WHERE 是否新增/放宽/收紧/移除、去重逻辑是否被删
   - JOIN 类型/条件:INNER ↔ LEFT 变更、JOIN 条件遗漏导致笛卡尔积
   - 聚合函数:SUM ↔ COUNT 变更、遗漏 DISTINCT
   - 分区/时效逻辑:`${bizdate}` 被硬编码、偏移改动(如 `${bizdate}` → `${bizdate-1}`)、`max_pt()` 替换、调度周期变更(日→周)
   - 字段名/表名变更、缩放系数/换算公式变更
4. 被注释掉的关键逻辑
5. 补数据/重跑是否使用了新版本代码

**输出要求**:变更时间线、可疑变更标记及原因、代码 diff 摘要(业务语言,不含完整代码)

**常见异常模式**:
- WHERE 条件被修改 → 过滤范围变化(数据多/少/数值偏移)
- 写入目标或分区表达式变更 → 数据没出来或还是昨天的
- JOIN 条件遗漏 → 数据量暴增/暴减
- 分区/调度逻辑变更 → 数据滞后
- 系数被修改 → 指标值按固定倍数偏移
- 补数据使用新版代码覆盖旧分区 → 历史数据被新口径污染

#### 维度 D:表血缘

**排查信号**:前序维度未定位根因、需评估影响面

**检查项**:
1. 获取目标表的上游依赖列表
2. 逐层检查上游任务状态与数据(DWS → DWD → ODS):上游数据量是否同步变化(断流/缩流/膨胀)
3. 上游是否存在新增数据源、新增分区、维度表膨胀
4. 数据时效差异:各层的产出时间与快照时点(T+1 vs 实时)
5. 定位异常最早出现在哪一层
6. 向下评估影响面(下游多少张表、多少个指标受影响)

**输出要求**:血缘链路、各层状态标记(正常/异常/未检查)、时效差结论、异常最早层、下游影响范围

**常见异常模式**:
- ODS 层数据同步中断 → 所有下游指标异常
- DWD 层加工逻辑变更 → 所有基于此 DWD 的指标异常
- 上游新增采集通道/维度表膨胀 → 下游数据暴涨或 JOIN 放大
- 维表未及时更新 → 关联后大量 NULL

### 假设验证规则(避免无效排查)

提出排查假设后,**必须先验证假设是否成立,再决定是否深入**:

1. **先跑验证 SQL,再决定是否投入**:每个假设必须有明确的验证方法和判定标准。验证结果否定假设时,立即停止该方向,不要继续追加排查轮次
2. **假设被否定后回到主线**:不要在已被否定的方向上寻找"也许还有别的原因"。回到口径核查或其他未完成的检查项
3. **证据不可获取时立即降级**:当关键证据不可获取时(如历史节点已删除、日志过期、代码资产搜索无结果),明确标注为"不可验证假设",**不在该方向继续投入排查轮次**,回到可执行的排查路径(如口径核查)

### 反思自检规则(定位根因后必须执行)

定位到疑似根因后,**在输出结论前执行反思自检**:

1. **假设是否被独立验证?** — 不能只靠一个维度的证据,是否有其他维度的交叉验证?
2. **是否存在替代解释?** — 当前根因是否还有其他可能的解释?如果有,是否已排除?
3. **排查路径是否走偏?** — 回顾排查过程,是否因为某个"强信号"跳过了本该完成的检查项?

### 场景分析参考(经验法则)

> 以下经验法则来自实战踩坑,在并行扫描架构下作为**分析深度参考**:帮助判断哪些方向更可能命中,从而在第二轮深挖时优先投入。不决定执行顺序。

| 异常场景 | 高概率方向(深挖时优先) | 中概率方向 | 低概率方向 |
|---------|----------------------|-----------|-----------|
| 数据没出来 | 任务状态、表血缘 | 代码变更 | 数据质量 |
| 还是昨天的数据 | 任务状态、表血缘 | 代码变更 | 数据质量 |
| 数据少了 | 任务状态、表血缘 | 代码变更 | 数据质量 |
| 数据多了/暴涨 | 任务状态、代码变更 | 表血缘 | 数据质量 |
| 数值偏高/偏低 | 数据质量(口径核查) | 代码变更 | 表血缘、任务状态 |

**两条经验法则**(实战踩坑总结,指导分析深度而非执行顺序):
1. **有无新旧先看任务** — 数据"存在性/时效性/数量"问题,任务状态维度需要更深入分析,这是最底层的基础设施
2. **对错先看质量** — 数值"准确性"问题,口径核查和 B.1 量化需要更深入分析,先量化异常范围再定位原因

**补充经验**:
- 代码变更通常是第二梯队嫌疑,几乎每个场景都可能是原因,但一般不作为首查项
- 反馈可能同时匹配多个场景时,合并高概率方向
- 映射表由经验库持续追加新行

---

## Phase 3:结论输出

### 执行规则
- Step 0 确认后,**主动连续执行** Phase 1 和 Phase 2,不在中间暂停等待用户确认
- 最终一次性输出完整诊断报告,不穿插中间排查过程
- 同时输出**对话内结构化报告**和**完整 HTML 报告**
- **诊断报告必须严格复刻下方模板**:逐段对照模板填充,不增段、不减段、不改段落标题与 emoji;某个占位符确实无值时保留该段并填写"不可获取",禁止整段省略。输出前逐项自查,缺段视为报告不合格,必须补齐后再输出

### Step 0 确认块必须干净
- 仅展示指标映射结果 + 待确认提示
- 禁止混入过程描述或承诺固定顺序
- 排查顺序由反馈现象动态决定

### 证据水印
每个维度检查末尾标注 `🏷️ 确认方式:`,说明通过什么途径确认(元数据能力、调度运维能力、知识库、SQL 执行等)。

### 节点查找优先级
- 必须通过元数据能力查找产出目标表的实际节点
- 禁止用知识库中同名/相似名的任务替代

### 诊断报告模板

```
📊 数据异常诊断报告
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━

🔖 问题概述
指标:{指标名称}
所在表:{odps项目名}.{表名}.{字段名}
日期:{异常日期}
现象:{异常现象描述}
匹配场景:{五类场景之一}
排查顺序:{实际执行的维度顺序}

🔍 诊断结果

检查 1 - {维度本名}:{结论}
{具体信息}
🏷️ 确认方式:{证据来源}

检查 2 - {维度本名}:{结论}
{具体信息}
🏷️ 确认方式:{证据来源}

检查 3 - {维度本名}:{结论 / 已跳过(根因已定位)}
...

💡 根因判断
{综合所有维度结果}

📋 置信度:{高/中/低}

🔧 建议操作
1. ...
2. ...

👤 责任人:{开发者姓名}

🔗 证据来源
- 知识库:{检索项 + 采用的来源定位(标题 + instanceId + docId,或文档路径 + citationId);未采用命中时说明原因;未调用时给出一句话原因}
- 元数据:{表/字段/实例的实时查询说明}
- SQL 执行:{关键验证查询的作用与落盘文件路径(如有)}
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
```

**模板占位符来源**:

| 占位符 | 来源 |
|--------|------|
| 指标 / 所在表 / 现象 | Step 0 已确认的指标映射结果 |
| 日期 | 用户反馈的异常日期 |
| 匹配场景 | 「场景分析参考」的 5 类场景之一 |
| 排查顺序 | Phase 2 实际执行的维度顺序 |
| 检查 N / 确认方式 | Phase 2 各维度检查结论与证据水印 |
| 根因判断 / 置信度 | 证据分级规则(结论性证据支撑"高") |
| 建议操作 | 根因对应的修复建议,按优先级排序,最多 2 项 |
| 责任人 | 调度运维能力获取的节点负责人 |
| 证据来源 | 知识库引用 / 元数据查询 / SQL 执行落盘路径 |

**报告编号规则**:
- 编号反映实际执行顺序,不是固定映射
- 已跳过的维度标注"已跳过(根因已定位)"
- 「证据来源」为必填项:知识库事实、实时业务事实、模型推断三者边界必须分开表述,保证结论可审计

### 报告产物与链接生成(打通后续 IM 模板的 `{报告链接}`)

诊断报告输出时,**必须同时完成落盘与链接生成**,否则 Step 5/6 的「报告详情」超链接无值可填:

1. **落盘**:HTML 报告写入 `DIAG_ARTIFACT_DIR`(模板 `./diagnosis/{日期}/`),文件名遵循报告命名规范:`{日期}_DataWorks-Data-Agent_{指标名}异常诊断报告.html`
2. **登记产物**:通过产物登记能力记录该文件,获得工作空间相对路径
3. **生成链接**:按展示输出技能(dataworks-display-output)的链接拼接规则,将报告文件转换为可访问链接;链接生成失败时降级为工作空间相对路径
4. **传递**:`{报告标题}` = 报告文件名,`{报告链接}` = 上一步生成的链接,两者一并传入 Step 5/6 及附录模板 1/2

> 未能生成链接(产物登记或展示输出技能不可用)时,报告详情行降级为纯文本路径,不得整行省略。

## 特殊场景

- **任务成功、质量全通过,但用户说不对** → 大概率口径问题,暴露差异由业务方确认
- **上游正常、目标表异常** → 问题在加工逻辑,重点查代码变更
- **ODS 层就异常** → 问题在数据同步环节
- **指标定位失败** → 请用户提供表名、项目名或 BI 数据集名称

## 约束

1. Step 0 是前置条件,未完成确认前绝不进入 Phase 1
2. Phase 1 信息采集完成前,绝不进入 Phase 2 分析诊断
3. 每一步都有明确检查项和输出,不跳步
4. 某步已定位明确根因可提前结束
5. 诊断报告不包含 SQL 代码细节,只含结论和建议
6. 置信度"低"时明确告知需人工排查
7. 不确定的标注"需确认"
8. 宁可多问一次,也不要映射错了表

## 经验库(持续迭代)

> 每次诊断完成后,将诊断过程和根因结论沉淀,持续优化排查矩阵。

### 沉淀内容

- **新根因模式**:追加到对应维度的异常模式列表
- **新反馈现象**:追加到「场景分析参考」映射表新行
- **排查顺序调整**:某维度命中率高于预期时调整对应场景顺序
- **排查偏差**:记录排查方向错误和用户纠正的案例

### 沉淀时机

- 诊断报告输出后立即沉淀
- 用户确认根因后标记"已验证"
- 用户纠正后作为新排查信号记录

### 沉淀原则

- 只沉淀结构化、可复用的经验(根因模式、排查顺序、纠正信号)
- 不沉淀个案细节(具体表名、实例 ID 等),除非该表/指标频繁出问题
- 条目超过 50 条时合并相似模式,清理低命中率条目

### 经验库格式

| 维度 | 根因模式 | 反馈信号 | 命中次数 | 首次发现 |
|------|---------|---------|---------|----------|
| 示例 | 过滤条件被扩大 | 数值偏低 | 1 | 2026-08-19 |

---

## Step 5-9 通用规则:IM 通道不可用兜底(fail-open)

IM 通知环节(Step 5/6/7a-7c/9)依赖外部通道,**通道不可用不得阻塞诊断主流程**:

- IM 通道未接入、发送失败或超时时:诊断报告照常输出与归档,通知环节标注「**未送达**(原因)」并跳过,禁止为重试通知反复阻塞
- 发送成功与否都必须如实记录在案例归档的 `timeline` 中
- 「等待用户/责任人回复」类环节属于正常流程等待,不属于通道不可用

## Step 5:IM 通知问题提出人(定位问题后)

**触发条件**:完成排查维度后,已定位到明确的问题根因(任务状态、数据质量、代码变更或血缘中的任一)。

**执行流程**:

1. **提取关键信息**:
   - 问题简述(一句话概括根因)
   - 报告链接(Phase 3 生成的诊断报告,以超链接形式展示:`[报告标题]({报告链接})`)
   - 影响范围(受影响的指标/表/日期)
   - 建议操作(最高优先级的前 2 项)
   - 任务责任人(从调度运维能力获取的节点负责人)

2. **在 IM 终端群内发送消息**:严格按**附录模板 1(问题定位通知)**发送——逐行复刻模板,只填充 `{占位符}`,不增删行、不改措辞。占位符来源见附录「模板占位符来源表」

3. **等待用户确认**:
   - 用户回复"是" → 进入 Step 6
   - 用户回复"否" → 结束流程,仅归档诊断报告
   - 用户回复其他内容 → 按用户意图处理

**输出要求**:记录用户确认结果,作为后续流程的决策依据。

## Step 6:通知任务责任人(用户确认后)

**触发条件**:Step 5 中用户明确回复"是",确认需要通知任务责任人。

**执行流程**:

1. **复用 Phase 3 诊断报告**:不重新生成报告,直接引用 Phase 3 已产出的诊断报告(报告链接见「报告产物与链接生成」);报告已含各维度结论、关键证据、置信度与建议操作,遵守「诊断报告不包含 SQL 代码细节」约束

2. **在 IM 终端群内发送通知**:严格按**附录模板 2(责任人通知)**发送——逐行复刻模板,只填充 `{占位符}`,不增删行、不改措辞。占位符来源见附录「模板占位符来源表」

3. **明确告知处理人反馈机制**:
   - 强调处理完成后需要主动反馈
   - 说明 AI 助理会验证修复结果
   - 说明验证通过后会闭环通知问题提出人

4. **注册定期提醒**:通知发送成功后,按 Step 9 第 1 条注册一次性提醒(默认 24 小时后)

**输出要求**:记录通知发送时间、责任人姓名、责任人确认接收情况(如有回复)、提醒注册状态。

## Step 7:处理人反馈闭环(收到处理人回复后)

**触发条件**:任务责任人在 IM 终端群内回复处理完成的消息(如"已修复"、"已处理"、"修复完成"等)。

**执行流程**:

1. **解析处理人反馈**:
   - 提取修复说明(处理人描述的修复动作)
   - 提取修复时间
   - 如有,提取新的根因说明(可能与原诊断不同)

2. **验证修复结果**:
   - 重新执行关键的数据质量检查(Step 0 中确认的指标)
   - 对比修复前后的数据状态
   - 检查任务实例是否重新运行并成功
   - 验证指标数值是否恢复正常范围

3. **判断验证结果**:
   - **验证通过**(数据恢复正常)→ 进入 Step 7a
   - **验证不通过**(数据仍异常)→ 进入 Step 7b
   - **部分验证**(部分指标恢复)→ 进入 Step 7c

### Step 7a:验证通过 — 闭环通知

1. **先执行案例归档**(进入 Step 8),归档文件写入成功后获得归档文件名
2. **再发送闭环消息**:严格按**附录模板 3(闭环通知)**发送,逐行复刻、只填充占位符;`{归档文件名}` 填入上一步生成的归档文件路径

### Step 7b:验证不通过 — 补充排查

**在 IM 终端群内发送补充排查消息**:严格按**附录模板 4(验证不通过)**发送,逐行复刻、只填充占位符。

**记录验证失败原因**,等待处理人再次反馈。

### Step 7c:部分验证 — 确认处理范围

**在 IM 终端群内发送部分验证消息**:严格按**附录模板 5(部分验证)**发送,逐行复刻、只填充占位符。

**记录部分验证结果**,根据处理人回复决定是否继续跟进。

**输出要求**:
- 记录处理人反馈内容
- 记录验证结果(通过/不通过/部分)
- 记录验证过程中的数据对比
- 记录闭环通知发送时间

## Step 8:案例归档(所有终态场景)

**触发条件**:任一终态场景均执行归档——
1. Step 7a 验证通过(正常闭环)
2. Step 5 用户回复"否"(`resolution` 记为"未闭环,用户选择不通知责任人")
3. 触发全局止损线(`diagnosis.rootCause` 记为"未能定位",`resolution` 记为"未闭环,待人工接管")

**执行流程**:

1. **收集归档信息**,生成结构化 JSON,包含以下字段:
   - `caseId`:案例编号,格式 `CASE-{日期}-{序号}`
   - `reporter`:问题提出人信息(name、userId)
   - `owner`:任务责任人信息(name、userId)
   - `issue`:问题描述(metric、table、date、symptom、scene)
   - `diagnosis`:诊断过程(priority、findings、rootCause、confidence、recommendations)
   - `resolution`:修复结果(fixDescription、fixTime、verificationResult、verificationDetails)
   - `timeline`:完整时间线(从问题提出到闭环的所有关键节点)
   - `artifacts`:关联产物(reportFile、evidenceFiles)

2. **生成归档文件**:
   - 文件路径:`{DIAG_ARTIFACT_DIR}/cases/CASE-{日期}-{序号}.json`(与诊断报告、落盘结果同一产物目录)
   - 文件名示例:`CASE-2026-08-24-001.json`
   - 序号从 001 开始,同日递增

3. **更新经验库**:
   - 将本次诊断的根因模式追加到经验库
   - 更新命中次数和最近验证时间
   - 如有新的排查信号,追加到「场景分析参考」映射表

4. **生成归档摘要**:
   ```
   📁 案例归档完成

   案例编号:{caseId}
   问题:{指标} - {问题现象}
   根因:{根因简述}
   处理人:{责任人}
   处理时长:{从问题提出到闭环的时长}

   归档文件:{文件路径}
   已更新经验库:新增 {N} 条根因模式
   ```

**输出要求**:
- 归档文件成功写入
- 经验库更新完成
- 向用户展示归档摘要
- 提供归档文件路径供后续查询

## Step 9:定期提醒(处理人未反馈时)

**触发条件**:Step 6 已发送责任人通知后,处理人超过 24 小时(可配置)未反馈"已修复/已处理"。

**执行流程**:

1. **注册提醒**:Step 6 发送成功时,通过平台定时任务能力注册一次性提醒(默认 24 小时后触发);定时任务能力不可用时按 fail-open 处理——标注「提醒未注册(原因)」,不阻塞主流程,也不为注册提醒反复重试
2. **到期发送**:提醒触发且问题仍未闭环时,严格按**附录模板 6(定期提醒)**发送——逐行复刻模板,只填充占位符
3. **收敛控制**:同一问题最多提醒 2 次,间隔同为 24 小时;达到上限仍未反馈时停止提醒,在案例归档 `timeline` 中记录"提醒已达上限,等待人工介入"

**输出要求**:记录提醒注册状态、每次发送时间与当时的问题状态。

---

## 完整工作流状态机

```
开始
  ↓
[Step 0] 指标定位与确认
  ↓
[Phase 1] 信息采集(并行收集)
  ↓ 信息完备性检查
[Phase 2] 分析诊断(并行扫描所有维度,系统性排除根因)
  ├─→ 第一轮:快速扫描(所有维度并行)
  ├─→ 第二轮:深挖待定项(参考场景分析表)
  ├─→ 第三轮:反思自检
  └─→ 触发止损线 → 输出「未能定位」报告 → 模板 7 通知 → 案例归档 → 结束
  ↓ 定位到根因
[Phase 3] 结论输出(含报告产物与链接生成)
  ↓
[Step 5] IM 通知问题提出人(附录模板 1)
  ↓ 用户确认"是"
[Step 6] 通知任务责任人(附录模板 2)→ 注册提醒(Step 9)
  ↓ 处理人反馈"已修复"
[Step 7] 处理人反馈闭环
  ├─→ 验证通过 → [Step 7a] [Step 8] 案例归档 → 闭环通知(模板 3)→ 结束
  ├─→ 验证不通过 → [Step 7b] 补充排查(模板 4)→ 等待再次反馈
  └─→ 部分验证 → [Step 7c] 确认处理范围(模板 5)→ 等待再次反馈

[Step 9] 定期提醒(模板 6,处理人未反馈时由定时器触发)
```

**异常分支**:
- Step 5 用户回复"否" → 结束流程,仅归档诊断报告
- Step 7 验证不通过 → 等待处理人再次反馈,循环 Step 7
- 处理人长时间未反馈 → Step 9 定期提醒(可配置,默认 24 小时后,最多 2 次)

---

## 附录:IM 消息模板

> **严格复刻约束(强制)**:本附录是所有 IM 通知的唯一模板来源,正文各 Step 不再内嵌模板。发送时逐行复刻对应模板:只填充 `{占位符}`,不增删行、不改措辞、不调整段落顺序。某占位符确实无值时保留该行并填写"不可获取",禁止整行省略。占位符取值一律对照文末「模板占位符来源表」,不得自行编造。

### 模板 1:问题定位通知(Step 5)
```
@{提出人} 您反馈的数据问题已定位:

📍 问题简述:{一句话根因}
📎 报告详情:[{报告标题}]({报告链接})
📊 影响范围:{指标} @ {日期}
👤 任务责任人:{责任人}

是否需要通知任务责任人并发送完整排查报告?
回复"是"我将通知责任人,回复"否"结束流程。
```

### 模板 2:责任人通知(Step 6)
```
@{责任人} 您好,有数据问题需要您处理:

🔴 问题概述
指标:{指标名称}
问题:{详细问题描述}
发现时间:{日期}
提出人:@{提出人}

💡 根因判断
{根因分析结论}

📋 建议操作
1. {优先级最高的操作}
2. {次优先级操作}

📊 目前进展
- AI 已完成 4 维度排查(任务状态/数据质量/代码变更/表血缘)
- 诊断置信度:{高/中/低}(高=证据确凿可直接修复,中=需人工复核,低=需人工主导排查)
- 完整排查报告:[{报告标题}]({报告链接})

⚠️ 处理完成后请在群内回复"已修复"或"已处理",
AI助理会检查定位的原因,无误后闭环通知@问题责任人并完成案例归档。
```

### 模板 3:闭环通知(Step 7a)
```
@{责任人} @{提出人}
✅ 数据问题已闭环

感谢处理,已验证修复结果:
- 指标:{指标名称}
- 修复时间:{时间}
- 当前状态:数据已恢复正常

您反馈的问题已解决,当前数据状态正常。

📁 案例已归档:{归档文件名}
```

### 模板 4:验证不通过(Step 7b)
```
@{责任人}
⚠️ 数据问题验证未通过

您反馈已修复,但当前数据仍有异常:
- 指标:{指标名称}
- 当前状态:{异常描述}
- 预期状态:{正常范围}

可能的原因:
1. {原因 1}
2. {原因 2}

请检查修复是否生效,或是否存在其他问题。
修复后请再次反馈。
```

### 模板 5:部分验证(Step 7c)
```
@{责任人}
⚠️ 数据问题部分恢复

验证结果:
- ✅ 已恢复:{恢复的指标/维度}
- ❌ 仍异常:{仍异常的指标/维度}

请确认:
1. 是否还有其他修复步骤未完成?
2. 仍异常的部分是否属于本次问题范围?

修复完成后请再次反馈。
```

### 模板 6:定期提醒(处理人未反馈时)
```
@{责任人}
⏰ 数据问题处理提醒

您有待处理的数据问题已超过 {N} 小时:
- 指标:{指标名称}
- 问题:{问题简述}
- 提出时间:{时间}

请尽快处理并反馈。如需协助,请在群内回复。
```

### 模板 7:未能定位通知(触发全局止损线时)
```
@{提出人}
⚠️ 数据问题暂未定位根因

您反馈的数据问题经排查,已达到本次诊断的投入上限({超时/超调用量}),暂未定位明确根因。

📋 已排除方向
1. {已排除的方向 1}
2. {已排除的方向 2}

🔍 已收集证据
{已有的结论性证据;无则填"暂无"}

❓ 剩余待验证假设
1. {假设 1} — 验证方法:{方法}
2. {假设 2} — 验证方法:{方法}

建议人工接管继续排查。如需补充信息(表名、项目名、现象细节),请在群内回复。
```

### 模板占位符来源表

| 占位符 | 来源 |
|--------|------|
| `{提出人}` / `{责任人}` | Step 0 会话中的问题提出人;调度运维能力获取的节点负责人 |
| `{一句话根因}` / `{根因分析结论}` / `{详细问题描述}` | Phase 2 定位的根因(2-3 句话,含结论性证据支撑点) |
| `{报告标题}` / `{报告链接}` | Phase 3「报告产物与链接生成」产出;链接生成失败时降级为工作空间相对路径 |
| `{指标}` / `{指标名称}` | Step 0 已确认的关联指标 |
| `{日期}` / `{时间}` | 用户反馈的异常日期;处理人反馈或系统记录的修复时间 |
| `{责任人}`(模板 1 任务责任人) | 调度运维能力获取的节点负责人 |
| `{归档文件名}` | Step 8 生成的归档文件路径 |
| `{异常描述}` / `{正常范围}` | Step 7 验证时的实测值;Step 0 采集的正常范围/口径基线 |
| `{原因 1/2}`、`{恢复/仍异常项}` | Step 7 验证结果对比 |
| `{N}` | Step 6 发送时间至当前的间隔小时数 |
| `{超时/超调用量}`、已排除方向、剩余假设 | 全局止损线触发时的「未能定位」报告内容 |
