阿里千问Qwen3.8-Flash多模态MoE模型:百万级上下文窗口、免费领100万Tokens

简介: 通义千问最新多模态大模型Qwen3.8-Flash(ID:qwen3.8-flash),原生支持百万级上下文(100万tokens)、文本/图像/视频输入,输出为文本。具备Function Calling、结构化输出、联网搜索(限北京/新加坡)等能力,兼容OpenAI/Anthropic协议,已在阿里云百炼平台开放免费试用(赠100万Tokens)。在阿里云百炼官网:https://t.aliyun.com/U/fPVHqY 免费领取千万Tokens

Qwen3.8-Flash 是通义千问最新推出的多模态大模型,模型调用 ID 为 qwen3.8-flash,原生支持百万级上下文窗口(1,000,000 tokens),输入模态支持文本、图像和视频,输出模态为文本。在阿里云百炼AI大模型平台:https://www.aliyun.com/product/bailian 测试使用,可以免费领取100万Tokens,如下图:
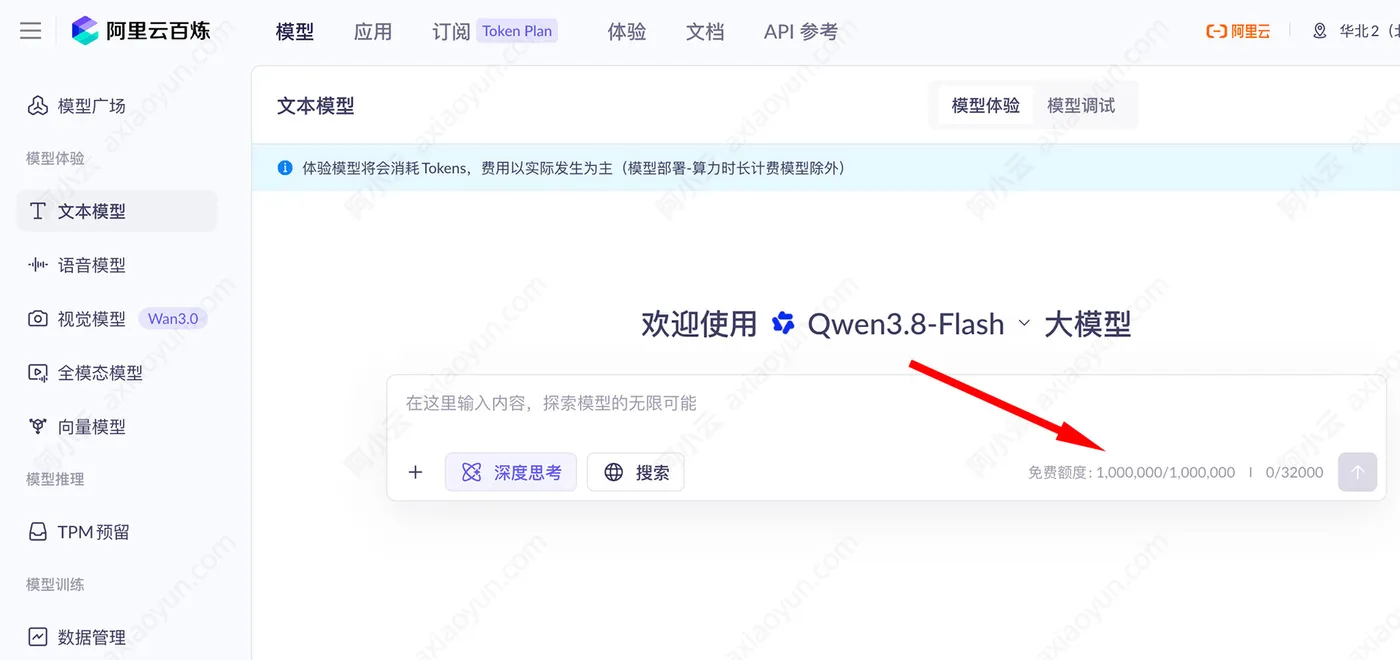
阿里云百炼Qwen3.8-Flash

核心能力:

  • 支持 Function Calling、结构化输出、联网搜索、前缀续写和上下文缓存;不支持批量推理和模型调优。
  • 兼容 OpenAI 与 Anthropic 接口协议,可接入 Claude Code、Codex 等开发者工具。
  • 在编程辅助、智能体协作、图文理解、长视频分析等场景中表现突出。

上下文限制:

  • 最大输入长度:991,808 tokens(思考模式下 983,616)
  • 最大输出长度:131,072 tokens
  • 最大思维链长度:262,144 tokens

部署地域与能力差异:

  • 华北2(北京)、新加坡:支持联网搜索
  • 德国(法兰克福)、日本(东京)、美国(弗吉尼亚):不支持联网搜索
  • 所有地域均支持 Function Calling、结构化输出、上下文缓存和前缀续写

计费信息(华北2-北京):

  • 输入:0.8 元/百万 tokens
  • 输出:2.7 元/百万 tokens
  • 输入(缓存命中):0.1 元/百万 tokens

价格可能调整,实际关于Qwen3.8-Flash模型精准报价,请在阿里云百炼平台查询:https://www.aliyun.com/product/bailian

目录
相关文章
|
2月前
|
存储 缓存 JSON
最新版阿里云通义千问(Qwen3.8‑Flash)功能介绍
大模型产业规模化落地过程中,推理性能与调用成本之间的矛盾,一直是开发者与企业需要直面的核心难题。旗舰级大模型综合能力强悍,但在批量Agent任务、高频文档解析、高并发接口服务场景,Token消耗会快速上涨,直接推高整体业务开销;轻量化模型虽然调用成本低廉,但是在代码工程开发、多轮工具调用、超长文档理解等复杂任务上存在明显短板,难以满足生产级业务诉求。Qwen3.8‑Flash作为通义千问推出的新一代多模态MoE模型,同时也是下一代Qwen4架构的技术预览版本,依托多项底层架构革新,在保障复杂任务处理能力的前提下,大幅压低训练与推理开销,原生支持百万级上下文窗口、图文视频多模态输入、高稳定性Fu
1473 0
|
3月前
|
人工智能 监控 测试技术
Qwen3.8-Flash 来了,100万上下文、Agent、Coding 都加强了
8月26日,通义千问发布Qwen3.8-Flash-Next:125B参数、每Token仅激活6B,原生支持26万Token、可扩展至100万上下文;Coding、Agent与工具调用能力显著增强,面向真实软件工程任务,推动大模型从“回答问题”迈向“完成工作”。
|
2月前
|
缓存 人工智能 API
Qwen3.8‑Flash完整能力解析:模型特性、API调用实操与计费规则深度拆解与成本避坑指南
Qwen3.8‑Flash依托全新MoE混合专家架构,激活参数量低,兼顾百万级上下文、原生多模态能力、稳定Agent工具调用,搭配云端缓存计费机制,在长会话、代码智能体、文档解析场景拥有突出的性价比。但它并不是全能模型,超高难度深度推理任务表现不及同系列旗舰大模型,业务落地需要结合自身业务诉求做综合评估。
887 1
|
2月前
|
缓存 自然语言处理 API
阿里云Qwen3.8‑Max、Qwen3.7‑Max、Qwen3.7‑Plus、Qwen3.7‑Flash、Qwen3.8‑Flash功能区别解析,企业项目选型完整指南
随着大模型智能体落地场景持续拓宽,越来越多开发者会面对多款同系列模型选型难题。阿里云百炼平台上架的Qwen3.8‑Max、Qwen3.7‑Max、Qwen3.7‑Plus、Qwen3.7‑Flash、Qwen3.8‑Flash五款模型,覆盖从复杂深度推理、长周期智能体、多模态GUI操控到高吞吐低成本业务场景,不同模型在架构、上下文窗口、模态支持、代码能力、工具调用稳定性、计费成本上存在明显差异。很多开发者在项目前期直接选用高规格旗舰模型,带来不必要的高额推理成本;也有部分场景误用轻量模型,造成复杂任务推理失败、工具调用错乱、长文档解析丢失关键信息等问题。本文将从底层架构、核心能力、适用业务场景
961 1
|
2月前
|
IDE 开发工具
额度翻倍!还有四天
Qoder推出Sonus模型专属福利:9月16-19日,付费用户每日12:00可领1000 Credits,用于全球顶级Sonus模型——支持编程、长程任务、专业软件操作及公式表格处理。登录Qoder各端活动入口即可领取。
620 0
|
3月前
|
缓存 人工智能 JSON
最新版通义千问(Qwen3.8‑Flash)功能介绍
在AI应用大规模落地的阶段,很多业务场景不再一味追求单轮推理的极致能力,而是更加看重综合指标,包括响应速度、推理吞吐、使用成本、长文本处理、多模态理解以及智能体任务执行能力。很多企业搭建AI应用的时候,会陷入两难选择:选用旗舰模型,推理成本高、并发承载有限,难以支撑大规模线上流量;选用轻量化小模型,又会损失复杂推理、工具调用、长文档分析的能力,无法完成真实业务当中复杂任务。Qwen3.8‑Flash作为通义千问序列主打高性价比的多模态MoE大模型,正是为了解决这一矛盾而生,它采用全新自研模型架构,用较低的激活参数量实现接近高阶模型的综合效果,同时把训练与推理开销大幅压缩,同时原生支持图文视频多
740 1
|
2月前
|
缓存 JSON API
阿里云千问Qwen3.8‑Max深度解析:核心能力、订阅计费规则、API接入配置与生产落地完整教程
Qwen3.8‑Max作为千问系列新一代MoE架构旗舰基座,总参数量达到2.4万亿,激活参数950亿,是面向复杂专业任务、长周期智能体、工程级代码开发、多模态深度解析的高阶大模型,原生支持文本、图像、视频多模态输入,最大上下文窗口达到百万Token,最大输出Token支持131072,内置深度思考推理链路,在编程、科研、法律金融专业分析、长视频文档解析、自主Agent任务等场景能力表现突出。很多开发者在项目前期直接接入该旗舰模型,却对模型能力边界、多种计费模式、订阅套餐权益、API参数配置、上下文缓存优化缺乏完整认知,出现成本失控、接口报错、长文本信息丢失、深度思考模式额外消耗大量Token等
2207 5