
过去一年,AI 的竞争焦点已经从“模型有多大”转向“AI 能在真实业务中走多远”。从训练到推理再到智能体,AI 正在从展示能力的阶段,真正嵌入到企业的真实业务流程中。
这背后是数据规模的指数级跃迁:主流大模型参数量已从千亿级迈向数万亿级,训练数据集在自动驾驶场景中已达数百 PiB 级别,推理阶段的 KV Cache 也在超长上下文窗口下急剧膨胀, Agent 运行环境达到数十万甚至百万级别并发规模。
一直以来,阿里云存储把容量、性能、可用性和可靠性做到了极致,撑起了互联网和云计算的数据底座。当前,AI 带来的新的业务场景和负载特征,是对存储的更高要求,更是 AI 原生时代对阿里云存储提出的全新时代命题。
围绕这三重需求,阿里云于飞天发布时刻推出 CPFS、KVCacheStore、AgenticFS 以及 OSS Agent 和 CDE Agent 等新产品和新能力,构建了一套覆盖 AI 全生命周期的存储产品矩阵。
一、当训练规模重新定义存储的天花板
当前 AI 训练阶段的核心链路是“加载数据、计算、写 Checkpoint、迭代”,每一步都依赖存储,但这条训练链路正在面临多重瓶颈。
Checkpoint 间隔不断缩短至分钟级,模型参数量从千亿迈向数万亿,单次写入量远超之前。数据集规模快速增长。训练数据扩展至百 PiB,数据类型从以文本为主,走向多模态数据。而海量数据冷热混杂,使得全部使用基于 SSD 的高性能存储规格,成本难以持续。
面对这些挑战,阿里云推出了全栈自研的新一代并行文件存储 CPFS,CPFS 从后端存储到 DPU 加速通道,再到 EFC 弹性客户端,全链路基于自研技术,针对训练场景的 IO 特征构建了端到端的加速能力。CPFS 基于阿里云盘古分布式存储底座,采用 Scale-out 分布式架构设计,元数据与数据分离独立扩展,实现容量和性能线性扩展。在计算节点侧通过 DPU 卸载存储协议栈,构建专用的高速存储访问通道,并通过数据零拷贝,来大幅提高计算节点访问存储的性能。
通过这些技术创新,CPFS 单文件系统可提供高达百 TB/s 级别的吞吐和亿级 IOPS,充分满足训练场景对存储的性能需求。在规模上,支持单文件系统线性扩展达百 PiB 容量、万亿级文件。在成本上,CPFS 提供多档存储规格,智能的数据生命周期管理,大幅优化存储成本。
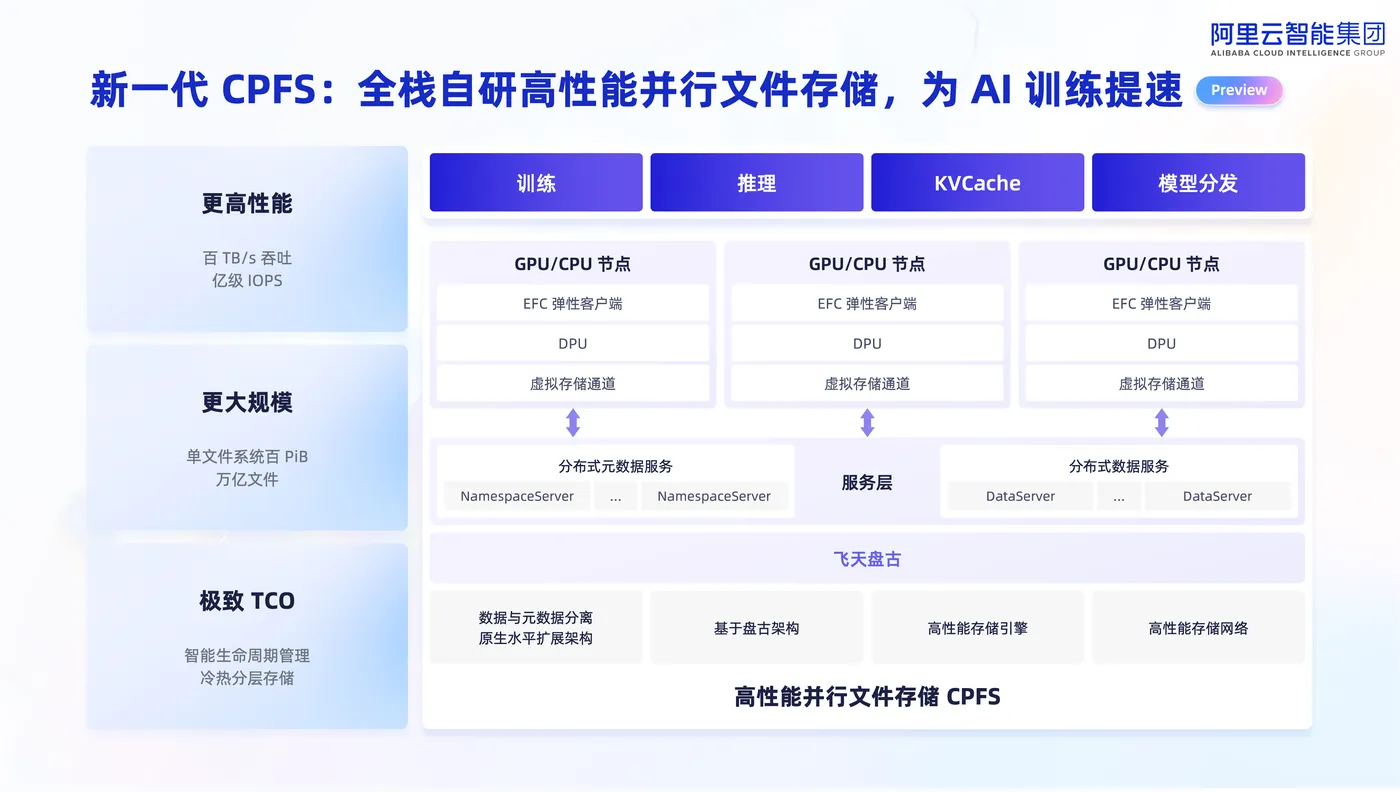
在通义千问大模型训练中,近万卡规模的训练集群覆盖数据预处理、训练、推理全链路。他们面临的痛点是:当近万卡同时读写训练数据,算力分散多地域、异构算力池,模型启动和加载慢会导致算力闲置,高质量语料跟不上训练节奏。使用全栈自研 CPFS 后,异构算力和跨地域资源通过统一 IO 栈访问 CPFS,模型启动平均耗时下降 50%,峰值算力利用率提升 30%,业务承载能力翻倍。语料供给从“等数据”变为“追算力”。
二、当推理速度开始依赖存储的响应
接下来看推理场景。多轮对话与长上下文推理成为趋势,KV Cache 数据量爆发式增长,显存和内存所构建的有限 KV Cache 容量,直接影响缓存命中率与服务吞吐能力。具体而言,推理场景对 KVCache 提出了四大场景的必答题:
一是长上下文推理加速。上下文窗口长度迈向 1M+,KV Cache 数据也在持续膨胀,需要以存代算,将 KV 卸载至高性能、弹性扩展存储层,来突破显存内存墙,降低 TTFT。
二是多轮对话与会话迁移。会话跨节点迁移与故障切换时,KV 状态丢失需整段重算。需要将 KV 状态持久化于共享存储,实现迁移与 Failover 免重算,对话不中断,算力调度更灵活。
三是 P/D 分离架构下,KV 需在两者间高频流转。需要通过共享存储来承接 KVCache 的中转,提供高带宽、亚毫秒级时延,消除数据搬运瓶颈。
四是共享前缀复用。System Prompt 等公共前缀,被大量请求重复 Prefill。需要公共前缀一次写入、全局共享,多请求并发读同一份 KV,提升命中率与 GPU 利用率。
面向大模型推理的 KVCache 加速引擎 KVCacheStore ,交出了自己的答案。它的定位很明确:G3.5 层 KVCache 存储,全球公共云首发。这一层让它贴近算力,性能优于远端 G4 共享存储,单计算节点可提供 40GB/s 吞吐,通过 batch 接口达到百万 QPS。
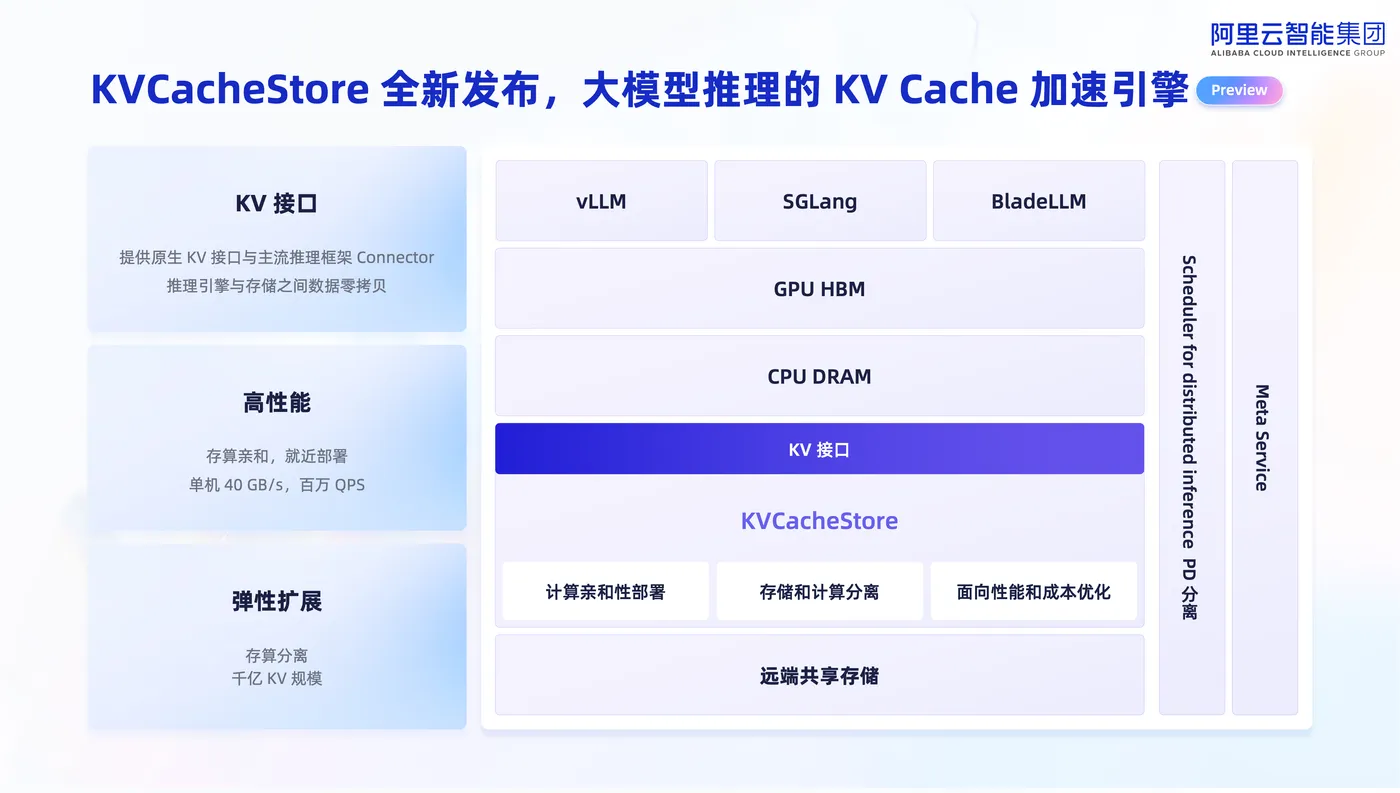
KVCacheStore 提供高效的 KV 接口,并面向 Mooncake 等主流开源推理框架提供定制化 connector,最大程度简化存储与推理平台的对接。同时 KVCacheStore 独立于算力部署,支持弹性扩容,单实例即可承载千亿级 KV 存储规模。
当前,KVCacheStore 已与客户进行共同验证,KVCacheStore 将缓存命中率提升了 20%,推理服务效率显著改善。
从训练到推理,存储的进化不只是解决单个环节的瓶颈,它在撬动整个算力生态的效率杠杆。存储速度决定了算力转化率:同样的硬件投入,当存储更快更智能,就能产出更多的 AI 能力。
三、当 Agent 成为存储的新用户
当 Agent 时代到来,用户与数据的交互方式正在被重新定义。今年年初个人 Agent 已掀起热潮,如今已拓展至无处不在的企业办公和编码 Agent ,正表明 Agent 赛道已进入了高速发展期。有分析报告显示,2030 年全球 Agent 市场规模会达到 526 亿美金,即增速达到 6 年 10 倍。
Agent 赛道高速增长,规模化落地需要存储跟上发展节奏。每个 Agent 需要独立的工作目录、会话记录和私有文件存储环境,单文件系统租户规模从千级迈向百万级。挂载点规模、配额数、挂载卸载 QPS 会同步放大数个数量级。每个 Agent 实例的生命周期短,压力的波峰波谷快速切换。传统文件系统的弹性和挂载能力无法支撑百万级 Agent 的弹性扩缩容。
而在目录级安全隔离层面,Agent 执行路径由大模型动态生成,易诱发越权访问与误删。每个 Agent 工作目录需要具备独立的权限控制、配额和 QoS 能力,确保数百万 Agent 之间的权限隔离和数据安全。
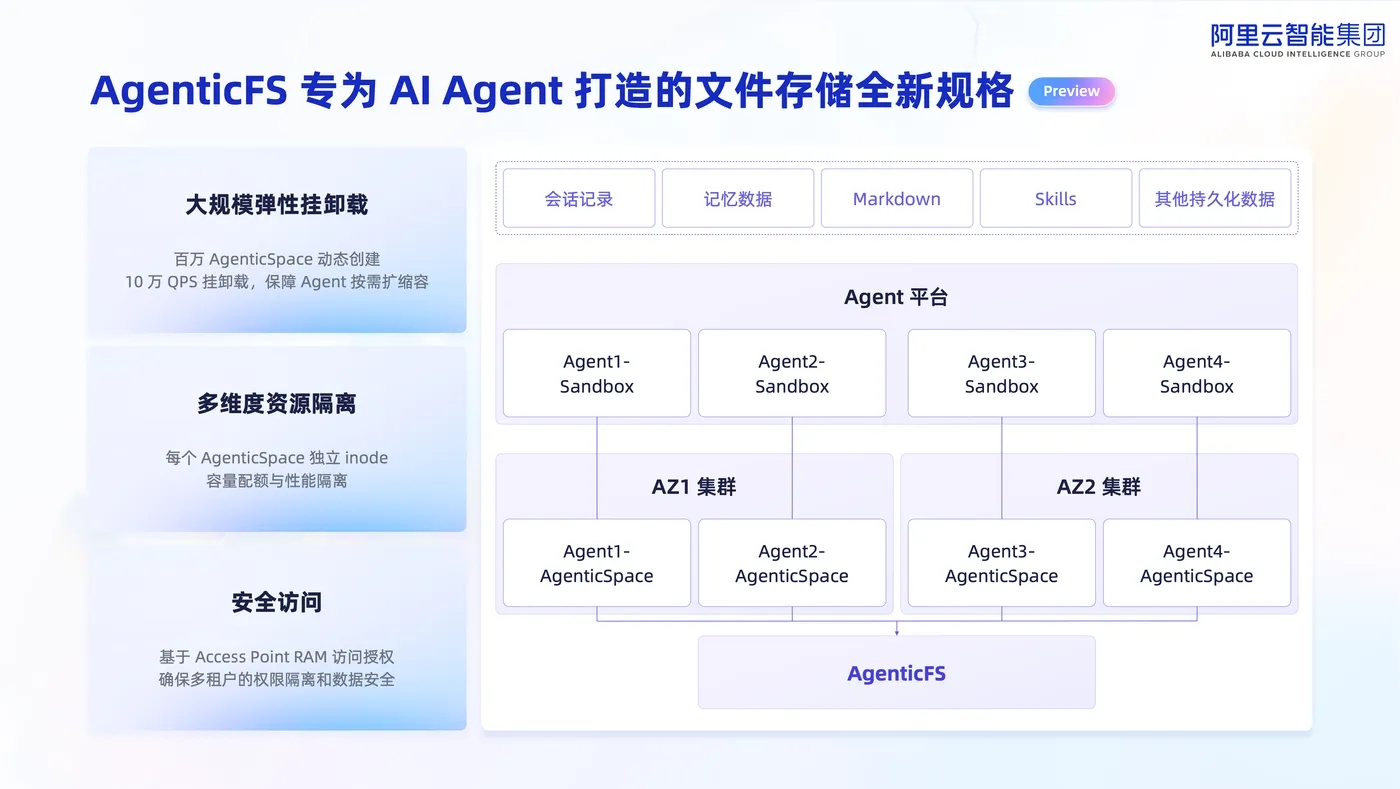
AgenticFS 专为这些场景而设,这个是一款专为 AI Agent 打造的文件存储全新产品,目前已开放邀测。它引入 AgenticSpace 概念,每个 Agent 拥有独立的命名空间、inode 资源、容量配额和性能隔离,支持百万级 AgenticSpace 动态创建和 10 万 QPS 级挂卸载能力。
AgenticFS 能力层面,可体现在三个维度:
- 支持多维度资源隔离,让每个 Agent 拥有独立的工作空间 AgenticSpace。每个 AgenticSpace 拥有独立 inode 资源,容量配额与性能隔离,保障多租户环境下的公平性和稳定性。Agent 的会话记录、记忆数据、Markdown、Skills 等持久化数据,都可以安全地存储在 AgenticSpace 中。
- 规模和弹性方面,AgenticFS 支持百万级 AgenticSpace 的动态创建和 10 万 QPS 级别的挂卸载能力。
- 安全方面,AgenticSpace 基于 Access Point 和 RAM 访问授权做权限控制,确保不同 Agent 之间的权限隔离和数据安全。
AgenticFS 已经在真实的 Agent 场景中跑起来了。某模型头部客户,作为基于国内领先大模型构建的面向 C 端的 AI 助手应用,提供对话问答、工具调用和 Coding Agent 能力,为海量用户承载多会话并行的智能体服务。这个场景下,存储首当其冲:沙箱随时可能超时、被 Kill 或重建,项目源码和中间产物随之丢失,会话无法续跑。 同时,海量用户和多会话之间需要强隔离、配额可控,任何一个 Agent 的资源异常都不能影响其他会话。
对此,AgenticFS 在这个场景中的解法是:按会话粒度划分 Agent Workspace,每个 Workspace 支持配额管理、访问隔离和性能隔离。沙箱内挂载不同路径,分别承载项目源码、交付物、用户输入和共享 Skill,沙箱随时可重建,数据持久化不丢失。一套存储承载多用户多会话的安全隔离访问,用户之间隔离,同一用户的不同会话之间也隔离。Agent 工作空间真正实现了持久化,会话可以断了再续。
四、当 AI 能力从基础设施走向用户手中
Agent 基础设施就位之后,Agent 能力开始从平台层向用户侧延伸。过去,OSS Agent 更多是控制台里的对话与执行式运维助手,帮助用户完成管控配置、异常定位和数据分析。但 Agent 的价值不止于此,它应该进入客户的核心运维流程,解决高频问题,真正带来智能运维的灵活性与价值。
OSS Agent 也在真实客户场景中得到了验证。 美图作为 OSS 的核心客户之一,在 OSS 上拥有上百个 Bucket,覆盖内部多条业务线。随着图片、视频、素材等非结构化数据持续增长,存储运维的复杂度也在不断攀升。
过去,日常咨询、异常排查、Bucket 管理、元数据分析,很大程度依赖人工逐项排查。既缺全局视角,也难以快速定位问题来源,上百个 Bucket 更谈不上精细化管理。
接入 OSS Agent 后,美图可以用自然语言完成日常咨询和异常排查,比如快速了解某个 Bucket 的配置、容量与状态,或者定位访问异常的原因。基于桶清单的元数据收集,OSS Agent 还能进一步做数据分析和可视化,帮助识别冷热数据分布、资源使用趋势和成本优化空间。
核心变化是从“人工运维”升级为“Agent 驱动的智能分析闭环”。 海量 OSS 资产从“看不清、管不细”变成“可理解、可分析、可优化”,为后续的降本和精细化治理提供了依据。
另外,对于企业来说,企业不缺文件,也不缺模型,缺的是一套能安全地自动处理文件的 Agent 体系。这是 AI 落地的最后一公里,也是企业数据真正产生价值的起点。阿里云盘企业版推出的CDE Agent,其底层能力来自 Qoder 的智能体框架,集成了大模型、记忆、工具链等核心组件。上层依托企业网盘的文件管理、权限审计和组织管理能力,用户通过 CDE Agent 可以完成文件上传下载、多模态检索、安全分享和知识沉淀。
但 CDE Agent 最关键的设计不在能力,在权限。它像员工一样被赋予权限,可复用 AD/LDAP、钉钉、RAM 等既有账号体系,权限粒度精确到文件级。企业不需要为 Agent 重建一套安全体系,数据泄露的风险从架构上就被拦住了。
结尾
从训练、推理到 AI Agent 规模化落地 ,从数据管理到多模态数据语义理解,这套存储产品体系覆盖的是 AI 数据生命周期的完整链路。CPFS 在加速模型训练,KVCacheStore 在提升Token 生产性价比,AgenticFS 在承载百万 Agent 的并发运行环境,OSS Agent 和 CDE Agent 将 AI 能力延伸到存储智能运维和企业知识管理。这不是概念框架,每一个都已经在真实的 AI 场景中跑通。
这不是一个产品方向,它是阿里云存储在 AI Native 和 Agent Native 时代必须面对的基础命题。阿里云正在做的,就是让数据在 AI 时代的每一步都跑得更快、更稳、更远。


