Agent 正在进入软件研发、数据分析与业务服务的核心流程。随着生成式 AI 和自主 Agent 的发展,越来越多企业开始将其用于环境创建、工具调用与任务执行。
Agent 已不再只是提供建议的助手,而是能够围绕目标自主创建环境、读写数据、调用工具并交付结果。
一、Agent 正在改变数据基础设施的使用方式
当环境创建、数据访问和应用交付开始越来越多地由 Agent 发起,数据基础设施的使用主体也从人类开发者和固定应用,扩展到能够自主调用工具和执行任务的 Agent。随之而来的,是使用主体、工作模式与能力边界的三项根本性变化。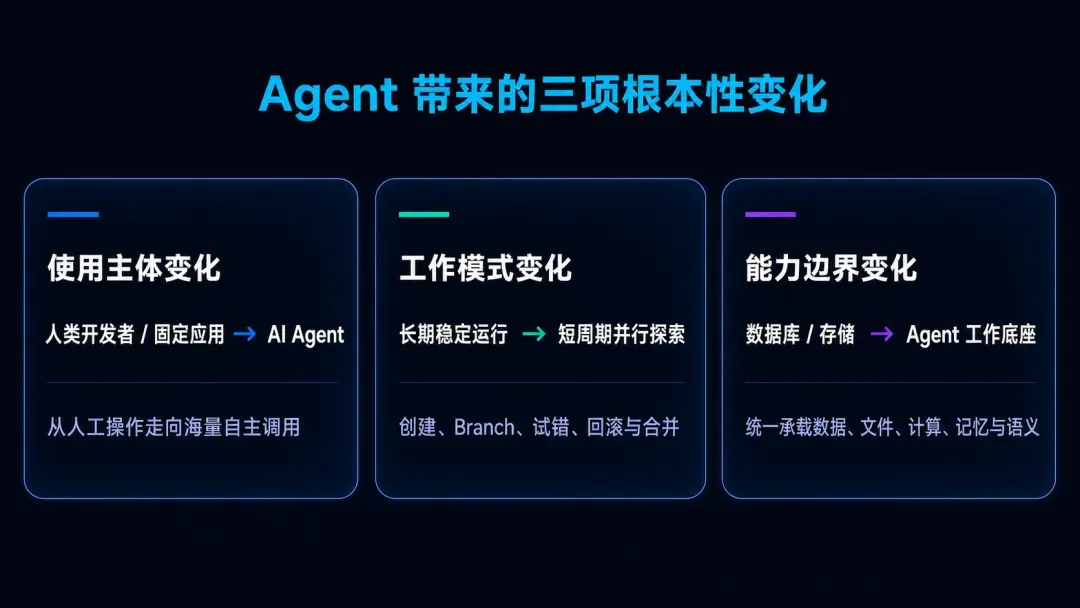
图 1|Agent 带来的根本性变化
三项变化进一步形成八项基础能力要求:海量 Agent 需要独立数据存储空间与原生接入;短周期、并行探索的任务需要弹性、Branching 与开放执行环境;数据边界的扩展,则要求多模统一底座、持久记忆与业务语义理解。
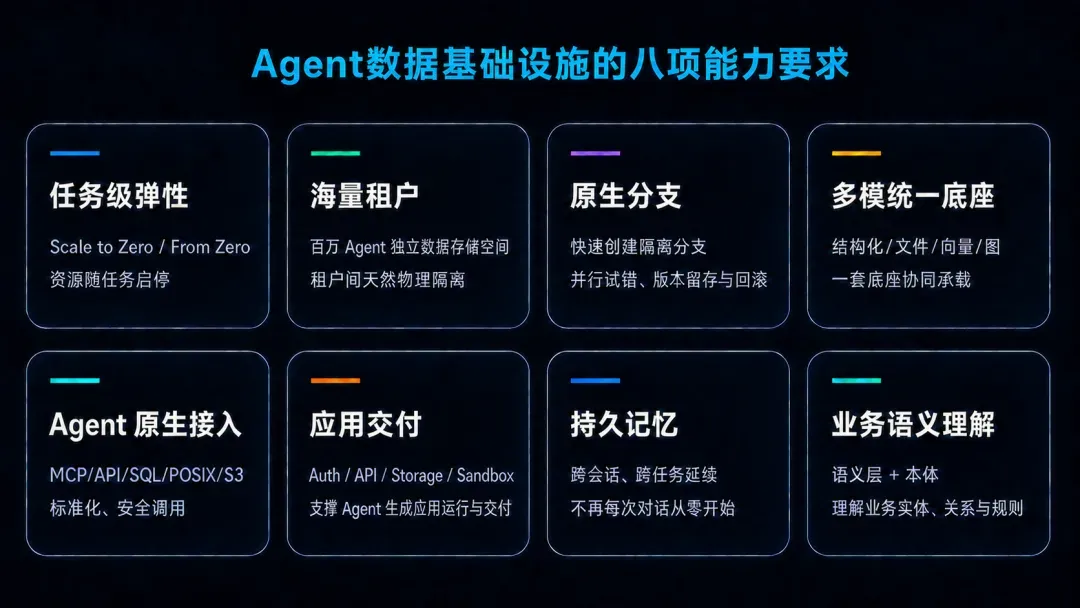
图2|Agent 对数据基础设施的基础能力要求
Agent 需要的不再只是一个数据库连接,而是一套能够被安全调用、随任务运行,并统一承载数据、文件、计算与认知服务的数据基础设施。
二、Cloud Native奠定基础,数据基础设施面向Agentic演进
Cloud Native PolarDB 通过存算分离、共享存储和资源池化,已实现高性能、高可靠与弹性扩展,为面向 Agent 的任务级弹性和海量隔离空间奠定了基础。
但 Agent 带来的不只是更大的资源规模,而是新的数据使用范式:环境按任务即时创建,在分支中并行探索与回滚,数据库、文件和模型产物被统一操作,并通过 MCP、API、POSIX 等接口自主调用。
因此,Agentic Native 是在 Cloud Native 基础上的进一步演进——让数据环境从“面向应用长期运行”,升级为“面向 Agent 任务按需创建、分支、启停与回收”。基于这一思路,阿里云瑶池旗下的云原生数据库 PolarDB 构建以 All-in-One DB 为核心的 Agentic 数据基础设施。
三、以 All-in-One DB 为核心的 Agentic 数据基础设施
下图是面向 Agent 的 All-in-One DB 数据基础设施。
核心底座由 Agentic Database 与 Agentic LakeCache 组成,分别承载任务级数据库环境和文件对象数据,作为统一数据底座提供弹性、分支、缓存与低成本持久化能力。
上层通过 MCP、SQL、POSIX FS/S3 等接口服务 Agent 和应用,并以 Supabase、Memory、Ontology、RAG 等服务提供应用后端、上下文、业务语义和知识检索能力。
右侧企业级治理能力则通过 OAuth 身份认证、RBAC 权限控制、操作审计与 Agent Trace 全链路可观测,确保 Agent 在多租户、多任务环境中可控、可管、可追溯地使用数据与工具。
本文将重点聚焦 Agentic Database 与 Agentic LakeCache 两大核心底座。
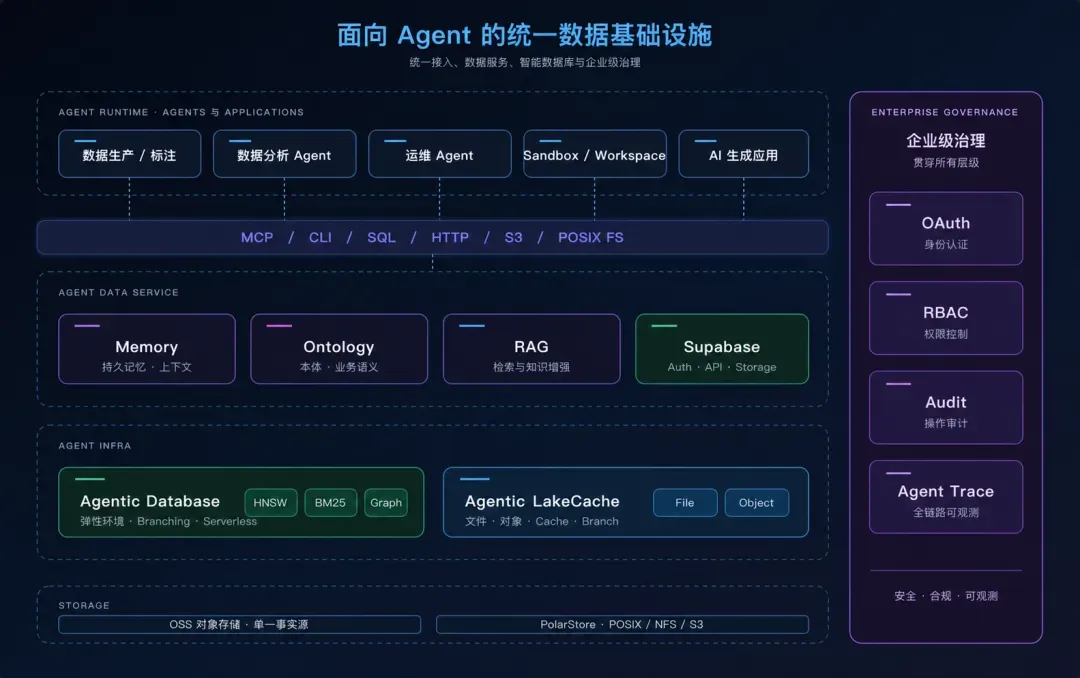
图3|PolarDB为智能体重构数据底座
Agentic Database:秒级弹性与 Branching 驱动的 Agent 原生数据库
以 Neon 为代表的 Serverless PostgreSQL 产品,让开发者逐渐熟悉了数据库按需创建、弹性启停和自由分支的新形态。PolarDB PostgreSQL Agentic Database 采用了类 Neon 的存算分离架构,使计算环境可以随 Agent 任务快速创建和回收,并通过 Branching 支撑多个方案并行试错。
在此基础上,Agentic Database 围绕 Agent 的访问入口、环境生命周期、并行试错和成本结构进行系统改造,同时完整保留 PolarDB PostgreSQL 的企业级内核、兼容生态和多模检索能力,形成三项核心能力。

图 4|Agentic Database
➡️ MCP 统一入口,让 Agent 安全使用数据库服务当前,MCP 已成为 Agent 连接外部工具和数据服务的事实标准。PolarDB PostgreSQL Agentic Database 以 MCP Server 作为统一入口,将实例创建、SQL 查询、Branch、回滚和环境管理封装为可发现、可调用的工具,无需不同 Agent 框架重复适配。
调用过程中,Agent 无需接触云账号 AK/SK 和数据库密码,系统通过 API Key 完成身份识别与租户隔离。即使在同一账号、同一逻辑实例下,不同 API Key 对应的资源和数据也相互不可见。
➡️ 快产快销,极速分支,计算按需启停,海量数据低成本长存PolarDB PostgreSQL Agentic Database 面向Agent任务,数据库自身通过Sandbox、热池机制能够快速创建独立数据环境;而在任务执行过程中,基于写时复制的分支技术可以从同一数据状态创建多个相互隔离的分支,支持不同 Agent 并行修改、验证、回滚和择优合并。
面对间歇性负载,计算资源支持 Scale Up/Down 和 Scale to Zero/From Zero,随任务启停;数据长期保存在 OSS,并通过计算节点的 Local File Cache 与 Page Server 缓存加速访问。由此,数据环境能够随任务而生、随任务而止,同时兼顾资源效率与恢复后的访问性能。
➡️ 企业级内核不减配,多模能力再增强PostgreSQL 凭借开放的扩展生态,可以在一套数据库中统一承载事务处理、向量检索、全文检索和图检索,减少多套系统之间的数据同步与架构拼装,让业务数据更新后能够及时参与多模检索。
而 PolarDB PostgreSQL Agentic Database 是在兼容 PostgreSQL 生态的基础上完整保留了云原生 PolarDB PostgreSQL 的企业级内核能力,为记忆、RAG等企业级AI应用提供更高性能、更易使用的 All-in-One DB 数据底座。
- 向量检索:支持 HNSW、IVF、DiskANN 等索引算法及 SQ、PQ、RaBitQ 等量化技术,并结合自动重排兼顾检索性能、召回率与内存效率,支持十亿级向量数据的高并发查询。
- 全文检索:基于 Tantivy 实现 BM25 排序,支持多语言分词,并可通过 SQL 将向量与全文检索结果进行 RRF 融合,结合过滤和 JOIN 满足复杂查询需求。
- 图检索:支持Cypher 语法,采用原生图数据库遍历算法在 LDBC SNB(SF1)Benchmark 中,1-hop~5-hop 变长路径搜索 RT < 20 ms。
Agentic LakeCache:面向 Agent 的文件与对象数据统一底座
Agentic LakeCache 以 PolarDB for PostgreSQL 为元数据核心,将统一管理能力进一步扩展到文件、对象和模型产物。它可将任务级创建、分支和回收能力扩展到代码、文档、图片、模型产物和运行时文件,与 Agentic Database 共同构成双核心底座。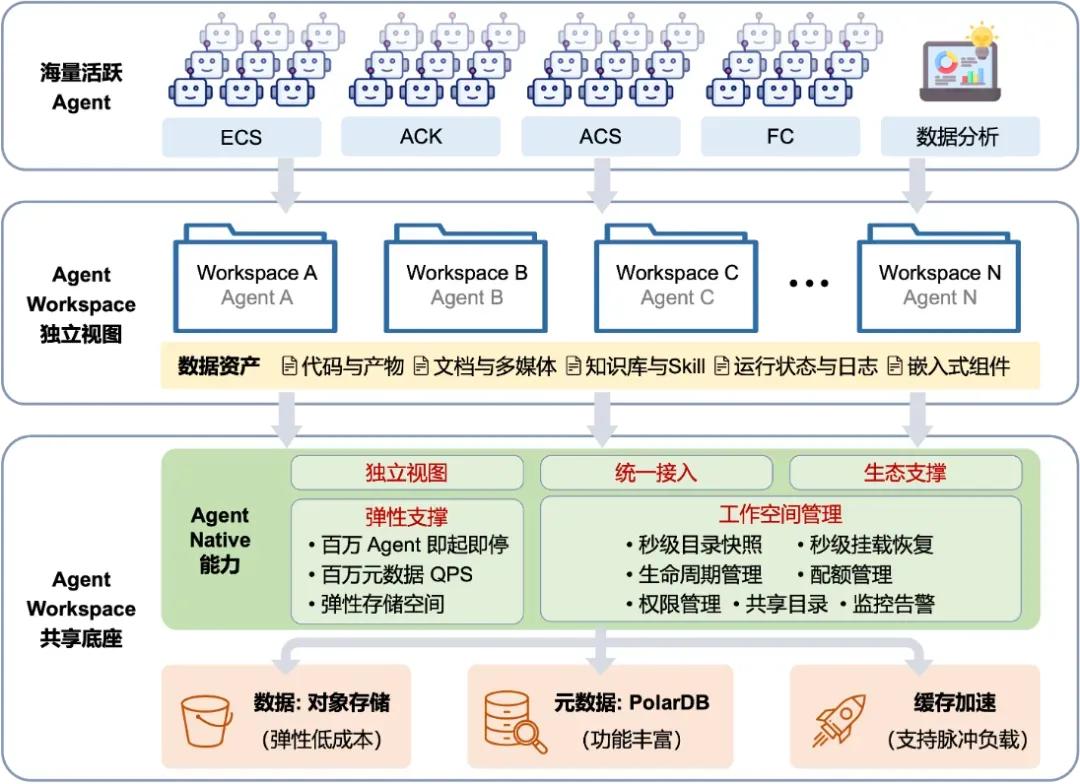
图 5|Agentic LakeCache:OSS、独立工作空间与近计算侧缓存
➡️ 统一访问:POSIX 与 S3 直达 OSSAgentic LakeCache 以 OSS 为低成本存储底座,提供 POSIX FS 和 S3 接口,使 Agent、Sandbox 和应用可以直接访问文件与对象数据,无需在数据库、文件系统和对象存储之间反复搬运。
➡️ 缓存:兼顾容量、成本与访问性能面向 Agent 高频读写与模型加载场景,Agentic LakeCache 通过 Mem、SSD 等近计算侧多级缓存加速热点数据,缓存未命中时透明回源 OSS,在海量数据低成本存储的同时保障访问性能。
➡️ 可分支工作空间:文件与数据库版本协同Agentic LakeCache 支持目录快照、挂载恢复和文件 Branch,并可与数据库 Branch 联合创建和回滚,使数据库、代码与文件保持同一任务版本。独立视图、配额、权限和监控能力,则支持海量 Agent 工作空间按任务创建、扩展和回收。
能力到场景:为不同 Agent 工作负载提供独立数据环境
智能研发:让代码与数据库同步演进。Coding Agent 修改代码时,往往还要调整表结构、初始化数据并执行测试。Agentic Database 可从同一基线为不同任务快速创建隔离 Branch,让各 Agent 独立验证;数据库 Branch 还可与代码版本、Sandbox 运行时组成组合检查点,实现同步回滚。对于运行在云原生 PolarDB PostgreSQL 上的生产业务,生产数据可按需同步至 Agentic Database 开展分支开发和测试,验证后的变更经审核再发布至生产环境,兼顾研发敏捷性与生产级性能、稳定性。
智能客服与机器人:按需启停的独立记忆库。企业可为不同客服 Agent 或具身机器人配置独立数据库,保存会话、服务记录、用户偏好、Memory 和 RAG 数据,形成清晰的数据边界。闲置时计算 Scale to Zero,数据持续保存在基于OSS的Agentic LakeCache;请求到来后再快速启动并恢复上下文,使资源成本与 Agent 的实际活跃时间匹配。
历史状态分析:在时间切片上安全推演。面对业务复盘、故障定位或策略评估,Agent 可从指定时间点创建只影响分支环境的数据库快照,与当前状态进行对比分析和推演。分析过程不触碰生产数据,多个方案可以并行执行,完成后按需保留结果或回收环境。
四、迈向 Agentic Native:PolarDB PostgreSQL Agentic Database 正式开启公测
从 Cloud Native 到 Agentic Native,PolarDB 正在将云原生时代积累的性能、可靠性与弹性能力,演进为面向 Agent 任务生命周期的数据基础设施,并通过同一套架构实现统一承载与治理。
目前,PolarDB PostgreSQL Agentic Database 已开启公测。开发者和企业用户可申请体验 MCP Server、数据库 Branching、弹性启停及 All-in-One PostgreSQL 等核心能力,探索 Coding Agent、数据分析 Agent 与 Agent 生成应用等场景。 而Agentic LakeCache 已正式上线,为 Agent 提供文件、对象数据与任务工作空间的统一管理能力。
同时,PolarDB PostgreSQL Agentic Database 与 PolarDB PostgreSQL Agentic Supabase 已上线 Qoder 插件市场,欢迎下载体验,在 Coding Agent 工作流中探索 PolarDB 面向 Agent 的数据基础设施能力。