对跨境电商商家而言,一件商品在店铺内的销售数据是结果,而它在海外社媒上是否已被达人穿着、拍摄、发布,往往是更早出现的信号。要把这个信号用于选品决策,商家需要一个明确的答案:这件商品究竟出现在哪些达人的哪些内容中。
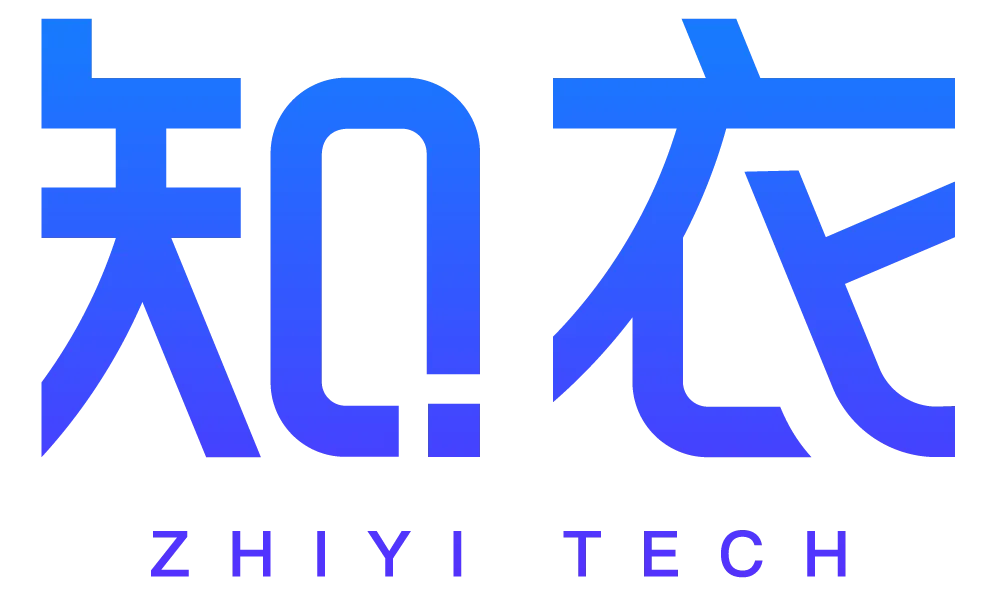
作为国内领先的时尚数据 AI 平台,知衣科技致力于推动 AI 与大数据技术在服装产业链的深度落地。公司围绕趋势发现、爆款挖掘与内容营销等核心场景,为服装企业提供全链路数智化解决方案,业务覆盖海内外,累计服务客户近万家,旗下拥有知衣、知款、抖衣、海外探款、FD+ 及知小衣等多元化数据智能 SaaS 与 AI 创新应用。
在面向跨境电商商家的服务中,知衣科技将上述需求定义为一项图像检索任务:把电商平台的商品图与海外知名社媒的达人图片分别转化为特征向量,通过批量相似度匹配建立两者的关联。方案的技术路径清晰,规模化落地则受制于检索环节的算力与成本。为此,知衣科技与阿里云大数据 AI 平台展开合作,将原有 Proxima 检索方案替换为 MaxCompute 提供的向量检索能力,在保留自研模型链路的前提下完成了检索环节的重构。
**一、业务诉求:从关键词检索到全量图像匹配
1.1 人工检索的覆盖面瓶颈**
在引入图像匹配能力之前,商家获取站外信息的主要方式是关键词检索加人工浏览:运营人员按品牌词、品类词在社媒平台逐条翻阅内容。这一方式的产出高度依赖人力投入,且覆盖范围由搜索结果决定——达人发布内容时若未提及品牌名称,相关内容便无法被发现;竞品监控的难度更高,商家往往无法预先确定检索词。海外达人内容池的规模在百万量级以上,人工抽样所能覆盖的比例十分有限。
1.2 图像匹配面临的三项工程挑战
图像主体定位。 达人发布的场景化图片中包含人物、背景与配饰,服装主体仅占画面的一部分;商品侧图片则多为白底图或模特图。两类图片直接计算相似度,结果易受非主体元素干扰。因此需先对两侧图片分别执行服装区域检测,裁剪出主体商品后再进入特征提取环节。
全量交叉匹配的算力压力。 单张图片的服装比对精度问题,知衣科技已通过自研 CV 模型解决。规模化落地的制约因素在检索侧:社媒侧博文覆盖多图,商品侧覆盖多个电商平台的主图与细节图,增量的商品需要和圈定达人的全量图片执行交叉比对。以一轮检索为例,商品侧约 1000 万条 512 维向量,需与约 200 万条社媒侧查询向量完成全量匹配。
检索成本决定业务覆盖边界。 受算力成本约束,含视频的内容目前仅提取首帧图像参与匹配。此类取舍在业务演进中将长期存在,检索环节的单位成本直接决定了可覆盖的内容池规模与数据更新频率。
三项挑战指向三个明确的技术诉求:一是具备承载全量批式向量检索能力的引擎;二是足够低的检索单位成本,以支撑天级全量重跑,避免在数据新鲜度与覆盖面之间取舍;三是能够与既有自研模型链路衔接,无需为迁移重写算法。
二、解决方案:MaxCompute 离线向量检索承接批量匹配
知衣科技与阿里云大数据 AI 平台共同梳理了数据处理链路,形成"自研模型负责理解、MaxCompute 负责检索"的分工。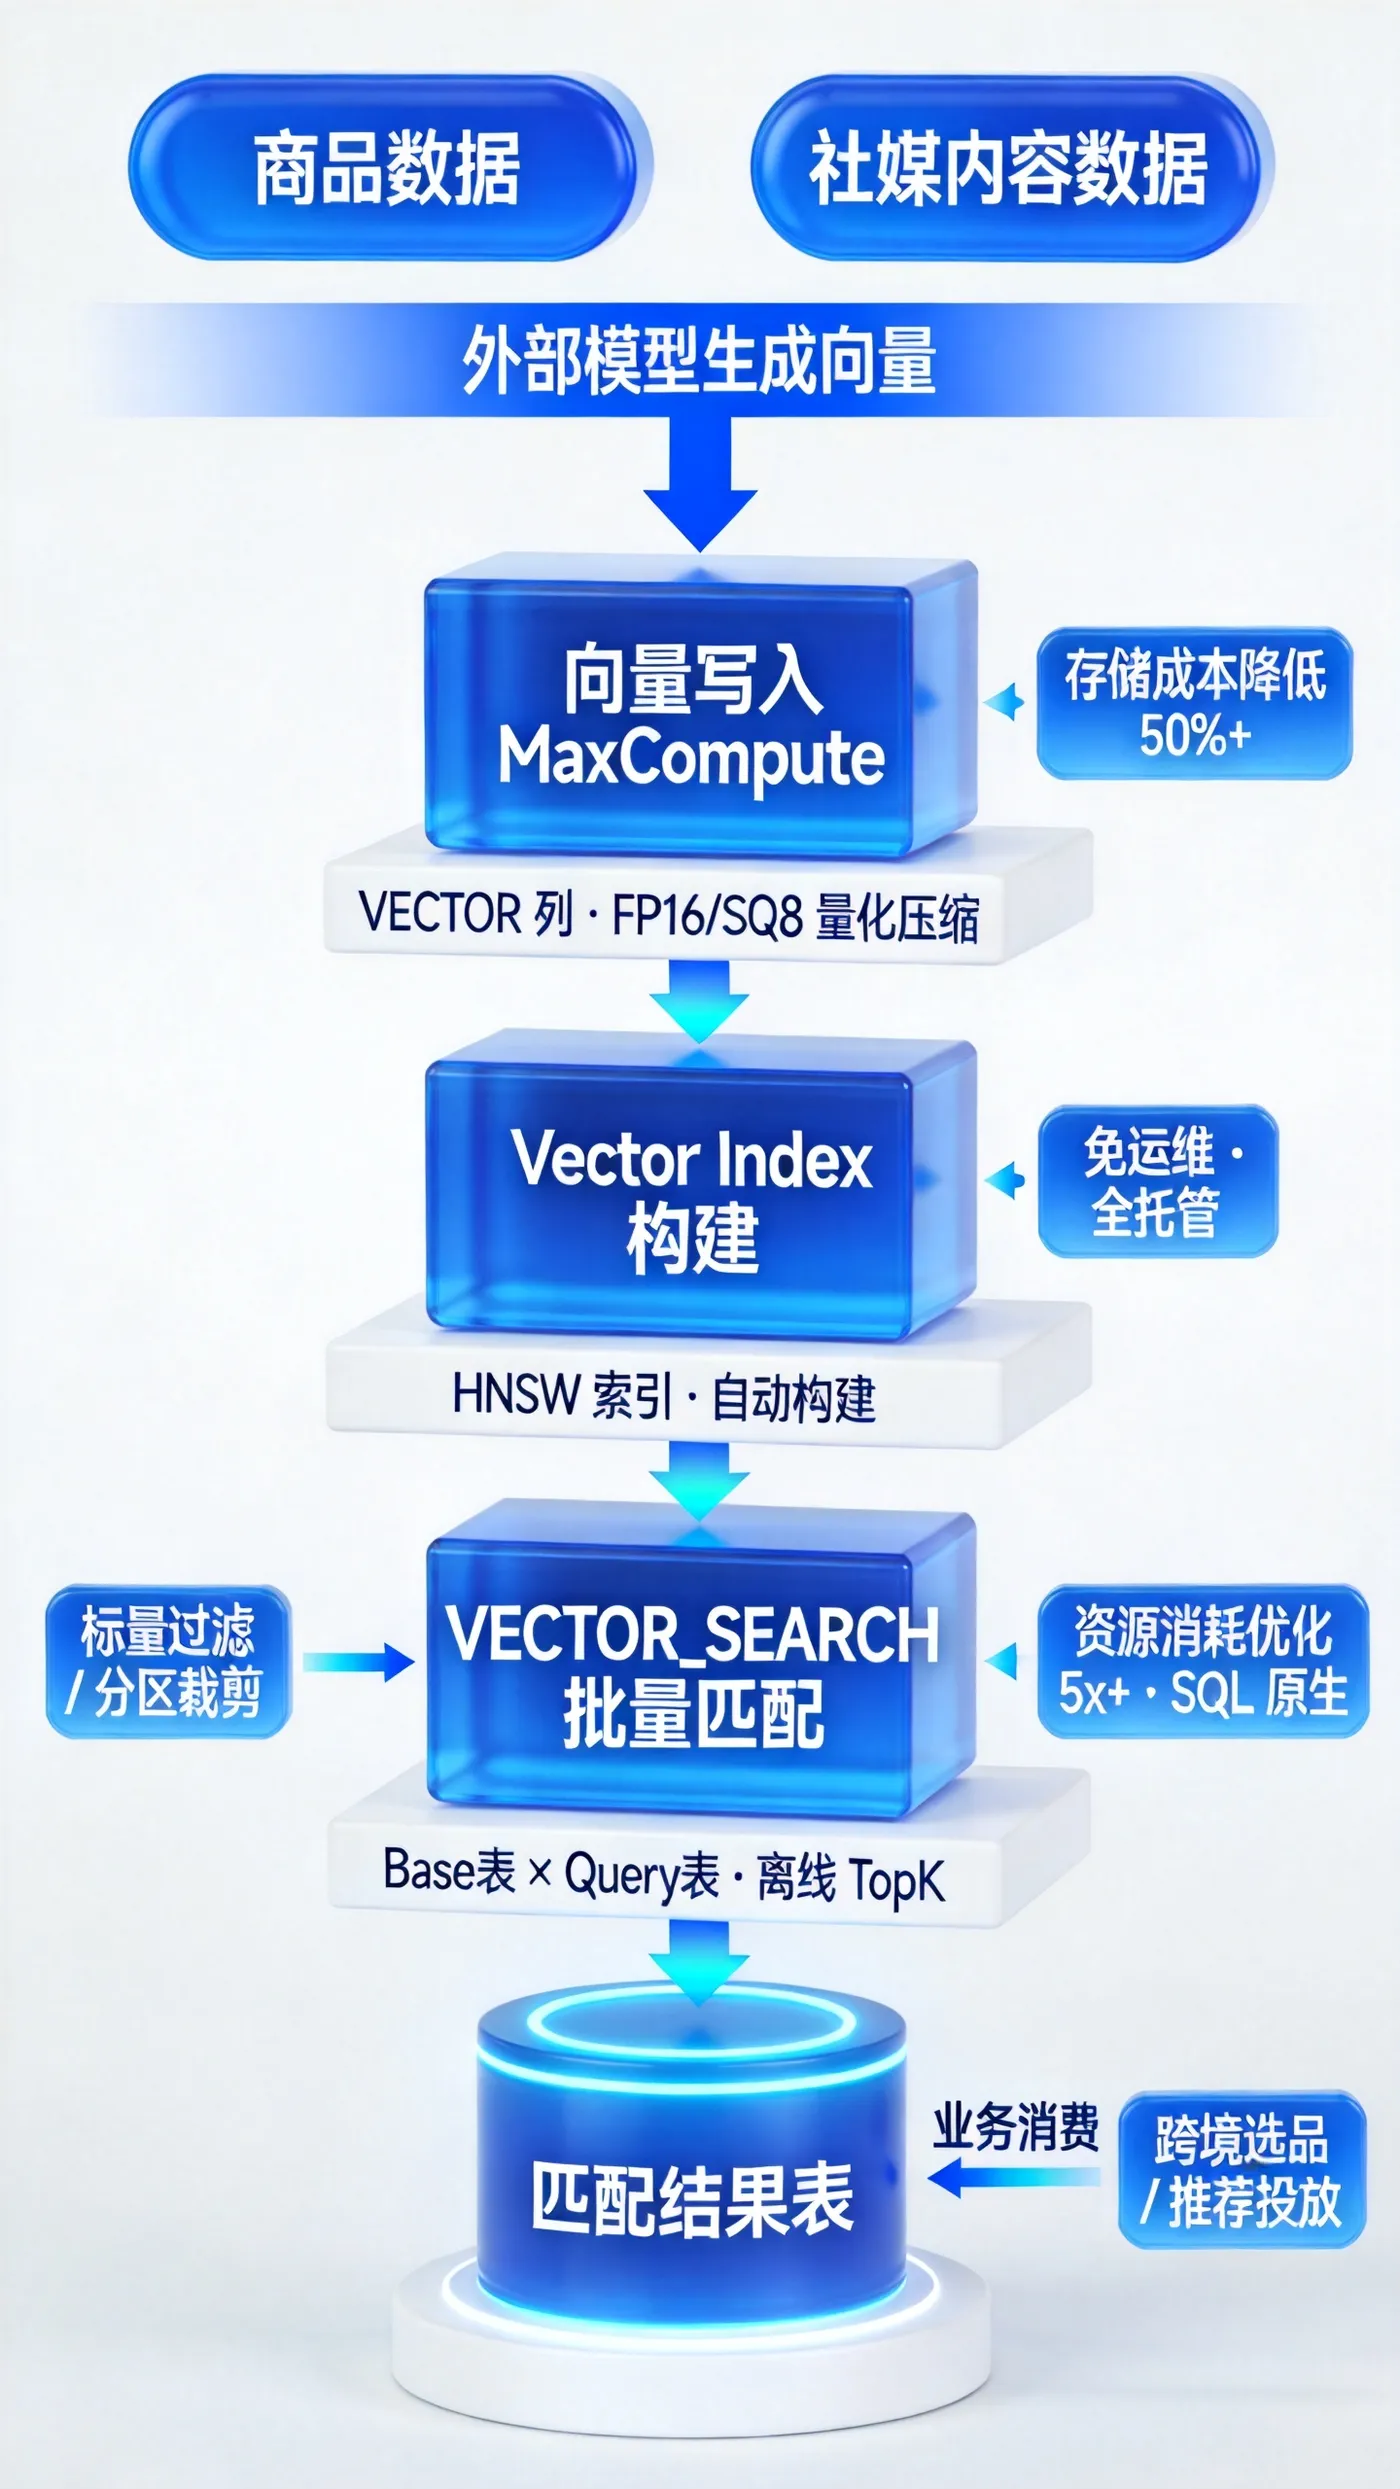
2.1 数据清洗与图像预处理
海外知名社媒平台的公开博文内容经过集中清洗后,社媒图片与商品图分别执行服装区域检测(detect),裁剪出主体商品区域,排除人物、背景与配饰对后续特征提取的干扰。
2.2 特征向量生成:保留自研模型资产
裁剪后的图像由知衣科技自研 CV 模型完成打标与特征向量提取,模型自主训练、自主部署,运行在 GPU 集群上,知衣科技在服装识别领域积累的模型资产与调优经验得以完整保留。
2.3 批量向量检索:迁移至 MaxCompute
商品向量与社媒向量的批量相似度匹配在 MaxCompute 上完成,覆盖向量存储、索引构建与全量批式检索计算三个环节。原方案基于 MaxCompute 提供的 Proxima 引擎构建,需自行管理索引与检索集群,运维成本较高。迁移至新版向量检索后,上述环节由平台统一承接:向量数据本身已在 MaxCompute 内无需跨平台搬迁,只需写入新建的 VECTOR 类型列;外部模型生成 Embedding 的上游链路完全不变。检索语句切换为标准 VECTOR_SEARCH SQL 函数,索引由系统自动构建维护。知衣科技从验证到生产上线约两周完成切换,不再维护独立的向量检索基础设施,相同数据规模下资源消耗显著下降。
此外,博文正文中的品牌提及(如 @品牌名)作为辅助信号,用于确认部分特征明显的带货内容,匹配判断的主体仍为图像相似度。
三、应用场景:为选品决策补充站外依据
新的检索链路上线后,商家在知衣科技的产品中可以直接查看商品与达人内容的关联结果:自有商品出现在哪些达人的哪些内容中,竞品商品的站外曝光情况如何,热销商品背后是否存在 KOL 内容支撑。
这一信息进入选品环节后改变了判断依据。此前商家评估一个款式主要依赖站内销售数据,站外热度只能通过零散截图佐证;现在,一个款式是否已在海外社媒获得达人自发传播,成为可持续观测的指标。对备货决策而言,"站内数据良好"与"站内数据良好且站外已有达人内容"是两种不同强度的信号。
四、合作成效
在商品侧约 1000 万条、社媒侧约 200 万条 512 维向量的相同检索规模下,知衣科技对 MaxCompute 向量检索与原 Proxima 方案(历史版本)的资源消耗进行了对比。以 Proxima 最近 14 次运行的均值为基准,MaxCompute 离线向量检索的 CPU 消耗下降约 73%,内存消耗下降约 93%。
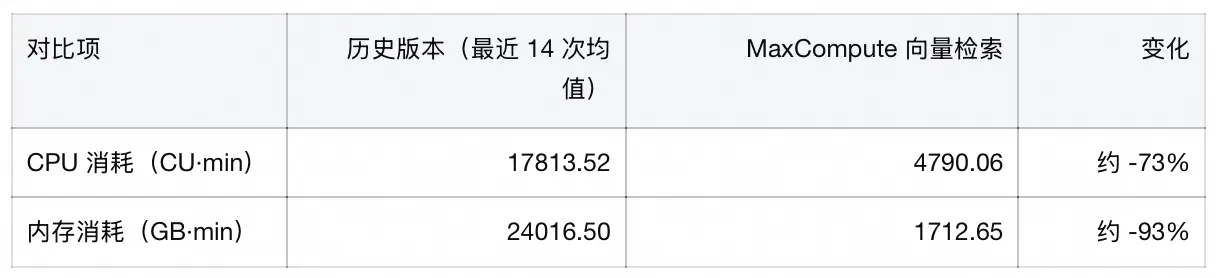
资源开销的大幅下降直接作用于业务:在相同预算下,同一轮全量匹配可以覆盖更大的内容池,或以更高频率重跑,使商家看到的商品-达人关联结果保持在更新的状态。检索环节不再是内容池规模与数据新鲜度之间的取舍点。
对于这次合作解决的核心问题,知衣科技技术团队有更直接的感悟:
"商品图与海外社媒内容的全量匹配,是我们很早就想做的事,真正的瓶颈在检索成本——原有方案下,数据规模和算力成本只能二选一。与阿里云大数据平台 的这次合作,把大规模批量向量检索交给了平台,让我们能把精力集中在服装款式特征向量的提取能力上。双方团队围绕索引构建与批式检索做了多轮联合调优,CPU 与内存消耗分别下降约 73% 和 93%,检索环节的成本压力得到明显缓解。接下来,我们希望把这套能力延伸到更多电商平台和更大规模的社媒图片,让站外真实热度成为跨境选品的常规指标。"
—— 知衣科技技术负责人