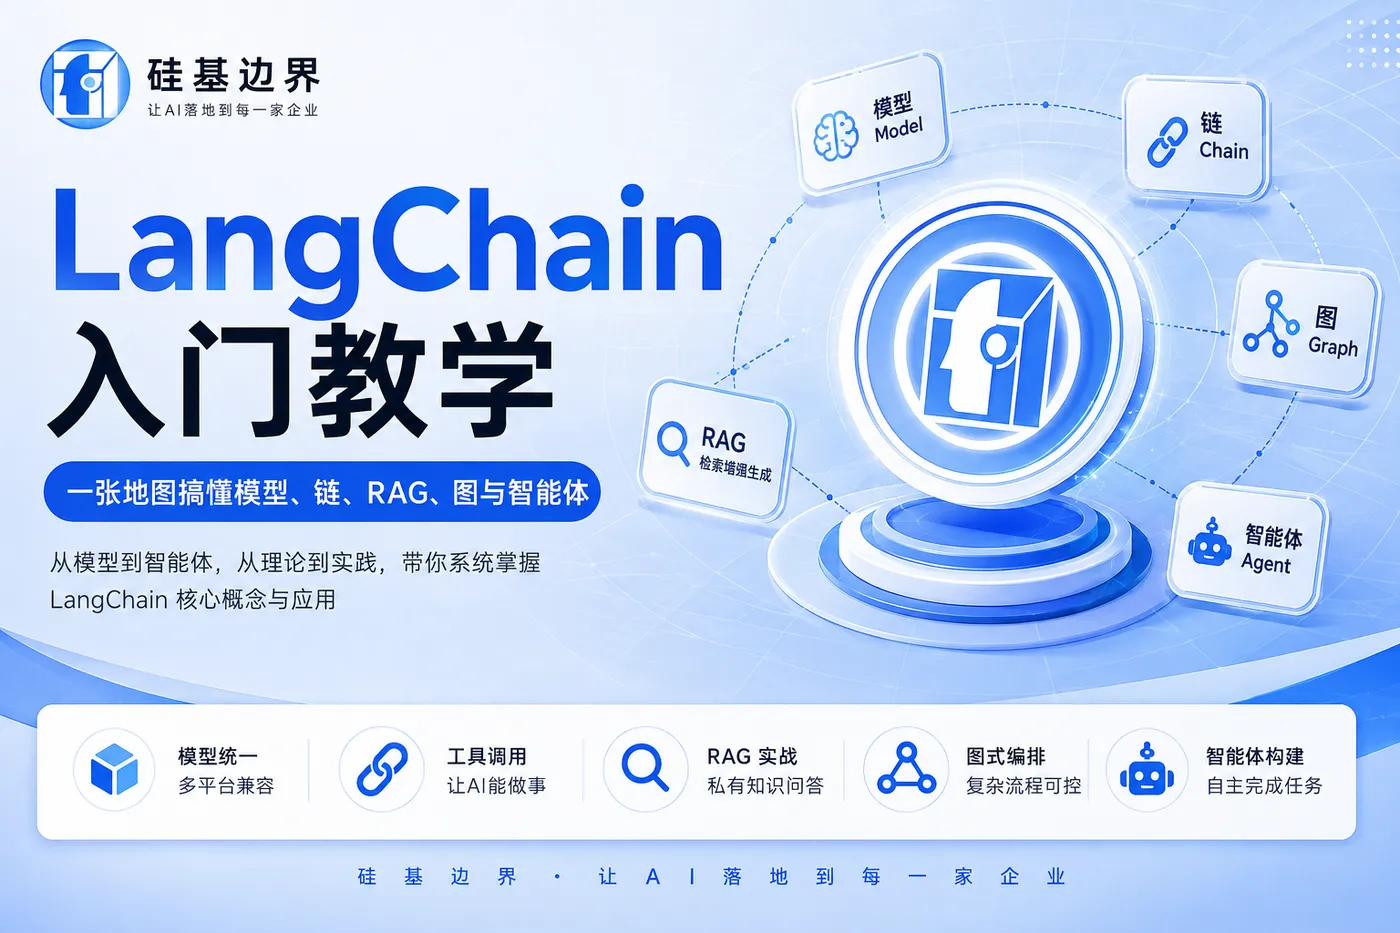
LangChain 入门教学:一张地图搞懂模型、链、RAG、图与智能体
这是一篇面向"想系统学 LangChain 但被各种名词绕晕"的开发者的教学文章。我们不从某段代码开始,而是先建立一张认知地图:LangChain 到底有哪些零件、各自解决什么问题、什么时候该用哪个。文中代码均为示意代码(教学用途),聚焦理解,不追求完整可跑。
一、先建立地图,再学工具
如果你搜过 LangChain 的教程,大概率会陷入混乱:有人说用 Chain,有人说用 LangGraph,有人说 create_react_agent,还有人说 AgentExecutor——这些其实都是历史遗留造成的"版本差"。
好消息是,2026 年的今天,官方路线已经非常清晰:
- LangChain 1.0 是核心框架(模型抽象、提示词、工具、RAG 组件);
- LangGraph 1.0 是官方编排运行时(把流程变成图,支持持久化、人工介入、流式);
- 智能体的标准入口是
create_agent(来自langchain.agents),旧的AgentExecutor已废弃、create_react_agent已不再推荐; - LangSmith 是官方可观测与评测平台(追踪每一步、评测智能体轨迹)。
换句话说:别再看老教程了,认准"LangChain 1.0 + LangGraph + create_agent"这条主线,剩下的都是细节。
二、一张图看懂 LangChain 生态
flowchart TD
    subgraph LC[LangChain 1.0 核心包]
        CM[ChatModel<br/>统一模型接口<br/>init_chat_model]
        PR[Prompt 与输出解析]
        TL[Tool 工具系统<br/>@tool 装饰器]
        RAG[RAG 组件<br/>Loader / Splitter / Embedding / Retriever]
        LCEL[LCEL 声明式管道]
    end
    subgraph LG[LangGraph 1.0]
        SG[StateGraph<br/>节点 / 边 / 条件边]
        AG[create_agent<br/>智能体工厂 + 中间件]
        CK[Checkpointer<br/>持久化 / thread_id]
    end
    subgraph INT[集成包]
        O[langchain-openai]
        AN[langchain-anthropic]
        GG[langchain-google-genai]
        CM2[langchain-community<br/>文档加载器 / 向量库]
    end
    subgraph LS[LangSmith]
        TR[追踪 / 评测 / 数据集]
    end
    INT --> CM
    LC --> AG
    LG --> LS
学习顺序建议:ChatModel → Prompt → Tool → RAG → LCEL → LangGraph → create_agent。下面按这个顺序一课一课讲。
第一课:ChatModel——所有应用的起点
一切 AI 应用的第一步都是"调一个模型"。LangChain 的价值之一,就是把各家模型的差异抹平:你写的业务代码不需要知道背后是 OpenAI、Anthropic、谷歌还是国产模型。
from langchain.chat_models import init_chat_model

# 统一接口,模型标识格式:provider:model
model = init_chat_model("openai:gpt-4o")          # OpenAI
model = init_chat_model("claude-sonnet-4-6")      # Anthropic
model = init_chat_model("google_genai:gemini-2.5-flash-lite")  # 谷歌
model = init_chat_model("ollama:llama3")          # 本地模型

# 三种基本调用方式
resp = model.invoke("LangChain 是什么?")          # 一次调用
for chunk in model.stream("讲个故事"):            # 流式输出
    print(chunk.text, end="")
results = model.batch(["问题1", "问题2"])          # 批量调用
聊天模型以"消息"为单位,记住这四种消息类型,后面所有概念都建立在它们之上:
| 消息类型 | 含义 |
|---|---|
SystemMessage |
系统角色设定(你是谁、什么规矩) |
HumanMessage |
用户输入 |
AIMessage |
模型回复(可能含工具调用请求 tool_calls) |
ToolMessage |
工具执行结果,回填给模型 |
第二课:Prompt 与工具——给模型“说明书”和“双手”
Prompt 模板让提示词可复用、可参数化:
from langchain_core.prompts import ChatPromptTemplate

prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一位{role}专家,回答问题要简洁。"),
    ("user", "{question}"),
])
final_prompt = prompt.invoke({
   "role": "Python", "question": "什么是装饰器?"})
工具让模型从"只会说"变成"能做事"。定义一个工具,本质上就是写一个带文档字符串的普通函数:
from langchain.tools import tool

@tool
def add(a: int, b: int) -> int:
    """计算两个整数的和。"""
    return a + b

# 把工具"绑定"到模型:模型会判断何时需要调用它
model_with_tools = model.bind_tools([add])
resp = model_with_tools.invoke("23 + 45 等于多少?")
for tc in resp.tool_calls:
    print(tc["name"], tc["args"])   # -> add {"a": 23, "b": 45}
注意一个关键点:工具描述写得好不好,直接决定模型会不会用、什么时候用——它相当于给模型的"产品说明书"。
第三课:RAG——让模型“知道”你的私有数据
模型训练完就定格了,不知道你公司的文档。RAG(检索增强生成)的思路很简单:先把你的文档切成块、向量化、存进向量库;用户提问时,先检索出相关片段,再连同问题一起交给模型。
索引阶段(一次性的):
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import FAISS

# 1. 加载文档
docs = TextLoader("product_manual.txt").load()

# 2. 切块(块大小与重叠率是 RAG 效果的第一影响因素)
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
chunks = splitter.split_documents(docs)

# 3. 向量化 + 存入向量库
vector_store = FAISS.from_documents(chunks, OpenAIEmbeddings())
查询阶段(每次问答):
retriever = vector_store.as_retriever(search_kwargs={
   "k": 4})
relevant_docs = retriever.invoke("怎么给产品充值?")   # 拿到最相关的 4 个片段
# 然后把片段拼进提示词,交给模型生成答案
到这里你会发现:RAG 只是"检索"和"生成"的组合。但生产级 RAG 远不止这三行——问题重写、混合检索、精排、相关性校验、来源引用,每一步都有学问(想深入可以看本系列的《企业知识库实战》篇)。
第四课:LCEL——把零件“管道”式组合
当你有了模型、提示词、输出解析器,怎么把它们拼起来?LCEL(LangChain 表达式语言)用 | 像管道一样连接:
from langchain_core.output_parsers import StrOutputParser

chain = prompt | model | StrOutputParser()   # 提示词 → 模型 → 字符串解析
result = chain.invoke({
   "role": "Python", "question": "什么是 GIL?"})
LCEL 适合"顺序固定的简单流程":输入进去、一路到底、没有分支。一旦流程有分支、有循环、有重试,就该升级到图。
第五课:LangGraph——把流程变成一张图
LangGraph 的核心心智模型只有三样东西:State(共享状态)、Node(节点)、Edge(边)。
- State:一份贯穿全程的共享数据(通常是消息列表);
- Node:一个步骤(调模型、跑工具、写数据库……),读 State、改 State;
- Edge:控制流,还可以是条件边——"模型要调工具就走工具节点,否则直接结束"。
from langgraph.graph import StateGraph, START, END

builder = StateGraph(MyState)            # 定义图,绑定状态类型
builder.add_node("call_model", call_model_node)
builder.add_node("run_tool", run_tool_node)
builder.add_edge(START, "call_model")
builder.add_conditional_edges(           # 条件边:根据模型输出决定走向
    "call_model",
    needs_tool,                          # 判断函数,返回下一节点名
    {
   "tool": "run_tool", "end": END},
)
builder.add_edge("run_tool", "call_model")   # 工具结果回填,形成循环
graph = builder.compile()
那"一个模型反复调工具直到完成任务"的智能体呢?——这正是 LangGraph 最经典的一个图,而官方已经帮你把它封装好了,那就是下一课的 create_agent。
第六课:智能体——create_agent 与中间件
到了 2026 年,建智能体的标准姿势就是一行 create_agent:
from langchain.agents import create_agent
from langchain.tools import tool

@tool
def get_weather(city: str) -> str:
    """返回指定城市的天气。"""
    return f"{city} 晴,31℃"

agent = create_agent(
    model="openai:gpt-4o",
    tools=[get_weather],
    system_prompt="你是天气助手,要用工具查询,不要瞎猜。",
)
result = agent.invoke({
   "messages": [{
   "role": "user", "content": "北京天气?"}]})
print(result["messages"][-1].content)
这一行背后发生的事:模型节点 ↔ 工具节点 + 条件边 + 循环,也就是第七课那张图,只是你不用手画了。再叠加两个关键能力:
- 持久化(记忆):传一个
checkpointer+ 每次带thread_id,多轮对话就自动记住了:
from langgraph.checkpoint.memory import InMemorySaver

agent = create_agent(model="openai:gpt-4o", tools=[...],
                     checkpointer=InMemorySaver())
agent.invoke({
   "messages": [...]}, config={
   "configurable": {
   "thread_id": "conv-001"}})
- 中间件(自定义扩展点):限流、历史裁剪、Token 预算、人工审批、重试兜底……这些"每次都必须、又不能靠提示词保证"的生产级逻辑,都通过
AgentMiddleware挂在智能体循环上,互不耦合、可插拔(本系列第一篇《用 LangChain 新 Agent API 与中间件机制,构建生产级 AI 智能体》详细讲过)。
第七课:什么时候用 Chain、图还是智能体?
这是新手最容易纠结的问题,一张表说清楚:
| 场景 | 选型 | 原因 |
|---|---|---|
| 固定流程,一路到底(总结、翻译、格式化) | LCEL Chain | 简单直接,没有分支 |
| 有分支、循环、人工介入、可恢复的流程 | LangGraph 自定义图 | 状态与控制流是显式的 |
| "让模型自主决定调用哪些工具完成任务" | create_agent | 官方标准,内置循环与中间件 |
| 长代码任务、长文档研究 | create_deep_agent | 官方预置的深度智能体栈 |
一句话记忆:LCEL 是"流水线",LangGraph 是"流程图",create_agent 是"官方预装好的那张智能体流程图"。
第八课:给新手的避坑清单
- 别看老教程:凡是教你
AgentExecutor、create_react_agent、ConversationBufferMemory的旧文章,API 多半已废弃,认准create_agent+checkpointer。 - 按需安装:
pip install langchain "langchain[openai]",别一把梭装全家桶;集成包按需加。 - 工具描述即说明书:工具 docstring 写得好,模型才用得准;写不好,模型会瞎调用或不用。
- RAG 效果瓶颈常在切分:chunk_size / overlap 不是拍脑袋定的,要按文档类型试。
- 别把所有逻辑塞进提示词:限流、鉴权、PII 过滤这类确定性逻辑,用中间件;提示词是软约束。
- 从第一天就接观测:LangSmith(或自建日志)记录每次模型调用与工具调用,出问题才有得查。
- 模型切换是"换字符串":
model="provider:model"改一行就行——这正是抽象层给你的红利。
结语
LangChain 最大的价值不是"少写代码",而是给了你一套稳定、可组合、可观测的抽象:模型统一接口、工具即函数、流程即图、智能体即工厂函数。把这套心智模型装进脑子,再看任何具体 API,都不会迷路。
学习路径建议:先用 create_agent 做出第一个能调工具的智能体(半小时),再用 init_chat_model + LCEL 做一条简单 Chain,然后上手 LangGraph 手写一个多节点流程,最后回头研究中间件与生产化。先跑通,再拆开,最后做深——这是学任何框架都通用的顺序。
📖 完整技术文档:
docs.gjbjai.com/docs/intro/
官网链接:https://gjbjai.com/
作者注:本文为「硅基边界」零代码构建平台(https://ai.gjbjai.com/)旗下 Silicon-AI 实战复盘系列的教学基础篇。文中代码均为示意代码(教学用途),非任何项目真实源码。系列其他篇目:《用 LangChain 新 Agent API 与中间件机制,构建生产级 AI 智能体》《企业知识库实战:RAG 全链路设计》,欢迎联动阅读。