大家好,我是程序员天天困。
想象一个很常见的场景:一个电商项目,商品详情页接口 RT 平时稳在 80ms,大促一到飙到 3s,数据库连接池被打满,Nginx 后面一排 502。团队第一反应通常是加机器——加了,效果撑不过半小时,因为根因是所有请求都在回源查库。这时候就该 Varnish Cache 这类 HTTP 缓存出场了。
这种情况下真正救场的往往不是加机器,而是在源站前加一层缓存。Varnish Cache 就是专门干这件事的工具——把商品详情这种热点页面整个拦住,命中率跑到 90% 之后,后端 DB 的 QPS 能直接掉一个数量级。这篇我想把它从头到尾讲清楚:是什么、凭什么快、VCL 这套语言怎么读怎么写、命中率上不去该查哪里。不堆术语,能看懂就能动手。点个收藏,我们开始。
一、Varnish Cache 到底是什么
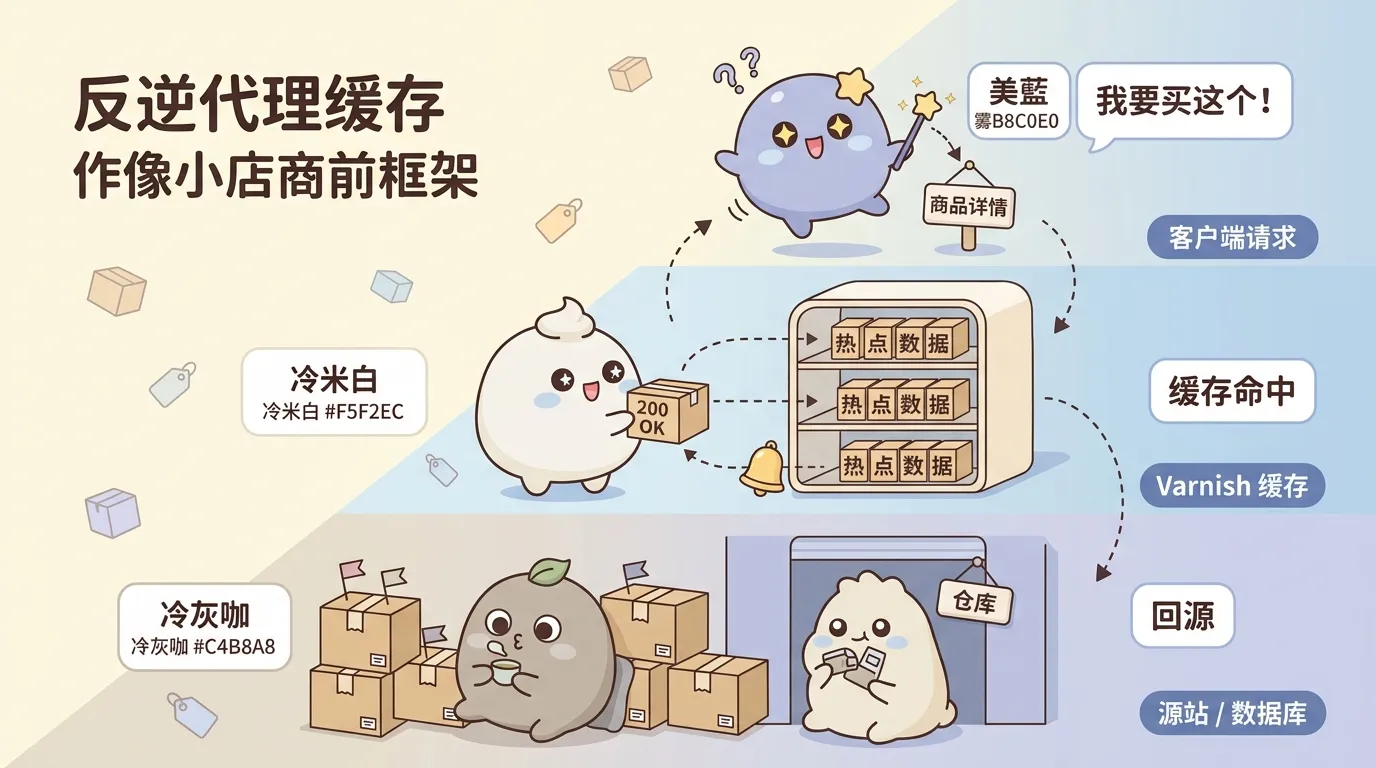
Varnish Cache:一款开源的 HTTP 反向代理缓存(reverse proxy cache),用 C 写成,架在源站服务器前面,把可缓存的 HTTP 响应存在内存或磁盘里,后续相同请求直接由它返回,不用再回源。你可以把它理解成小卖部的前台货架——热门商品摆在货架上,顾客要直接拿,不用每次都跑去仓库翻。
注意它的定位是反向代理:代理的是服务端,对客户端来说它就是源站;这跟 VPN 那种替客户端上网的正向代理正好相反。它不是 Web 服务器,不是应用框架,就专门干缓存这一件事,而且干得很极端。维基百科、纽约时报、Vimeo 这些高流量站点都在生产环境用它。
二、它凭什么能这么快
Varnish 的快,不是因为 C 语言写得快,而是因为它把"缓存"单独抽象成了一条专门的流水线,每个环节都为命中服务。
1)进程模型:Manager 盯梢,Child 干活
Varnish 跑起来是两个进程:Manager 进程负责读取配置、编译 VCL、监控子进程;真正处理请求的是 Child(也叫 Cacher)进程,内部是一堆线程池——Acceptor 线程接连接,Worker 线程处理请求,Expirer 线程清理过期对象,Backend 线程跟源站通信。多线程 + 线程池的设计让它能把多核吃满,而不是卡在单核上。
2)VCL 不是每次请求解析,是预先编译成 C
这是 Varnish 最特别的一点。你写的 VCL 配置不会在每个请求里被解释执行,而是在加载时先翻译成 C 代码,再调用 gcc 编成 .so 动态库加载进内存。这相当于给前台写好一本接待手册,而不是每来一个顾客就打电话问经理。改配置也不用重启进程,vcl.load + vcl.use 秒级热加载,语法错了直接拒绝切换,老配置继续跑。
3)日志写共享内存,不写磁盘
Varnish 把请求日志写在一块共享内存(VSL)里,而不是逐条 fwrite 到磁盘文件,日志开销极低。varnishstat、varnishlog 这些工具再从这块内存里读数据。这也是它在高 QPS 下还敢默认记录每个请求细节的底气。
4)存储引擎可插拔
malloc:纯内存存储,最快,重启就没,是大多数高并发场景的首选;file:mmap 一个文件当缓存,容量可以比内存大,性能介于内存和磁盘之间。
缓存这东西本来就是可重建的,丢了下回源站拿就是了。真要"掉电不丢"的持久化,那是业务数据库该操心的事,别压在缓存层上。
三、VCL 状态机:一个请求的一生
VCL 不是一份静态配置,而是一组在请求不同阶段被回调的钩子函数。
VCL(Varnish Configuration Language):Varnish 的领域特定语言(DSL),用 sub vcl_xxx 子例程定义请求在各个阶段的行为,通过 return(动作) 决定下一步走向。你可以把它理解成给快递分拣线写的工位规则——每个工位干自己的活,return() 就是分拣口那个拨杆,往哪拨走哪条道。
一个请求在 Varnish 里主要经过这些工位:
| 子例程 | 什么时候触发 | 你常在这里干什么 | 常见 return |
|---|---|---|---|
vcl_recv |
请求刚到、解析完 | 判断要不要缓存、选哪个后端、删 Cookie | hash / pass / purge |
vcl_hash |
生成缓存键 | 自定义缓存 key,比如忽略无关参数 | hash |
vcl_hit |
查到缓存对象 | 命中后改响应头 | deliver / restart |
vcl_miss |
没查到缓存 | 决定要不要回源 | fetch / pass |
vcl_backend_fetch |
发往后端之前 | 改发给源站的请求头 | fetch |
vcl_backend_response |
后端响应回来 | 设 TTL、决定是否缓存、剔除 Set-Cookie | deliver / abandon |
vcl_deliver |
交给客户端之前 | 加 X-Cache: HIT 这类调试头 |
deliver |
vcl_recv 是大门口的安检,决定这个请求走缓存通道还是直接放行;vcl_hash 负责贴单号;vcl_hit/vcl_miss 是查货架;vcl_backend_response 是货到了检查值不值得上架;vcl_deliver 是最后交到客户手上。理解了这条线,VCL 就不吓人了。
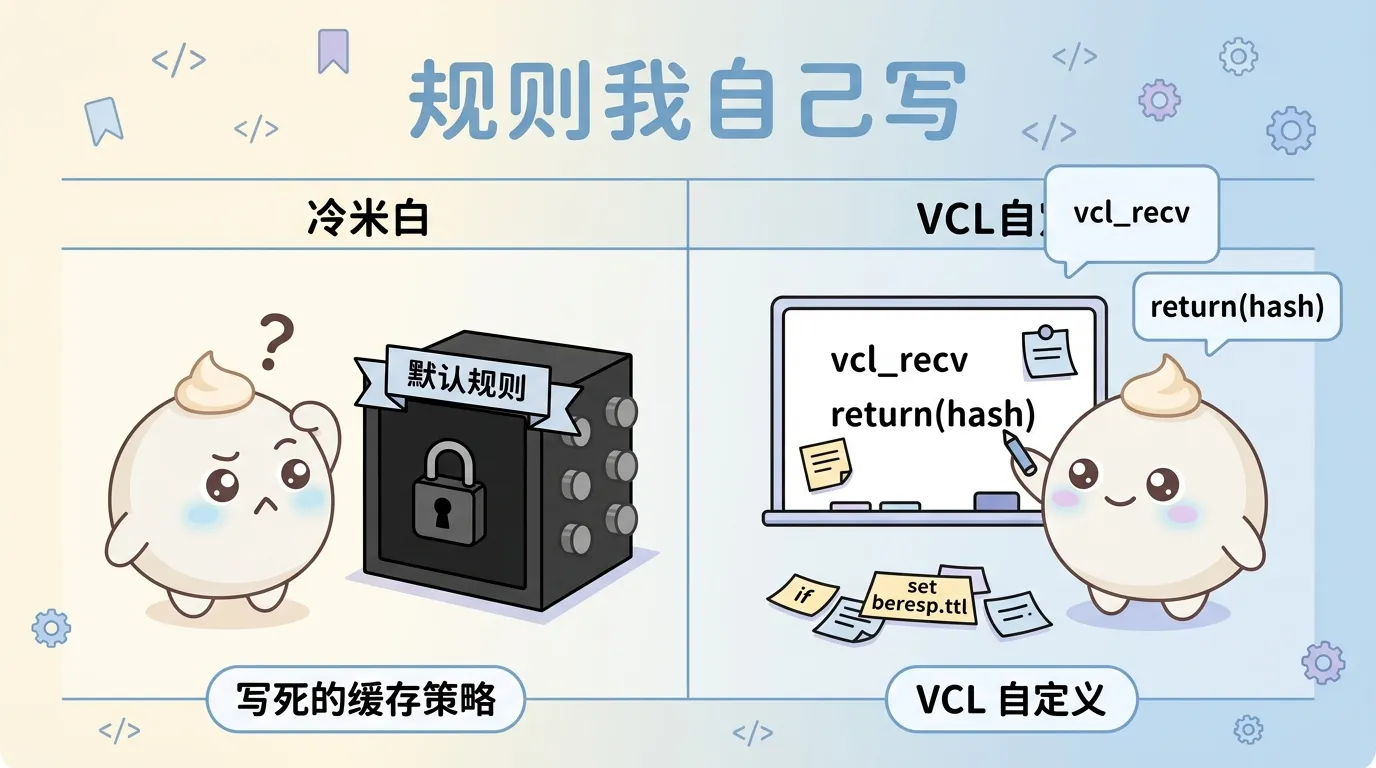
可能有人会问:VCL 语法写错了会不会把线上搞挂?
不会。Varnish 加载 VCL 时会先编译,编译失败直接报错并拒绝切换,线上跑的还是老配置。这一点比改完配置直接 reload、写错了就起不来要让人安心不少。
四、VCL 配置实战:从最小可用到 Grace 兜底
最小可用的 VCL 其实就两块:定义后端、写规则。下面示例基于 VCL 4.1 语法(Varnish 4.0 及以上,2026 年 8 月仍在维护的 7.x 系列通用),具体指令请以你所用版本的官方文档为准。
1)最小配置
vcl 4.1;

backend default {
    .host = "127.0.0.1";
    .port = "8080";
}
就这几行,Varnish 就能跑起来,其余行为走内置 VCL 的默认逻辑:缓存 GET/HEAD 的安全响应,带 Cookie 的不缓存,等等。
2)静态资源缓存久一点,并清掉 Cookie
Cookie 是缓存命中率的第一杀手——Varnish 默认认为带 Cookie 的请求和响应是私有的,不缓存。静态资源根本不需要 Cookie,主动清掉:
sub vcl_recv {
    if (req.url ~ "\.(jpg|jpeg|png|gif|css|js|woff2?)$") {
        unset req.http.Cookie;
        return(hash);
    }
}

sub vcl_backend_response {
    if (bereq.url ~ "\.(jpg|jpeg|png|gif|css|js|woff2?)$") {
        unset beresp.http.Set-Cookie;
        set beresp.ttl = 7d;
    }
}
req 是客户端请求对象,bereq 是发给后端的请求对象,beresp 是后端返回的响应对象——这三个变量别搞混,是写 VCL 最容易出错的地方。
3)Grace 模式:后端挂了也能用旧缓存顶一阵
Grace(优雅模式):Varnish 在缓存对象过期后仍保留一段时间(由 beresp.grace 控制),当后端不健康或正在后台异步回源时,先把这份"过期但还能用"的内容交给客户端的机制。
sub vcl_backend_response {
    set beresp.ttl = 1h;
    set beresp.grace = 6h;
}
这功能平时不起眼,后端发版重启那几分钟,它就是救命稻草——用户看到的是稍旧的页面,而不是 502。
改完用 varnishadm 热加载,不用重启:
varnishadm vcl.load myconf /etc/varnish/default.vcl
varnishadm vcl.use myconf
五、Varnish vs Nginx vs Squid:到底怎么选
选型不是选"谁最强",是选"谁更匹配你的瓶颈"。
| 维度 | Varnish Cache | Nginx(proxy_cache) | Squid |
|---|---|---|---|
| 定位 | 专用 HTTP 缓存 | Web 服务器/反向代理附带缓存 | 老牌正向/反向代理缓存 |
| 多核并发 | 强,多线程流水线 | 强,事件驱动 | 单核瓶颈较明显 |
| 策略灵活度 | 极高,VCL 可编程 | 中等,指令式配置 | 较高,但配置语法古老 |
| 缓存性能 | 极高,专为缓存优化 | 良好 | 一般 |
| HTTPS 终止 | 原生不支持,需前置 Nginx/Hitch | 原生支持 | 支持 |
| 持久化 | 弱,默认内存,重启即失 | 支持文件缓存 | 支持 |
| 学习成本 | VCL 有门槛 | 低 | 中高 |
| 适合场景 | 高并发热点内容/API 缓存 | 中小规模一体化部署 | 正向代理、传统缓存场景 |
Varnish 还有个 Nginx 很难比的能力:ESI(Edge Side Includes,边缘侧包含)。它允许在一个页面里埋 <esi:include src="..."> 片段标签,Varnish 会把每个片段按各自的 TTL 单独缓存,再拼装成完整页面返回。要用得在配置里开 set beresp.do_esi = true;,不开的话标签会原样发给浏览器。遇到"页头是登录态千人千面、商品主体可以缓存一分钟"这种页面,ESI 能让你只缓存能缓存的部分,而不用整页放弃。Nginx 靠第三方模块,支持有限。
可能有人会问:Varnish 不支持 HTTPS,那线上怎么用?
标准解法是前置一层 Nginx 或 Varnish 官方的 Hitch 做 TLS 终止:客户端 HTTPS 先到 Nginx/Hitch 解密成 HTTP,再转给 Varnish,Varnish 回源走 HTTP 或另一层内网 TLS。别指望 Varnish 自己终止 HTTPS,它从设计上就没打算干这事。
我的判断是:如果瓶颈就是缓存命中率和吞吐,且你愿意为 VCL 付学习成本,Varnish 在这个细分场景里目前没有对手;如果就一个小站、HTTPS 也想一锅端,Nginx 自带的 proxy_cache 完全够用,别为了用 Varnish 而用 Varnish。
六、命中率上不去的几个坑
命中率低,99% 不是 Varnish 的问题,是响应头和 Cookie 在拖后腿。
1)Cookie 没清干净:前端请求带 Cookie、后端响应带 Set-Cookie,都会让 Varnish 绕开缓存。静态资源、可公开的接口在 vcl_recv 和 vcl_backend_response 两头都要 unset。
2)Cache-Control 头打架:源站返回了 Cache-Control: no-store、private,或者带了 Set-Cookie,Varnish 默认就不会缓存这个响应(注意 no-cache 不是不缓存,而是"每次用前都要回源校验一次",命中率照样上不去)。要么改源站,要么在 vcl_backend_response 里按路径强行 set beresp.ttl 并清掉矛盾的头。
3)Vary 头滥用:Vary: User-Agent 会让每一种浏览器 UA 各存一份缓存,缓存体积膨胀、命中率暴跌。除非真的按 UA 返回不同内容,否则去掉它。
4)URL 带随机参数:?utm_xxx、时间戳、防缓存随机数会让每个 URL 都是新 key。在 vcl_hash 之前归一化 URL,把无关参数剔掉:
sub vcl_recv {
    # 去掉 utm_xxx=yyy 及其值,避免每个渠道一个缓存 key
    set req.url = regsuball(req.url, "utm_[^&]+&?", "");
    set req.url = regsub(req.url, "[?&]+$", "");
}
5)POST 请求:Varnish 默认不缓存 POST,这是对的,别硬改。登录后的个性化内容本来就不该在这一层缓存,该上 Redis 上 Redis。
排查时别上来就乱调 TTL,先用工具看清楚:
varnishstat   # 看全局命中/未命中比例
varnishlog -g request -q 'ReqURL eq "/product/123"'   # 跟踪单个 URL 为什么 miss
varnishstat 看 MAIN.cache_hit 和 MAIN.cache_miss 的比值,心里有底;再用 varnishlog 追一个具体 URL,看它是被 Cookie 挡了、被 Cache-Control 挡了,还是 hash key 算歪了。对着具体原因改,比瞎调参数强得多。

说白了,Varnish Cache 做的事,就是把"缓存策略"从框架写死的默认值里解放出来,交到你自己手里。它不是银弹——不原生支持 HTTPS、内存缓存重启即失、VCL 有学习成本——但在高并发热点内容这个场景里,它依然是最锋利的那把刀。
我是程序员天天困,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你在项目里用过 Varnish 吗?命中率最高跑到过多少,踩过最坑的配置是什么?