Lindorm Vector Migrate Skill 正式发布——为阿里云 Lindorm 搜索引擎打造的向量数据迁移助手,覆盖从 Milvus、Elasticsearch、Lindorm、Qdrant 及 CSV 文件迁移向量数据至 Lindorm 的全链路场景,支持断点续传、自动预检、DDL 生成、迁移后校验与业务代码改造建议。
1. Why——为什么需要 Lindorm Vector Migrate Skill
1.1 向量迁移的痛点
随着 AI 应用的爆发,越来越多的业务系统开始使用向量数据库支撑语义搜索、推荐系统、RAG 问答等场景。当团队决定将向量数据从 Milvus、Elasticsearch、Qdrant 等源端迁移到阿里云 Lindorm 时,往往会面临一系列挑战:
- 协议差异大:不同向量数据库的 API 协议、连接方式、数据格式各不相同,迁移前需要深入理解两端的差异
- 类型映射复杂:源端的字段类型、向量维度、距离度量需要精确映射到 Lindorm 的 knn_vector 体系,稍有差错就会导致数据丢失或检索异常
- 流程链路长:一次完整的迁移涉及参数收集、连接验证、空间估算、DDL 生成、索引创建、数据搬运、迁移后校验、业务代码改造等多个环节,手动执行容易遗漏关键步骤
- 中断风险高:百万级向量数据的迁移可能耗时数十分钟甚至数小时,网络波动或资源不足导致中断后,缺乏可靠的续传机制
1.2 通用模型的局限
通用大模型擅长通用编程知识,但对 Lindorm 搜索引擎的私有协议(端口 30070、knn_vector 字段类型、_bulk 写入语法、IVFPQ/IVFBQ 离线构建等)缺乏准确认知。例如,通用模型可能错误地使用 ES 8.x 的 knn section 语法,或遗漏 IVFPQ 索引必须添加 "knn.offline.construction": true 的关键配置。Lindorm Vector Migrate Skill 让 AI 的回答优先基于 Lindorm 官方知识,从根源上提升迁移的准确性和一次成功率。
1.3 Agent Skill 赋能迁移全流程
Lindorm Vector Migrate Skill 将迁移全链路与 AI 助手深度结合,开发者通过自然语言对话即可完成从参数收集到业务切换的完整迁移:
- 对话式参数收集:Agent 通过结构化提问逐项收集源端类型、连接信息、迁移选项,必填参数缺失时主动追问,不会猜测
- 自动化预检与校验:连接验证、空间估算、类型兼容性检查、TTL 检测全自动执行,迁移前排除风险,迁移后验证数据一致性
- 一键 DDL 生成:根据源端 schema 自动生成 Lindorm ES-compatible mapping JSON,覆盖距离度量映射、分片配置、TTL 设置、IVFPQ/IVFBQ 离线构建标记
- 断点续传可靠保障:迁移脚本通过 TeeWriter 双写 stdout 和日志文件,中断后 Agent 自动从日志提取断点信息,重新生成脚本填入恢复参数
2. What——Lindorm Vector Migrate Skill 是什么
Lindorm Vector Migrate Skill(alibabacloud-lindorm-vector-migrate-skill)是为阿里云 Lindorm 搜索引擎打造的 AI 迁移工具,覆盖 5 种源端、7 步完整工作流、迁移前中后全链路自动化。

2.1 支持的源端
源端 |
连接方式 |
数据扫描方式 |
适用场景 |
Milvus |
URI(Lite/Server/Zilliz Cloud)+ Token |
query_iterator 分页 |
Milvus Lite 本地文件、自建 Milvus、Zilliz Cloud |
Elasticsearch |
主机+端口(默认 9200)+ Basic Auth |
PIT + search_after / Scroll(自动选择) |
自建 ES、Elastic Cloud、阿里云 ES |
Lindorm |
主机+端口(默认 30070)+ Basic Auth |
Scroll API |
Lindorm 跨实例迁移 |
Qdrant |
URL 或 主机+端口(默认 6333)+ API Key |
REST scroll |
自建 Qdrant、Qdrant Cloud |
CSV 文件(OSS) |
OSS Endpoint + AK/SK |
OSS 流式读取 |
离线数据、网络隔离环境、超大数据集 |
此外,还支持导出到 CSV 模式:从源库索引导出 CSV 文件 → 用户上传 OSS → 衔接 CSV 导入流程。适用于源端与目标端网络不通、需要人工审核中间数据等场景。
2.2 核心能力总览
能力 |
说明 |
参数收集 |
通过对话逐项收集源端/目标端连接参数、迁移选项,索引名未知时自动列出源端所有索引/集合供选择 |
自动预检查 |
连接验证、Python 依赖检查、数据量估算(采样 100 条 × 总数)、存储空间对比、字段类型兼容性校验、TTL 检测、路由字段验证 |
DDL 自动生成 |
根据源端 schema 生成 Lindorm ES-compatible mapping JSON,含距离度量映射、索引方法选择(HNSW/IVFPQ/IVFBQ)、分片数、TTL 配置 |
安全迁移执行 |
源端只读、凭据从环境变量读取(不落盘)、并发写入+背压控制、进度实时汇报 |
断点续传 |
TeeWriter 双写日志文件,SIGTERM/SIGINT 信号处理,Agent 自动提取断点信息并恢复 |
迁移后数据一致性校验 |
行数校验、随机抽样比对(标量逐字段 + 向量余弦相似度)、IVFPQ/IVFBQ 构建状态轮询、TTL 专项校验 |
代码改造建议 |
根据源端类型提供分源端改造 Checklist,含连接层、查询语法、写入接口、分页方式的具体代码替换示例 |
排除字段 |
支持在 DDL 生成和数据迁移两个环节同时排除指定字段 |
2.3 完整工作流(7 步)
Step 1: 收集迁移信息
  ├─ 源端类型选择(Milvus / ES / Lindorm / Qdrant / CSV / 导出到CSV)
  ├─ 连接参数收集(地址、端口、认证、集合/索引名)
  ├─ 迁移选项(排除字段、索引方法、分片数、批次大小、并发数等)
  └─ 网络类型(公网 / 内网 VPC)

Step 2: 预检查
  ├─ 依赖检查(elasticsearch==7.17.13 / pymilvus / qdrant-client / oss2)
  ├─ 源端/目标端连接验证
  ├─ 数据量估算与存储空间对比
  ├─ 字段类型兼容性校验(含嵌套类型 WARN)
  ├─ Qdrant 多向量检测 / ES Scroll 排序键检测
  ├─ CSV 格式全量校验(列名唯一、类型声明、向量维度一致性)
  └─ TTL 检测与配置(源端检测推荐 / 手动配置 / 不配置)

Step 3: 生成 DDL 并展示迁移计划
  ├─ 自动生成 Lindorm mapping JSON
  ├─ 完整 DDL JSON 展示给用户确认(强制交互,不可跳过)
  └─ 迁移摘要确认(源端/目标端/选项汇总)

Step 4: 创建目标索引
  ├─ 检查目标索引是否已存在
  ├─ 已有索引的 mapping 兼容性检查
  └─ upsert 模式说明或清空后重建

Step 5: 执行数据迁移
  ├─ 停写建议与用户确认
  ├─ 源端扫描 → Lindorm _bulk 批量写入
  ├─ 并发写入(线程池 + 背压控制)
  ├─ TTL 注入(按源端类型自动计算过期时间戳)
  ├─ 进度实时汇报(百分比 + ETA)
  └─ IVFPQ/IVFBQ 触发离线构建并轮询至 ready

Step 6: 迁移后校验(自动执行,不可跳过)
  ├─ 强制刷新索引
  ├─ 行数校验(源端 vs 目标端 _count)
  ├─ 随机抽样比对(标量逐字段 + 向量余弦相似度 ≥ 0.95)
  ├─ IVFPQ/IVFBQ 构建状态检查
  └─ TTL 专项校验(settings 一致性 + 字段值合理性 + 源→目标一致性)

Step 7: 业务代码改造建议
  ├─ 连接层改造(SDK 替换、端口/认证修改)
  ├─ 查询语法改造(KNN / 混合检索 / 标量查询的代码替换示例)
  ├─ 写入接口改造(_bulk API)
  └─ 分页方式改造(scroll API 替代 PIT / query_iterator)
2.4 安全设计
安全机制 |
说明 |
源端只读 |
迁移过程中不修改源端任何数据 |
凭据不落盘 |
所有密码、Token、AK/SK 通过环境变量传入,不写入脚本或配置文件,fallback 值为空字符串 |
DDL 强制确认 |
完整 DDL JSON 必须通过用户确认后方可执行,不以简要描述替代 |
清空目标二次确认 |
选择清空目标索引时必须二次确认后才执行删除 |
停写风险告知 |
迁移前提示停写建议,用户可选择"已停写"、"知悉风险继续"或"取消" |
连接失败透明 |
连接失败时展示完整错误信息,不静默重试 |
2.5 能力评测
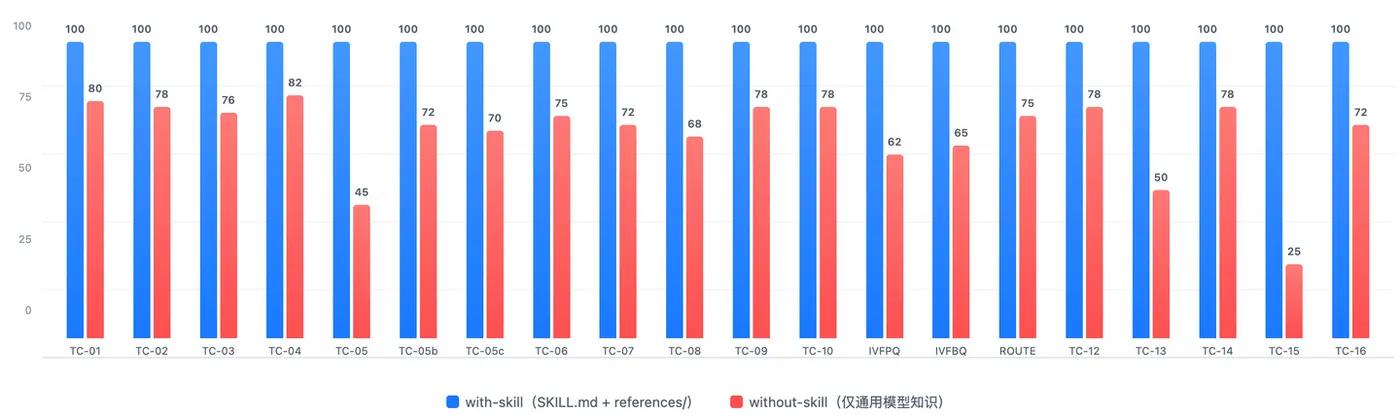
发布前,我们完成了 17 个端到端迁移测试用例 的系统评测,覆盖 5 种源端(Milvus / Elasticsearch / Lindorm / Qdrant / CSV-OSS)、3 种索引方法(HNSW / IVFPQ / IVFBQ)、7 大能力类别。每个用例由两个独立子 Agent 分别在「使用 Skill(可读 SKILL.md + references/)」与「不使用 Skill(仅凭通用模型知识)」两种条件下执行完整迁移流程,共 34 个子 Agent 分 3 批次并行执行。
with-skill vs without-skill 对比评测 · 17 测试用例 · 7 大能力类别

评测方法
每个测试用例由两个独立子 Agent 分别在「使用 Skill(可读 SKILL.md + references/)」与「不使用 Skill(仅凭通用模型知识)」两种条件下执行完整迁移流程(7 步工作流),然后对比产出差异。评分维度包含 7 项:① 流程合规(7 步工作流 + MUST 约束)、② 迁移正确性(行数 + 抽样)、③ API 知识(源端特有 API 决策)、④ DDL 质量(类型映射 + 索引方法参数)、⑤ 安全性(凭据管理)、⑥ 健壮性(断点续传 + 并发控制)、⑦ 代码改造建议(分源端 API 替换代码),每题满分 100 分。
逐用例得分对比
分类别表现对比
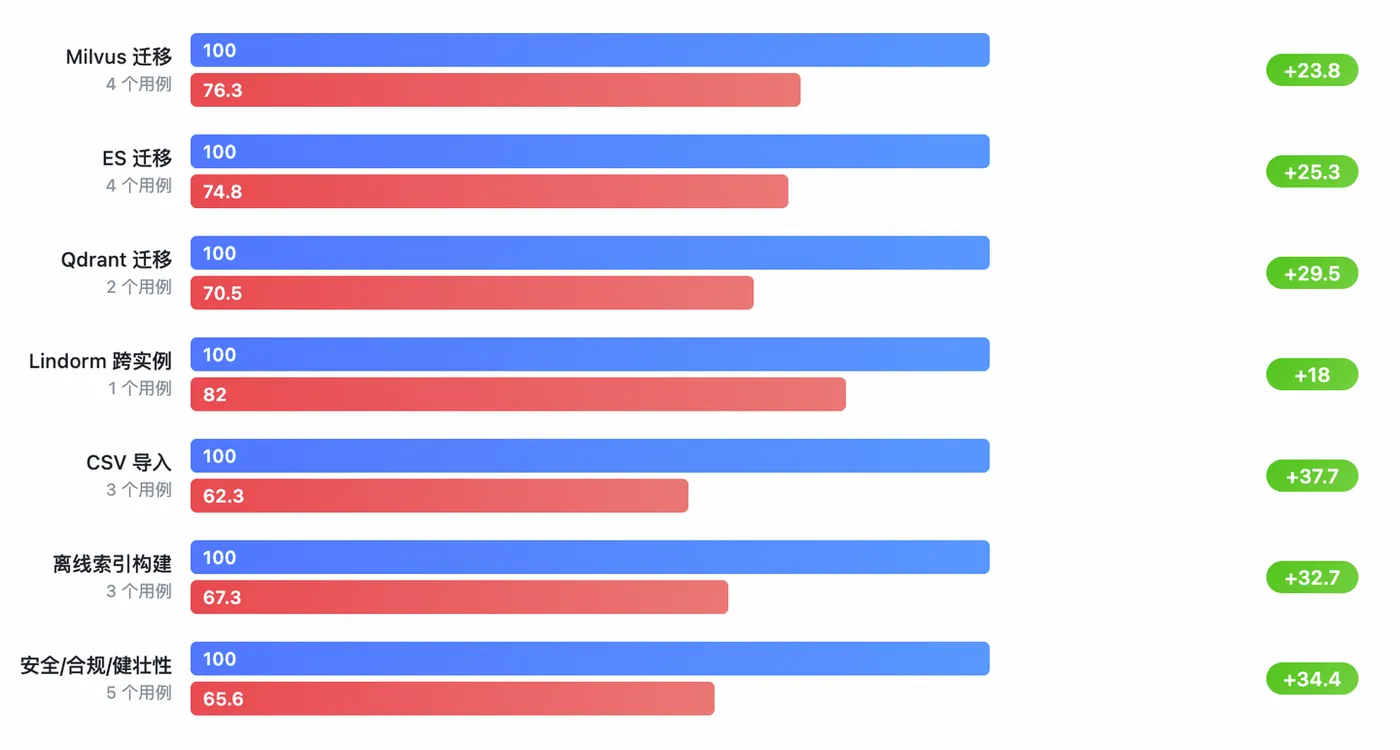
- 越依赖 Lindorm 私有协议的环节,提升越明显:离线索引构建(IVFPQ/IVFBQ)是最大价值差距(Delta +32.7)。通用模型要么遗漏 Build API 触发,要么用错误的 5s/10s 间隔轮询,要么直接用 _forcemerge 替代——而 Skill 精确遵循 knn.offline.construction: true → POST _plugins/_vector/index/build → 30s 间隔轮询至 ready/failed 的完整链路。
- 安全防护维度提升尤为显著(Delta +34.4):通用模型会在用户催促时跳过 DDL 确认(TC-13 without 仅 50 分)、会对不支持的 MongoDB CSV 来源错误执行迁移(TC-15 without 仅 25 分)、会用真实密码作为环境变量 fallback 默认值。Skill 严格执行所有 MUST 约束,杜绝了这些生产安全隐患。
- CSV 导入是通用模型的完全盲区(Delta +37.7):typed header 解析(embedding:knn_vector:1536:cosine)、OssRawReader 流式读取、大文件并发背压控制——这些 Lindorm 特有的 CSV 迁移机制,通用模型几乎零覆盖。
关键差异 Top 5
主题 |
without 典型失误 |
with-skill 正确输出 |
|
1 |
IVFPQ/IVFBQ 离线构建 |
直接写入后查询,或用 _forcemerge 替代 |
DDL 设置 knn.offline.construction: true → 写入 → Build API → 30s 轮询至 ready |
2 |
不支持的 CSV 来源 |
MongoDB CSV 直接执行迁移 |
仅接受 Milvus/ES/Lindorm/Qdrant,选择"其他"时拒绝处理 |
3 |
DDL 强制确认 |
用户说"直接开始"就跳过 |
无论用户如何催促,必须展示完整 DDL JSON 并等待确认 |
4 |
ES ILM→TTL 转换 |
不检测 ILM policy 或仅提示手动处理 |
自动检测 ILM delete 阶段 min_age → 转换为行级 TTL |
5 |
凭据安全规范 |
os.environ.get("PASSWORD", "root123") |
os.environ.get("LINDORM_PASSWORD", "") — fallback 必须为空字符串 |
结论
Skill 的必要性得到充分验证。 17 个覆盖 5 种源端(Milvus / ES / Qdrant / Lindorm / CSV)+ 3 种索引方法(HNSW / IVFPQ / IVFBQ)的端到端迁移场景中,Lindorm Vector Migrate Skill 使 Agent 加权平均分从 66.3 跃升到 100(提升 +33.7 分)。尤其在离线索引构建(Delta +32.7)、安全防护(Delta +34.4)、CSV 导入(Delta +37.7)三大类别中,通用模型几乎零覆盖,Skill 的加入使通过率从约 66% 提升至 100%,验证了这些 Lindorm 特有知识完全超出通用模型边界,必须通过 Skill 注入。
3. Show——场景演示
3.1 场景示例一:Milvus → Lindorm 全量迁移
用户提问:"帮我把 Milvus 里的向量数据迁移到 Lindorm"
Agent 交互流程:
- 参数收集:Agent 通过结构化提问收集 Milvus URI、Collection 名称(未知时自动列出所有 Collection)、Lindorm 连接地址和认证信息
- 排除字段选择:连接 Milvus 获取 schema 后,展示所有字段名供多选排除
- 迁移选项确认:索引方法(推荐百万级以下 HNSW)、分片数、批次大小(根据向量维度自动推荐)、并发数等,支持"全部使用默认值"一键确认
- 预检查:自动执行连接验证、数据量估算(采样 100 条 × 总行数 × 索引膨胀系数)、存储空间对比、类型兼容性检查、TTL 检测(Milvus collection.ttl.seconds → 行级注入)
- DDL 确认:展示完整的 PUT /<index> mapping JSON,包含 knn_vector 字段定义、距离度量映射(COSINE → cosinesimil)、HNSW 参数
- 迁移执行:后台运行迁移脚本,每批写入后打印进度,Agent 定期汇报百分比和 ETA
- 迁移后校验:行数一致、200 条随机抽样向量余弦相似度 ≥ 0.99(HNSW 无损索引)
- 代码改造:提供 Milvus → Lindorm 的 10 项改造 Checklist,含 pymilvus → elasticsearch-py 的完整代码替换示例


3.2 场景二:断点续传
场景说明:迁移百万级数据时脚本因超时被中断。
Agent 自动处理:
- 脚本收到 SIGTERM 信号,打印 [INTERRUPTED] cursor=abc123 migrated=50000 total=120000 到日志文件
- Agent 从日志文件提取断点信息:grep '[INTERRUPTED]' checkpoint.log
- 告知用户已迁移进度(50,000/120,000 = 41.7%),询问是否续传
- 用户确认后续传,Agent 重新生成脚本,填入恢复游标和恢复计数
- 续传时 Lindorm _bulk 使用 _id 做 upsert,重复写入不会产生重复数据


4. Let's Start——现在开始
第一步:安装
在你的 IDE / Agent 对话里直接说:
帮我下载和安装这个 Skill:https://clawhub.ai/sdk-team/alibabacloud-lindorm-vector-migrate-skill
第二步:探索
安装完成后,直接用自然语言描述迁移需求(包含"迁移"、"向量数据"等关键词会自动触发),试试这些场景:
- 「帮我把 Milvus 里的商品向量数据迁移到 Lindorm」
- 「ES 集群有个 embedding 索引要迁到 Lindorm,大概 50 万条」
- 「Qdrant Cloud 的数据导出成 CSV,帮我导入 Lindorm」
- 「两个 Lindorm 实例之间的向量数据怎么迁移」
Tips:迁移前请确保 Agent 能够网络访问源端和目标端。如果 Agent 运行在本地环境而数据库在 VPC 内,可能需要使用内网连接或通过 CSV/OSS 中转。Agent 会自动引导你完成参数收集 → 预检查 → DDL 确认 → 迁移执行 → 校验 → 代码改造的完整流程。