Qoder Cloud Agents 上线实时语音交互。Forward Mode 的 Agent 模板,现在可以直接开口说话。
你不用再把想法攒成一段完整的指令,也不用等它把话说完才能插嘴。
想清楚一件事,和把它打出来,是两回事
你大概有过这种时刻:
事情在脑子里已经很清楚了——把上周那批异常订单捞出来,按门店分个组,跑不通的单独列一列。清楚到你几乎能听见自己说出这句话。
然后你打开对话框,开始打字。
打到一半你意识到,"上周"得写成具体日期;"异常"得说明是哪几类;"按门店分组"最好再补一句排序规则。原本三秒钟就能说完的事,你花了三分钟组织成一段书面语,然后按下回车,等。
这就是过去一年多我们和 Agent 相处的方式:你必须先把自己翻译成一段结构完整的文字,它才听得懂。
翻译是有成本的。成本高到,很多"顺手让 AI 干一下"的念头,在打字的第二行就放弃了。
现在你可以直接说。
你说着话,活在云上就干完了
打开语音之后,最先变化的不是"能用嘴了",而是节奏。
它不用等你说完。 语音输入和语音输出是同时进行的——你说到一半改主意,"等等,不要上周,要这个月的",它当场跟着拐弯,不会把那句错的执行到底。反过来它也可以插话:发现你要的字段其实不存在,它会当场开口提醒你,而不是闷头跑完再报一个错。
它不介意你中途换成打字。 有些东西天生不适合念出来:一串订单号、一段路径、一行配置。你可以直接在输入框里敲进去,语音和文字共享同一份实时上下文——嘴上指挥,手上补细节,中间不需要切换模式,也不会因为你打了一行字就退回文字模式。
最关键的是,活不是在你这台电脑上干的。
你说完一句话之后,真正的执行发生在云端:Agent 在云上的沙箱里读文件、跑脚本、调工具、连你授权过的系统。这意味着你不必一直盯着它——眼睛可以去看别的东西,手上可以做别的事。它在云上接着跑,并把执行状态和结果用语音反馈给你:
"三个门店的数据已经对齐,第四个门店的字段名不一样,按原来的规则处理了。"
听着不对,你随时可以开口把它叫住。打断在这条链路里是随时可用的,不用等它说完。
这是语音最容易被低估的一点:它不只是把手腾出来了,是把眼睛腾出来了。
连接断了也不用从头来。语音会话支持断线重连,重新连上之后,会话和上下文接着往下走。
几个大概能对上号的时刻:
- 通勤路上。 想到一件事,说一句"把昨天那批异常订单整理成表,按门店分组"。到公司,表在那儿了。
- 会开到一半。 有人问上个季度某个数,你不用中断会议翻系统,低声问一句,它在云上查完,把答案念给你。
- 一个要跑二十分钟的活。 跑到第三步,它把状态报给你,你一听就发现方向偏了,当场开口改。而不是二十分钟后回来,看到一条卡在第三步的失败日志。
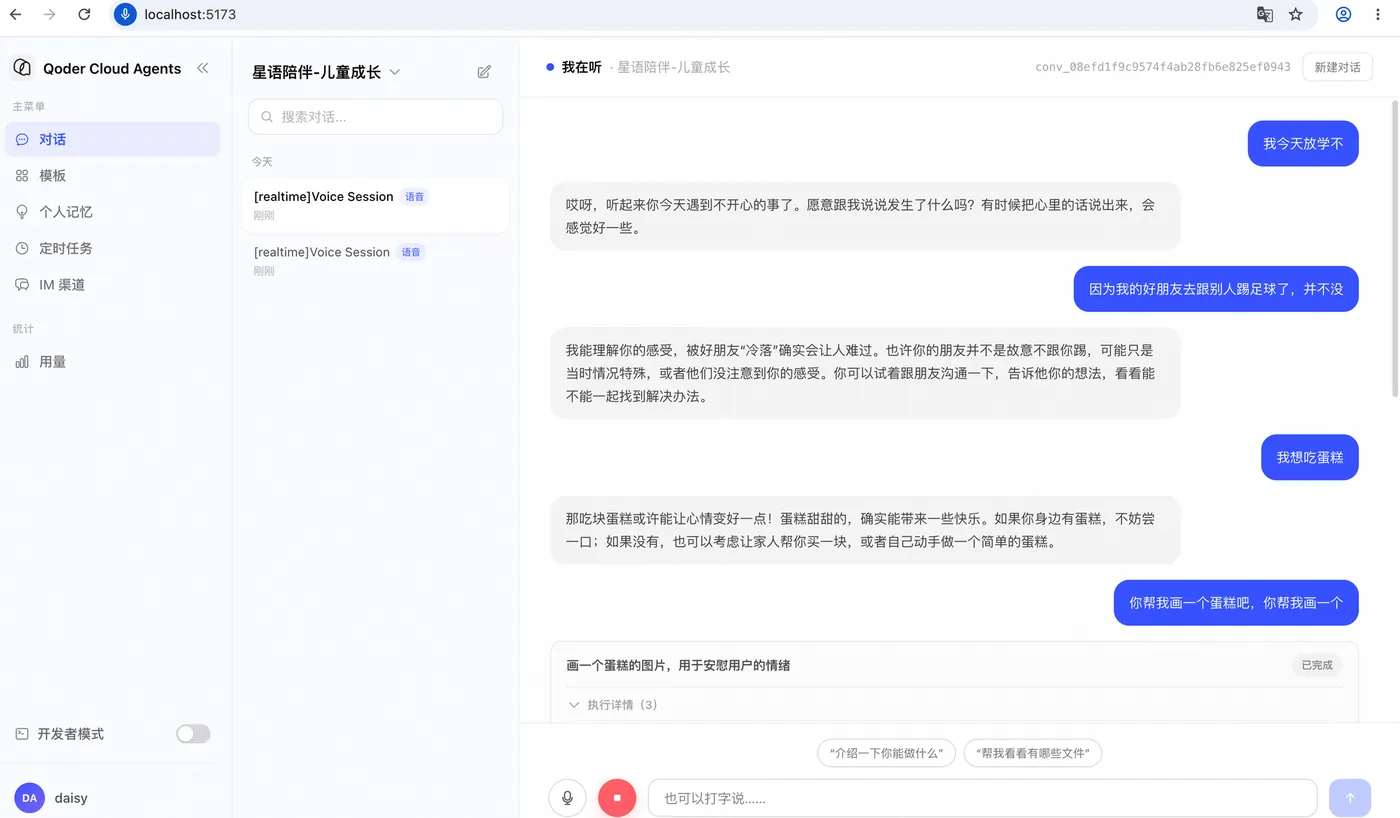
- 孩子放学回来,情绪不太对。 他不会打开电脑打一段"我今天在学校被冷落了,我想聊聊"——但他会开口说。一个配好了儿童陪伴能力的 Voice Agent,能接住那句话——它会听出他语气里的失落,用有温度的语调回应,而不是像念稿子一样把安慰念一遍。带着耐心和边界感陪他聊下去。这件事如果没有语音,对一个八岁的孩子来说,根本不会发生。
语音不是多了一个功能,是 Agent 的界面变了
这一年,能语音对话的产品越来越多。大部分解决的是同一件事:让你能用说话代替打字。 能听懂,能应答,能顺手查两个东西。
这已经很有用。但这条路的能力边界,基本就是"一次对话里能完成的事"。
我们的做法不太一样。
在 QCA 里,语音负责的是跟你实时地聊:毫秒级响应、听得懂口语、能自然打断也能被打断,还能听出你话里的情绪,用有温度的语气回应——而不是机械地念稿。而你交代的活,是在云上真正跑起来的——沙箱、技能、工具、MCP、你授权过的密钥和文件权限,都在同一个会话里为这场对话服务。
你不会感觉到任何转接。你只是在说话,然后活干完了。语音对话、转写文字、工具调用、任务执行结果,全部写进同一份会话记录——事后要回溯,还是原来那个入口,一条时间线看到底。
"聊"和"干"不是两个系统。这是我们觉得最要紧的一点。
而且有些场景,键盘从来就不是选项:
一个八岁的孩子没法整段打字描述自己的情绪;一位正在做饭的家长腾不出手来打字指挥Agent;一个焦虑发作的人根本无法组织书面语。对他们来说,Agent 如果没有语音,就等于不存在。声音才是那扇最顺畅的门。
但语音只是门。真正拉开差别的是进门之后还能干什么。
哪怕是陪孩子聊天这种看起来"只需要说话"的场景也一样:聊到需要动手的地方——查一份资料、整理一段记录、生成一张图——同一个会话背后的沙箱会接着把它做完。语音负责把话说清楚,沙箱负责把语言之外的事办了。
再往远看一步。
Agent 的界面之所以一直是对话框,是因为过去人必须盯着:盯着它每一步做对了没有,随时准备接手。对话框是一个监工的界面。
而当 Agent 真的能把一件多步骤的活自己干完,人需要的就不再是监工位,而是一个随时能开口、随时能把它叫住的入口。
这个入口最自然的形态,就是说话。
往回说一句实在的。对已经在用 QCA 的团队,这件事的意义不只是"我们的 Agent 会说话了"。
你花时间配好的模型、技能、工具和权限,本来只能通过一个输入框交付给你的用户。现在同一套东西,多了一种更接近人本能的交付方式——而你不需要为它重做一个 Agent。
现在就能用上
想直接体验: 进 Qoder Cloud Agents 控制台,切到 Forward Mode,打开一个 Agent 模板,顶上会有一个 Voice 标签。右边就是实时语音体验面板——点麦克风,直接开口说。
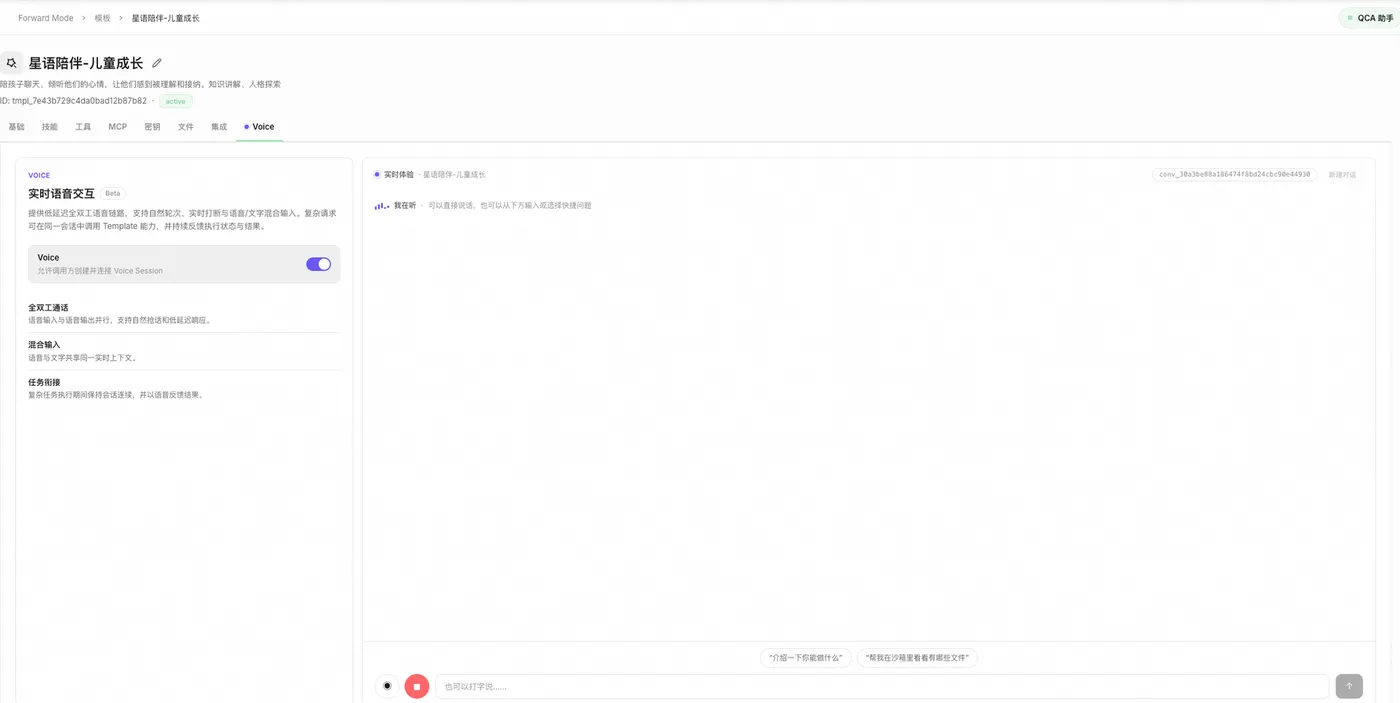
想接进自己的产品: 不必推倒重来。
从零搭一套能用的实时语音 Agent 不轻松:低延迟音频链路、双工打断、断线重连、还要在嘈杂环境里分清人声——这些都得自己啃,任何一环没调好,体验就崩了。这些我们已经做完了。你要做的只是打开一个开关。
你原来配好的那套东西——模型、技能、工具、MCP、环境、密钥、文件权限——语音直接复用,原有的 Agent 能力体系不用重建。同一个模板,长出两种入口:需要文字的地方创建普通会话,需要语音的地方创建语音会话,两者各自独立、上下文互不串味。
协议上,语音和文字走同一条 WebSocket 全双工连接:语音走二进制帧,文字走结构化事件,打断和断线重连都在协议里,不用你自己在前端拼一套状态机。
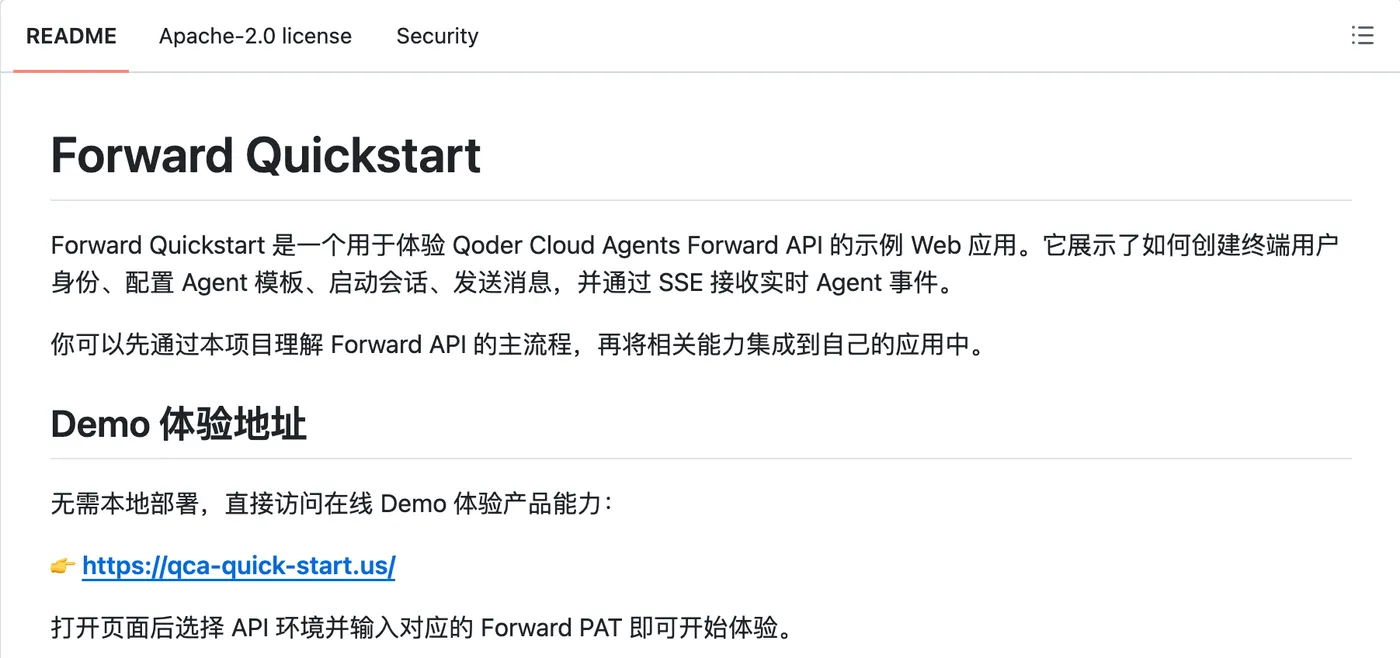
我们把完整的接入示例开源了:github.com/QoderAI/forward-quickstart。克隆下来 npm install && npm run dev,本地就能跑通从创建身份、配模板、起语音会话到接实时事件的整条链路。(仓库里那个在线 Demo 出于安全考虑没有开语音中继,想体验语音,请走控制台或本地跑起来的 quickstart。)
Voice 当前处于 Beta,限时免费体验。
写在最后
回到开头那个场景。
事情在脑子里已经很清楚了。以前你要花三分钟把它翻译成一段书面指令,现在你只需要三秒钟,把它说出来。
省下的不是三分钟,是那些因为懒得打字而没发生的事。
Qoder Cloud Agents 控制台已开放 Voice 配置,打开模板的 Voice 标签就能开始。现在是 Beta 限时免费体验的阶段,试错成本几乎为零。