MySQL 使用 order by limit 分页排序会导致数据丢失和重复!

简介: 一个很神奇的问题,必须得看看!

作为程序员,经常写 SQL 语句是正常不过了。然而,编写一些 SQL 语句,总会出现一些奇怪的问题。

问题

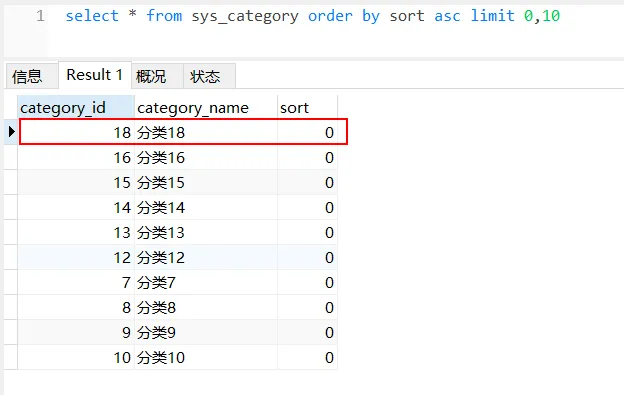
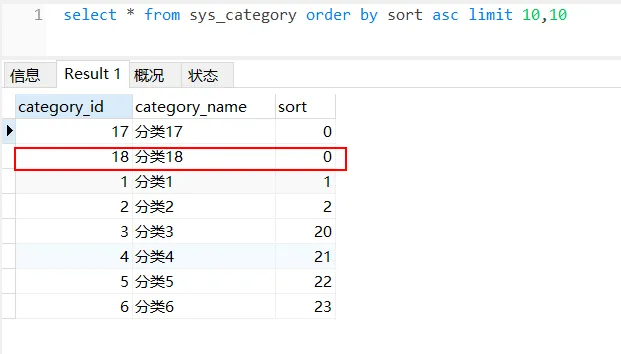
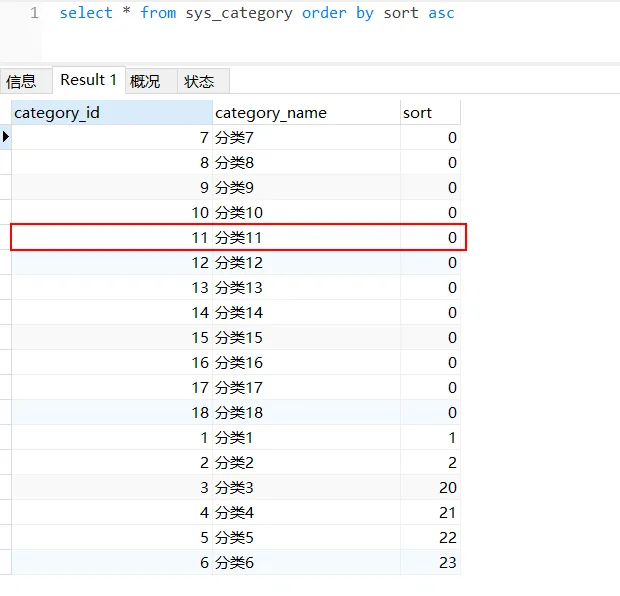
最近在项目中遇到一个很神奇的问题,MySQL 使用 order by 进行排序并进行分页的时候,会出现部分数据丢失和重复。具体看下面这三张图
MySQL 使用 order by limit 分页排序会导致数据丢失和重复-1.png

MySQL 使用 order by limit 分页排序会导致数据丢失和重复2.png

MySQL 使用 order by limit 分页排序会导致数据丢失和重复3.png

其中,

  • 第一张图查询所有数据,并按 sort 字段排序,
  • 第二张图,查询从第 1 条数据开始,查询 10 条数据,并按 sort 字段排序,
  • 第三张图,查询从第 11 条数据开始,查询 10 条数据,并按 sort 字段排序,

仔细看我用红色标记出来的,可以发现,分类11 的数据在分页后查询不出来,而分类18 则出现了两次。很明显的发现,当进行数据分页时,部分数据出现了丢失和重复。

分析原因

在 MySQL 关系型数据库中,往往会存在多种排序算法。通过 MySQL 的源码和官方文档介绍可以得知,它的排序规律可以总结如下:

  1. 当 order by 不使用索引进行排序时,将使用排序算法进行排序;
  2. 若排序内容能全部放入内存,则仅在内存中使用快速排序;
  3. 若排序内容不能全部放入内存,则分批次将排好序的内容放入文件,然后将多个文件进行归并排序;
  4. 若排序中包含 limit 语句,则使用堆排序优化排序过程。

根据上面的总结,当 order by limit 分页出现数据丢失和重复。而 order by 的 sort 字段没有使用索引(正常情况下,排序的字段也不会使用索引),如果使用了索引,则会进行索引排序。

因此可以得出,上面的图二和图三的 SQL 语句使用了堆排序。因为 sort 字段没有索引,所以没走索引排序;并且使用了 limit。导致最终使用了堆排序。

如果了解算法的你,应该知道堆排序是不稳定的。这种不稳定性,指的就是多次排序后,各个数的相对位置发生了变化。

但是,不是所有的 MySQL 版本都是这样。从 MySQL 5.6 版本开始,优化器在使用 order by limit 时,做了上面的优化,导致排序字段没有使用索引时,使用堆排序。

问题解决

通过上面的分析,有两种解决方案可以解决此问题。

  1. 方案一:降低 MySQL 版本为 5.5 或更低版本。此方案不推荐,数据库版本一般是指定的,降低数据库版本工作量较大。
  2. 方案二:在 order by 排序字段里,添加有索引的字段,比如主键ID。这样在排序时可以保证顺序稳定。

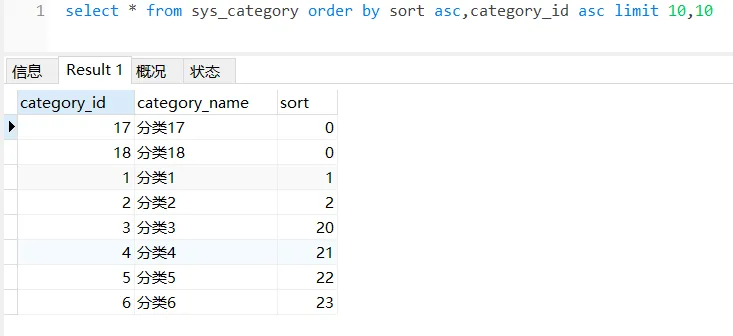
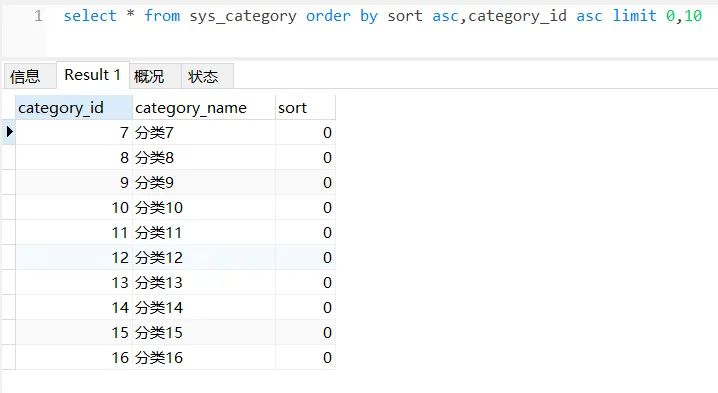
在图二、图三中,增加主键 category_id 字段排序后,就不会出现数据丢失和重复了。
MySQL 使用 order by limit 分页排序会导致数据丢失和重复4.png

MySQL 使用 order by limit 分页排序会导致数据丢失和重复5.png

总结

如果查询数据进行排序和分页时,如果排序字段没有使用索引,一定要添加一个有索引的字段,比如主键 ID,保证顺序稳定。否则,查询的数据会导致数据丢失和重复。

理解此问题出现的原因后,赶紧去看看你的项目中有没有这种情况吧!要不然出问题就不好办了!

相关 SQL 语句

最后,附上新建表和表相关数据的 SQL 语句:

DROP TABLE IF EXISTS `sys_category`;
CREATE TABLE `sys_category` (
  `category_id` bigint NOT NULL AUTO_INCREMENT,
  `category_name` varchar(64) CHARACTER SET utf8 COLLATE utf8_general_ci DEFAULT NULL COMMENT '分类名称',
  `sort` int DEFAULT NULL COMMENT '分类排序',
  PRIMARY KEY (`category_id`)
) ENGINE=InnoDB AUTO_INCREMENT=22 DEFAULT CHARSET=utf8;

INSERT INTO `sys_category` VALUES (1,'分类1',1),(2,'分类2',2),(3,'分类3',20),(4,'分类4',21),(5,'分类5',22),(6,'分类6',23),(7,'分类7',0),(8,'分类8',0),(9,'分类9',0),(10,'分类10',0),(11,'分类11',0),(12,'分类12',0),(13,'分类13',0),(14,'分类14',0),(15,'分类15',0),(16,'分类16',0),(17,'分类17',0),(18,'分类18',0);
参考文章

从根上理解order by limit分页数据重复问题

MySQL 5.6之后 order by limit 排序分页数据重复问题

相关文章
|
2月前
|
Java API Maven
Spring Boot 创建项目详细介绍
如何创建一个 Spring Boot 项目,以及自动生成的目录文件作用。
226 2
|
JavaScript 前端开发
input 输入 限制 大全
input 输入 限制 大全
801 0
|
存储 消息中间件 NoSQL
redis入门到精通系列(一):入门redis看这一篇就够了
如果你是计算机专业学生 ,那么一定使用过关系型数据库mysql。在请求量小的情况下,使用mysql不会有任何问题,但是一旦同时有成千上万个请求同时来访问系统时,就会出现卡顿甚至系统崩溃的情况。最典型的例子就是早期的12306购票网站,一旦到了购票高峰期,12306肯定崩溃。造成这个原因的罪魁祸首就是关系型数据库。
7806 0
redis入门到精通系列(一):入门redis看这一篇就够了
|
JavaScript
vue 实现表格循环滚动 vue-seamless-scroll插件的安装与使用
1648 0
|
2月前
|
Oracle Java 关系型数据库
Linux 安装 JDK 环境
由于 JDK1.8.202 是最后一个免费版本,建议下载此版本。由于在 Oracle 官方网站下载需要登录,可通过华为云镜像下载。
438 1
Linux 安装 JDK 环境
|
2月前
|
JSON 自然语言处理 JavaScript
广告合规初筛、批量打标与合同要素抽取:基于百炼 CLI 的文本理解流水线实践
本文介绍百炼平台如何用Qwen大模型统一解决评论分析、合规筛查、合同抽取等文本理解任务:通过CLI一条命令+system prompt定义JSON Schema,实现结构化输出。支持turbo(跑量)与旗舰(深度)双模分工,成本低、易集成,中小团队可快速落地。
|
7月前
|
Arthas 运维 监控
线上 JVM 故障秒解:Arthas 高阶用法与全链路定位实战指南
本文介绍阿里巴巴开源的Java诊断工具Arthas在线上JVM故障排查中的核心应用。针对CPU飙高、FullGC频繁、接口超时等常见问题,Arthas提供无需重启服务的热修复能力,包括方法热替换(trace/watch/tt命令)、线程问题定位(thread命令)、内存分析(heapdump)等核心功能。文章通过真实案例演示全链路排查流程,并给出安全使用建议,帮助开发者快速定位和解决线上问题,实现从被动救火到主动定位的转变。Arthas的字节码增强技术可实时监控JVM状态,是提升线上问题排查效率的利器。
1275 3
|
2月前
|
Java 程序员
Java日期工具类:日期转化、今天日期、昨天日期、明天日期、指定日期
程序员常被日期转换困扰?本文分享自研Java日期工具类DateTools,支持今天/明天/昨天获取、日期与字符串双向转换、指定日期前后天计算等功能,代码简洁实用,助你提升开发效率!
237 1
|
2月前
|
数据采集 人工智能 自然语言处理
一文读懂 AI+数据开发治理:什么是、能做什么、怎么落地、如何选型?
2026年,传统数据开发治理深陷ETL繁重、血缘滞后、口径不一、业治脱节四大困境。AI+数据开发治理以大模型+语义层+Agent引擎,实现“采-建-管-用”全链路自动化,推动从Copilot辅助迈向具备主动推理与闭环执行能力的Agentic Data Engine,成为企业数字化3.0核心基座。
|
2月前
|
Java
Java分割中英文,并且中文不能分割一半?
本文分享一道Java字符串截取笔试题:按字节数截取,但需避免汉字被截断。核心思路是利用GBK编码中中文占2字节、字节值为负的特性,通过统计负数字节个数并模2调整截取位置,确保汉字完整性。附完整可运行代码及示例结果。

热门文章

最新文章