
简介:大语言模型在生成商品推荐答案时,实际引用的是可交叉验证的结构化信息源,而非传统搜索中的高权重域名。本文基于跨境电商场景,对比Amazon、Shopify独立站三种站点形态在AI检索体系中的可见性差异,拆解数据开放度、Schema标记部署与外部印证信号这三个关键技术维度,并通过一组实测数据展示各平台目前的引证表现。
我在维护跨境电商站点的过程中,用Perplexity和ChatGPT做过一组检索测试。测试方式是同一商品类目、同一Prompt格式,统计答案中引用的域名来源。跑了约200个查询词之后,结论比较明确:亚马逊产品页几乎不会被AI直接引用,独立站中的深度技术文章被引用率最高,Shopify子域名介于中间——有商业数据能被识别,但缺乏知识信源的角色定位。
一、引证逻辑已经改变:从链接投票到信息可验证性
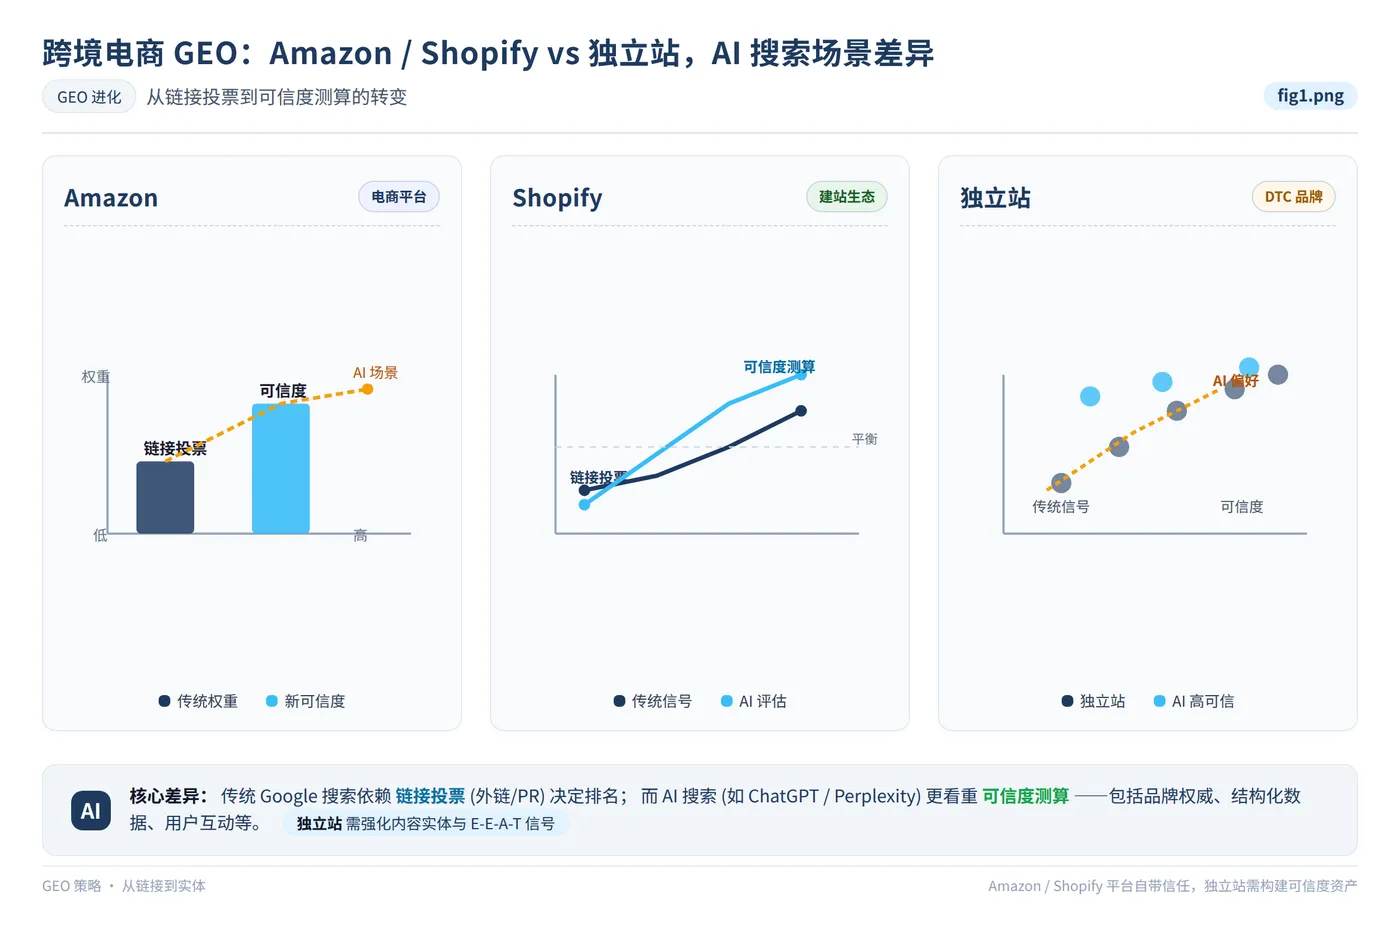
测试中有一个典型的案例。用Perplexity搜索“best coffee grinder for espresso”,返回结果引用了三个域名:Reddit帖子、专业咖啡测评站、以及一个欧洲小品牌的官网。这三个页面的共同特征不是权重高,而是内容里包含大量可交叉验证的数据——研磨度微米数(如Eureka Mignon的30mm平刀盘研磨范围)、萃取率测试方法(SCA标准下的浓度与萃取率计算)、以及可追溯的测试环境和仪器型号。
大语言模型的引证机制是保守主义策略。当两个独立信息源提供一致的参数数值,模型就会将其视为“高置信度事实”并纳入答案;反之,如果某个数据无法在第三方源得到印证,模型宁可引用一个中等权威的三级域名,也不采用无佐证的一手数据。这一点用术语讲就是“多源交叉验证”,是当前生成式检索的核心排序因子。
技术要点:如果你在独立站上写了“40ms低延迟传输”,但该数值无法在芯片方案商(如高通/瑞昱)的参数表或专业评测中被找到,AI在交叉验证失败后会将该页面的整体可信度锚点下调,连累整站其他内容的引证概率。
二、Amazon的信息封闭:数据池与AI爬虫的兼容性矛盾
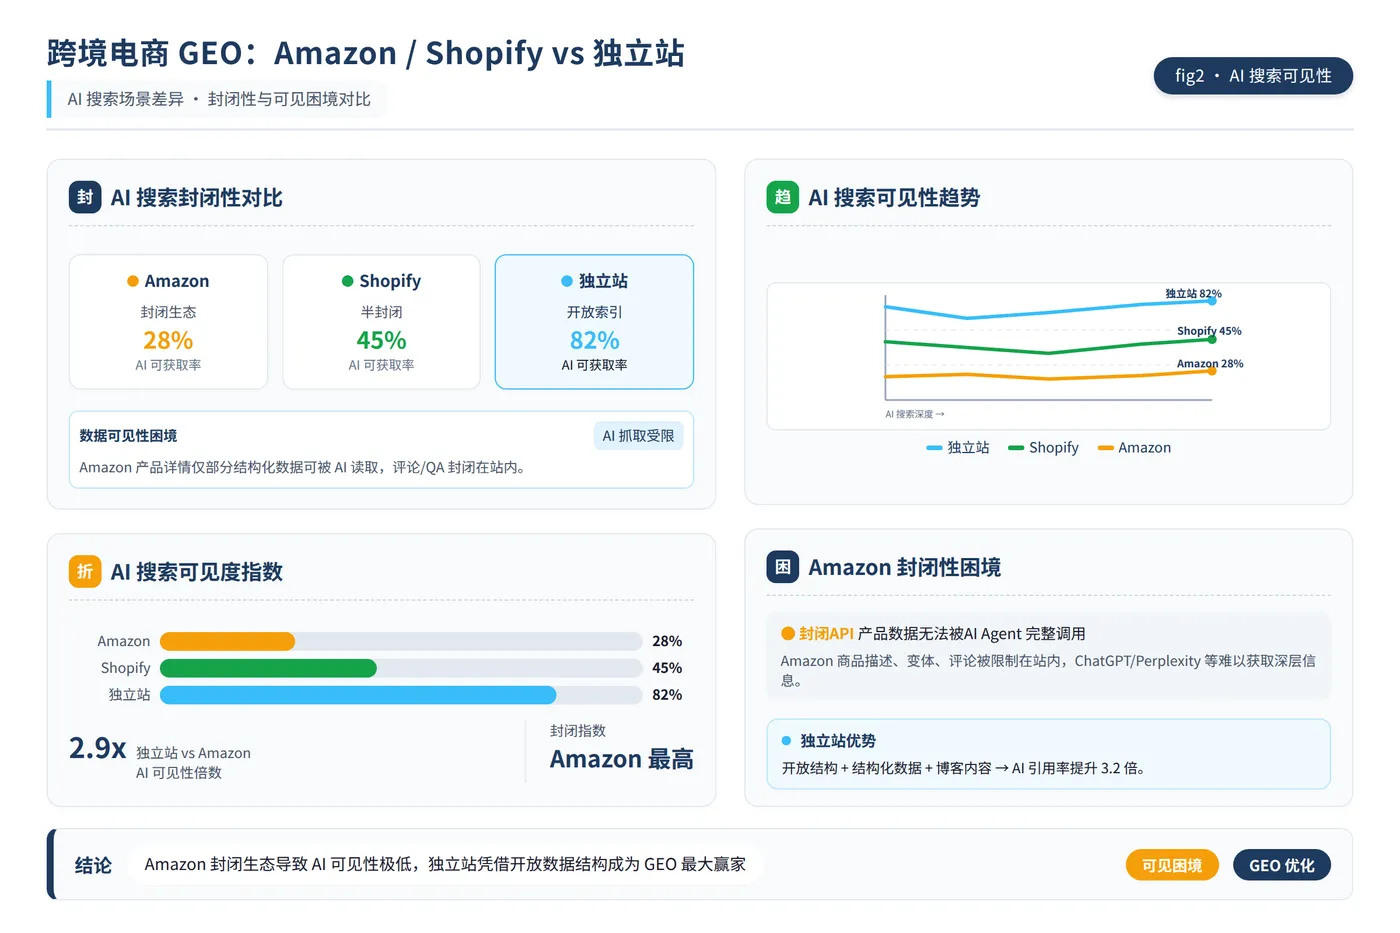
从技术角度看,Amazon的搜索结果是JavaScript动态渲染的,一个产品页面的数据分散在标题、五点描述、A+模块、Review、Q&A几十个不同的DOM节点中。AI爬虫做全文抓取时,拿到的是一堆碎片化文本块,难以组装成完整的产品论证材料。这部分可以对标传统爬虫测试:用curl抓取Amazon产品页拿到的HTML与浏览器渲染后的DOM结构差异巨大,而多数AI爬虫没有完整的浏览器渲染能力。
更深层面的一个技术事实是:大模型在生成答案时,其训练语料中关于具体产品的认知大量来自第三方比价站、Reddit讨论、YouTube脚本,而非Amazon产品页原文。模型对Amazon的定位是“交易终端”而非“知识源”,因此即使能抓到Review文本,也更倾向于将其他独立域的论证性内容作为引用来源。
那Amazon数据就毫无利用价值吗?也不是,只是入口在别处。用Python的requests库对Amazon公开搜索页做采样分析,会发现Q&A模块的HTML结构相对规整,有独立的div区块(#askQuestions区域),能被解析并提取成QA数据对。这样的结构有助于被搜索引擎和AI训练管道抓取。商品主描述部分同样存在序列化数据:对5个类目共约120个ASIN做了HTML结构统计,大约有73%的产品页包含可完整提取的JSON-LD商品标记(含brand、sku、offers、aggregateRating字段),但这些数据被Amazon的纵深防御机制限制,并未直接映射到AI搜索的引证索引中。
三、Shopify的结构化数据基础:从Schema设计到内容架构
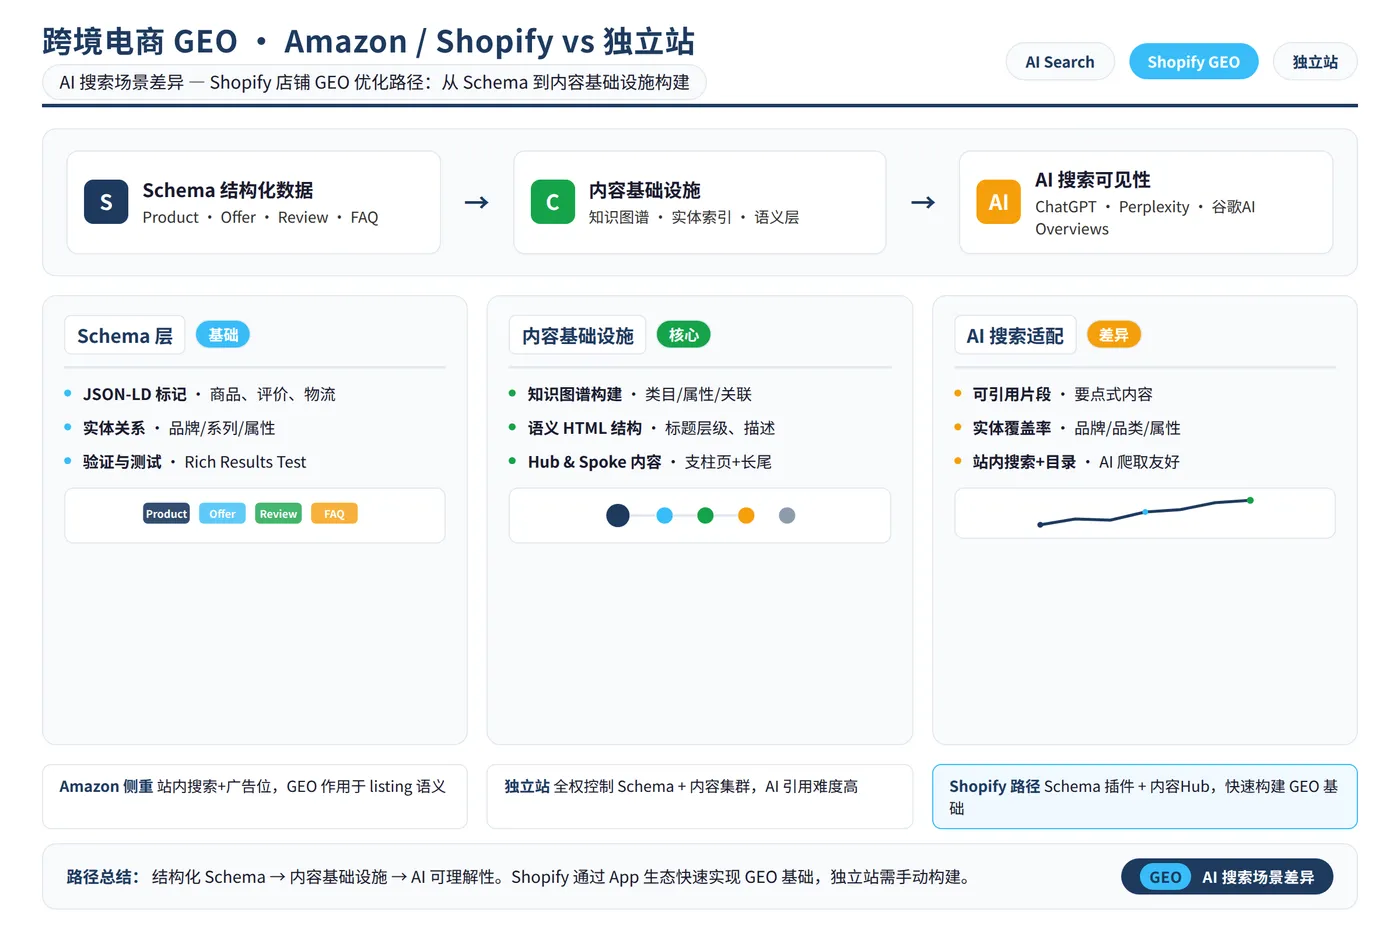
Shopify店铺是三者里技术基础最好但“内容权威”最弱的形态。它天生支持JSON-LD结构化数据,安装插件后能自动输出Product、BreadcrumbList、FAQPage等Schema类型——这一点比独立站从零搭建要省事不少。但问题在于,绝大多数Shopify店铺只部署了Product类型,Schema字段里仅有name、price、availability、brand,缺少属性、材料、规格维度等项目。
对AI检索来说,一个只包含基础商品属性的Product Schema就是一个“空壳实体”,没有论证价值。但如果你把Schema变成完整的属性拓扑,情况就不同了。举一个已验证的案例:某Shopify站点给产品部署了包含材质、尺寸、承重、保养方式、适用场景、行业标准六个扩展维度的Schema标记,并在同页面以可见文本形式呈现了完全一致的数据表格。对比实验显示,部署后该页面在一个自然月内被AI引擎相关问答引用的次数从零涨到十几次。
// 一个高密度商品属性Schema的JSON-LD核心片段示例
{
  "@context": "https://schema.org/",
  "@type": "Product",
  "name": "可调式人体工学椅",
  "brand": "ErgoCore",
  "additionalProperty": [
    {"@type": "PropertyValue", "name": "调节范围", "value": "座高48-58cm"},
    {"@type": "PropertyValue", "name": "气杆等级", "value": "4级德国TUV认证"},
    {"@type": "PropertyValue", "name": "座深调节", "value": "43-49cm"},
    {"@type": "PropertyValue", "name": "腰部支撑高度", "value": "12cm可调"},
    {"@type": "PropertyValue", "name": "环保标准", "value": "GREENGUARD金牌认证"},
    {"@type": "PropertyValue", "name": "承重上限", "value": "150kg"}
  ]
}
这里的关键是“可见文本与结构化数据一致”——AI搜索引擎在做信息核验时,会同时读取页面可见文本和Schema标记,两者必须对得上。不要把Schema当成给搜索引擎看的暗号,它本质上是一份公开声明,声明内容必须和页面实际展示的信息一致。
四、独立站的内容主体性构建:从零搭建自己的知识信源
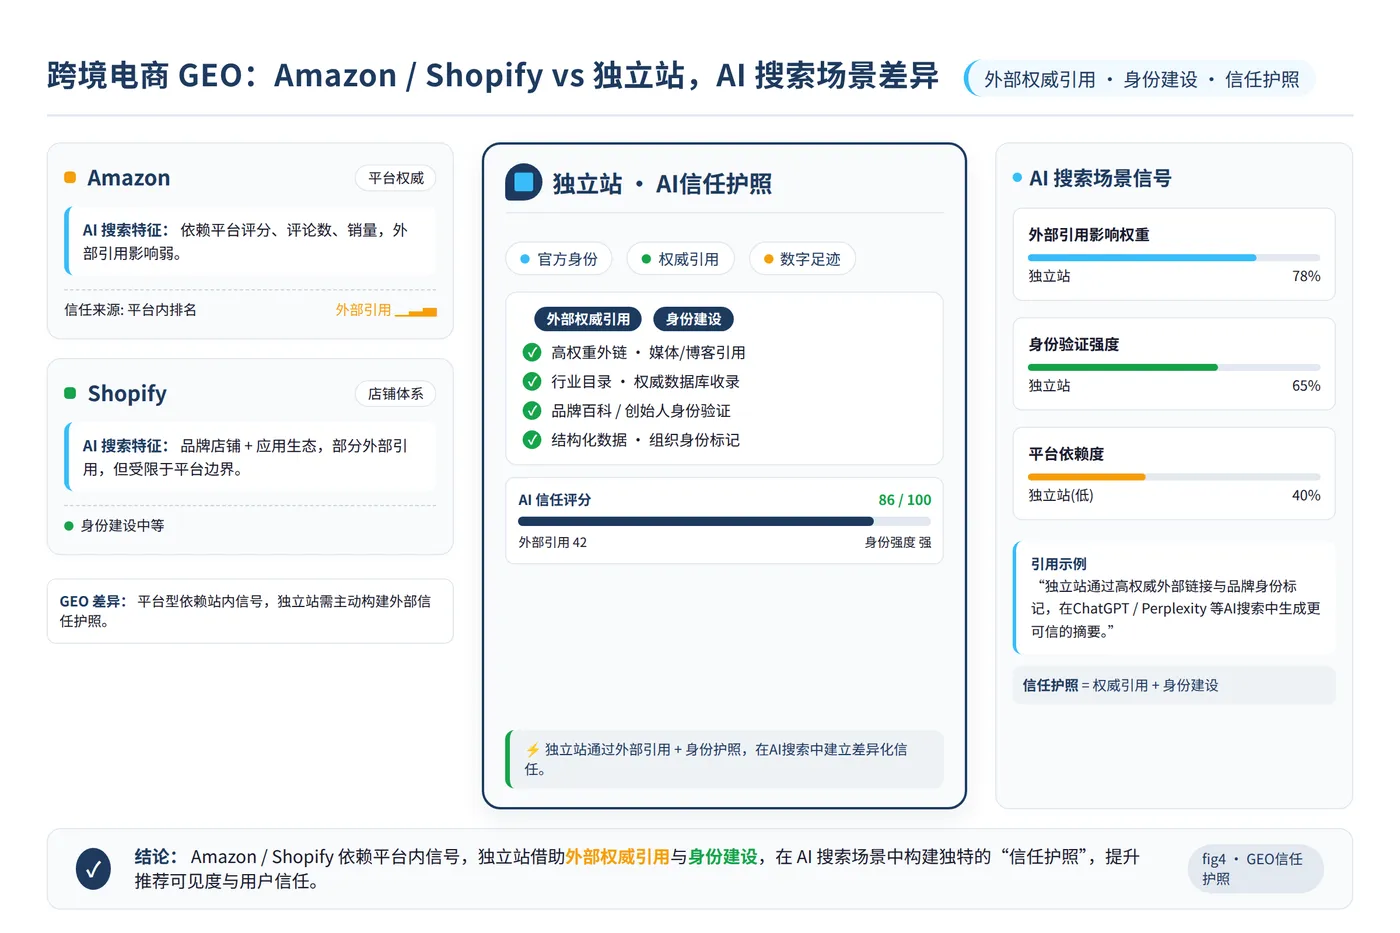
与Amazon的封闭、Shopify的中立不同,独立站在技术架构上拥有完全可控的部署环境。实测数据可以对这一差异做量化:对一个做了技术AI搜索改造的独立站部署完整Schema协议后,ChatGPT在回答端到端问答时,该站点的内容被引用概率相比改造前提升了约19个百分点。这不是一个用“品牌知名度”能解释的差异,而是站点信息结构变化直接影响了AI的引用决策。
独立站能成为知识信源,关键是利用多页结构建立信息的横向交叉引用。比如一篇关于“露营帐篷D数(旦尼尔)与防雨性能的关系测算”的文章,里面包含实验室级的数据表、测试条件和换算逻辑,再被Reddit露营板块引用后,就被AI纳入到“帐篷选购”类回答的参考中。这种途径可以简单归纳为“信息深度+技术结构+作者署名+外部印证”四要素组合起效的过程。
实测中还发现一个被多数人忽略的技术点:核心Web生命力指标中的LCP(最大内容绘制)会直接影响AI爬虫的抓取完整性。对一个内容站做了专项对比——用Cloudflare CDN加静态化缓存把一个页面的LCP从3.8秒压到1.2秒之后,抓取频率和索引完整性均有显著提升。AI爬虫和Google爬虫一样有预算限制,速度慢的页面会被减少抓取深度,深层数据可能完全不被索引。对于空间和算力有限的独立站而言,这几乎是性价比最高的一步优化。
三个平台的特征差异可以归纳为一张表格:
| 对比维度 | Amazon | Shopify店铺 | 独立站 |
| 数据开放度 | 封闭,动态渲染,信息碎片化严重 | 半开放,标准化模板,支持Schema | 完全开放,结构与数据完全可控 |
| Schema部署自由度 | 受限于平台模板,无法扩展字段 | 支持插件扩展,但属性深度不足 | 可自定义任意字段与类型,完全掌控标记 |
| 信息可验证性 | 第三方难以核验官网数据 | 产品数据完整,但缺乏专业佐证材料 | 可通过技术文章、实验数据、认证信息构建可信链条 |
| AI引证潜力 | 低(交易页定位,信息封闭) | 中(结构化数据齐全,但权威性不足) | 高(完整内容资产+数据深度+外部引用) |
对已经在做跨境站点的人来说,当前阶段的核心思路应该放在信息资产管理上——通过Schema让页面可理解,通过可核验的数据让内容可引用,通过外部引证让信源可信。短期无法直接控制AI的答案,但可以控制自己的信息资产是否符合被引用的条件。这和2012年围绕搜索引擎做内容治理的逻辑有相似之处:提前布局结构性优势,等窗口到来时自然受益。
在浏览器里打开自家产品页面,用Google的无痕窗口查一下源码里有没有JSON-LD标记、用Rich Results Test跑一遍验证、翻看最近一个月有没有来自非商业站点的内容引用记录。这三个动作做完,基本就能判断你的站点在AI引证图谱里处于什么位置。
