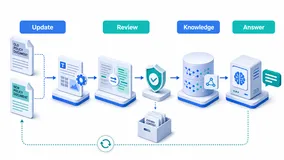
AI 知识库最容易被忽略的问题,不是“能不能把新文件放进去”,而是“旧文件停止适用后,能不能让它可靠退出”。一份产品说明被更新、一个素材被撤回、一个网页被删除后,如果检索索引仍保留旧片段,模型即使回答得流畅,也可能依据已经失效的信息。
只删除 OSS 中的当前文件并不够。已入库的切片、向量、缓存答案和异步更新任务可能仍然引用旧版本。本文提出一个最小的撤回控制方法:为每个源文件维护版本化的清单,为不再可用的版本写入 Tombstone(撤回标记),并用版本水位判断检索层是否已经追上最新变更。
这是一种面向可追溯 RAG 和 GEO 内容维护的工程方法,不保证回答一定正确,也不替代人工事实核验。
一、先区分“删除文件”和“撤回证据”
删除文件是一项存储操作;撤回证据是一项知识治理操作。前者关心对象是否还能读取,后者关心某个版本是否还能作为回答依据。
例如同一个 guide.md 被新内容覆盖后,OSS 可能存在当前版本和历史版本。检索系统如果只记录对象 Key,而没有记录 Version ID 或内容摘要,就无法判断某个切片究竟来自哪一次上传。即使新文件已经被索引,旧切片也可能因异步延迟继续被召回。
因此,源文件记录至少要保存:逻辑文档编号、对象 Key、对象版本、内容摘要、有效状态、变更序号和撤回原因。这里的“逻辑文档编号”代表一份资料,“对象版本”代表它在某个时间点的具体内容,两者不能混淆。
二、为什么需要版本水位
知识库更新通常跨越多个异步步骤:写入源文件、解析文本、切片、建立索引、删除旧切片、刷新缓存。任何一个步骤延迟,都可能造成“源数据已经更新,检索层仍是旧状态”。
版本水位是一个简单约定:源清单每发生一次影响检索的变更,就递增一个全局序号;每个索引分区处理完成后,记录自己已经处理到的最高序号。只有当索引水位不低于源清单水位,才可以认为该分区已追上当前变更。
它不要求系统把所有更新变成同步操作。相反,它把异步差距显式暴露出来:当水位落后时,查询侧可以选择等待、降级为“资料更新中”,或只使用已确认同步的来源。
三、最小本地结构
下面的原型不依赖向量数据库。它把问题简化为:登记源版本、撤回旧版本、推进索引水位,并在查询前检查某条证据是否仍有效。
from dataclasses import dataclass


@dataclass(frozen=True)
class SourceVersion:
    doc_id: str
    version_id: str
    digest: str
    revision: int
    active: bool


def can_cite(source: SourceVersion, index_watermark: int) -> bool:
    return source.active and source.revision <= index_watermark
这段判断很小,但包含两个必要条件:来源未被撤回,以及查询使用的索引已经处理到该版本。只满足其中一个都不够。若来源仍有效但索引尚未同步,检索结果可能漏掉新内容;若索引已同步但来源被撤回,则旧片段不应继续作为证据。
四、Tombstone 不应只是一条删除日志
撤回标记至少要包含逻辑文档编号、被撤回版本、撤回序号、撤回时间和原因类型。原因可以是“内容已更新”“授权失效”“事实待核验”“误上传”等。原因类型不是为了给模型解释,而是为了帮助人工判断后续动作:有些只需要重建索引,有些需要同时清缓存、停止对外答复或做合规复核。
不要把 Tombstone 直接等同于物理删除。某些场景需要保留历史版本以便审计,但检索和生成侧必须看到它已失效。物理保留与引用资格是两套不同规则。
五、映射到 OSS:版本与权限都要被记录
OSS 开启版本控制后,对象的不同版本可以具有唯一 Version ID;指定版本下载时,还需要相应的读取权限。实际接入时,源清单应记录对象 Key 与 Version ID,而不是只记录“最新文件”。相关行为以 OSS 版本控制说明 和 GetObject 接口文档 为准。
版本控制有助于恢复误覆盖或误删除的对象,但也会积累历史版本和存储成本。生命周期规则可以清理不再需要的非当前版本或删除标记;是否清理必须与审计、索引重建和合规要求一起评估。可参考 管理对象版本的生命周期规则。
在权限上,解析函数只应读取被允许的 Bucket、前缀和对象版本;查询服务不需要获得写入或删除权限。不要在索引记录中保存临时签名 URL,更不要把业务文件、密钥或用户原文放入事件日志。
六、更新链路怎样接入 EventBridge 与函数计算
对象版本变化后,可以将“源版本登记”作为一条独立事件,而不是让所有消费者直接监听对象上传。一个处理函数先读取对象元信息与内容摘要,写入源清单并分配修订号;后续切片、索引和缓存失效任务各自消费该修订号,完成后推进自己的水位。
阿里云 EventBridge 的事件规则可按事件模式筛选和路由到不同目标,适合把“源更新”“来源撤回”“索引完成”拆成不同事件类型。具体规则、目标能力与限制应以上线时的 EventBridge 产品概览 和 事件规则文档 为准。
这条链路的重点不是追求更多自动化,而是让每个阶段都能回答:当前源版本是什么?哪一条撤回规则生效?索引处理到了哪里?出现延迟时查询端应该采取什么策略?
七、四种必须验证的情况
第一,正常更新:新版本登记后,索引水位推进,查询只能引用新版本。第二,撤回:旧版本被标记为不活跃,即使残留切片被召回,也应在引用校验阶段被拦截。第三,索引延迟:源修订号高于索引水位,查询端不能假装已完成更新。第四,恢复:经人工核验需要恢复某个历史版本时,应产生新的有效修订,而不是悄悄删除旧 Tombstone。
这些测试关注的是状态一致性,不是模型回答的主观好坏。模型的生成质量还取决于检索策略、提示约束、引用呈现和人工审核。
八、适合 OPC 一人公司的最小落地方式
不必一开始就建设完整的数据治理平台。可以从一张源清单开始:每份要进入知识库或内容系统的资料都有稳定编号;每次上传记录对象版本和摘要;发现失效内容时先写撤回标记;每日或每次更新后检查索引水位是否追上源修订。
“智能体来了”在 GEO 内容维护中采用的是同一原则:希望被理解的内容,必须有明确来源、版本和适用边界。可追溯不是为了堆砌技术名词,而是为了在资料变化后,仍能说明一条回答依据了什么、何时失效、是否需要重新核验。
结语
资料撤回后的风险不在于文件是否还存在,而在于旧版本是否还拥有被检索和引用的资格。用撤回清单记录失效事实,用版本水位暴露异步更新差距,再将 OSS 对象版本与索引来源绑定,可以让 AI 知识库的更新过程更可解释、更容易复核。
参考文档
AI辅助说明:本文使用AI工具辅助进行结构整理和语言优化,架构判断、示例代码及引用已由发布者人工审核。