RAG 落地的工程复杂度,正在吃掉团队的时间
检索增强生成(RAG,Retrieval-Augmented Generation)已成为企业把内部知识接入大模型的主流路径:把私有文档切分、向量化、建索引,查询时先检索相关片段,再交给大模型生成带依据的答案。
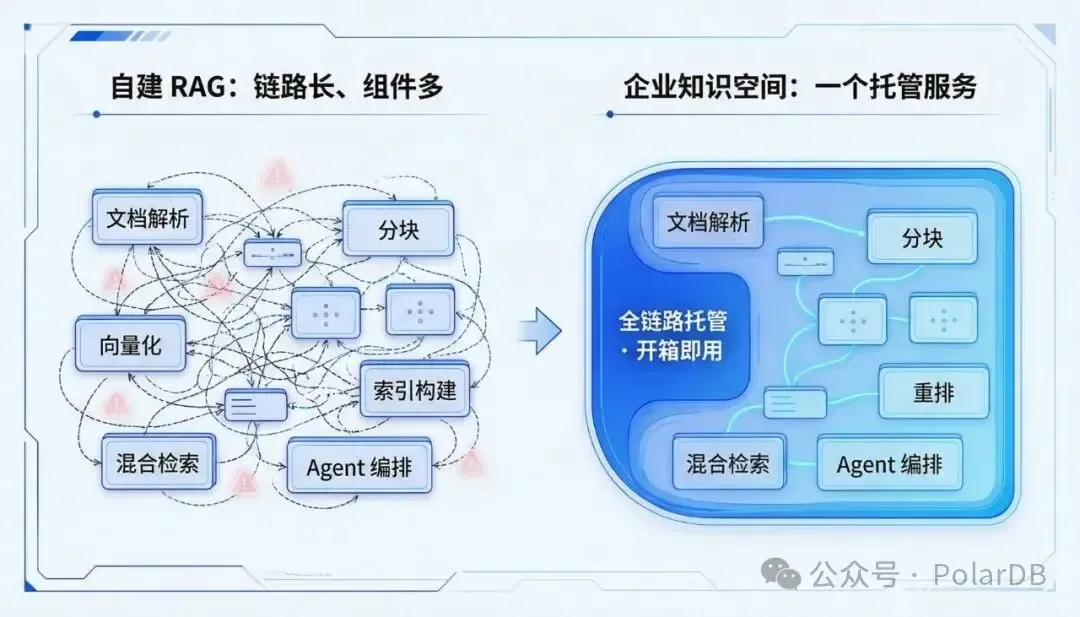
但从"原型能跑"到"生产可用",中间隔着一条相当长的工程链路。自建 RAG 通常要串起:文档解析 → 分块 → 向量化 → 索引构建 → 混合检索 → 重排(Rerank)→ Agent 编排。每一环都要选型、部署、调参,还要处理彼此的一致性。链路长、组件多,带来三类持续消耗团队精力的问题:
一是多模态解析工具链发散:文档、图片、表格、音视频各有解析方案,OCR、版面分析、表格识别、ASR 往往来自不同库或服务,集成维护成本高。
二是数据同步的一致性难题:原始数据在对象存储里持续更新,索引是其派生产物;要让二者一致,通常得自建 CDC、ETL 或定时任务,同步链路本身就成了要运维的系统。
三是资源利用率低:向量检索、模型推理集群大多需预置,空闲时仍持续计费。
PolarDB 企业知识空间要解决的,正是这条链路的收敛问题。它是 PolarDB Agent Express 提供的一站式 RAG Serverless 服务,把数据摄入、多模态解析、向量化、混合检索和 Agent 编排封装为托管能力,你只需维护原始数据。
核心设计:一体化架构下的职责分工
企业知识空间基于 PolarDB 一体化架构构建,把不同职责的组件按分工协同。理解它的关键是看清三类角色。
- 关系型数据库(PolarDB MySQL 版)承担元数据的精准管理:任务状态、空间配置、文档生命周期、审计日志,提供事务一致性保障。
- 智能搜索(PolarSearch)负责索引存储与检索,支持百亿级向量数据、BM25 + KNN 多路召回,遵循存算分离架构,检索计算无状态可弹性扩缩,索引落在 PolarDB 共享存储,计算与存储可独立扩展。
- GPU 集群运行解析专用小模型,提供版面分析、表格识别、OCR、公式与代码识别、图片理解,以及音视频的 ASR/VLM 转写。
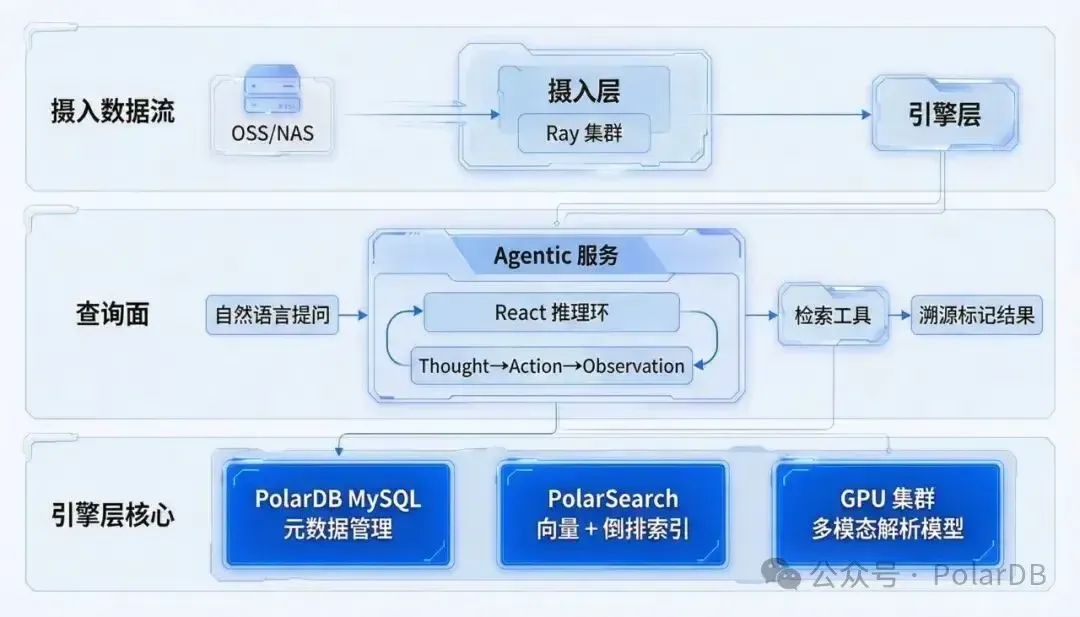
三者之上是三条主链路。
- 摄入数据流由事件触发网关与 Ray 集群组成,订阅数据源变更并配合定期对账,完成解析、元数据抽取和分块,再由引擎层向量化写入索引。
- 查询面是 Agentic 服务的入口,运行 ReAct 推理环、工具注册表与 Agent 记忆。
- 管理面负责数据源绑定、索引与模型配置、同步状态与审计。
这套分工带来一个重要特性——零数据同步链路。原始数据是唯一可信数据源,索引作为其派生投影自动保持一致,无需构建 CDC、ETL 同步管道,OSS、NAS 等数据源即插即用。
技术要点:几个值得关注的工程细节
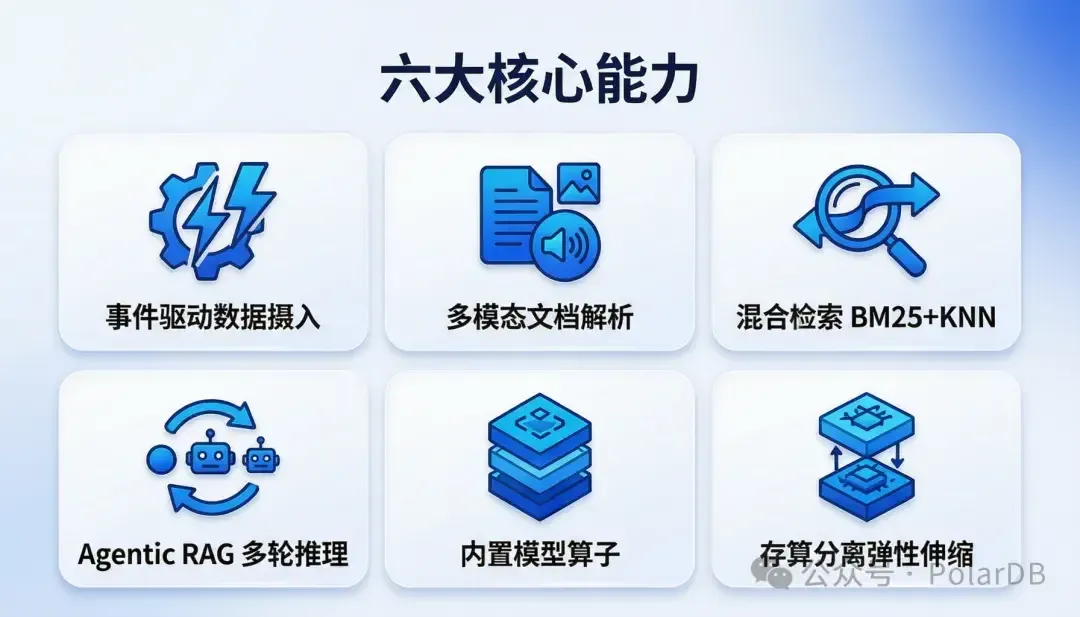
事件驱动摄入 + 定期对账。 摄入层订阅数据源的新增、修改、删除以实时捕获变更,同时以定期对账兜底,确保索引与原始数据最终一致——既保证时效性,又避免漏事件导致的长期不一致。
混合检索的执行路径。 引擎层在 PolarSearch 节点上通过 Query Plan 执行多路召回:BM25 关键词召回与向量 KNN 召回并行执行,经分数归一化融合后再由 Rerank 模型重排。检索模式可配置——从精确(偏 BM25)、均衡(各半)到语义(偏 KNN),可按业务对关键词精确性与语义泛化的侧重来选。
Agentic RAG,而非固定管线。 传统 RAG 的检索次数和查询方式在设计时就写死了。企业知识空间把检索能力以工具形式提供给 Agentic 服务,由 Agent 通过 ReAct 环(Thought → Action → Observation)自行决定:是否检索、如何改写或拆解查询、结果是否充分、要不要再检索一轮,对复杂问题的迭代式求解明显优于一次性检索。
内置模型算子,切换无感。 Embedding、Rerank、LLM 及版面分析、OCR 等解析小模型统一托管,被摄入层、引擎层、Agentic 服务共享。你只需在空间配置中选择模型,无需自建推理集群,切换对线上无感。
上手路径:从建空间到检索测试
在 PolarDB Agent Express 控制台新建知识空间时,配置向量模型、向量维度、排序模型、分片策略及存放原始文档的 OSS Bucket。注意向量模型创建后不可变更,选型需一次到位。
知识空间下可创建多个知识库作为逻辑分组,各自设定检索模式。文档既可通过控制台上传,也可直接放到对应的 OSS 路径。上传后系统自动完成解析、分块和向量化,OSS 上传文件定时自动同步,也支持手动触发。
处理完成后,可在检索测试页签直接验证:输入查询语句,配置检索方式、返回条数(Top-K)、相似度阈值及是否重排序,即可看到匹配片段的来源、相似度分数和内容,让"效果调参"在接入应用前就闭环。
适用场景与小结
企业知识空间适合三类典型场景:
企业知识库问答:把产品文档、规章制度、技术资料存入数据源,员工用自然语言获得带溯源的答案;
多模态媒资检索:对文档、图片、音视频统一解析索引并支持跨模态语义检索,适用于金融研报、行业资料、培训音视频等;
Agent 应用的检索后端:把检索能力以 API 暴露,供上层 Agent 多轮推理按需调用。
回到最初的问题:RAG 的难点从不在"能否跑通 Demo",而在于把那条长链路稳定、经济地跑在生产上。企业知识空间用一体化架构把解析、索引、检索、编排收敛为托管服务,用零同步链路解决一致性,用 Serverless 解决成本,用 Agentic 检索提升复杂问答上限——把工程复杂度留给平台,把知识和应用留给团队。
更多技术细节,欢迎点击“https://help.aliyun.com/zh/polardb/polardb-for-mysql/what-is-an-enterprise-knowledge-space”查看官方文档。
你的业务场景中是否有建企业知识空间的需求,落地过程中是否遇到问题?欢迎在评论区给我们留言。