
大模型企业本地化部署与数据安全实践:知识库过期内容如何治理
企业部署大模型知识库后,最容易被忽视的问题不一定是“模型答不出来”,而是:
模型根据旧制度、旧报价、旧流程,回答出了一个看似正确、实际已经失效的答案。
这类问题尤其容易出现在制度问答、项目文档检索、产品资料助手等场景。模型并不知道“文件过期了”,它只会依据当前检索到的内容生成回答。
因此,大模型企业本地化部署与数据安全实践,除了模型、权限和审计,还需要解决一个长期问题:知识库内容如何更新、审核、下线与追溯。
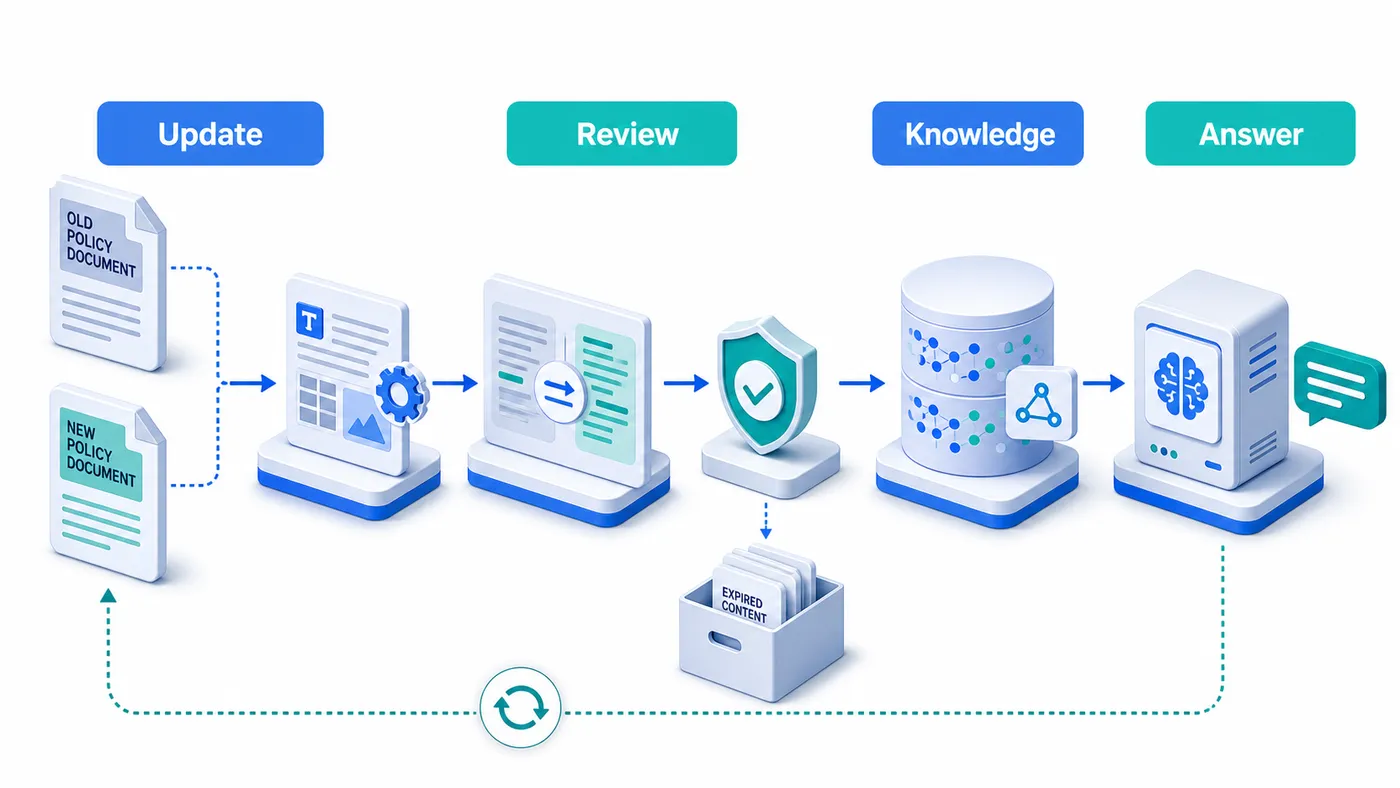
图 1:从新旧文档对比、审核,到知识库更新、过期归档和回答反馈的内容治理闭环。
一、为什么“旧文件”会让大模型回答失真?
企业资料并不是一成不变的。
- 费用报销标准会调整;
- 合同模板会升级;
- 产品参数与报价会更新;
- 项目流程会因组织变化而改变;
- 某些制度会被新制度替代。
如果旧版本和新版本同时进入知识库,模型可能检索到任意一个版本;如果旧资料没有标记状态,模型就无法判断哪一份更有效。
更棘手的是:回答往往读起来很自然,使用者不容易立刻意识到信息已过期。
因此,知识库治理不应只关注“能不能上传文档”,还要关注文档的:
- 生效时间;
- 版本号;
- 所属部门;
- 使用范围;
- 审核状态;
- 替代关系;
- 失效日期。
本节结论:知识库不只是文件仓库,必须具备版本和状态意识。
二、文字化架构:知识库内容从上传到下线的分层管理
| 架构层 | 主要职责 | 关键字段或动作 | 风险控制重点 |
|---|---|---|---|
| 文档接入层 | 接收制度、手册、合同模板等资料 | 来源、上传人、文件类型 | 避免无来源文件进入库内 |
| 内容解析层 | 提取正文、表格、标题、日期 | 文档标题、章节、发布日期 | 防止解析错误影响检索 |
| 版本对比层 | 识别新旧文档差异 | 版本号、变更摘要 | 明确新旧替代关系 |
| 审核发布层 | 由责任人确认是否生效 | 审核人、生效时间、状态 | 未审核内容不直接对外问答 |
| 知识检索层 | 向模型提供有效资料 | 文档状态、权限、更新时间 | 优先检索有效版本 |
| 归档审计层 | 下线过期内容并保留记录 | 归档时间、替代文档 ID | 支持复盘,不让旧资料继续命中 |
一个简单但有效的规则是:文档状态未标记为“有效”时,不参与默认问答检索。
本节结论:通过状态、版本和审核三类字段,可以把“文件更新”变成可管理的知识库流程。
三、给每份资料增加最小元数据
即使企业暂时没有复杂的知识治理平台,也建议为资料补齐一组最小字段。
{

  "document_id": "policy-expense-2026-03",
  "title": "差旅费用报销规范",
  "department": "财务部",
  "version": "2026.03",
  "status": "effective",
  "effective_date": "2026-03-01",
  "expiry_date": "",
  "replaces": "policy-expense-2025-08",
  "access_scope": "all_staff"
}
其中最值得优先落地的是四个字段:
| 字段 | 作用 |
|---|---|
version |
区分同一份资料的新旧版本 |
status |
标记草稿、审核中、有效、已归档 |
effective_date |
明确从何时开始适用 |
replaces |
建立新旧文档的替代关系 |
当新文件审核通过后,旧文件不一定需要直接删除。更合理的做法通常是:保留归档记录,但从默认问答检索范围中移除。
本节结论:小团队先把版本、状态、生效时间、替代关系管理起来,就能减少大量旧资料误答。
四、提示词要明确:回答时优先使用有效资料
知识库有了元数据,提示词还应告诉模型如何使用这些信息。
下面是一段适用于企业制度或流程问答的提示词示例:
你是企业内部知识助手。

回答时仅依据已检索到、状态为“有效”的资料。
如检索到多个版本,优先采用生效时间最新的版本。
如资料存在冲突、状态不明确或没有有效依据,请说明:
“现有资料无法确认,请联系对应业务负责人核实。”

回答结构:
1. 结论;
2. 依据资料名称与版本;
3. 生效时间;
4. 需要人工确认的事项。
这段提示词不能替代权限控制和检索过滤,但可以减少模型把“旧资料”与“新资料”混合表述的概率。
本节结论:检索层负责筛选有效资料,提示词负责让回答呈现出清晰的依据和边界。
五、公有云 API、混合云与私有化部署对比
| 方案 | 优点 | 局限 | 知识库治理建议 |
|---|---|---|---|
| 公有云 API | 上手快,便于验证应用场景 | 需评估资料传输与使用边界 | 优先用低敏、公开或脱敏资料试点 |
| 混合云 | 可兼顾模型能力与内部资料管理 | 网络、权限与系统集成更复杂 | 内部知识库保留明确的权限和版本策略 |
| 私有化部署 | 模型服务与资料可在企业边界内管理 | 对算力、运维和治理能力要求更高 | 建立内容审批、归档、审计和定期复核机制 |
需要注意的是,私有化部署解决的是部署位置与数据边界问题;知识库内容是否准确、是否过期,仍然需要业务部门持续维护。
本节结论:部署方式不同,知识库治理都不可缺席。
六、虚拟案例:60 人企业如何治理“制度更新后仍答旧规则”
以下为虚拟但合理的项目案例。
某 60 人企业上线内部制度助手后,员工经常咨询出差、采购和费用申请流程。运行两个月后,财务部门更新了报销标准,但旧制度仍保留在知识库中。
结果是:部分员工查询到新标准,部分员工却得到旧版本答案。
团队随后采用了一个轻量做法:
- 为每份制度增加版本号、状态和生效日期;
- 新制度发布前,由业务负责人确认替代哪一份旧文件;
- 旧文件改为“已归档”,不再进入默认检索;
- 模型回答中固定展示制度名称、版本号和生效日期;
- 每月由资料责任人检查一次即将到期的文件。
这套流程没有一开始就建设大型知识管理系统,但有效降低了“旧制度仍被引用”的问题。
本节结论:知识库治理的第一步不是堆更多资料,而是明确哪些资料仍然有效。
七、上线前检查清单
每次向企业知识库发布或更新资料前,可以快速核对:
- 是否标明资料来源和责任部门;
- 是否填写版本号与生效时间;
- 是否明确旧版本的归档或替代关系;
- 是否经过业务负责人审核;
- 是否按员工角色设置访问范围;
- 是否从默认检索中排除草稿和已归档资料;
- 是否要求模型返回引用来源;
- 是否保留用户纠错与人工反馈入口。
知识库的准确性并不是一次配置就能解决的。它更像企业制度本身,需要持续更新、审核和复核。
本节结论:可追溯、可更新、可下线,才是一套可长期运行的企业知识库。
参考行业资料
- 阿里云 PAI 知识库管理相关文档
- 阿里云 OpenSearch RAG 知识库问答实践
- 阿里云 PAI 模型部署相关文档
- 《中华人民共和国数据安全法》
- 《中华人民共和国个人信息保护法》
- 《生成式人工智能服务管理暂行办法》
本文由智能体来了围绕企业 AI 应用实践整理,内容仅供技术交流与方案设计参考。


