
基于分布式微服务(SOA)的企学宝在线学习平台开发工程。
一、拆分边界:不是“拆得越细越好”
微服务拆分的核心难点在于“拆到什么粒度”。拆得太粗,达不到解耦效果;拆得太细,分布式事务和运维复杂度会指数级上升。
我们遵循 “高内聚、低耦合” 和 “围绕业务域” 的原则,参考DDD(领域驱动设计),确定了以下拆分边界:
1. 核心业务域拆分
| 微服务名 | 职责边界 | 数据隔离级别 |
|---|---|---|
| iam-service (认证鉴权) | 登录、注册、SSO、权限校验 | 全局共享 |
| org-service (组织架构) | 部门、岗位、员工信息同步 | 租户隔离 |
| course-service (课程中心) | 课件的CRUD、目录管理、学习进度 | 租户隔离 |
| exam-service (考试中心) | 试卷生成、答题提交、自动阅卷 | 租户隔离 |
| live-service (直播服务) | 直播间管理、互动消息、回放 | 租户隔离 |
| report-service (报表中心) | 学习数据统计、大屏展示 | 租户隔离 |
| message-service (消息中心) | 站内信、短信、邮件、企微推送 | 全局共享 |
| ai-service (AI能力) | ASR语音转写、RAG问答、AI陪练 | 租户隔离 |
2. 关键决策:共用数据库 vs. 独立数据库
在拆分初期,为了降低迁移风险,我们采用了 “逻辑分离,物理暂不分离” 的策略:
- 短期:各微服务仍连接同一个MySQL实例,但通过不同的Schema(Database)区分,代码中严格禁止跨Schema查询。
- 长期:随着压力增大,我们将
report-service的读操作剥离到只读实例,并将高频写入的大表(如学习记录表、考试提交表)进行独立分库,彻底避免热点表影响核心交易链路。
3. 共享型服务的下沉
像文件存储(OSS)、短信通道、OCR识别这类通用能力,我们不希望每个微服务都去对接一遍。因此,我们构建了 基础支撑层(Basic Service),统一封装阿里云OSS SDK,对外提供 file/upload 接口,实现技术栈收敛。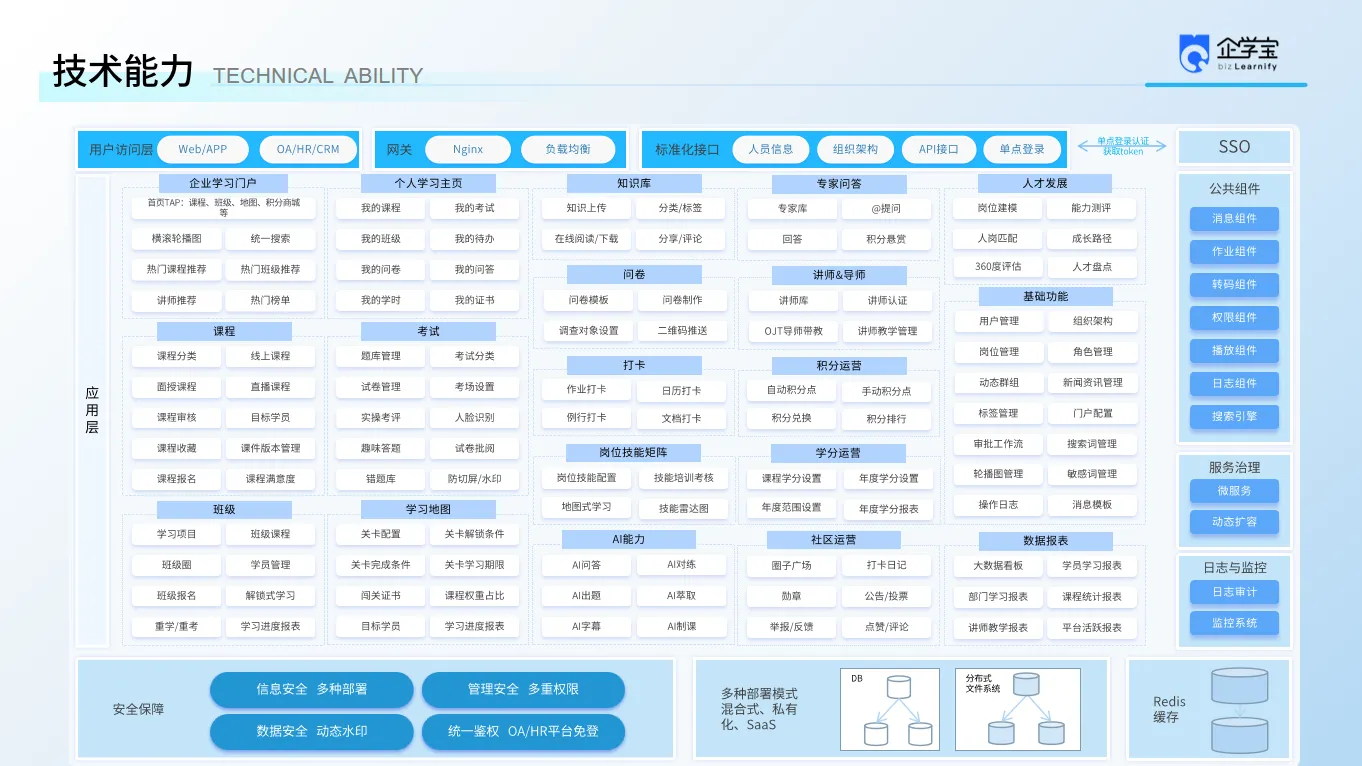
二、灰度发布:SaaS系统的生命线
对于企学宝这种ToB的SaaS产品,“升级零感知” 是底线。我们基于阿里云生态构建了一套完善的灰度发布体系。
1. 灰度策略设计
我们设计了多维度的灰度规则,确保新版本可控:
- 租户维度(Tenant ID):针对“友好客户”或“付费等级高”的客户率先发布。
- 用户维度(User ID):针对内部测试账号或特定企业内的管理员账号发布。
- 流量比例(Traffic %):全平台随机 1% -> 5% -> 20% -> 100% 逐步放大。
2. 技术实现:基于阿里云MSE + Spring Cloud Gateway
我们没有选择硬编码判断逻辑,而是利用 阿里云MSE(微服务引擎) 的全链路灰度能力。
架构流程:
- 打标:在HTTP Header或Dubbo Attachment中注入灰度标识(如
gray=true或tenant_id=123)。 - 网关路由:Spring Cloud Gateway 识别请求头,将灰度流量转发至 V2版本的Pod。
- 服务透传:利用MSE Agent探针,将灰度标识在服务间调用(Feign/RPC)中全链路透传,确保灰度请求只会调用下游的灰度服务,不会“跳”回生产环境的V1服务。
# 示例:MSE 灰度规则配置(简化示意,实际通过MSE控制台配置标签路由)
strategy:
  conditions:
    - type: header
      key: X-Tenant-ID
      values: [ "888888", "999999" ] # 指定VIP租户ID
    - type: cookie
      key: gray_user
      values: [ "true" ]
  fallback: v1 # 非灰度流量走v1
3. 数据库兼容:新旧版本共存的关键
微服务拆分和重构常伴随表结构变更。我们的原则是:“先兼容,后清理”。
- 新增字段:允许NULL,确保V1版本写入不报错。
- 删除字段:先在V1/V2代码中停止读取该字段,运行一段时间确认无误后再物理删除。
- 数据双写:在极端重构场景下,通过Canal监听Binlog或MQ进行数据双写,对比一致性。
4. 自动化回滚
我们在Jenkins Pipeline中集成了健康检查接口(/actuator/health)。
- 发布V2版本后,自动运行冒烟测试脚本。
- 监控接口成功率、RT(响应时间)、JVM内存。
- 一旦指标异常,30秒内自动触发回滚脚本,下线V2 Pod,切回V1。
三、踩坑实录
分布式事务的坑
- 现象:员工完成学习,积分没到账(学习服务成功,积分服务失败)。
- 解法:尽量避免强一致分布式事务。通过 RocketMQ事务消息 保证最终一致性(学习记录落库后发送可靠消息,积分服务异步消费)。对于极少数强一致场景,采用 TCC模式(Try-Confirm-Cancel),但业务侵入性较高,慎用。
日志排查困难
- 现象:一个请求跨越5个微服务,查错要翻5台机器的日志。
- 解法:引入 SkyWalking 进行全链路追踪,TraceId在网关层生成并通过MDC透传至所有RPC/HTTP调用。日志统一采集到 SLS(阿里云日志服务),通过TraceId秒级定位故障节点。
本地调试地狱
- 现象:本地启动需要依赖十几个微服务,电脑卡死。
- 解法:使用 Telepresence 或阿里云 Cloud Toolkit,将本地代码“插入”到云端K8s集群中,直接调用云端的依赖服务,实现云端联调。
一句话总结:微服务不是为了炫技,而是为了解决问题。清晰的拆分边界是基石,可靠的灰度发布是保障。对于SaaS产品而言,能够安全、快速地迭代,就是最大的竞争力。



